两条简单的规则,让 LLM 帮你精简、改进文章,而不把文字巴氏杀菌,也不往里灌玉米糖浆。
写“怎么写作”很棘手。读起来像是在炫耀,暗示你写得好。也许你写得好,也许不好,但可以肯定,互联网上某个角落一定有一群批评者觉得你写得很烂。我和所有人一样既虚荣又缺乏安全感,写这篇文章时有种说不出的别扭。但我还是决定放下自我把它写下来,因为这些建议很重要,难以反驳,而且简单直接。
读者能察觉到万亿分之一浓度的 LLM 用词。无论你花多少功夫去打磨、去“人味化”,一段 LLM 写的文字在很多读者眼里都不是写作,而是产出物。所以先说坏消息:你得自己写。
不过 LLM 依然非常有用。只是你要把它当作文字编辑(copyeditor)来用,而不是当作代笔。所以我的方法第一步:写出你的文章。第二步:把它交给一个好模型去找毛病。
但在谈这个怎么做之前,你需要先理解两条规则。它们能抵御 LLM 的悄然渗透,否则它会把你推进表达与产出物之间的恐怖谷,让你失去读者的注意力。
规则一:LLM 建议的任何一个词,你都不能用。
违反这条规则会让你惹上麻烦。原因在于:前沿模型挑选悦耳措辞的能力好得不可思议,这几乎就是它们的看家本领。模型所建议内容的问题很微妙。可以这样理解:前沿模型被卡在一种模式里,它写的每一句都像杂志标题。标题很好,但如果有人写一篇文章通篇是几十个标题,你就会对他心存疑问了。
所以我认为,作为一种智力上的个人防护装备,你应该采用这样的规则:LLM 建议的任何具体措辞一概不得使用。这条规则要严格执行!整个前提是,你无法可靠地发现前沿模型试图把你的文字变成 Velveeta 奶酪的所有手法。即使你喜欢这些词,即使你确信它们比你原来的更好,LLM 生成的措辞也一律取消资格。
规则二:避开鼓励
LLM 还会通过影响力运动来侵染你的写作。这是一个微妙得多的问题,危害也没那么显眼,但它仍然是 LLM 让你的文章变差的一种方式,既然结果如此,那还不如干脆不用 LLM。
问题在于:把任何一篇文章交给 LLM,它都会回复“太棒了,Jerry!”但这并不是你需要听到的!
你的初稿里,大多数段落都很糟,话题的流动前后不连贯,至少有 750 个字是多余的。模型却在整体结构上鼓励你。接着,又在段落和过渡上鼓励你。然后是用词和比喻。流行文化梗。它们都很糟!全都很糟!别听它的!
它会这样坑你:你会在初稿的所有冲动上变本加厉。但这通常并不是你本来会做的。你本来会编辑、重新思考、替换段落。那些重新思考,是你个人声音中承重的部分。读者说不出哪里不对,但会感觉到你变得带着人工香精的味道。
有好几年,我在每个文字编辑提示词的开头都撒一个谎:说我不是作者,而是一家线上刊物的编辑,正在筛选来稿。这有帮助,但模型往往矫枉过正,过度贴合我那份“刊物”的“目标”。
所以目前我最实用的建议是:禁止模型鼓励你,然后对赞美保持高度警惕。
那么,这些东西能做什么?
它们特别擅长指出问题。天哪,你的问题可真多。你可以靠人工把它们找出来,但那是乏味又累人的活儿。模型不会累。所以在发现下面这些问题上,它们比你强:
- 你过度使用(或者,如果你对 LLM 言听计从,也许是使用不足)被动语态,把动词名词化或把动作埋起来,还反复使用相同的措辞或用词。
- 草稿里到处撒着“very”“unfortunately”“really”和“actually”,就像粘在工作台上的锯末。
- 几乎可以肯定,有 2 到 3 个段落可以很快挪到文章的别处,立刻提升清晰度(这类修改真的、确实、非常令人满足)。
如果你像我一样是程序员,就会希望有一本书能给出这类修改的蓝图,一本针对散文的“C Interfaces And Implementations”,就像 Hanson 对那门最伟大的糟糕编程语言所做的那样。而这本书确实存在,它叫《Style: Lessons In Clarity And Grace》,我敢对天发誓,它把文字编辑变成了写 Java。同样的枯燥,同样的有效。我是从 Richard Gabriel 那里知道这本书的,我很惊讶,我认识的每个程序员的桌上居然都没有一本。
所以去读《Style》,或类似的书,边读边做笔记。整理出一份给模型用的提示词清单,然后分轮次对你的文章逐遍运行。
用这种方法你可以走得相当远:
- 让模型找出你文章中的问题。
- 针对每个问题,重写段落(或句子,或章节)。
- 把原文和新写的内容一起交给模型,问它哪个更好。
烦人的是,这里你会碰到规则二的一个变体,因为除非你小心,否则模型知道你刚刚重写了某处,也知道你想听到新版本更好。所以要把这些选项交给一个不了解你编辑过程上下文的模型。
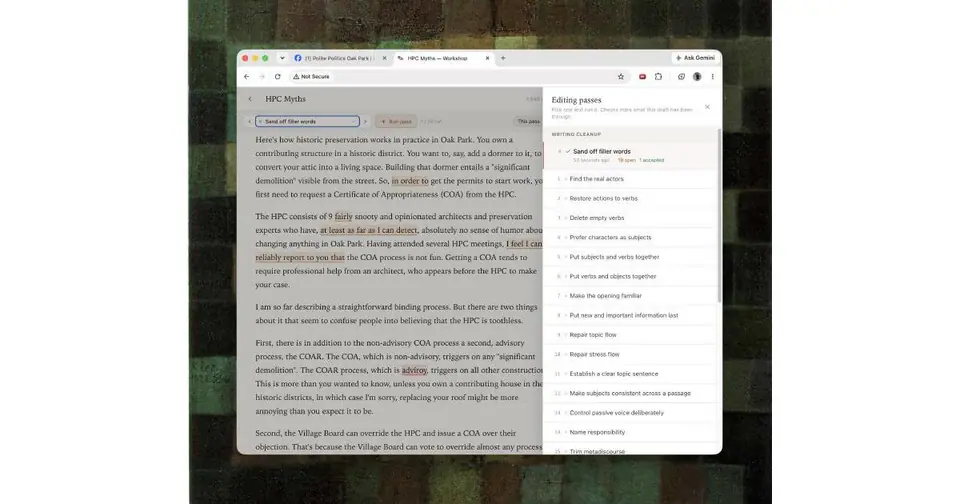
我最终受够了在各个标签页之间来回切换,还要费劲说服模型“我不是作者,而是一位乐于助人但严格的写作教练,在帮助一个可能很好也可能很糟的学生”,于是我捣鼓出一个小软件来替我处理这些。下面是一个效果不错的开场提示词:
“我们要构建一个写作工作坊工具。先把骨架搭起来。Python,用 HTMX 做交互,SQLite 后端,Tailwind 前端,使用本地构建而非 CDN。要非常出色的文本编辑器,Notion 风格。支持高亮(我们要做编辑轮次)。做 Genius 风格的侧边栏批注,与高亮的内容对应。确保我们能在建议之间前后切换。支持多篇文档,跟踪修订,允许用户标记重大修订。先做到这一步,然后我再告诉你我真正想要什么。”

然后,把你想好的编辑提示词清单交给它,让它通过 Codex、Claude 或 Antigravity 的 CLI 逐个运行。你在这里想出的任何东西都会比我的好,因为无论谁自己想出什么,对他自己来说都比别人的更好。
所以:不要让 LLM 替你挑词。小心别让它骗你,让你以为初稿比实际更好。然后把所有最乏味的工作外包给模型。你的声音保持完整,而你的工作更快、更好、也更不痛苦。
最后一点。不要全盘接受模型的文字编辑建议。这是规则二的一个推论。就在刚才,我把这篇文章喂给了 GPT5(“这不是我写的”),它说整篇文章长了 20%。它大概是对的。但我不会改。我就做我自己。