可穿戴设备能在人群规模上持续捕获生理信号。从心率动态到睡眠模式,这些数据流能够在症状出现之前揭示早期的生理变化。瓶颈已不再是数据采集,而是如何把这些信号转化为可靠且具有临床意义的生物标志物。
现有的基于语言模型的智能体系统可以自动化科学工作流的部分环节,但在生理时间序列数据上往往会失灵。这些系统以预测性能为优化目标,却忽视了统计有效性,导致虚假相关、数据泄漏和脆弱的特征。
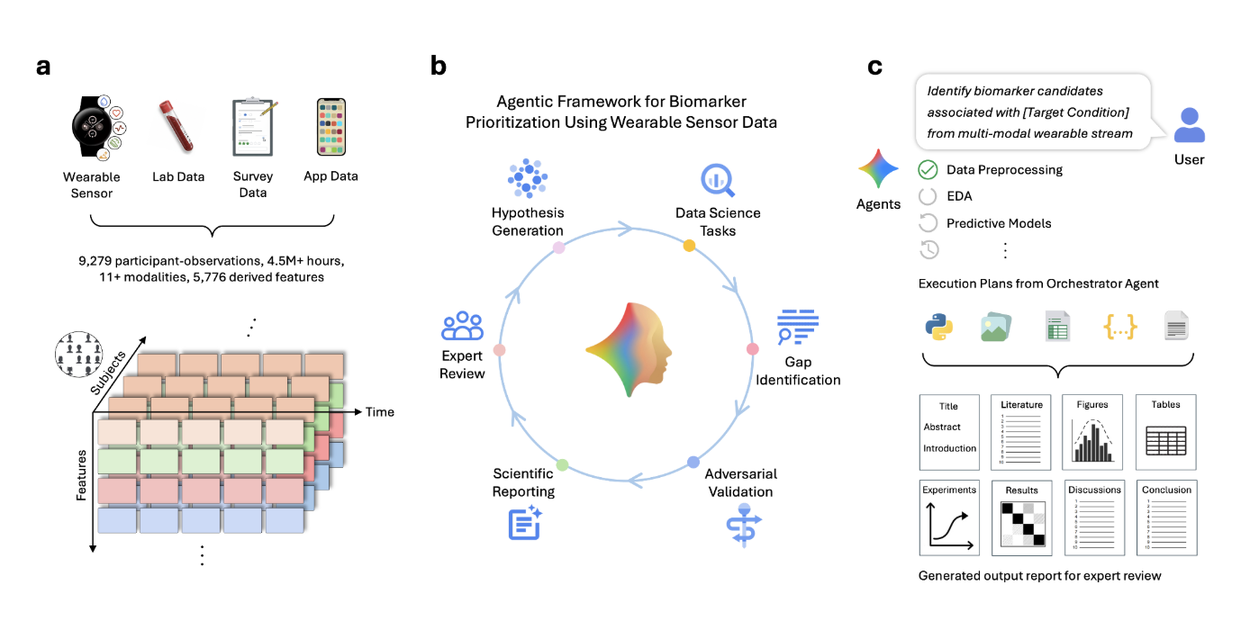
为此,我们推出了 Biomarker Discovery Framework,这是一个多智能体系统,把候选生物标志物的优先级排序构建为在人类监督下的迭代研究循环。通过结合假设生成、并行统计分析、模型训练、对抗性验证和基于文献的推理,Biomarker Discovery Framework 在保持严格统计严谨性和人类监督的同时,加速了发现过程。在三个队列(N = 9,279 个参与者观测)中,Biomarker Discovery Framework 复现了已知的临床信号,在独立数据集中识别出趋同的生物标志物,并在与人口统计学特征结合后提升了下游预测效果。
结构化、对抗式、有人类监督的流水线
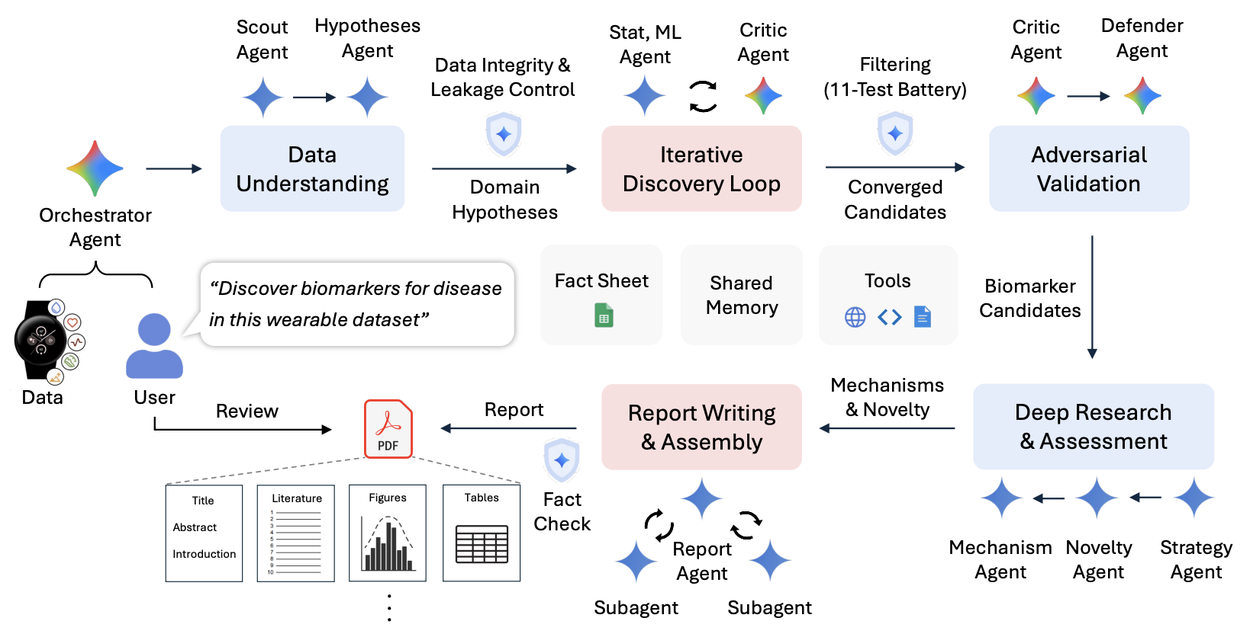
Biomarker Discovery Framework 将用于数值分析的确定性计算与用于假设形成和解释的生成式推理相结合。Orchestrator 智能体把自然语言研究指令分解为执行计划,并引导各专职智能体完成六个阶段的流程。同时,共享记忆、结构化事实表(fact sheet)和通用工具在整个工作流中保持可追溯性:
- 数据理解:Scout 智能体梳理 schema、缺失情况、时间结构和临床终点,同时通过泄漏控制将目标标签与特征构建隔离开。
- 候选假设的依据确立:Literature 和 Hypotheses 智能体检索并核实已有证据,然后提出在生理上合理的特征和复合指标。
- 迭代发现循环:Statistical 和 ML 智能体执行确定性代码,构建特征、估计关联、进行多重检验校正,并评估预测信号。Critic 智能体会找出薄弱的假设和未解决的缺口,必要时促使进一步分析。
- 对抗性验证:Critic 和 Defender 智能体对候选项进行压力测试,检查目标泄漏、过拟合、混杂敏感性、构念重叠、不稳定性和生理上的不合理性。一套结构化的 11 项内部检查会赋予明确的报告标签,包括 screened(已筛选)、conditional(有条件)、exploratory(探索性)、rejected(已拒绝)和 unstable(不稳定)。
- 深度研究 & 评估:Mechanism、Novelty 和 Strategy 智能体评估生物学合理性、既有文献和潜在的转化相关性,同时不把关联当作因果证据。
- 报告撰写 & 汇编:Report 智能体对照事实表核实数值论断,并把分析、图表、文献和局限性汇编成供专家评审的草稿。
例如,面对“优先排出与抑郁严重程度相关的可穿戴候选项”的请求,Biomarker Discovery Framework 先对 DWB 数据集做了画像,提出了睡眠时间变异性特征,并估计了睡眠时长变异性与 PHQ-8 严重程度之间的关联(ρ = 0.252)。随后,工作流检查了稳定性、泄漏、亚组一致性和替代解释,才把结果表述为一个基于文献的昼夜节律不稳定假设,交由人类评审。
结果:跨领域为候选关联排序
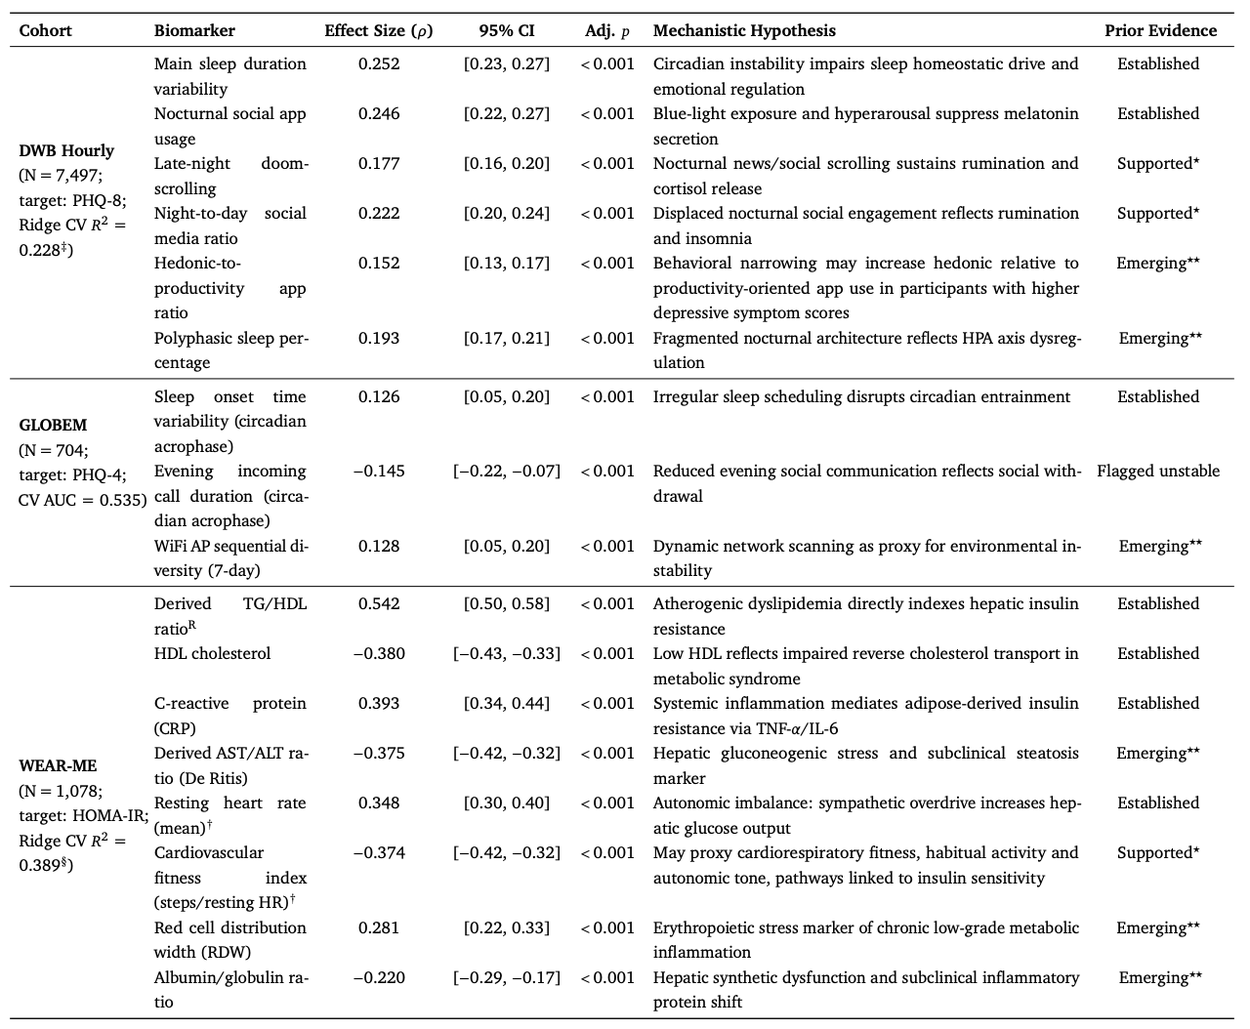
为评估 Biomarker Discovery Framework 从噪声数据中提取合理生理洞见的能力,我们将其分别应用于三个大规模队列,共计 9,279 个参与者观测,涵盖心理健康(DWB 和 GLOBEM)与代谢疾病(WEAR-ME)两个领域。该流水线自主识别出 41 个心理健康方面的候选数字生物标志物,以及 25 个代谢结局方面的候选标志物。
下表展示了经过挑选的候选关联样本。Spearman 的 ρ 概括关联的方向和强度。95% 置信区间量化不确定性,校正后的 p 值则考虑了多重比较。机制一栏给出的是基于文献的假设,而非因果结论。需要强调的是,最后一列描述的是既有证据的强度,并非本研究中的临床验证,星号表示证据层级标记,而不是统计显著性代码。
Biomarker Discovery Framework 并不只是选取现有变量,它还构建了新的复合特征。例如,在心理健康领域,它识别出睡眠时长变异性和入睡时间变异性是与抑郁严重程度最相关的指标。在代谢领域,它推导出一个心血管适能指数(步数除以静息心率),作为胰岛素抵抗的非侵入式相关指标,并将其与此前关于血糖调节和心脏代谢适能的研究联系起来。
大规模发现临床信号
我们将 Biomarker Discovery Framework 部署在三个各不相同的大规模队列上,共计 9,279 个参与者观测,涵盖心理健康和代谢疾病两个领域。
在两个抑郁症领域中,Biomarker Discovery Framework 优先选出了同一类昼夜节律不稳定构念的不同操作化方式。在 DWB 中,睡眠时长变异性与 PHQ-8 严重程度相关(ρ = 0.252,p < 0.001)。在 GLOBEM 中,入睡时间变异性则表现为与 PHQ-4 之间一种探索性的低信号关联(ρ = 0.126,p < 0.001;CV AUC = 0.535)。由于队列、终点和特征定义各不相同,且没有任何一个相同的候选项得到复现,这一模式应被解读为提示性的构念层面趋同,而不是直接复现。
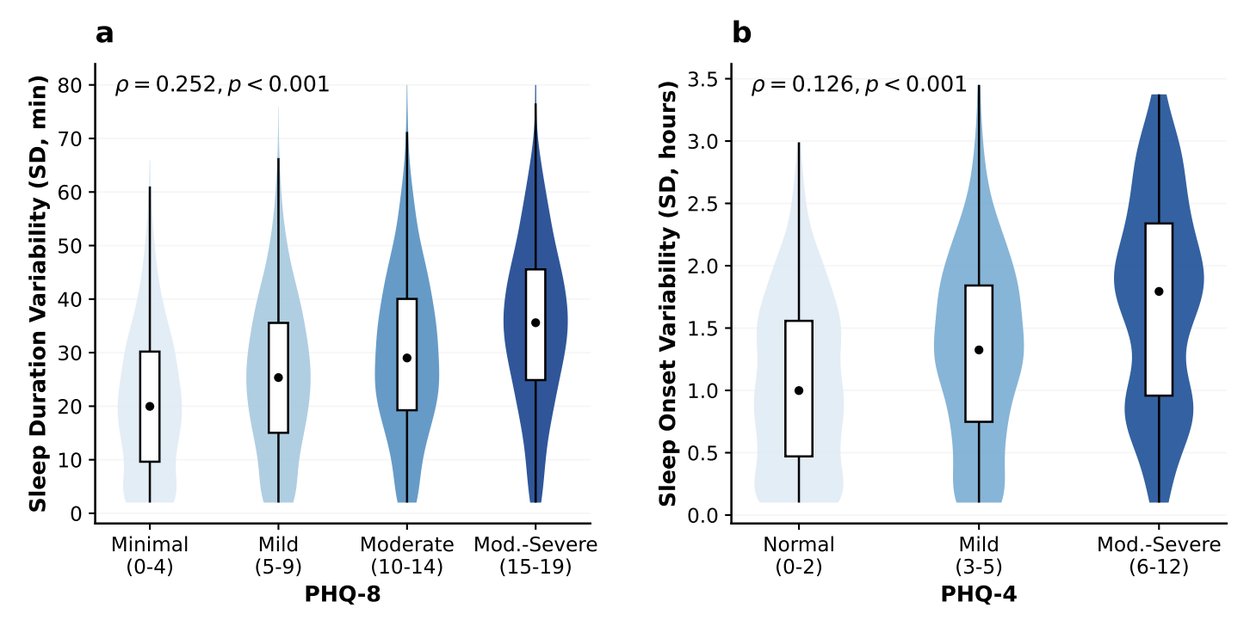 *两个抑郁症队列中相关的昼夜节律不稳定候选项。在两个队列中,变异性都随症状严重程度分组而增加,但这些发现仅用于生成假设,不构成因果证据,也不是直接的跨队列复现。*
总体而言,Biomarker Discovery Framework 识别出 41 个心理健康方面的候选数字生物标志物和 25 个代谢结局方面的候选标志物。尽管效应量体现的是被动感知数字表型分析中典型的较小幅度,但将这些由 Biomarker Discovery Framework 推导出的特征与人口统计学变量结合后,预测性能得到提升(抑郁的 ΔR² = 0.040,胰岛素抵抗的 ΔR² = 0.021)。
人类领域专家的评估
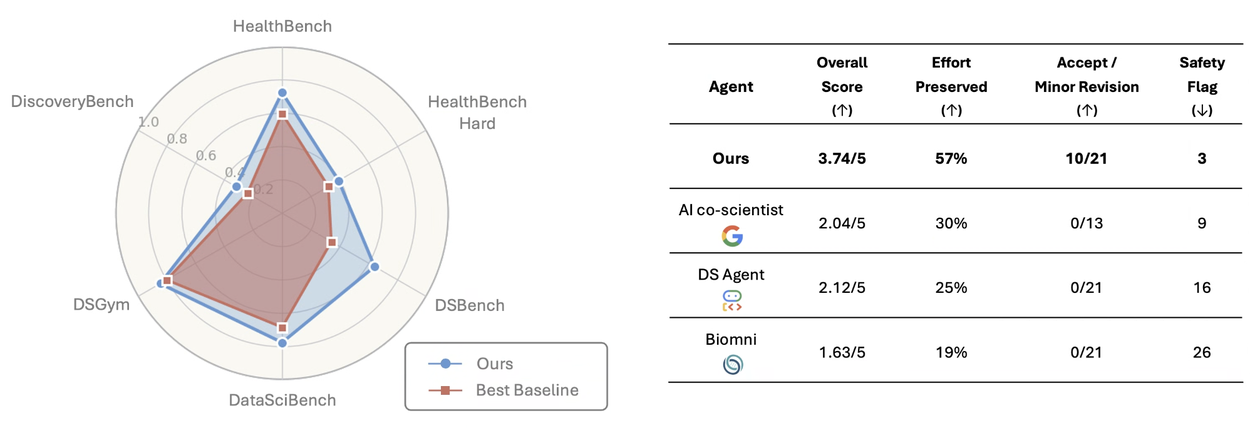
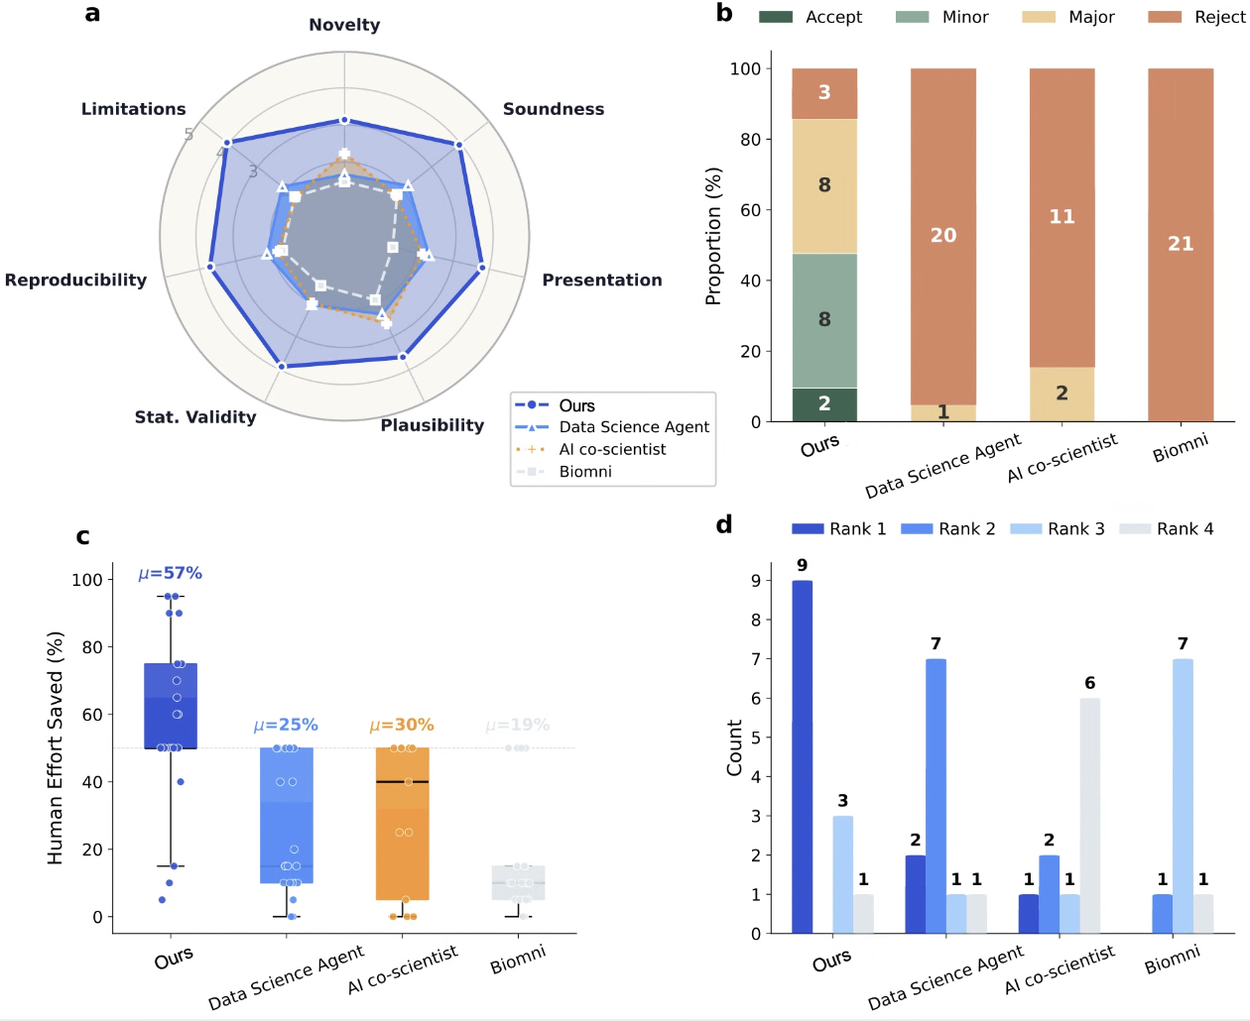
为评估稿件质量,15 位来自医学、生物医学数据科学、机器学习、生物信息学和数字健康领域的专家,对 Biomarker Discovery Framework 与三个当代 AI 研究系统(Google DeepMind 的 AI co-scientist、Biomni 和 Google ADK 的 Data Science Agent)的盲审报告进行了评审。Biomarker Discovery Framework、Biomni 和 Data Science Agent 在 21 个评审环节中一同打分,而 Biomarker Discovery Framework 则在另一组 13 个环节中使用同一评估工具单独打分。
在盲审评估中,Biomarker Discovery Framework 在全部七个质量维度上都获得了最高的平均分。按照本研究模拟的编辑评审标准,它是唯一获得任何“接受”或“小修”建议的系统:2 个接受、8 个小修、8 个大修和 3 个拒绝。评审者估计,他们平均会保留 Biomarker Discovery Framework 所生成稿件内容的 56.9%,而基线系统的这一比例为 18.8%–30.4%;在 13 个四系统排名环节中,有 9 个环节把 Biomarker Discovery Framework 排在第一。
结论
随着可穿戴健康数据在人群中持续扩大规模,数字医学的瓶颈已不再是数据采集,而是有章法、严谨的假设生成。仅靠扩展模型能力并不能解决科学严谨性的问题。然而,当 AI 部署在一个精心构建的架构之中,把确定性计算与生成式推理分离,并迫使智能体对自己的发现展开防御性辩论时,它就能在人类监督下支持结构化的假设生成、验证和优先级排序。通过从黑箱自动化转向透明的、人在回路(human-in-the-loop)的工作流,我们可以构建出能够安全加速临床研究中“假设到验证”循环的 AI 系统。
致谢
本文由 Google Research 的 Yubin Kim、Hamid Palangi 和 Daniel McDuff 撰写。这项工作由 MIT 博士生 Yubin Kim 在 Google 实习期间主导,由 Daniel McDuff 和 Hamid Palangi 指导。我们感谢来自 Google Research、Google DeepMind 和学术界的合著者与合作者对这项工作的贡献。