摘要
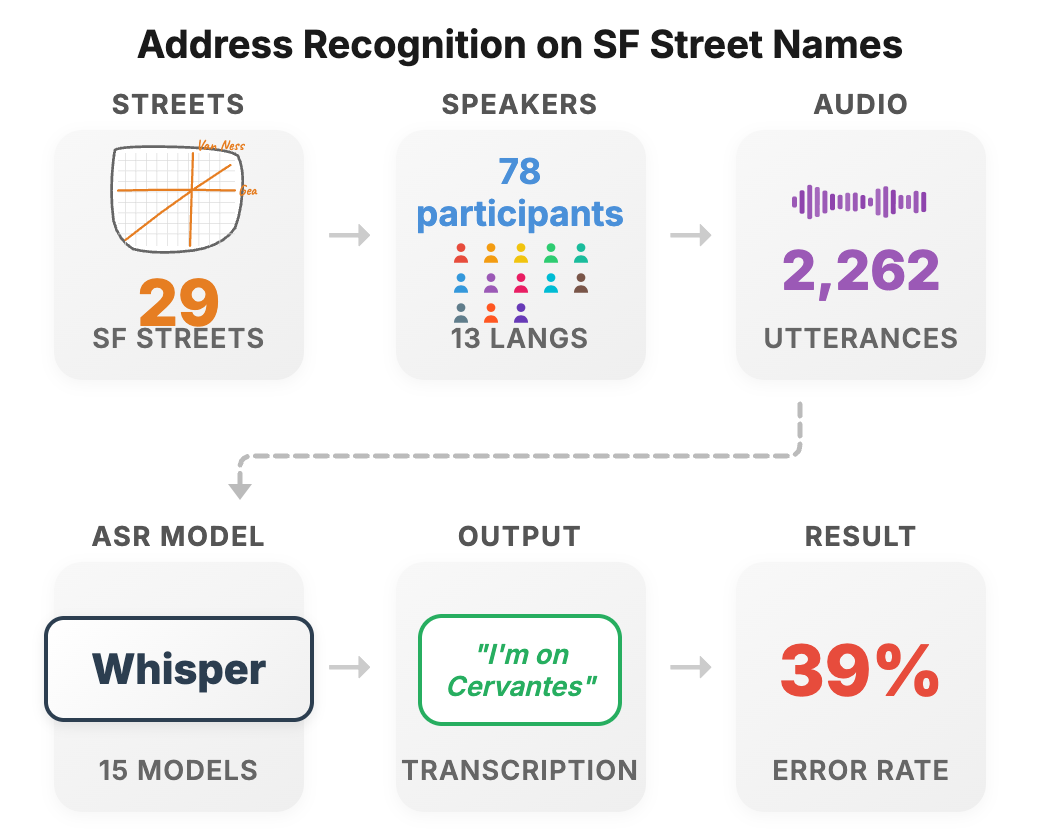
我们证明,当说话者的语言背景各不相同时,语音识别系统很难听懂街道名称的发音:15 个最先进模型的平均转写错误率为 39%,非英语母语说话者与英语母语说话者之间存在 18% 的准确率差距。我们还证明,一种名为“跨语言风格迁移”(cross-lingual style transfer)的合成数据生成技术,只需不到 1,000 个训练样本,就能让错误相对基础模型最多降低 60%。
Whisper、Deepgram、Phi-4 等自动语音识别系统,已是当今数字基础设施的组成部分。这些模型在 Librispeech 和 Switchboard 等语音基准测试上经过标准化测试,在词错误率(Word Error Rate)等指标上接近人类水平。然而,这些只关注单词准确率的聚合指标,往往会掩盖关键错误。最显著的差距之一,是无法在真实世界中可靠地转写简短而事关重大的语句。当用户向导航系统或紧急调度员口述指令时,命名实体上的一个错误,就可能让当事人和调度方都耗费宝贵的时间。
我们的最新研究调查了基准测试表现与真实世界可靠性之间的差距。我们推出了 SF Streets 和 US Streets 两个新基准,用于对已部署系统中的命名实体识别进行压力测试。评估结果显示,即便是来自 OpenAI、Deepgram、Google 和 Microsoft 的最强模型,也在这项任务上表现不佳。为此,我们开发了一套合成数据生成方案,利用跨语言风格迁移,只需不到 1,000 个训练样本,就能将性能提升最多 60%(相对于基础模型)。
STT 基准测试中的地址识别
标准语音基准测试往往以长篇朗读语音为主,语义上下文有助于消解歧义。而街道名称由多语言城市的居民说出时,则是另一种挑战:它们缺乏上下文,声学上千差万别,对语音错误毫不容忍,发音上的细微差别就可能在地图上造成巨大差异。
为量化这一难度,我们收集了 SF Streets 数据集。该数据集包含来自美国、语言背景多元的 78 位参与者的 2,262 条语音,内容是旧金山的街道名称。我们聚焦于该市的林荫大道,例如“Cesar Chavez”或“Alemany”,因为它们是主干道,在导航查询中经常被提及。
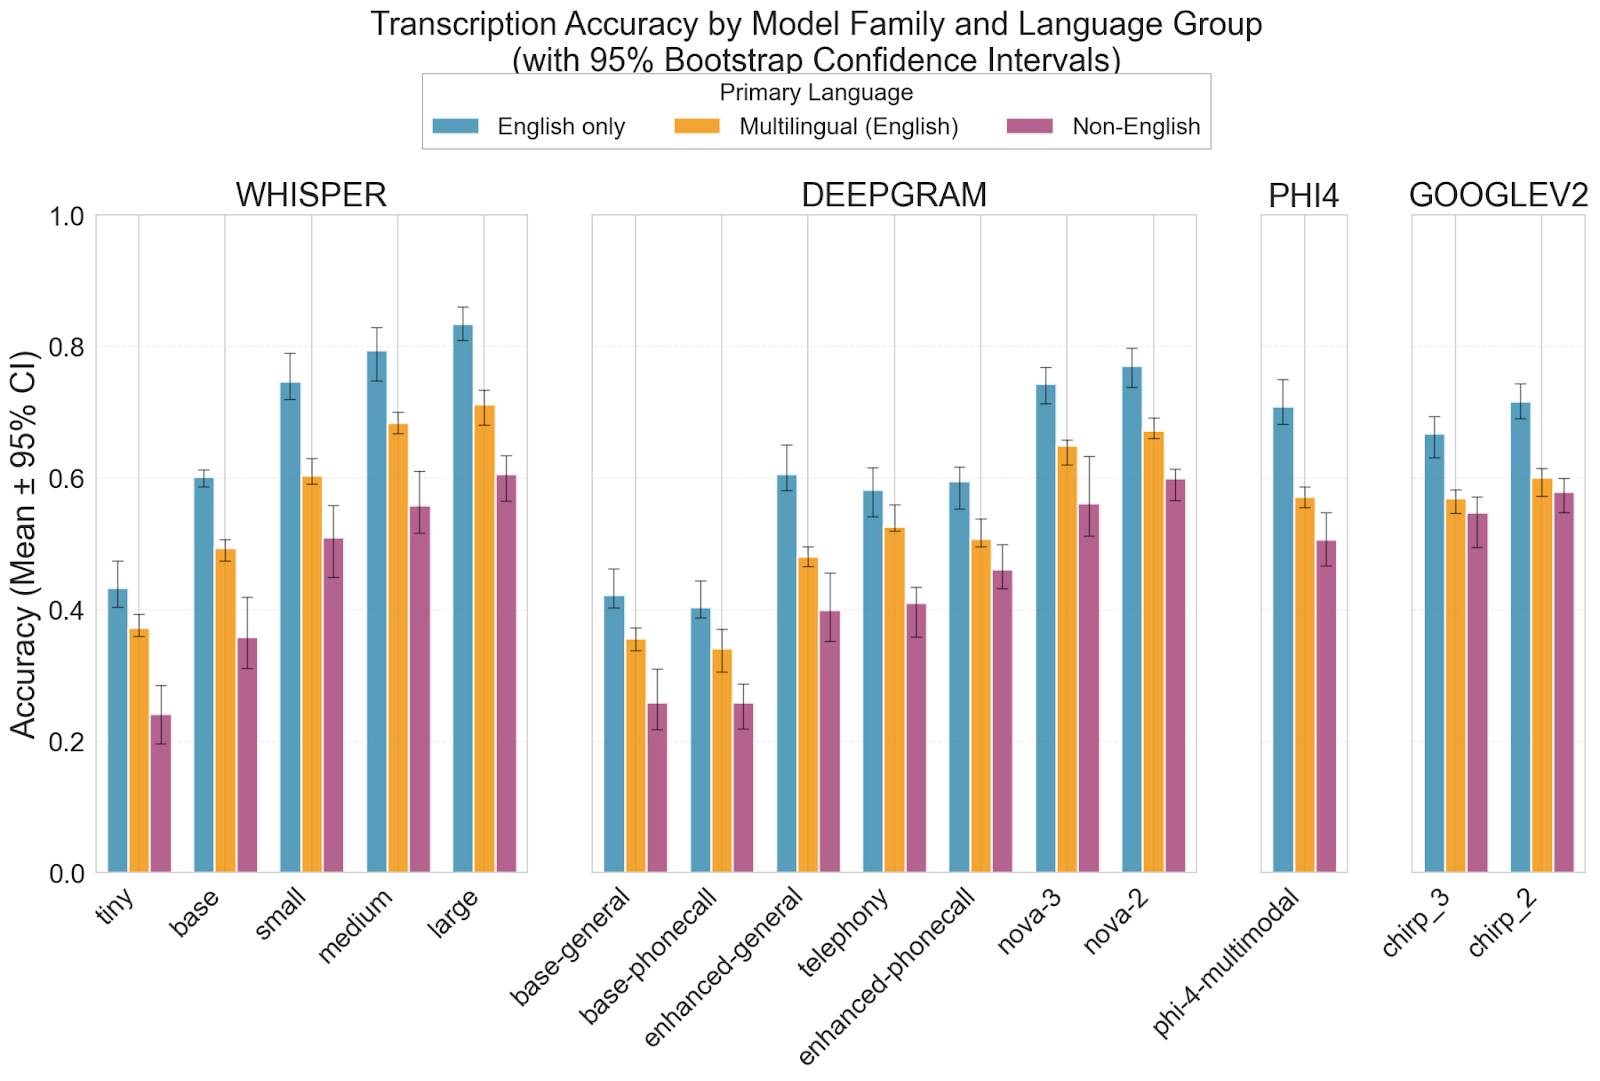
我们在该数据集上评估了 15 个最先进模型。尽管这些模型在通用语音上的 WER 很低,但在街道名称上的平均转写错误率达到 39%。这种脱节挑战了“模型规模会自动解决鲁棒性”的假设。例如,Whisper-Large 的通用词错误率为 14%,表现不错,但在街道名称上的错误率升至 27%。
在旧金山这样的城市,出租车服务为老年人和残障人士提供必不可少且有补贴的交通。这些偏差会造成实实在在的经济损失。根据标准出租车费率表和交通数据,我们估计纠正这些错误所需的额外驾驶时间,每次事件约耗费 \$4.00。按全市每年的出租车运量汇总,仅转写错误一项,每年就可能造成约 43,500 小时本可避免的延误,折合每年约 \$2.1 million 的时间和车费浪费。
人群构成与差异化影响
这些系统的可靠性在不同群体之间差异显著。随着现代语音模型被部署到多元的城市环境中,它们会遇到口音和语言背景各不相同的说话者。我们对 SF Streets 数据的分析揭示了显著的性能差异。在我们的 15 个模型及模型变体上,非英语母语说话者的准确率比英语母语说话者低 18%(46% 对 64%)。
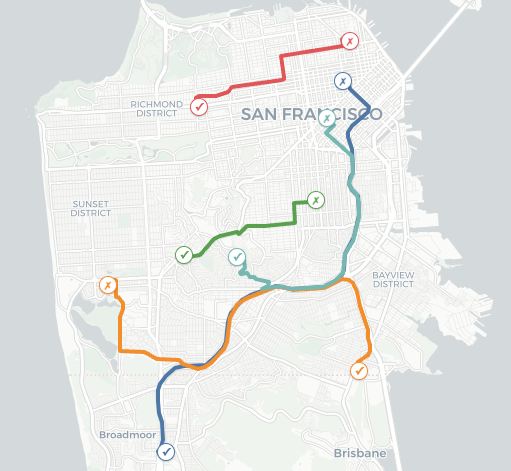
这种技术故障直接转化为更实际的运营摩擦。为衡量真实世界的后果,我们用 Google Maps API 把转写出的街道名称映射到地理坐标,发现非英语母语说话者的误转写导致的路线目的地,平均偏离预期位置 2.40 英里;仅说英语者的错误造成的偏差较小,为 1.26 英里。
通过数据克隆提升代表性
为每一个可能的命名实体收集具有代表性的真人语音数据,成本高得令人望而却步,也无法规模化。因此,我们研究了合成数据能否帮助弥合这一差距。
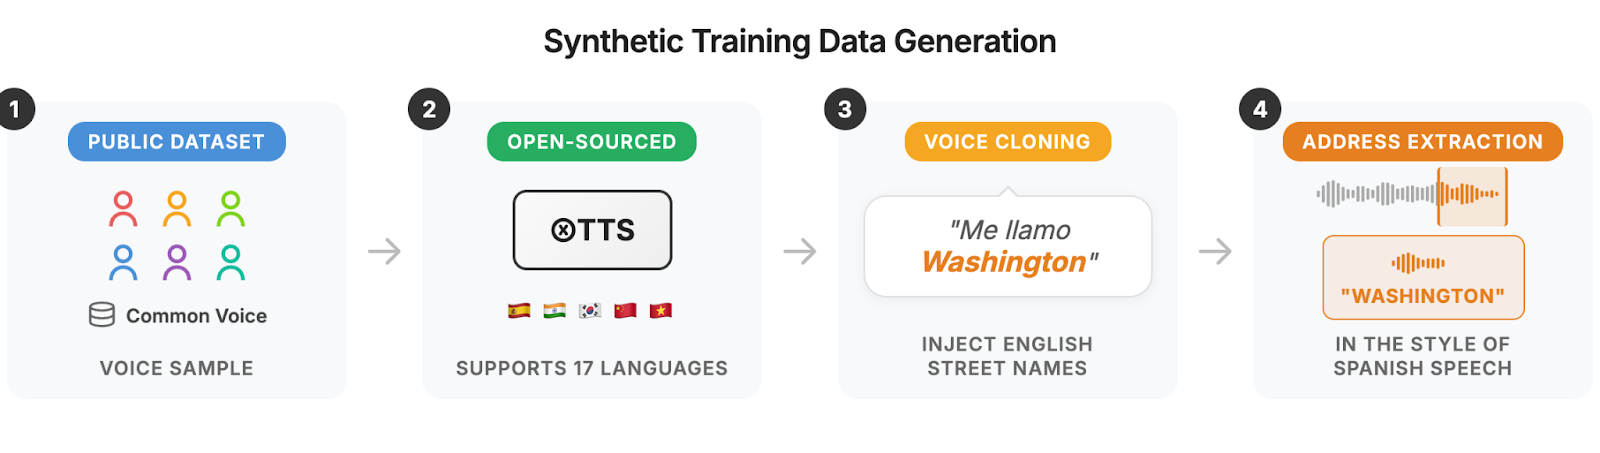
我们利用了多语言文本转语音模型固有的偏差,采用了一种我们称为跨语言风格迁移的技术。我们提示开源的 XTTS 模型用西班牙语等外语生成语音,但在提示中注入特定的英语街道名称。这迫使模型把非英语的音系规则应用到英语单词上。用“Estoy en Washington”提示模型,会让“Washington”一词带有明显的西班牙语发音特征。
这种方法让我们无需真人说话者,就能生成高度多样的发音。我们用不到 1,000 条这样的合成语音创建了微调数据集。在这个小规模合成数据集上微调 Whisper-Base,准确率相对基础模型提升了 60%,其中非英语母语说话者的提升最大。这说明,小规模的合成与开源语音克隆,可以显著改善命名实体的转写。
未来展望
我们的工作凸显了现代语音识别中一个长期存在的弱点。通用模型虽在不断进步,但在短小而信息密集的语句上仍然失败得格外多,而这些语句恰恰驱动着紧急调度和导航等关键系统。不过,我们也证明这是一个可以解决的问题。创造性地运用合成数据和风格迁移,让从业者无需进行大规模、高成本的数据收集,也能提升模型的鲁棒性。
为促进后续研究,我们将发布 SF Streets 数据集和规模更大的 US Streets 基准。US Streets 数据集包含来自美国 12 个主要城市的 3,600 条录音。我们希望这些资源能帮助社区超越聚合指标,关注部署中最重要的可靠性。