AI 智能体从根本上改变了推理工作负载的复杂度。迄今为止,业界一直难以确立一套标准,来衡量推理系统在这类条件下的表现。Artificial Analysis 的 AgentPerf(AA-AgentPerf)是业界首个多厂商开放基准测试,其剖析的轨迹能够代表真实世界中 AI 智能体的编码任务。
本文介绍 AA-AgentPerf 如何为衡量智能体工作负载性能树立新标准,以及 NVIDIA 的极致协同设计如何让智能体编码性能比上一代最高提升 20 倍。
什么是 AA-AgentPerf?
AA-AgentPerf 是由 Artificial Analysis 创建的硬件基准测试,用于衡量推理系统在满足预先设定的、针对特定模型的性能服务级别目标(SLO)档位的前提下,能够支持的并发 AI 智能体数量。SLO 被定义为输出词元速度和首词元时间(TTFT)的特定阈值。基准测试结果按每个加速器和每兆瓦进行归一化,以便在不同硬件配置之间比较。
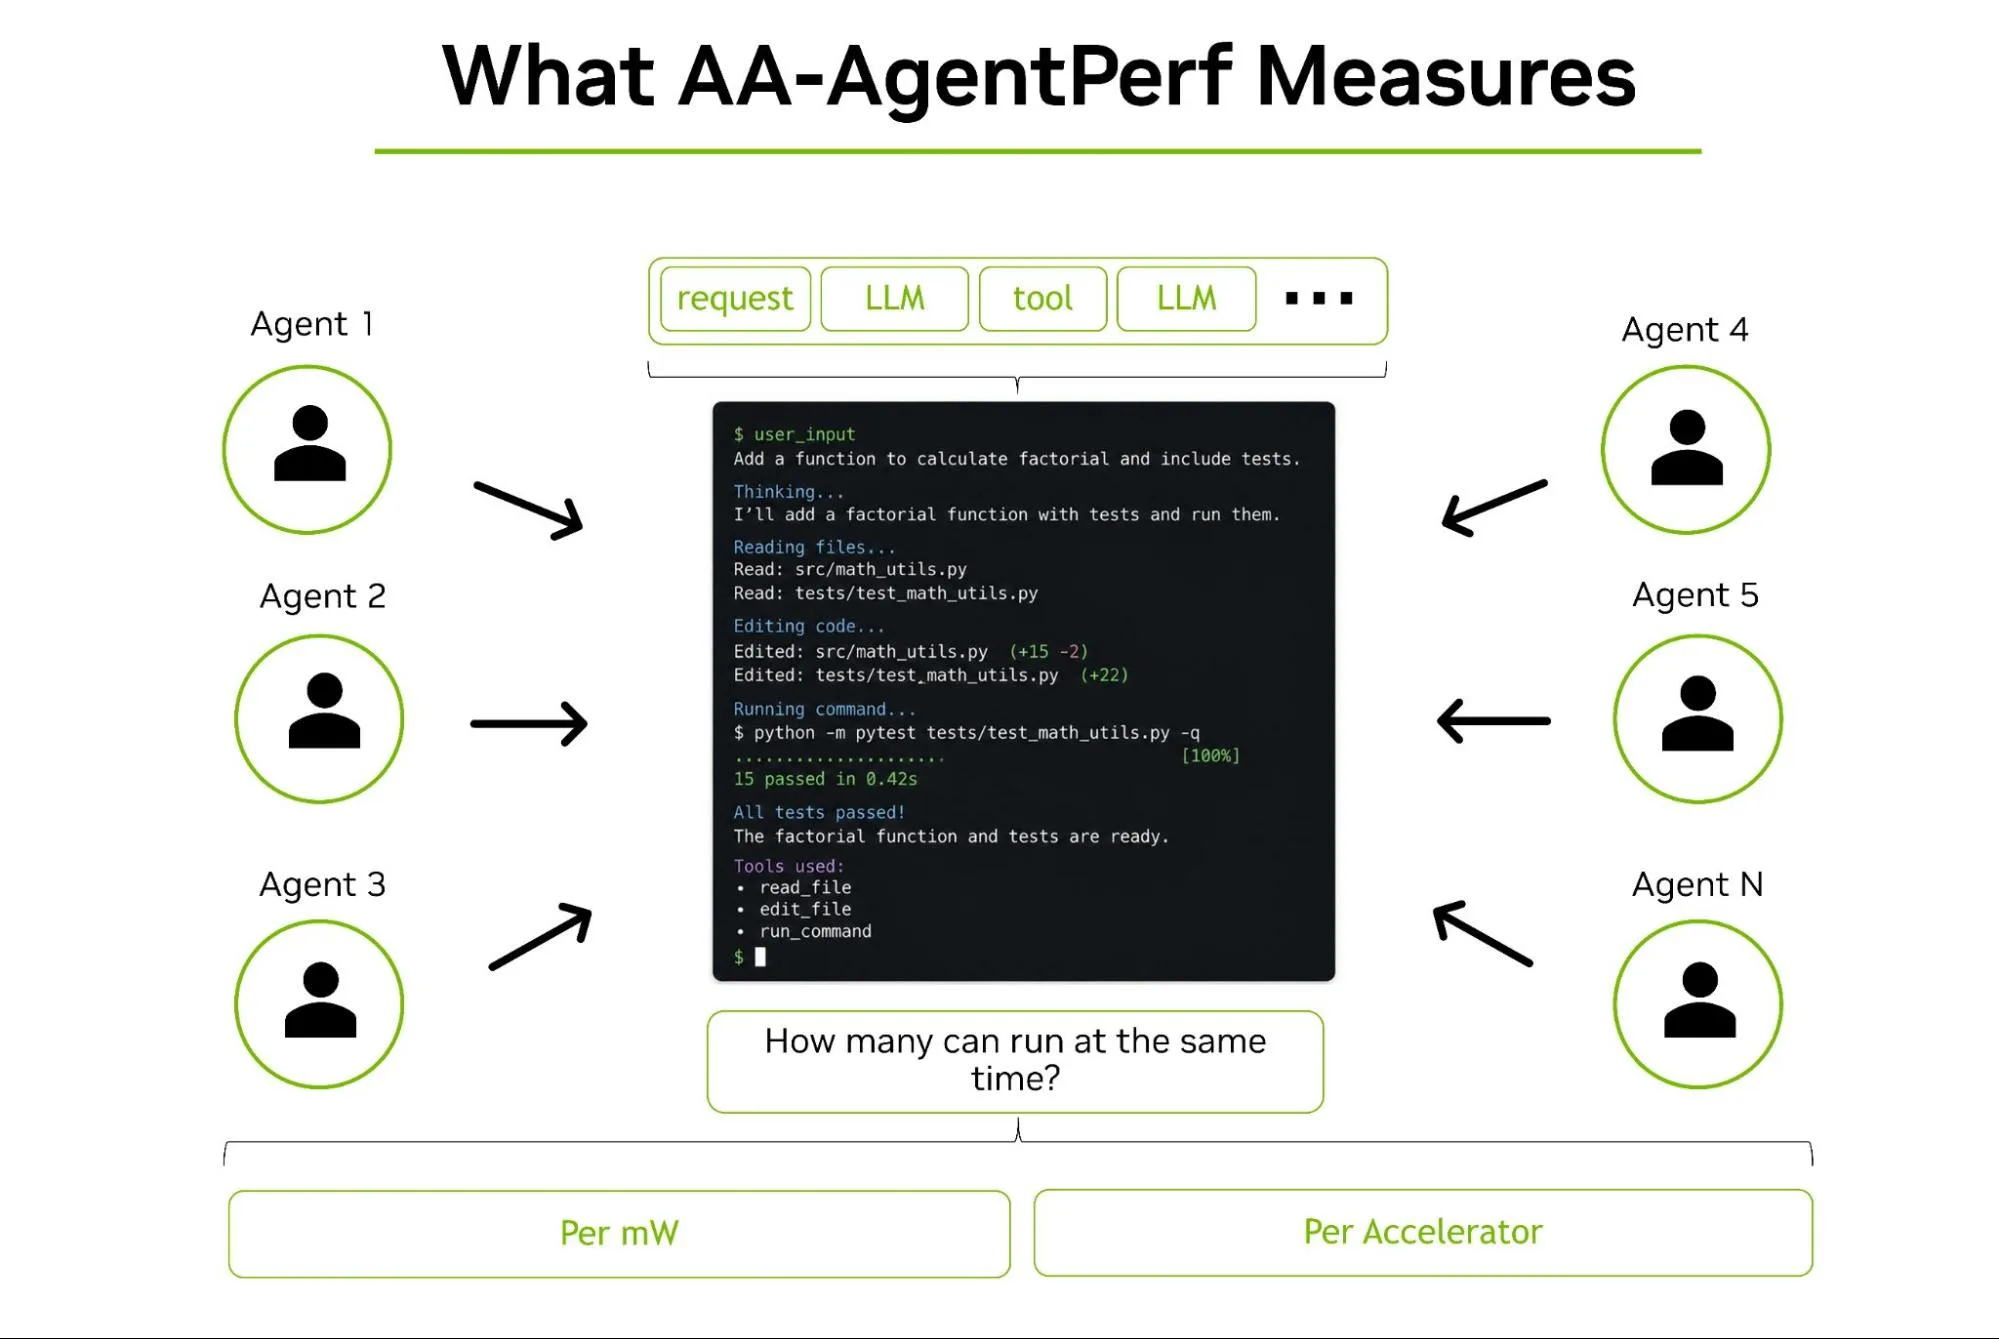
衡量具有代表性的智能体编码性能
智能体工作负载的独特之处在于,由 LLM 驱动的决策往往会产生非确定性的请求和工具调用序列。衡量智能体性能最困难的部分,是在一条具有代表性的智能体轨迹中准确刻画这种非确定性。所谓智能体轨迹,是指智能体从头到尾完成一项任务的过程中所做的全部动作、决策和观察所构成的完整序列(图 2)。
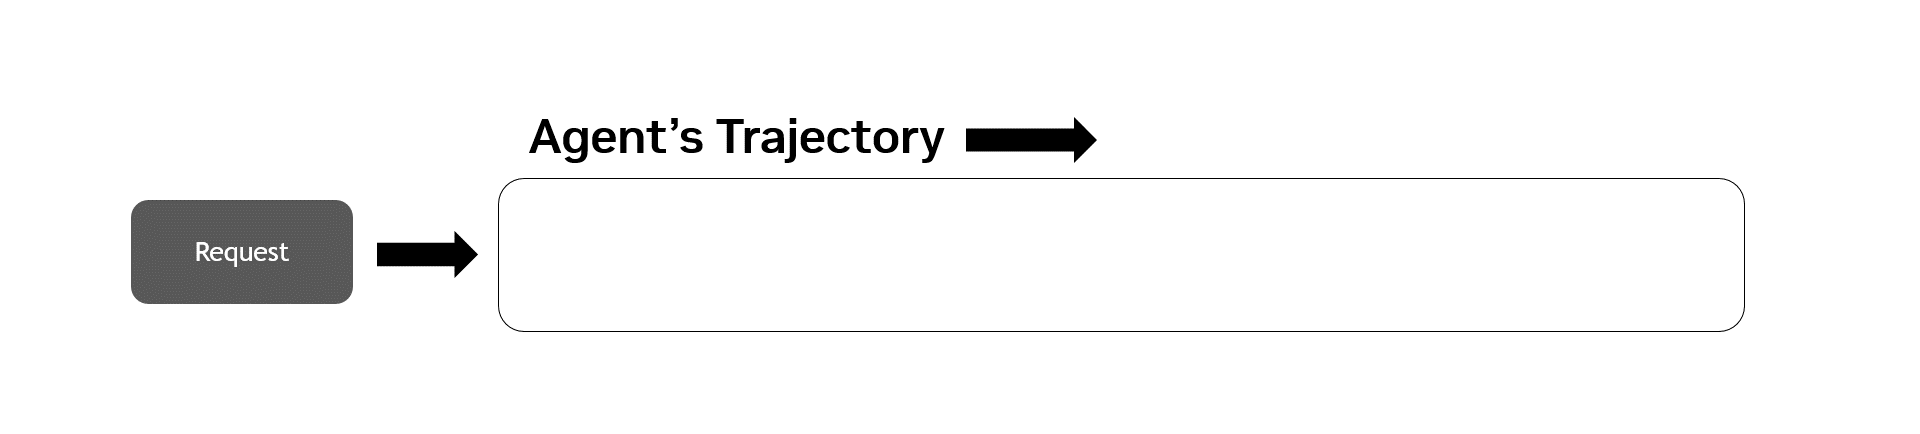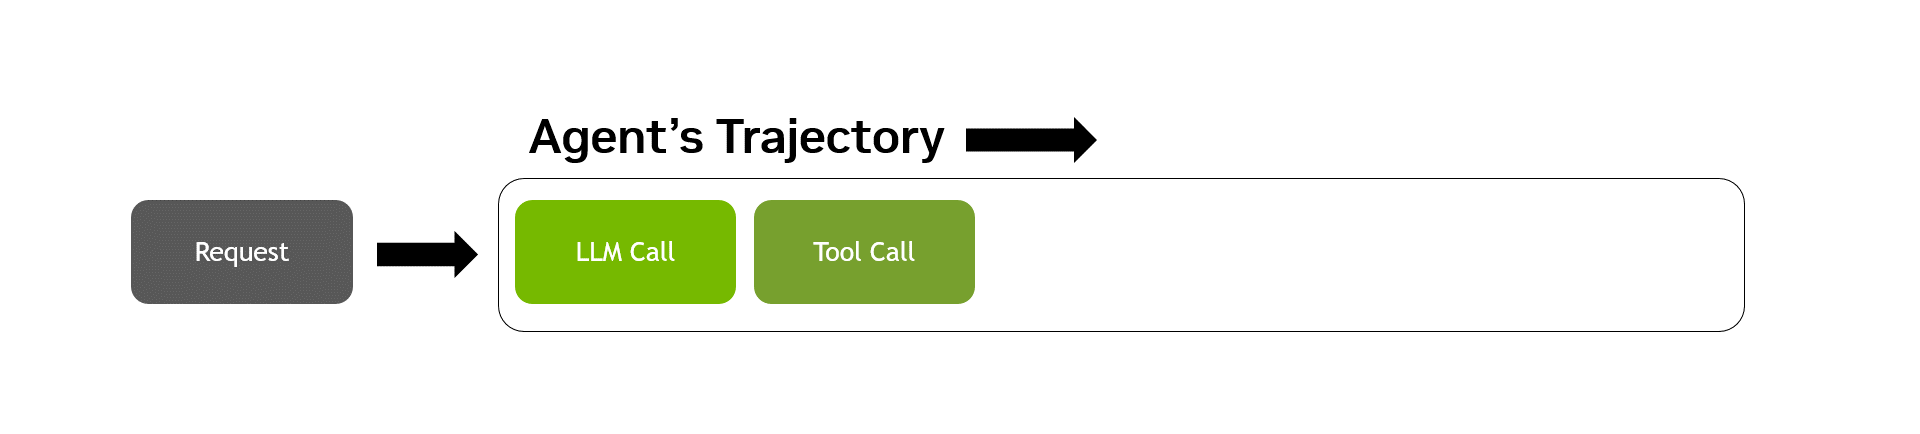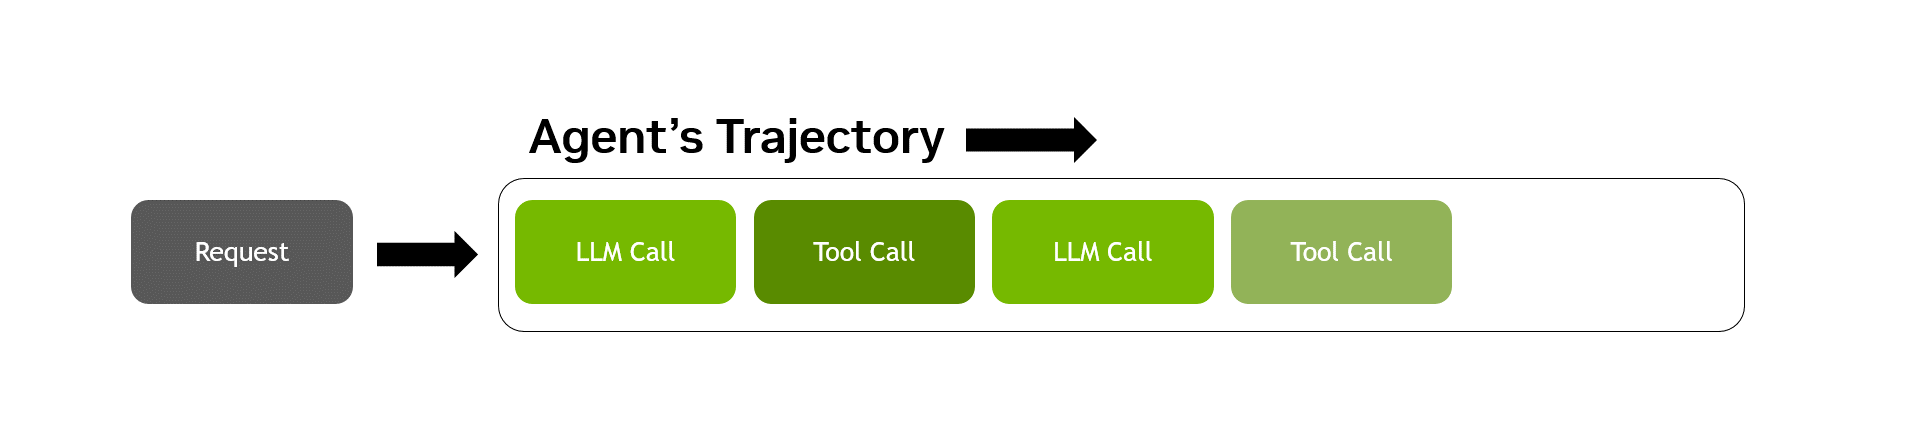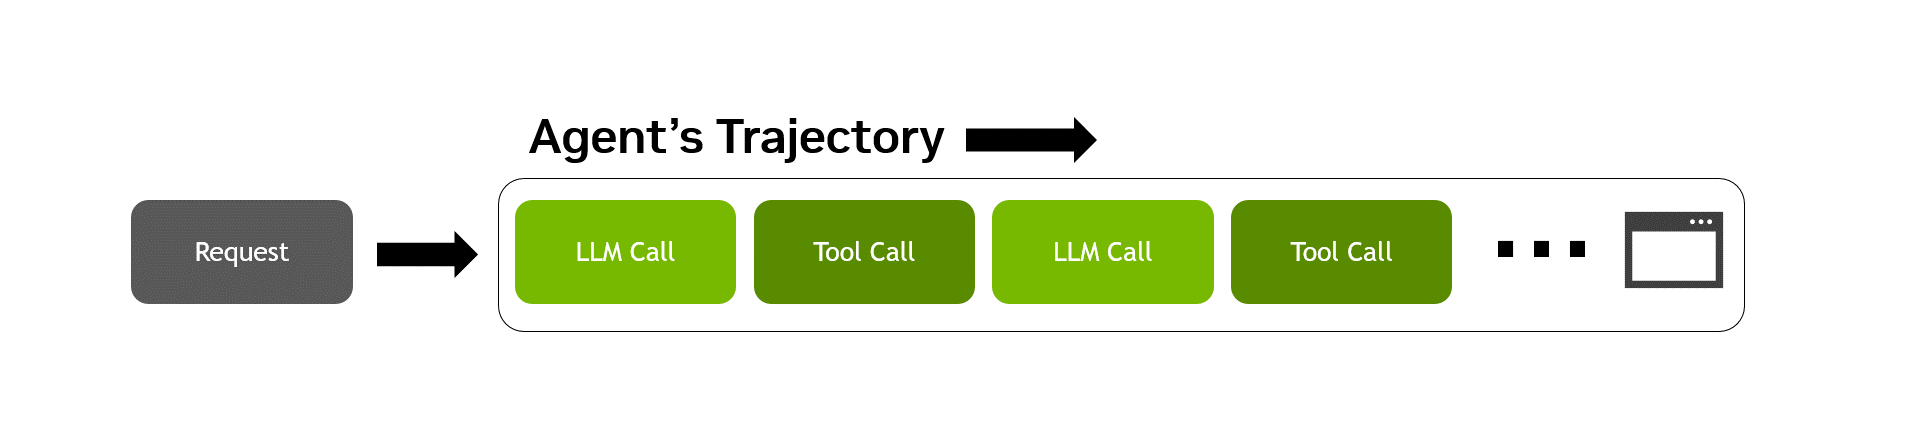
AA-AgentPerf 的做法是,在预先录制的、交错包含推理与工具使用的智能体编码轨迹上衡量 GPU 性能,同时用一个具有代表性的 CPU 工具调用性能基线来模拟轮次之间的延迟。这些轨迹围绕解决公开代码仓库中的问题构建,涵盖多种用例、12 种以上编程语言,以及前沿模型的响应。除了对轨迹作出严格定义之外,Artificial Analysis 团队还:
- 采用了具有代表性的缓存、输入和输出请求序列长度,范围从 5K 到 131K,平均约为 27K。
- 将工具调用映射到智能体编码工作流中具有代表性的 CPU 侧任务,并按延迟时间中位数为一秒的分布模拟工具调用。随后,所有被测系统都采用同一套 CPU 工具调用基线。
- 对测试集保密,以防止针对基准测试的优化。
AA-AgentPerf 的测试与测量方法
AA-AgentPerf 测试框架衡量的是,推理系统在满足 SLO 要求的前提下能够支持的并发智能体数量(图 3)。基准测试在发布时侧重于测试 DeepSeek-V4-Pro,覆盖多个 SLO 档位,这些档位源自 Artificial Analysis 的无服务器 API 基准测试数据。这确保了基准测试反映的是当前生产环境服务商所呈现的服务质量水平。
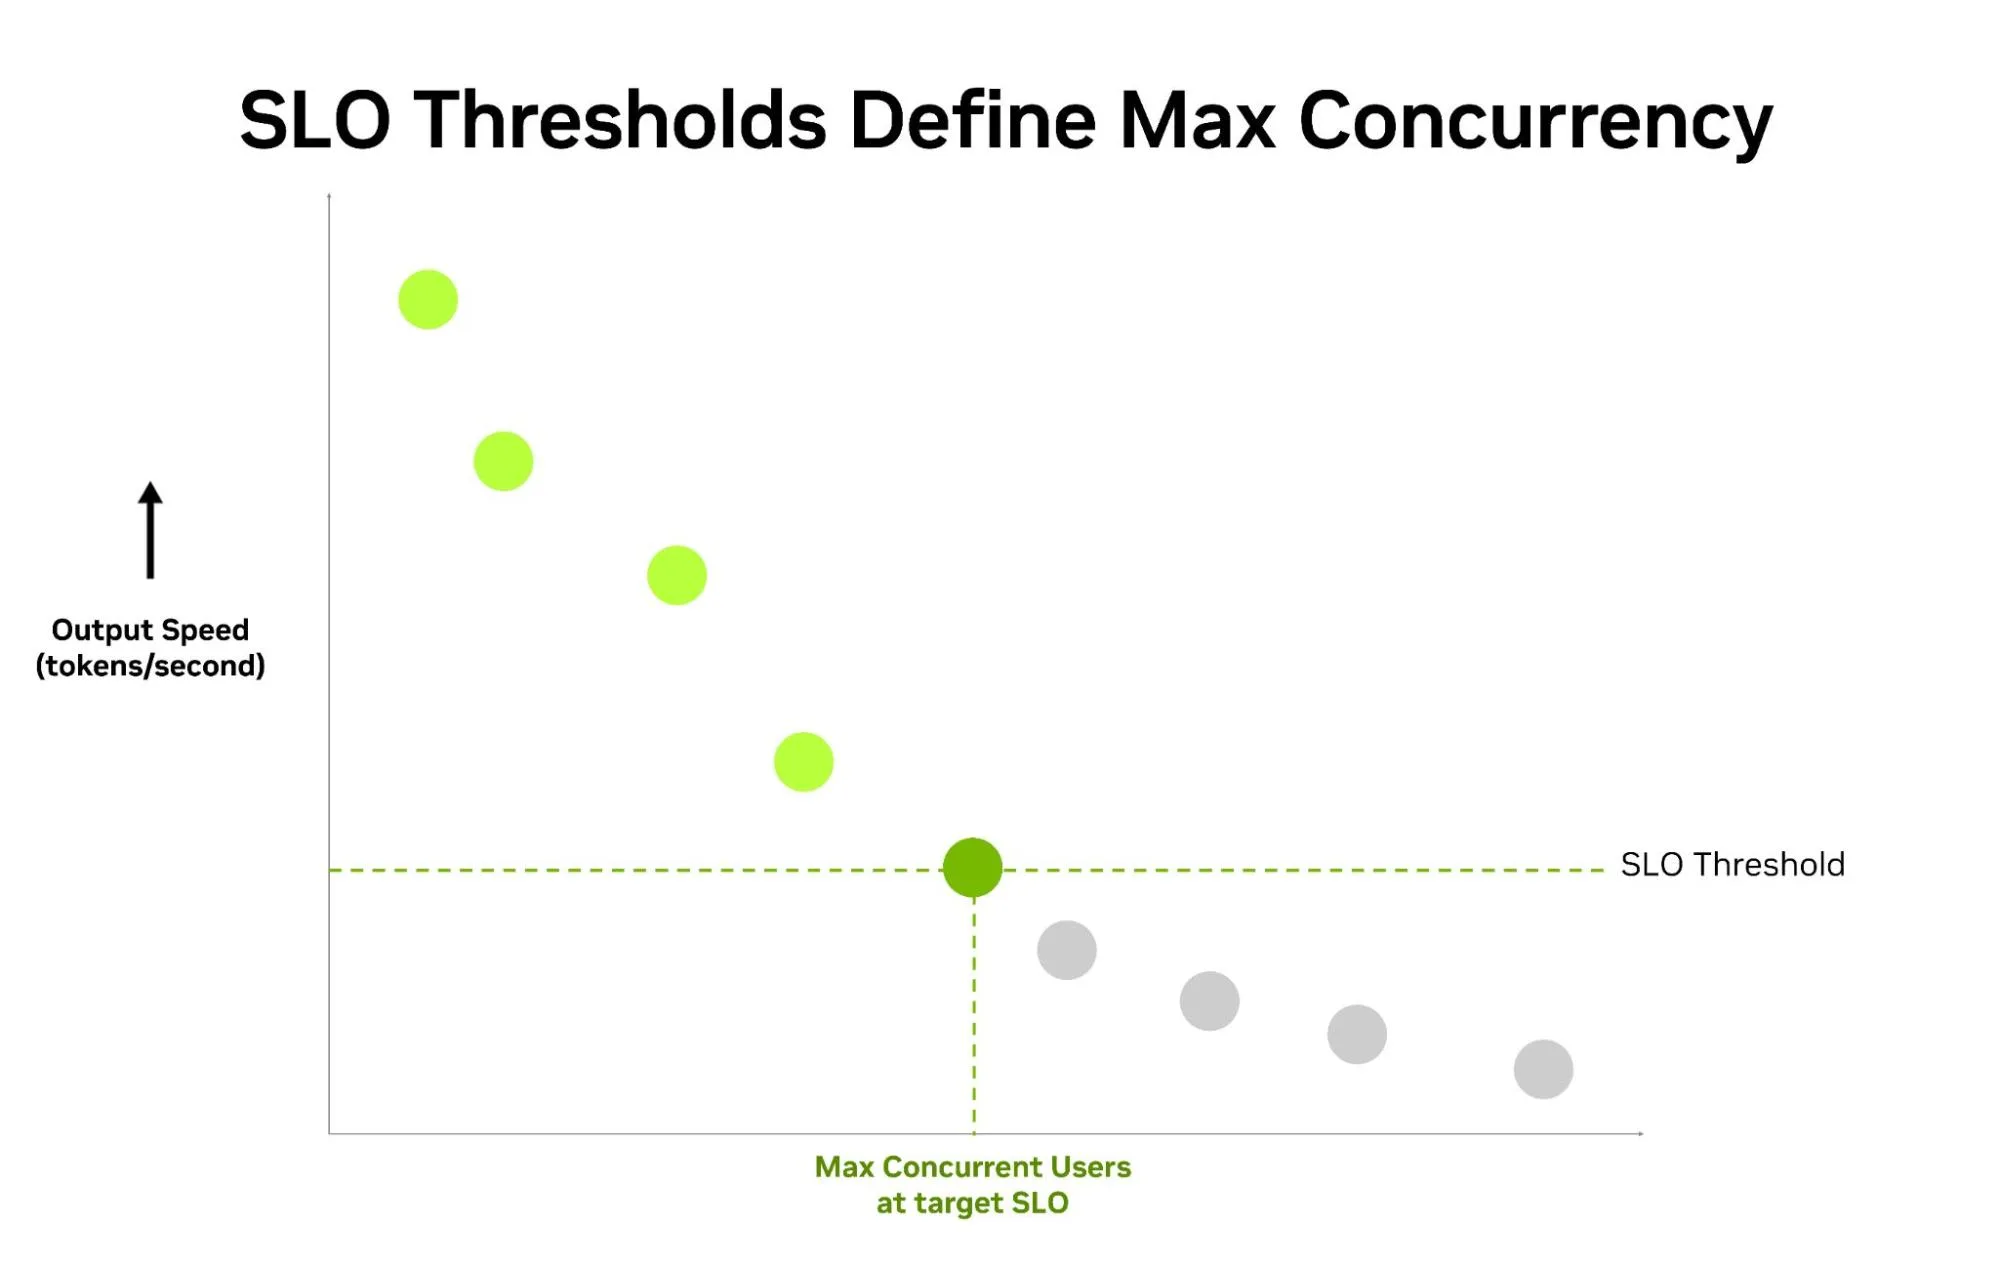
在基准测试运行期间,AA-AgentPerf 会向 GPU 发送数千个并发请求,这些请求取自其预先录制的智能体轨迹数据集。为确保每次运行的结果相互独立,会在每个轨迹阶段的开头添加动态前缀。整个轨迹期间都会严格执行 SLO 阈值,满足这些要求的最高并发水平会被记录为给定 SLO 下的官方基准测试结果(图 3)。随后,这一过程会在多个 SLO 档位上重复,以覆盖不同的用户体验目标(表 1)。
| 模型 | SLO 档位 | P25 输出速度(词元/秒) | P95 TTFT(秒) |
|---|---|---|---|
| DeepSeek-V4-Pro | SLO #1 | 30 | 10 |
| SLO #2 | 100 | 5 | |
| SLO #3 | 300 | 3 |
如何解读 AA-AgentPerf 的结果
AA-AgentPerf 的核心指标是每兆瓦运行功率下的表现,这是一种用于体现数据中心规模性能的实用归一化方式。表 2 说明了如何利用所报告的性能,估算在给定功率预算下能够支持多少个智能体会话。
表 2. 如何利用 AgentPerf 报告的指标,为旨在大规模支持智能体应用的数据中心做容量规划。数字反映的是 SLO=30 配置下的 AA-AgentPerf 结果
| 基准测试 | 指标含义 | NVIDIA GB300 NVL72 | NVIDIA H200 |
|---|---|---|---|
| 每 MW 并发智能体数 | 能效:在给定功率预算下,系统能够支持多少活跃智能体 | 61.4K | 2.6K |
| 每 GPU 并发智能体数 | 硬件效率:每块 GPU 能达到多大的服务容量 | 57.5 | 1.4 |
在发布当天,NVIDIA GB300 NVL72 每兆瓦可支持的并发智能体数量,比上一代 NVIDIA H200 最多高出 20 倍(图 4)。
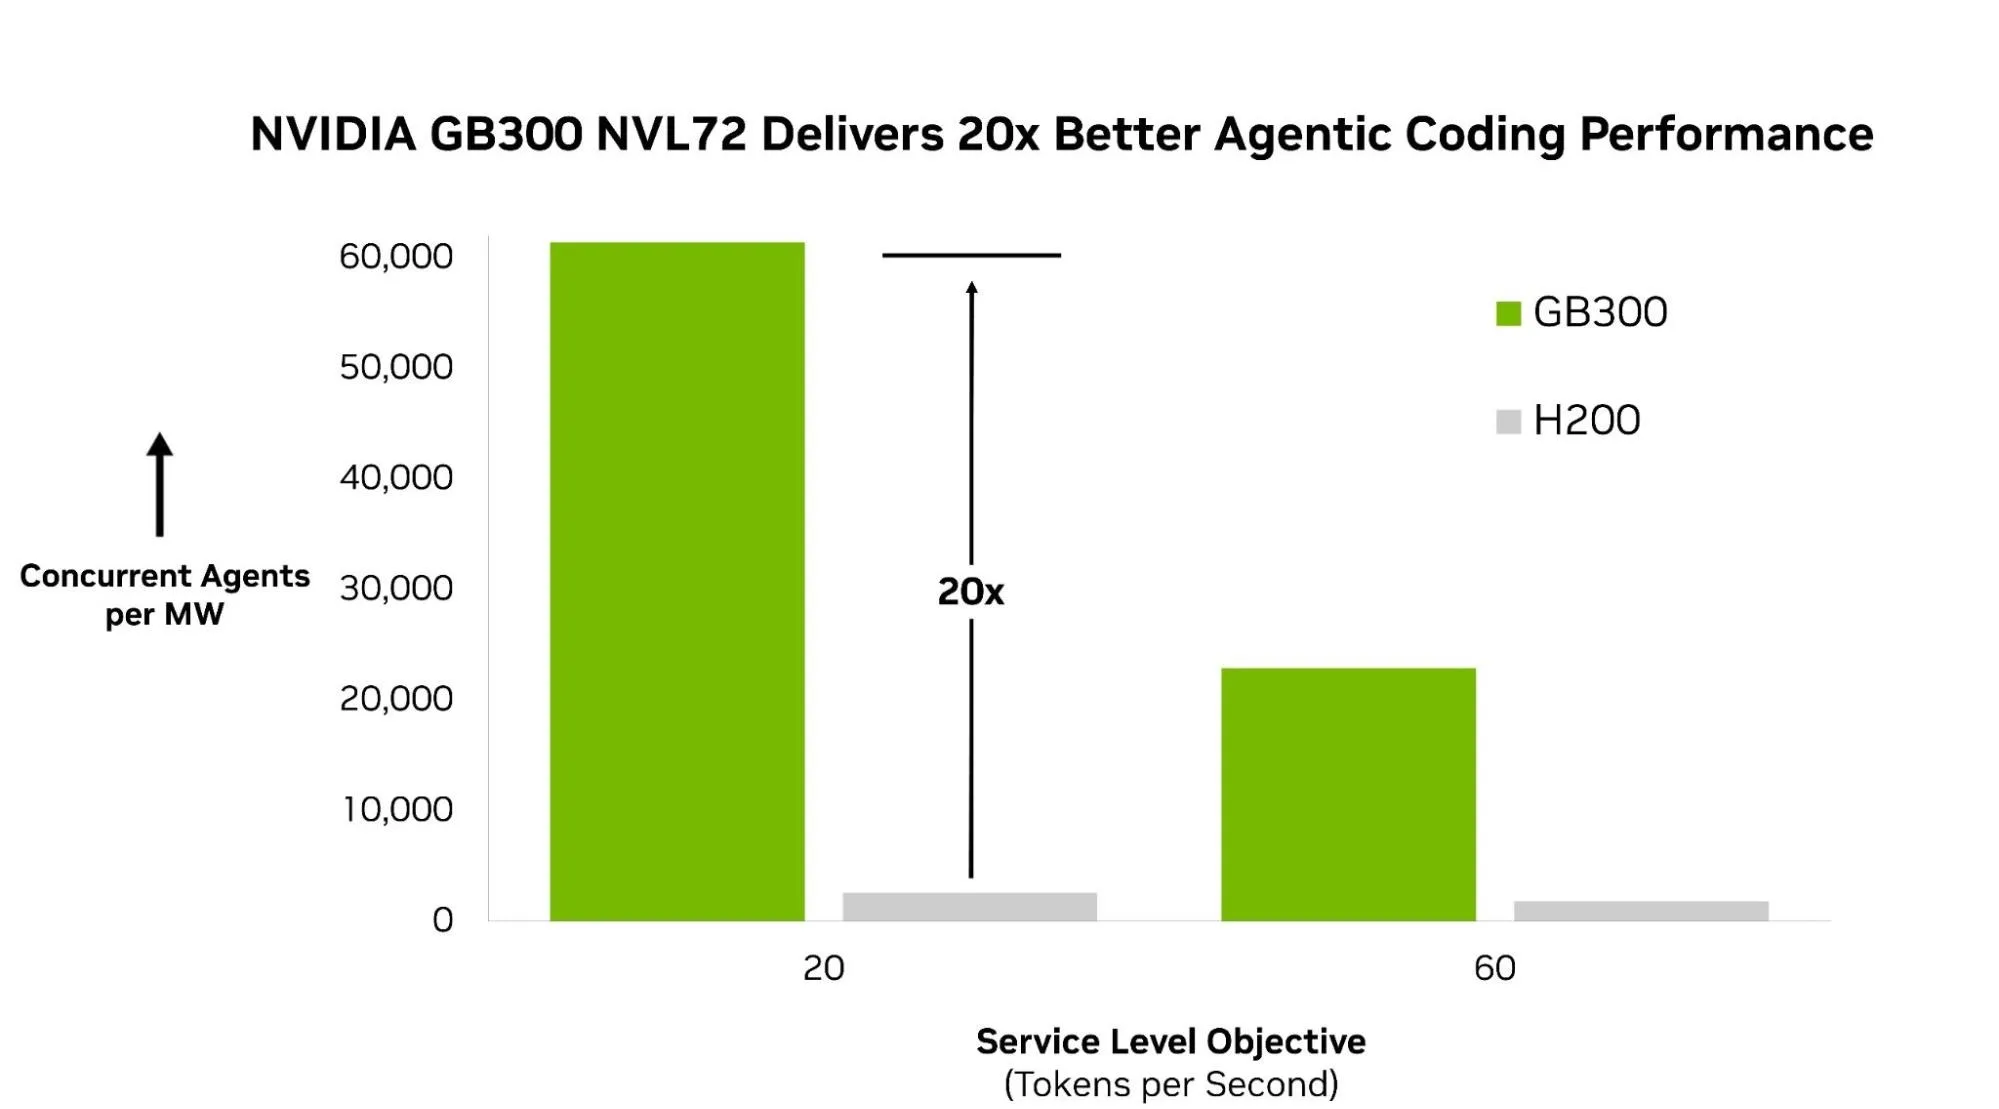
这一表现凸显了 GB300 NVL72 在大规模智能体编码工作负载上的交付能力:从高效路由长时间存活的会话,到在大量并发智能体会话中让混合专家模型(MoE)和 GPU 保持充分利用。
- SGLang、TensorRT LLM 或 vLLM:智能体运行时应用 WideEP 和 DeepEP 等优化,将 MoE 专家的执行分散到整个 NVL72 域,使有效批大小最大化,并有效扩展到数千个智能体。
- DeepGEMM 与 Mega MoE 优化:MXFP4/MXFP8 内核和融合 MoE 让 NVLink 通信与张量核心计算重叠,从而提升推理和代码生成的词元吞吐量。
- NVIDIA NVLink 纵向扩展域:GB300 NVL72 将 72 块 GPU 连接成单一的高带宽 NVLink 互连结构,使每块 GPU 都能快速共享参数、KV 缓存和中间结果,这对智能体编码系统的快速协同执行至关重要。
展望:NVIDIA Vera Rubin 平台
AA-AgentPerf 确立了评估智能体推理的标准,其结果也凸显出,软硬件紧密集成能够在并发度和效率上带来阶跃式的提升。NVIDIA GB300 NVL72 展现出最高 20 倍的智能体编码性能提升。
NVIDIA Vera Rubin 平台预计将进一步扩大这些优势:它拥有 50 PFLOPs 的 NVFP4 算力,并借助 Vera CPU 加速 LLM 工具调用,从而提升智能体工作流的端到端性能、经济性和效率。
若想进一步了解智能体工作负载为何对推理基础设施提出独特要求,以及 NVIDIA Vera Rubin 平台如何优化性能,请参阅以极致协同设计应对日益复杂的智能体系统。
致谢
这项工作得以完成,离不开 Jatin Gangani、Iman Tabrizian、Xiaoming Chen、Peiheng Hu、Taizhong Wu、Shichen Li、Manu Maheswari 以及许多其他才华横溢的 NVIDIA 工程师的专业知识和工程贡献。