事实性是大语言模型(LLM)可靠的关键。当模型错误地回答了一个事实性问题,是因为这个事实从未被编码,还是因为事实已被编码却无法被调取?标准的准确率指标把这两种情况混为一谈,尽管它们指向截然不同的局限,也需要截然不同的干预。编码失败需要扩大模型规模或扩展数据覆盖面,而回忆失败则可能还指向后训练和推理阶段的方法,帮助 LLM 更好地利用其已编码的内容。
在《空书架还是丢失的钥匙?回忆是参数化事实性的瓶颈》(Empty Shelves or Lost Keys? Recall Is the Bottleneck for Parametric Factuality)一文中,我们提出了知识画像(knowledge profiling),这是一个同时衡量编码和回忆的行为学框架,并用它来考察前沿 LLM(如Gemini3和GPT-5)事实性背后的瓶颈。随后我们表明,前沿 LLM 中的许多事实性错误,更应被理解为丢失的钥匙(回忆失败),而不是空书架(编码失败)。
类比而言,我们用编码表示事实在参数中的表征,用回忆表示在没有外部线索的情况下检索已编码的事实,用识别表示当正确事实与其他选项并列呈现时辨认出它。为支持这一分析,我们提出了WikiProfile,这是一个包含 2,150 条源自维基百科的事实的基准测试,每条事实配有十个问题,分别考察编码、回忆和识别。
核心思想:知识画像
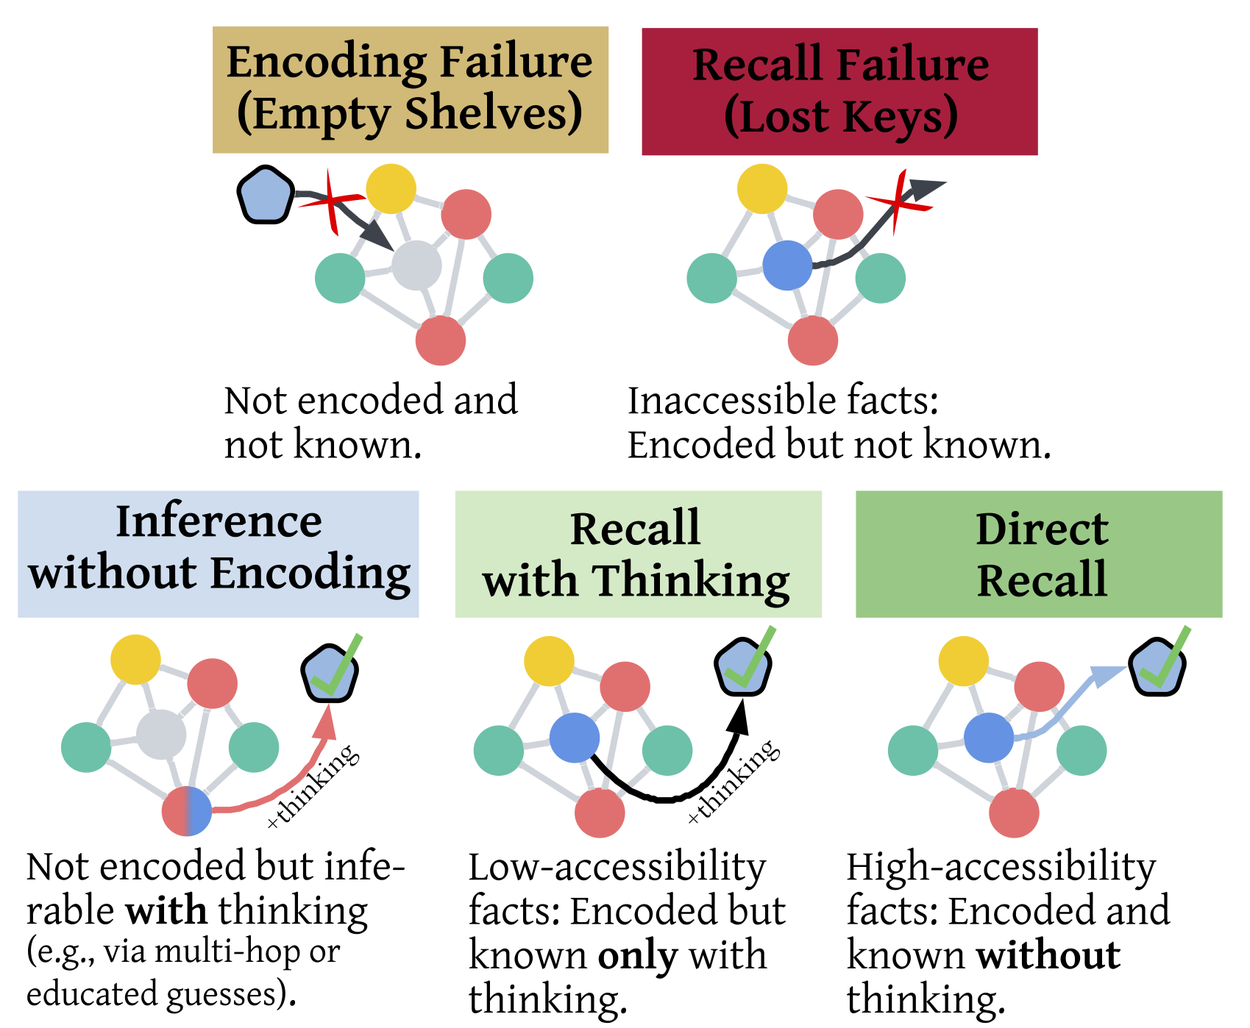
知识画像把分析单位从单个问题转移到事实上。我们不再问模型是否正确回答了某个具体问题,而是问一个更宽泛的问题:这条事实处于什么状态?我们把每条事实归入五种知识画像之一:(1)编码失败,(2)回忆失败,(3)直接回忆,(4)借助思考的回忆,以及(5)无编码的推断。这些画像比单纯的问题级准确率提供了更有信息量的诊断。
分类依据是事实是否被编码以及它的可获取程度:无法回忆、可以直接回忆,或只有借助思考才能回忆(在给出最终答案之前先引出中间计算,包括思维链提示和针对思考优化的 LLM)。
我们用三个行为学概念来落实这一点:
- 编码:如果模型能在类似预训练的语境中正确复现某条事实,就说它编码了这条事实。在我们的设置中,我们用命题补全和语境提问来衡量这一点,二者把模型置于与该事实在预训练期间自然出现时相似的语境中(且不透露答案),从而引导模型暴露该事实是否已被编码。
- 知识:如果模型能在不同措辞下正确回答关于某条事实的语义等价问题,包括正向问题和反向问题,就说它知道这条事实(例如,若 *A 是 B*,正向问题问“B 是什么?”,反向问题则问“A 是什么?”)。
- 回忆:如果模型知道一条已编码的事实,就说它回忆了该事实。如果不借助思考就能回忆,我们称之为直接回忆。如果它知道一条未被编码的事实,我们称之为无编码的推断。这只发生在启用思考、且模型依赖其他已编码事实进行多跳推理或有依据的猜测时。
 *上:我们从维基百科(预训练数据的主要来源)中提取事实。 左:我们通过提示 LLM 在原始语境中复现事实来衡量编码。 右:我们通过在不同措辞和关系方向上提问来衡量知识,分为启用思考和不启用思考两种情况。*
WikiProfile 简介
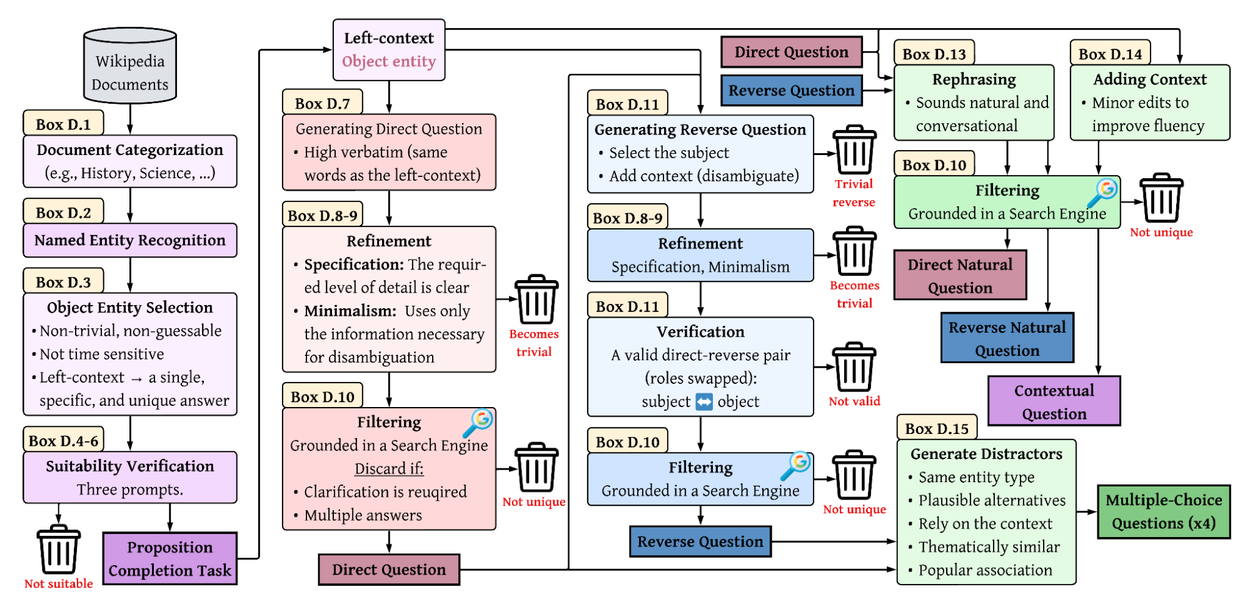
为了落实知识画像,我们构建了WikiProfile,这是一个旨在衡量自然出现的事实上的事实性的基准测试。WikiProfile 通过一条完全自动化的流水线构建,由一个经过提示的 LLM(启用思考的 Gemini-2.5-Pro)驱动。提示词是在一小部分留出的子集上通过人工优化得到的。我们从维基百科页面中提取候选事实,其定义是:涉及一对有序实体(主语和宾语)的命题,且主语在文档中首先出现。每条事实配有 10 个任务:两个用于编码,四个用于知识评估,四个多选变体用于识别。
我们通过生成、精炼和过滤三步流程来生成正向和反向问题,确保每个问题无歧义、具体、精简,并且有唯一答案。所有问题都要经过基于搜索引擎的过滤。凡是返回多个答案或需要澄清的情况,我们都予以舍弃。经过这一自动化过滤和最后的人工验证步骤,基准测试共包含 2,150 条事实。
我们如何评估 LLM
我们评估了 13 个 LLM。每个模型都在启用思考和不启用思考两种情况下评估。对每个模型、每条事实和每个任务,我们采样八个回答。回答由经过提示的 LLM 自动评分器自动打分(详见论文),共产生约 450 万条回答。
主要结果:瓶颈是回忆,而不是编码
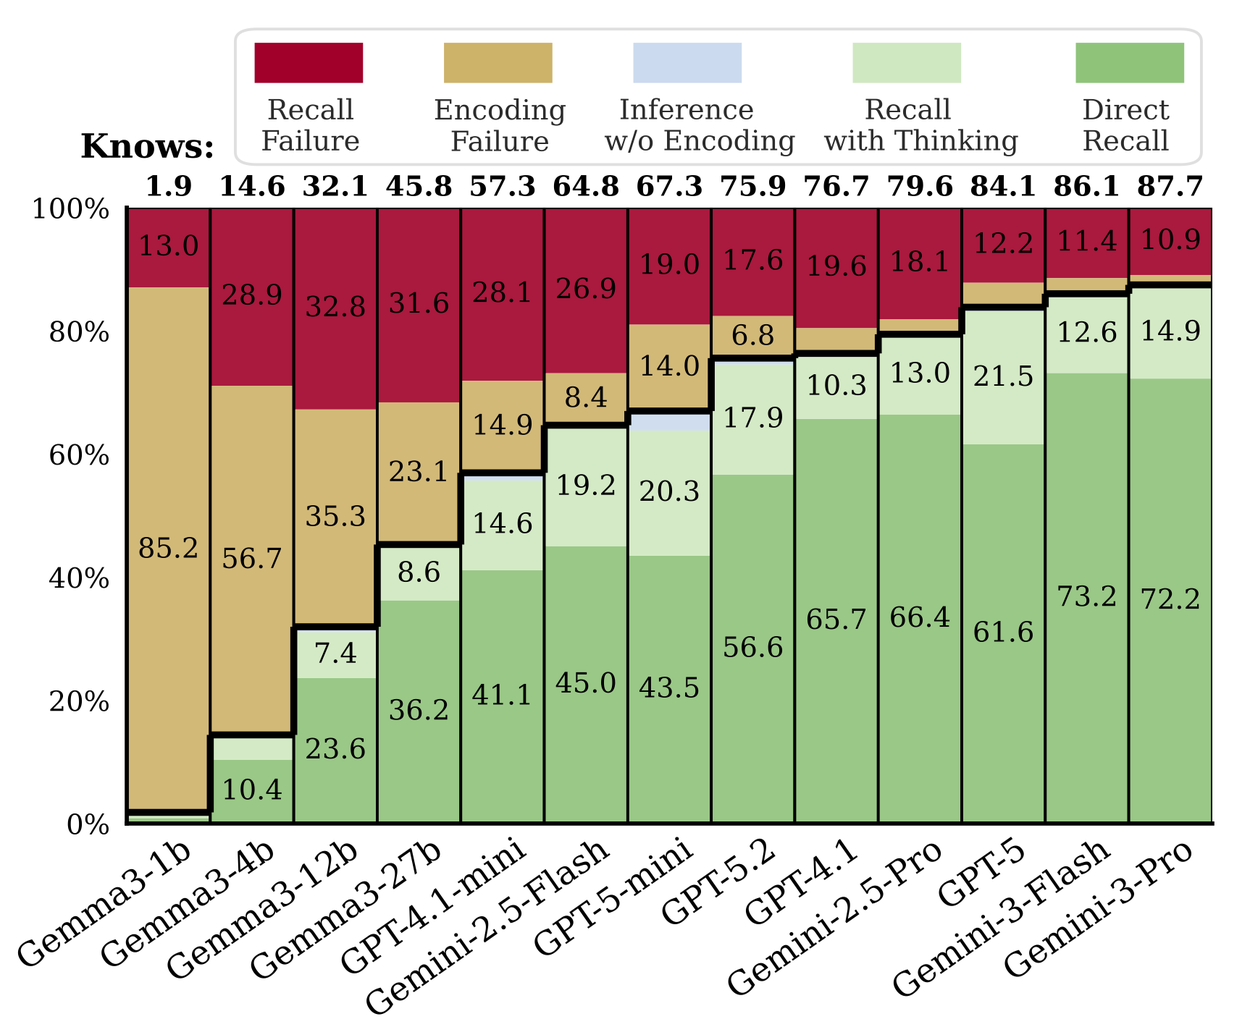
在前沿 LLM(Gemini-2.5-Pro、Gemini-3-Pro 和 Flash、GPT-5)中,事实编码已接近饱和,但回忆并非如此。对于 Gemini-3-Pro 和 GPT-5,95% 至 98% 的事实已被编码,但这些模型仍然无法直接回忆 26% 至 34% 的事实。即便启用思考,它们仍然在 11% 至 12% 的事实上失败。这意味着在前沿模型中,事实性错误越来越多地并非源于知识缺失,而是源于已存储却无法被可靠获取的知识。换言之,瓶颈正从知识获取转向知识利用。
规模扩展进一步印证了这一图景。在 Gemma 3 系列中,更大的模型编码失败要少得多,但回忆失败依然可观,并且在剩余错误中占据更大的份额。规模扩展对模型所存储内容的改善,多于对模型所能获取内容的改善。
回忆为什么会失败?
我们的结果表明,回忆与事实被学习时的条件紧密相关。当查询偏离了事实被遇到时的训练期语境、措辞或顺序,回忆就变得更困难。我们重点介绍系统性出现这种情况的两种场景。
稀有事实被编码了,但难以回忆
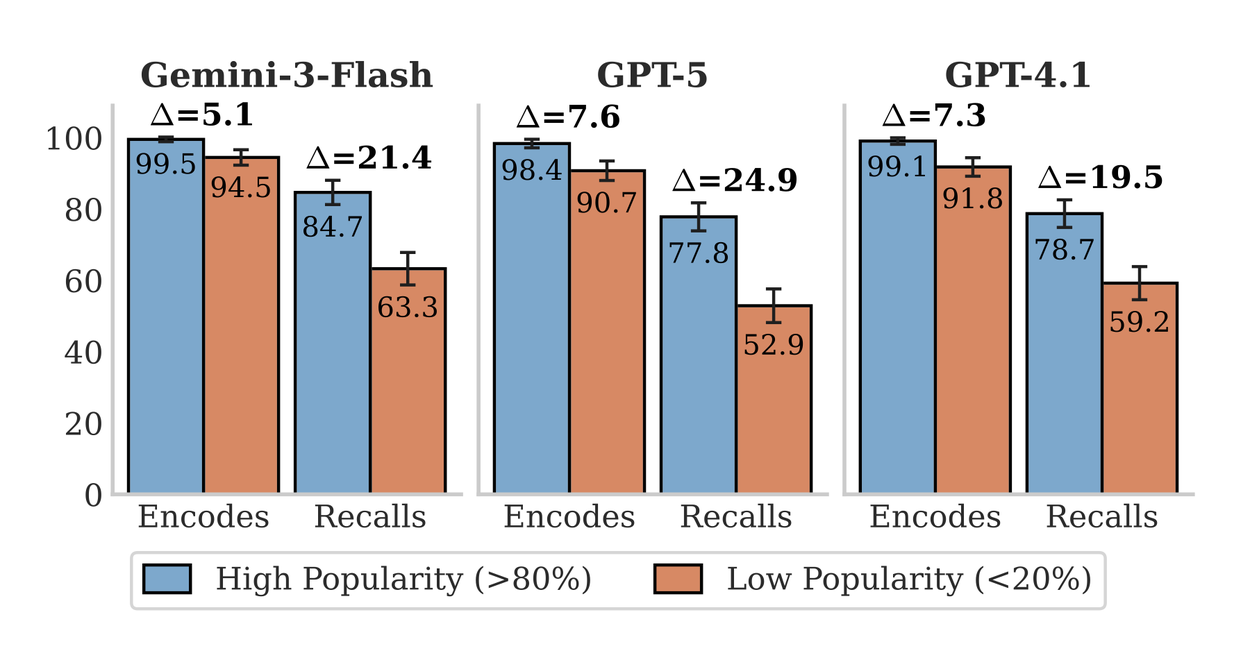
已有研究表明,LLM 在长尾(稀有)事实上表现不佳,常将其归结为模型容量问题。我们的结果给出了一幅互补的图景。比较低知名度和高知名度的事实时,我们发现稀有事实的编码率与热门事实相近。编码上的差距相对较小,但回忆上的差距更大。这为长尾问题提供了新的视角:许多稀有事实并非不存在于模型参数中,而是存在却难以获取。瓶颈已从知识获取转向知识利用。
反向问题可验证,但难以回忆
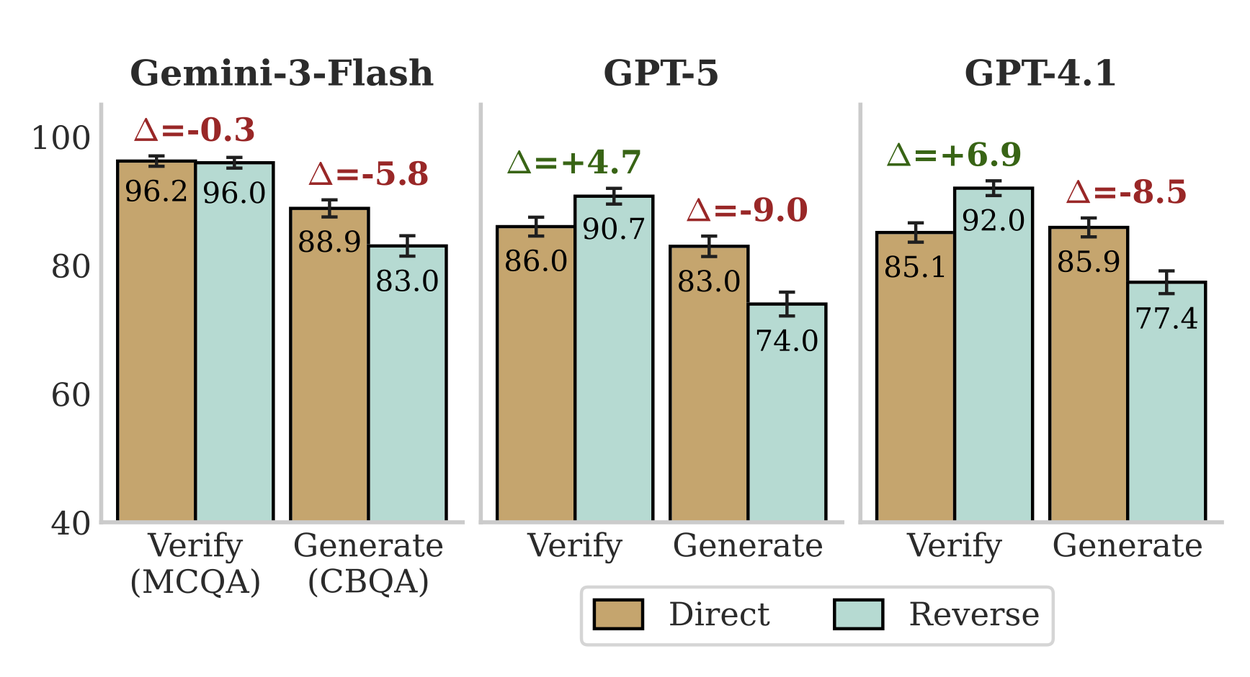
我们还重新审视了逆转诅咒(reversal curse):当 LLM 知道“A 是 B”,却答不出“B 是什么?”。乍看之下,这似乎说明 LLM 缺乏双向知识。但我们的结果对这一观点提出了修正。在开放式生成(即回忆)中,反向问题始终比正向问题更难。然而在多选验证(即识别)中,反向问题并不比正向问题更难,甚至往往更容易。这种分离很重要。如果模型在正确答案与干扰项并列时能够识别出来,却无法在反向查询中生成它,那么问题就不单纯是双向知识的缺失。更确切地说,这条事实似乎已被编码,甚至可以被识别,但当查询方向偏离了训练期间遇到该事实的方式时,就难以回忆。逆转诅咒是一个回忆问题。
思考作为一种恢复机制
接下来我们转向这样一个问题:是什么使原本无法获取的知识得以恢复?为此,我们考察了思考能否承担这一角色。思考恰恰在直接回忆最弱的地方对回忆的提升最大。对稀有事实和反向问题,提升尤为明显,缩小了知名度差距和方向性差距。
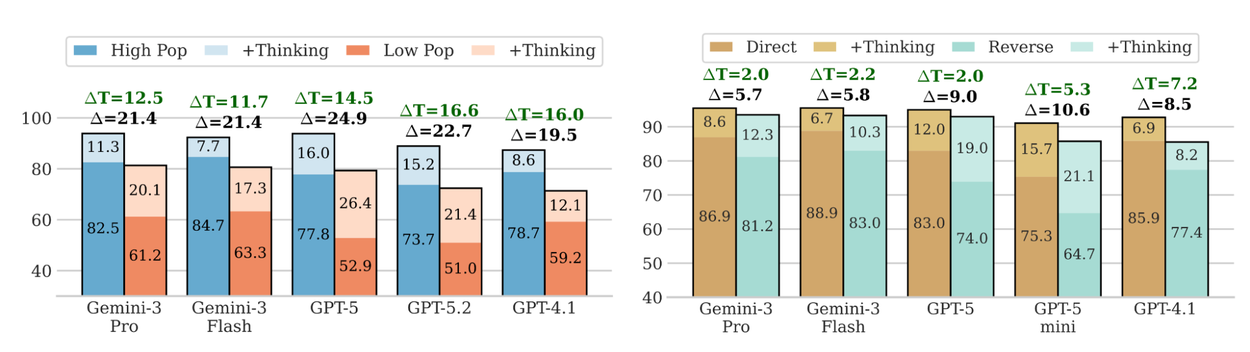 *我们考察思考对回忆(知道已编码的事实)的影响。 左:比较两个事实知名度层级(最低 20% 与最高 20%)。 右:比较正向和反向问题。知名度差距或方向性差距分别用 Δ(不思考)和 ΔT (思考)表示。
如图所示,思考缩小了差距(ΔT< Δ)。*
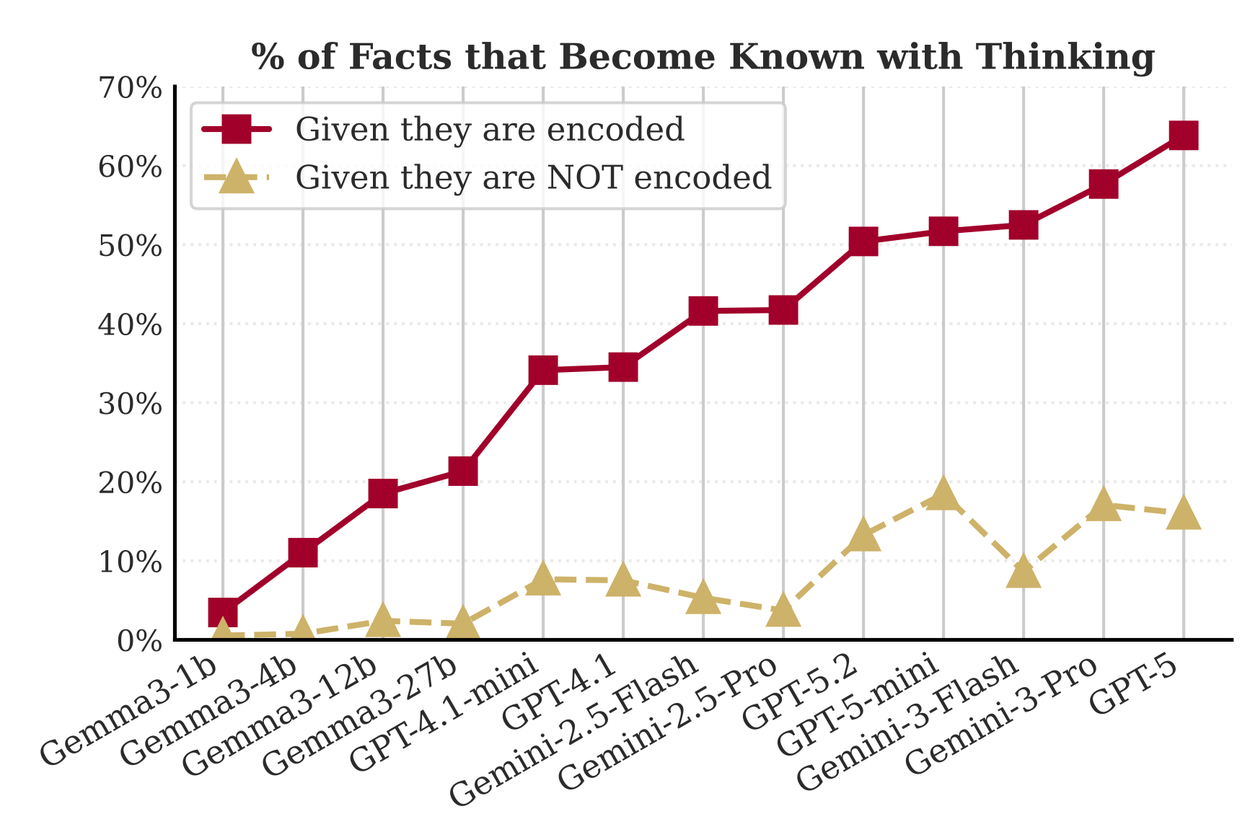
更具体地说,在针对思考优化的模型中,思考能够恢复大约 40% 至 65% 已编码但无法直接得知的事实。相比之下,它对未编码事实的帮助要小得多。这一模式表明,思考主要是一种回忆促进机制:它帮助模型获取其已编码的事实,而不主要是通过复杂的多步推理推导出答案。话虽如此,思考并非没有代价。它带来计算成本,而且究竟如何确定模型应在何时调用它,目前仍不清楚。
结论
知识画像使我们能够精确诊断 LLM 的事实性行为。将这一方法应用于维基百科事实,我们的结果表明,我们应当转变看待前沿 LLM 事实性错误的方式。如果编码已接近饱和,那么事实性的进一步提升可能较少来自(模型规模或数据的)扩展。既然思考可以恢复相当一部分已编码但无法直接得知的事实,事实性的下一步改进可能不仅来自更好的知识获取,还来自对模型中已编码知识的更好利用。