我来了,我提示了,我走了(第二部分):一个月内从零构建 GPU 驱动
上一篇博客:https://codyho.dev/blog/hypervisor-macbook-neo/
我们做了什么
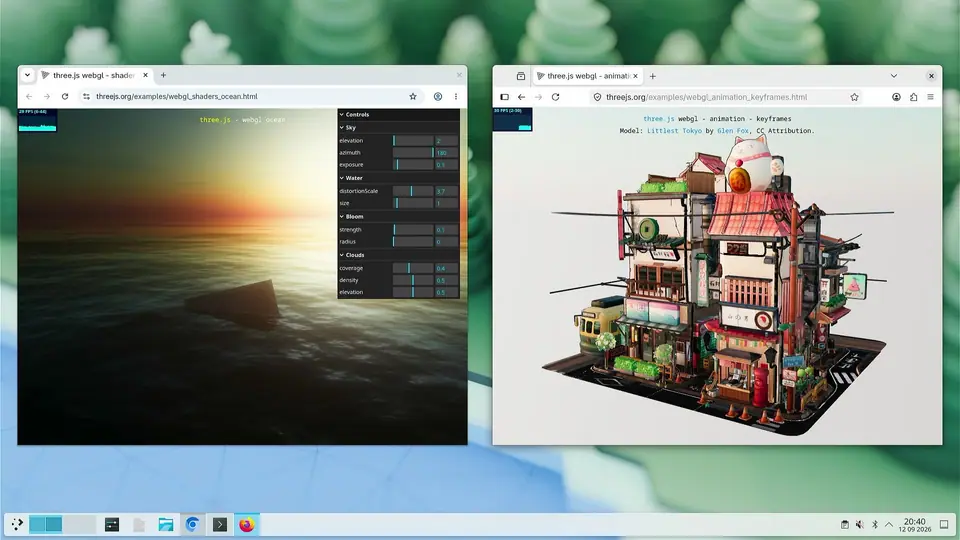
太长不看:Niklas 和我用大约一个月的时间,为 M4 Mac Mini 和 MacBook Neo 构建了一个完全符合 OpenGL ES 3.0 标准的 GPU 驱动,而这个过程通常需要数年。下面是 Chrome 和 Firefox 在 M4 Mac Mini 上运行 WebGL 的画面,合成显示工作正常:

最重要的是,这个驱动足够快,可以以 200fps 运行 Minecraft:
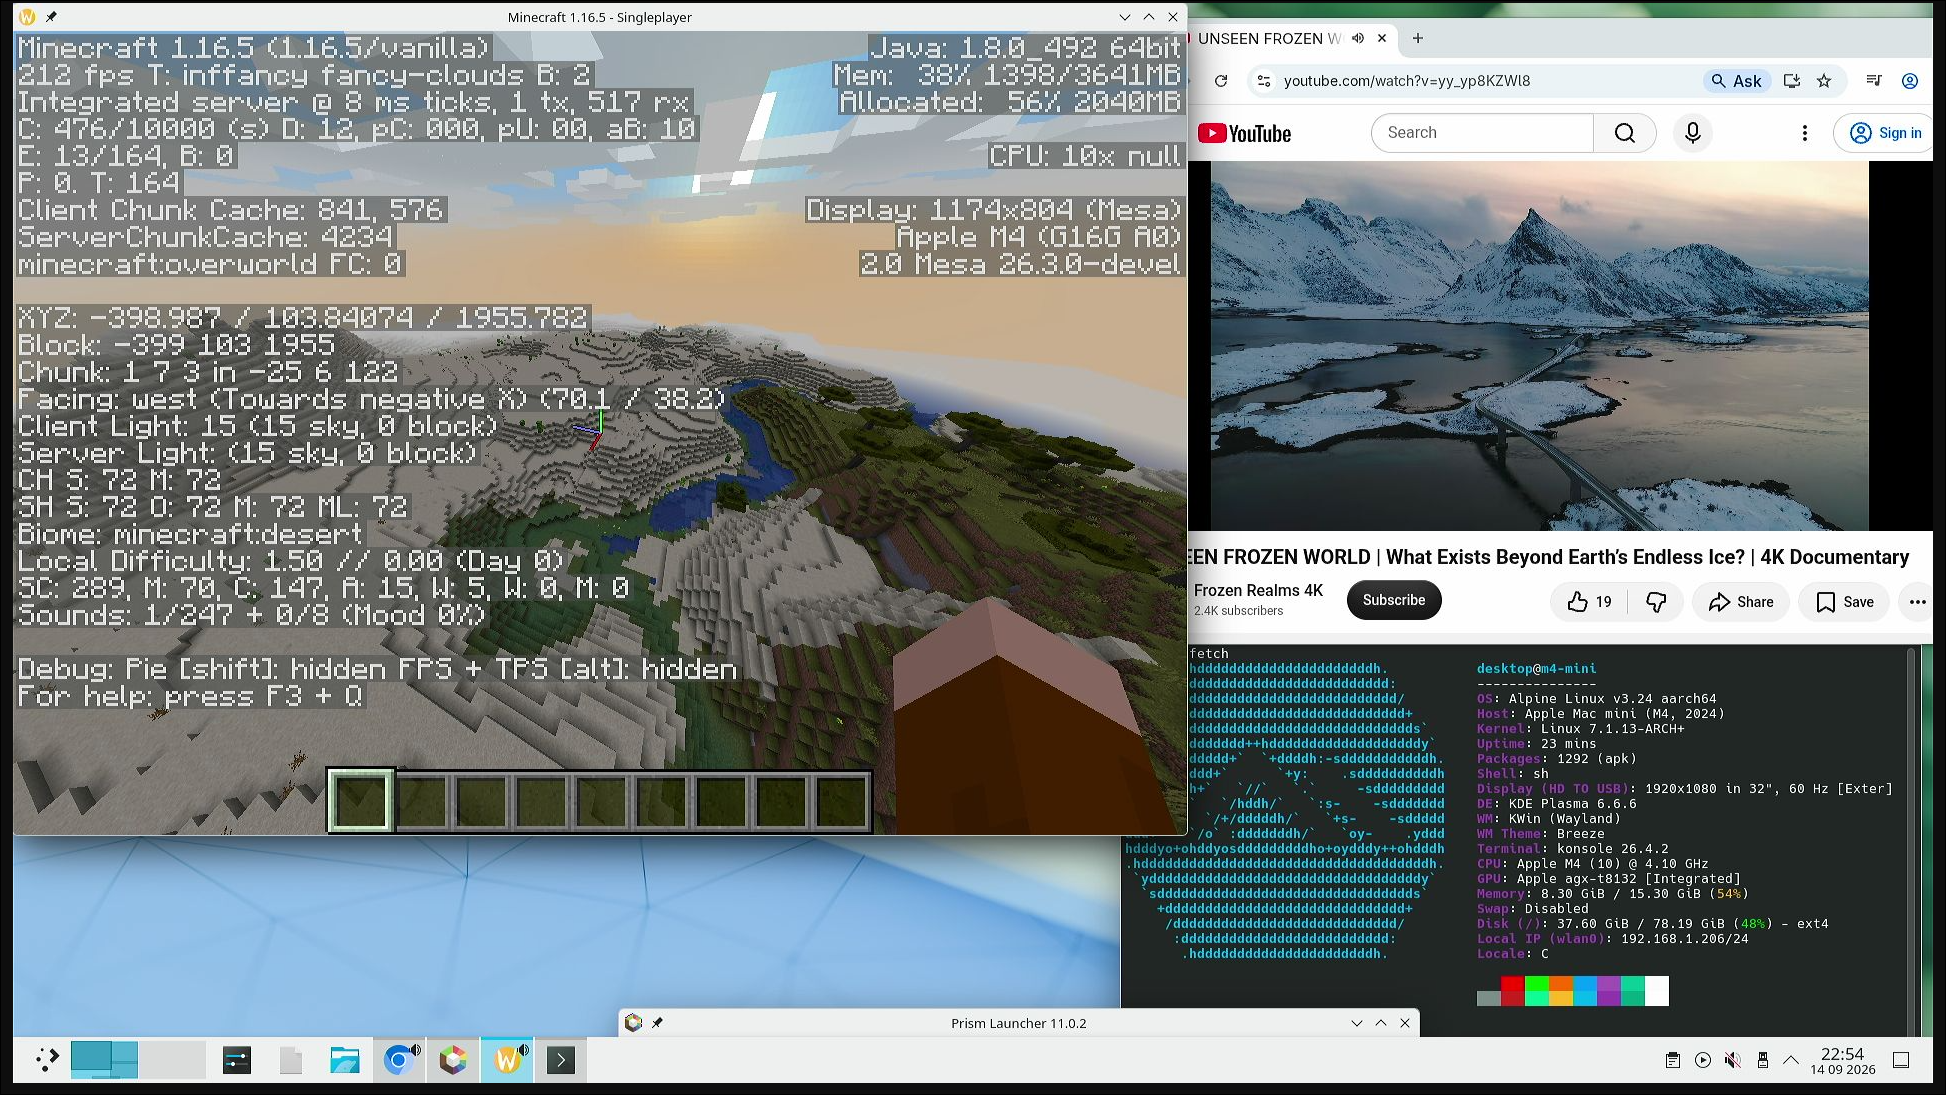
构建这个驱动需要对 AGX(苹果对其 GPU 的称呼)极其复杂的固件 ABI 和用户空间组件进行逆向工程。这一切都是以透明、可验证的洁净室方式,使用成熟的技术完成的。代码尚未准备好面向最终用户,但我们希望尽快把它交到用户手中。
我们是怎么做的
此前我构建了一个用来逆向 macOS 的 hypervisor。现在的目标是用它做点真正有用的事,还有什么目标比编写 GPU 驱动更合适呢?GPU 实际上是任何现代系统的必需品,否则一切都得靠 CPU 渲染,速度要慢几个数量级,能效也低得多。我们的目标是为 M4 Mac Mini 和 MacBook Neo 实现符合标准的 OpenGL(以及即将到来的 Vulkan)驱动。
通常,构建 GPU 驱动要花上数年;我们的目标是在几天内完成。事实证明“几天”过于乐观,但“几周”仍然是巨大的进步。在这几周里,我们完成了:
- 仅通过实时探测就逆向了 M4、A18 Pro 和(大部分的)M5 用户空间,并发现了硬件支持、但苹果驱动不会发出的功能和指令
- 构建了一个完全可用的用户空间驱动,包括全新的自研 IR/着色器编译器、命令流构建器以及更多组件
- 利用我之前构建的 hypervisor 抓取的轨迹,从零逆向了完整的 AGX 固件 ABI
- 为该固件 ABI 实现了完整的 Linux 内核驱动
在整个过程中,我们没有查看过任何苹果的二进制文件,只使用了(来自我们 hypervisor 的)硬件轨迹和我们自己编写的着色器。对于用户空间图形逆向,我们谨慎地把所有必需的苹果 blob 视为不透明对象。我们请一位朋友为这些 blob 撰写了文档 1,这样我们就能自行完成洁净室实现(其中大部分是靠盲目尝试直到跑通构建出来的)。我们已公开所有实验,任何人都可以验证我们工作的来源(见交付成果下的双 agx-re 仓库)。
本文分为用户空间和内核空间两部分,这与所有现代 GPU 驱动的划分一致:内核负责与固件对接、分配缓冲区和管理调度,而这些缓冲区的实际内容以及被调度的是什么,对内核来说是不透明的。用户空间则负责真正理解 GPU 如何工作,并往这些缓冲区里填入内容。
内核空间
在 Apple Silicon 上,内核驱动并不直接与硬件对接,而是与运行一个名为 RTKit 的自定义 RTOS 的 GPU 固件通信。这意味着编写内核驱动的第一步不是与硬件对话,而是搞清楚固件 ABI。
固件 ABI 是这个项目中迄今最令人头疼的部分。苹果没有做设计一个带有良好接口的合理 ABI 这种理智的事,而是基本上把一个普通的内核驱动切成两半,把其中一半放进 AGX 并称之为固件,另一半内核驱动则通过内存中的共享结构体与之通信。其中许多结构体把固件拥有的字段(我们绝不能修改,只能通过逆向去了解)与主机控制的字段交错在一起。要感受这个 ABI 有多复杂,看看 M1/M2 上的共享内存树就知道了:
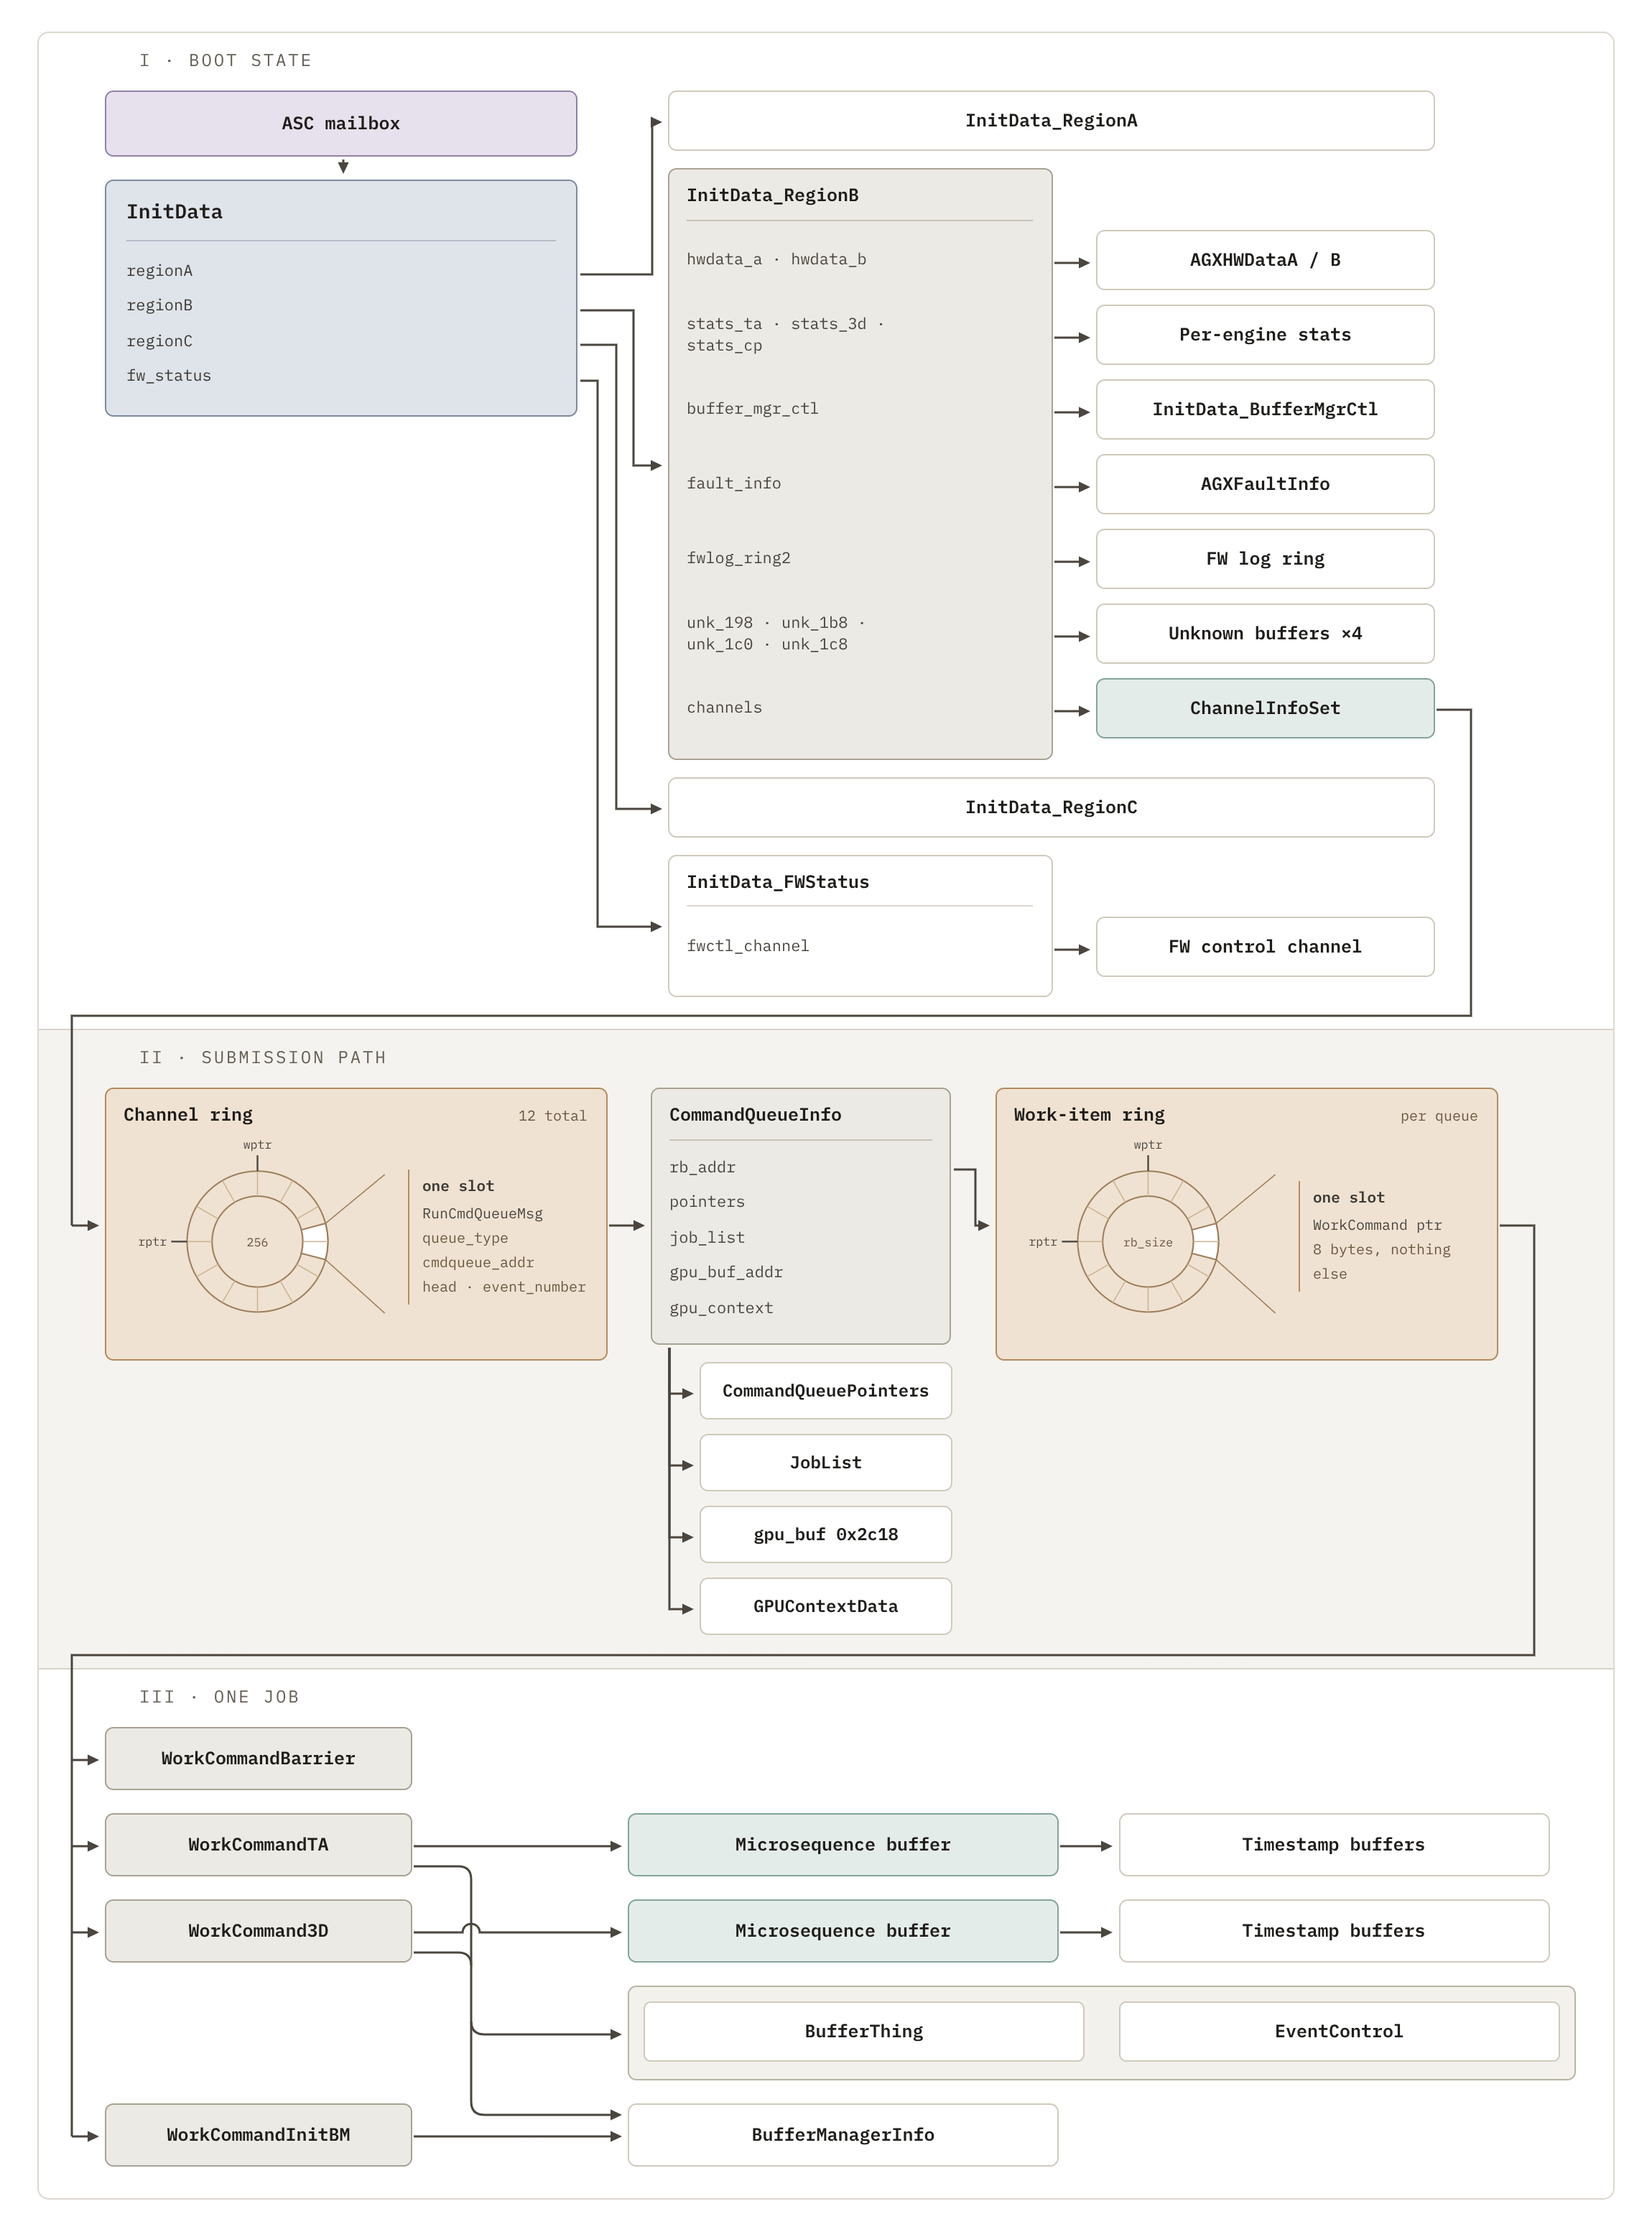
Asahi Lina 以在艰苦的 12 小时工作日中搞清楚这一切而闻名,并借此构建了 M1/M2 内核驱动,这是令人惊叹的技术成就。不幸的是,A18 Pro 的固件 ABI(我最初在 MacBook Neo 上开始逆向工作,后来转到 M4 Mac Mini)比本就非常复杂的 M1 固件 ABI 复杂得多:
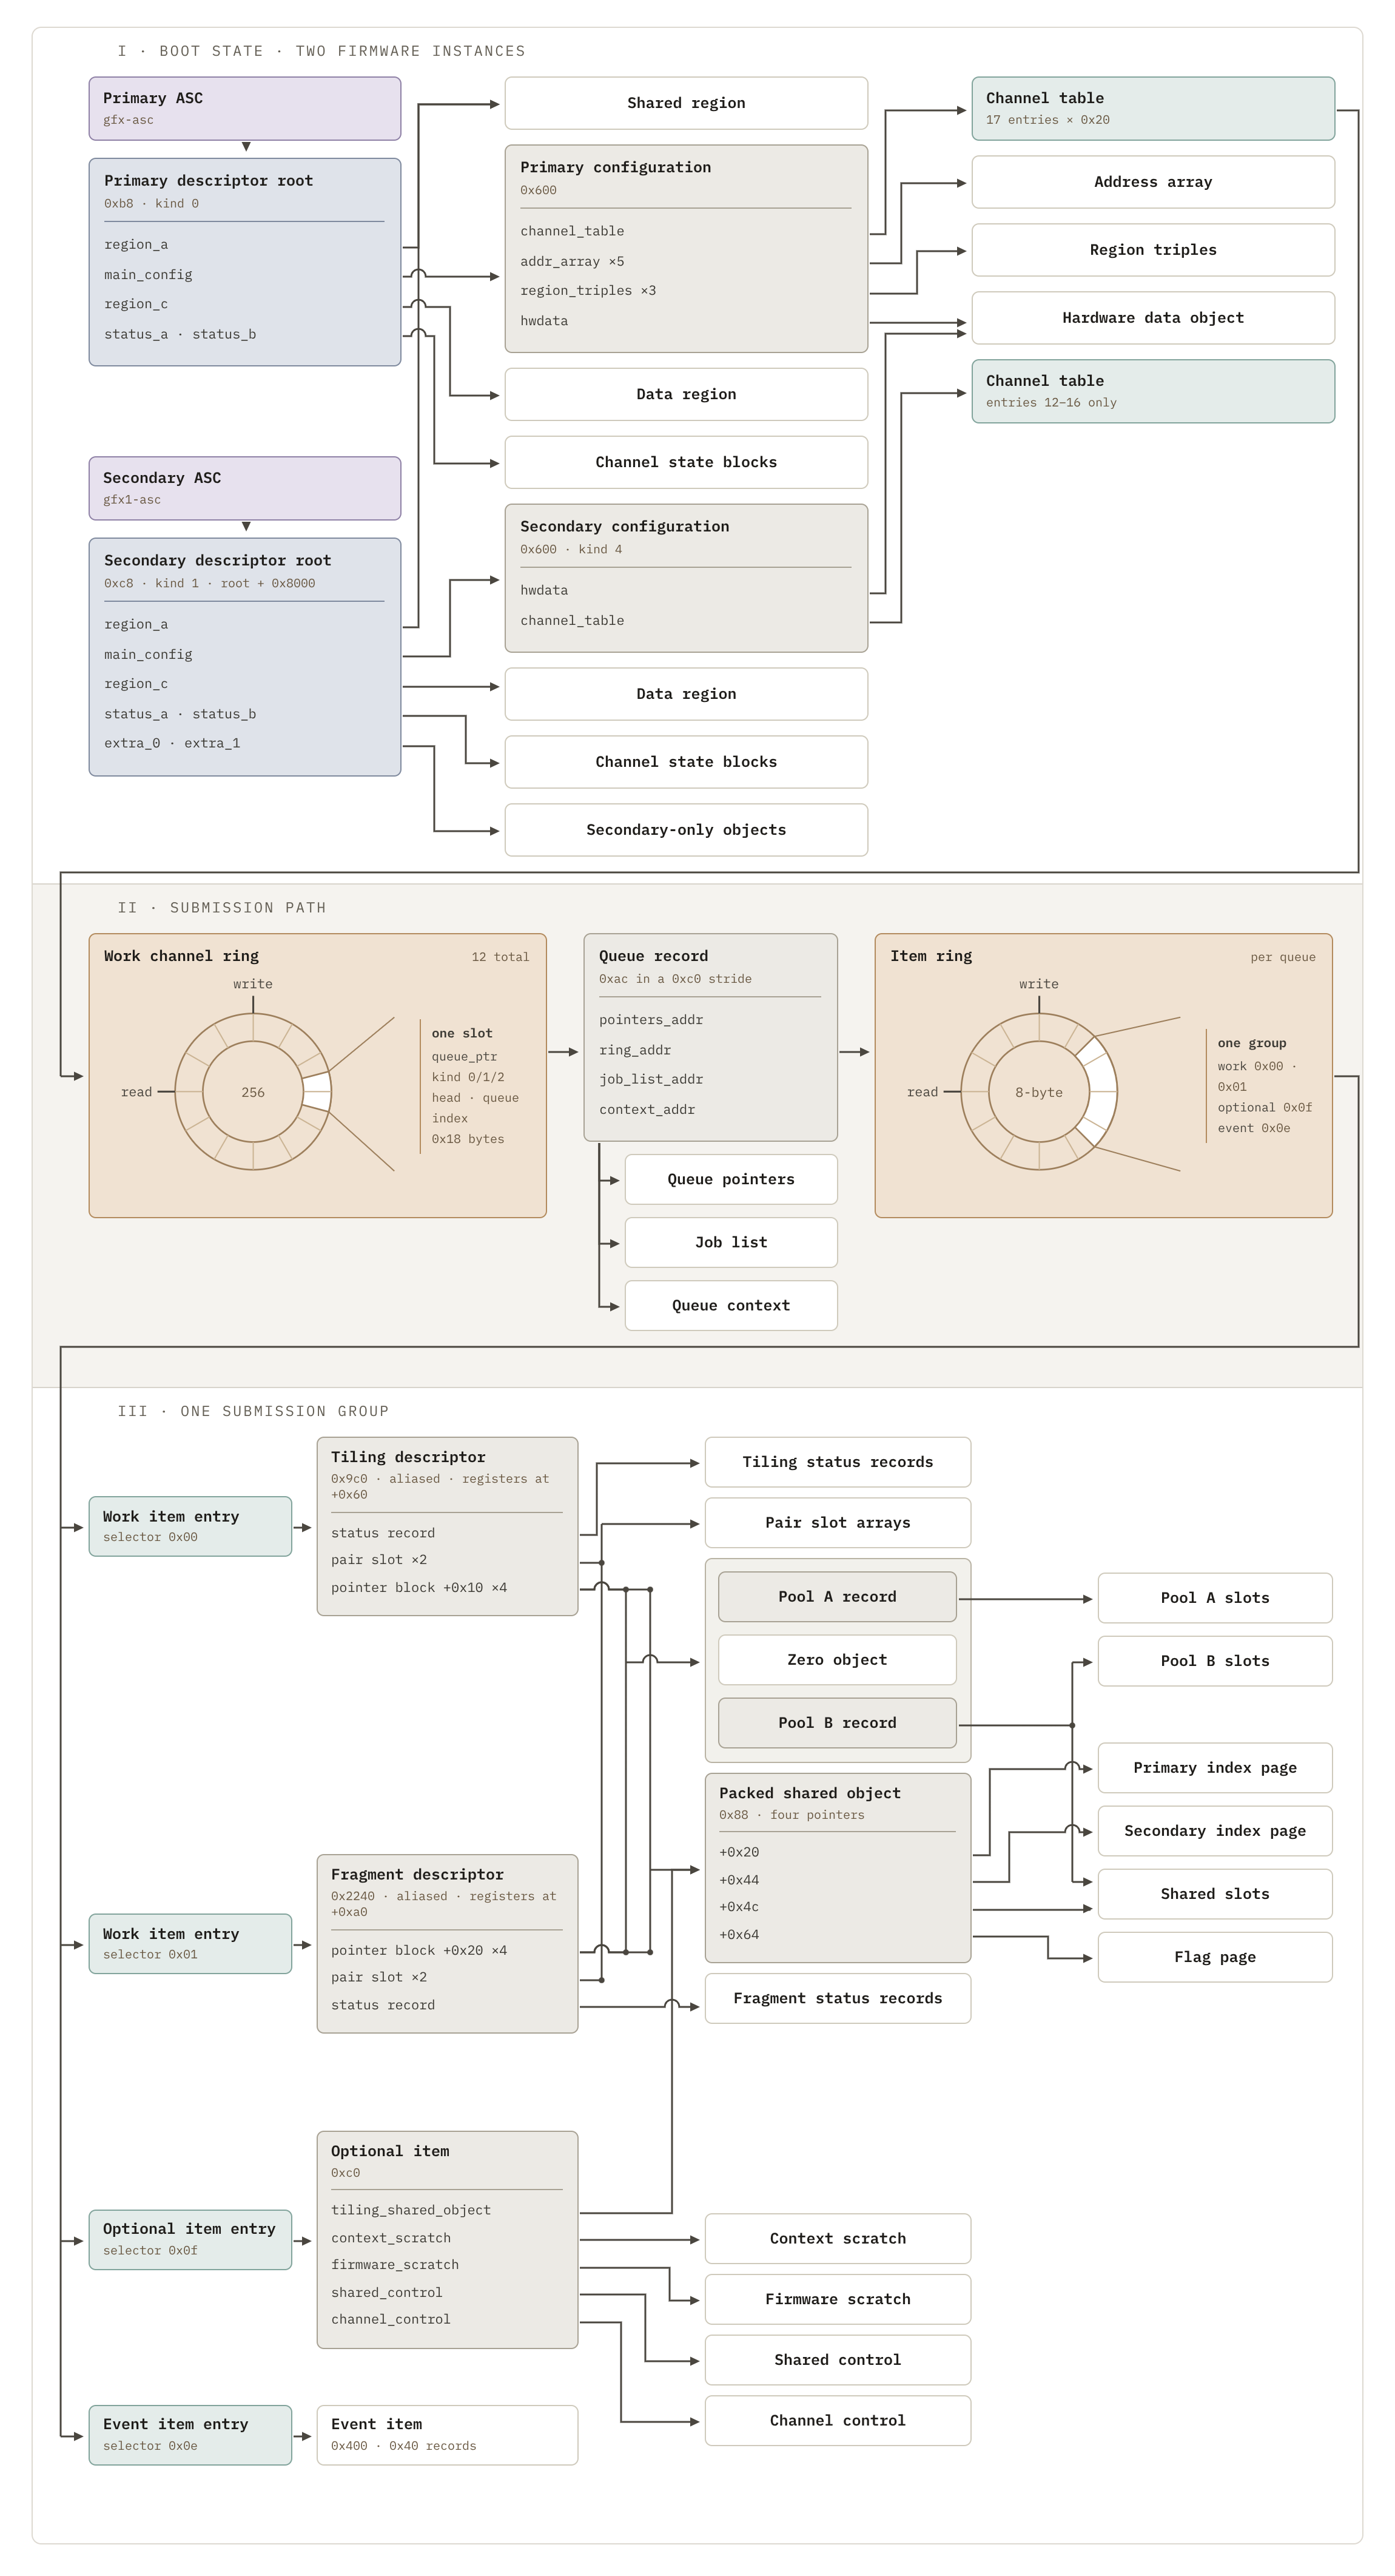
搞什么鬼,Apple。请注意 A18 有:
- 1.5 倍数量的结构体
- 两倍数量的指针
- 复杂得多的任务提交流程
还有许多其他问题给逆向过程增添了阻力 2。我确实有一些关于固件 ABI 的文档,但非常不完整,说实话也没什么用 3。
我的方法很简单,基于成功逆向 M1/M2 机器时所用的方法:观察 macOS 做了什么,重放它,然后尝试自己去做,而这一切都由 hypervisor 实现。
当我向 LLM 描述这个方法时,它把“重放”理解得极其字面:它做的第一件事是等待第一个对固件可见的事件(称为“kick”),然后保存了整个 GPU 内存状态的副本。重启后,它把保存的内存状态直接复制回主机内存,执行 kick,并观察输出页面的变化。接着它会尝试用代码重建这些对象,跟踪所有指针并理解其内容。在一次次实验中,Codex 不断减少复制的页面数量,直到不再有任何重放的状态,一切都从源码构建。4 令人惊讶的是,我注意到 Codex 很有品味,知道什么时候该继续戳硬件,什么时候该直接运行 hypervisor 自己抓取状态。
主要有三个问题,都是因为我们无法干净地捕获主机端的工作:
第一个问题是在 GPU 固件启动之后提交的渲染任务。我们可以在固件启动前预先布置任务,启动 GPU,这些任务会按预期完成;但一旦固件启动,之后提交的任何任务都只会被 ACK 并直接退役,而不会真正执行任何操作。固件启动后,捕获状态要困难得多,因为一切都变成动态的,固件成了一个带有难以重放的状态的有状态对象。
此时我不得不介入,检查 Codex 的做法。结果发现它试图在 AGX 生命周期很晚的时候重放一次捕获,那时已经发生过许多先前的事件。当我让它选择 AGX 生命周期早得多的捕获,也就是固件启动后的第一次捕获时,Codex 几乎立刻就发现了问题(它漏掉了一个字节的描述符)。这花了几天时间。
第二个问题,也是唯一一个真正造成阻塞的问题,是计算。AGX 大体上支持两类任务:计算和渲染。在常规 GUI 路径中,计算任务只有在大量渲染任务已经执行之后才会被调度。因此,要获得一份干净的计算负载捕获花了很长时间,而当 Codex 终于拿到时,它有 336 MB,根本无法重放(它试了很久)。它还尝试通过查看捕获自行构建这些对象,为此花了一个多星期,但最终没有成功。要筛查的无意义内容实在太多。我这边的问题也加剧了这一点:渲染跑通后,我以为提交计算任务会更简单(计算的固件 ABI 确实更简单,所以这点我判断对了),但我失去了谦逊,认为这会是小菜一碟,只要几个小时。因此我没有为 LLM 把任务搭好脚手架。
解决办法其实是在另一个 Codex 会话里给我的。本质上是:
- 通过启动到单用户模式来禁用 GUI,这意味着不会有任何渲染任务。
- 安装一个 LaunchDaemon,让它在尽可能早的时间点运行,即 Metal(苹果专有的图形框架)可用的那一刻。
- 运行我们提供的一个很小的 Metal 程序
- 捕获并重放这条很小的、纯计算的轨迹。
轨迹被成功捕获。几个小时内,Codex 就把它拆解完毕,几天内 Codex 就让计算跑通了。至于最初的计算代码库为什么不能用……Codex 也不知道。能用的和坏掉的看起来非常相似。
事后看来,这本该从一开始就是策略:捕获尽可能小,并在单用户模式下运行,以免干扰结果。针对最后一个问题,我吸取了教训:
部分渲染(partial render)最终成为最难搞清楚的事情之一。当分块顶点缓冲区(Tiled Vertex Buffer,TVB)不够大、无法存放当前几何数据时(也就是要画的三角形太多),就会发生这种情况。此时有两个选择,驱动需要同时支持:要么增大 TVB,要么执行部分渲染,即先渲染一部分几何,然后用其余的三角形重新加载缓冲区,再完成这次部分渲染。事实证明,部分渲染非常非常棘手,比其他工作更甚,因为它本质上意味着要给 GPU 驱动加上保存与恢复功能。
我之前发现的工作流在这里派上了大用场。Codex 能够重放一次部分渲染事务,然后修改我们的 Metal 着色器以执行多次部分渲染(做法很简单:用成千上万个三角形反复轰击单个图块,直到触发部分渲染),接着学会了如何重放这些渲染。一旦 Codex 成功重放,它学会自行构建只是时间问题。
构建内核驱动
从 Python 原型驱动迁移到功能完整的 Linux 驱动花了三天,其中有一天几乎完全浪费了,因为 Codex 出于某个我至今不理解的原因,选择先攻克部分渲染(迄今最难的任务),而不是先做计算(最简单的任务)。我让它先做计算之后,一切都顺利了。
总体而言,整个过程基本上是:
- 按照完全相同的模式用 Rust 重写现有的
drm-shim,这样我们就得到一个同步的 Rust 驱动。 - 把前端重写为异步;实际的 GPU 提交仍然是同步的。
- 把 GPU 提交重构为异步,不再轮询,而是监听固件事件并将任务与 fence 关联
- 实现一些唾手可得的优化,例如批量提交任务。
这些都是相当常规的工程工作,LLM 完全有能力胜任。
我发现唯一值得一提的是,Codex 为了调试自己的代码为何不能工作,大量使用了 hypervisor,包括捕获完整的地址空间并与已知正确的样本进行比较。这种系统化的调试方式,正是 Codex 成为我最喜欢的编码智能体的原因。
用户空间
A18 Pro 的用户空间与 M1/M2 大不相同:它有新的描述符格式、新的 ISA,以及一大堆其他新东西。除了是一个为运行 Metal 而设计的分块延迟渲染器之外,它就是另一款 GPU。
好消息是,用户空间逆向有一套定义非常清晰的流程:写一个小的 Metal 程序,编译,运行,看看什么变了,然后拆开它,开始摆弄各个比特,直到弄懂它们的作用。如果你觉得这听起来正是那种枯燥、重复、机械、而 LLM 非常擅长的工作,那你说对了。
逆向工作分两个阶段进行。第一阶段,我让 Claude 查看它能找到的每一个 Metal 程序,尝试构建反汇编器、汇编器,并理解 GPU 驱动所需的所有其他描述符/命令流等的格式。为求完整,我让 Claude 把所有东西都枚举出来,包括 Linux 用不上的(比如曲面细分)。这一步成功了,但 Claude 能反汇编再重新汇编程序,并不意味着它知道如何自己构建一个。当我们试图弥合这一差距,即充分理解每条指令,以便真正能编译我们自己的任意程序时,Claude 表现得很糟糕,基本毫无进展。
此时,Niklas 完成了他为 M4 Mac Mini 编写的 drm-shim,加入我一起进行第二阶段的用户空间逆向。对于如何真正完成用户空间驱动,我们采用了两种不同的方法:
我的方法是优先进行硬件逆向,专注于弄清楚硬件和所有指令是如何工作的。然后我写一份规范,让 LLM 去实现,希望最终实现完整的 OpenGL 和 Vulkan 合规。这意味着我的 LLM 大部分时间都花在硬件上编写实验,而不是真正实现 Mesa 代码。想法是一旦我理解了硬件,其余一切就水到渠成。
Niklas 采取了不同的方法,我称之为“Mesa 优先”。本质上,他先尝试把 Mesa 搭起来,只在为了构建某些功能时才进行逆向。他的时间分配在构建和测试 Mesa 以及进行逆向两方面。
事实证明,Niklas 的进展比我快得多,因为我的智能体以追求完整为名,在细枝末节、无关紧要的任务上花了大量时间。相比之下,他的智能体因为必须真正构建 Mesa 而有了落脚点,因此对时间和资源的使用有效得多。他推进得比我快太多,以至于最后我只能通过调查他尚未理解的任何行为来支持他的工作。
这是我注意到的 Codex 的一大局限。我能想到的最贴切的词是“迂腐”:它始终极其周密,这在某些场景下是很大的优势,但有时它会陷入某个随机旁枝的细节,损害了整体目标。
在逆向过程中,我们发现了硬件支持、但 Metal 不支持的行为;这是通过直接摆弄不同指令的比特,并根据已知存在的东西推断可能存在什么而发现的,就像 Alyssa Rosenzweig 逆向 M1/M2 时所做的那样。这包括:
- 原生的单指令 64 位加法
- 高达 128x 的各向异性过滤(Metal 上限为 16x)
- 矩阵单元的一种新模式
uniform_mov的 7 位立即数支持
Mesa 开发
在构建用户空间图形时,有几件事对我们非常有利。最值得一提的是,Khronos 一致性测试套件(CTS)本身就是一个详尽的测试语料库,我们的驱动必须通过它。换句话说,与 LLM 合作时最难也最敏感的部分,即给它们提供良好的测试作为依据,已经替我们完成了。
此外,Mesa 已有很好的抽象,让我们的工作轻松很多。现代 Linux 上的 OpenGL 栈如下所示:

我们只需要在 Gallium(Mesa 的内部 API)与 AGX 硬件语义之间进行转换。这个过程中最大的部分之一,是把 NIR(Mesa 的内部 IR,与 LLVM IR 十分相似)翻译成 AGX 的专有 ISA。另外,这个编译器还可以复用于未来的 Vulkan 驱动。
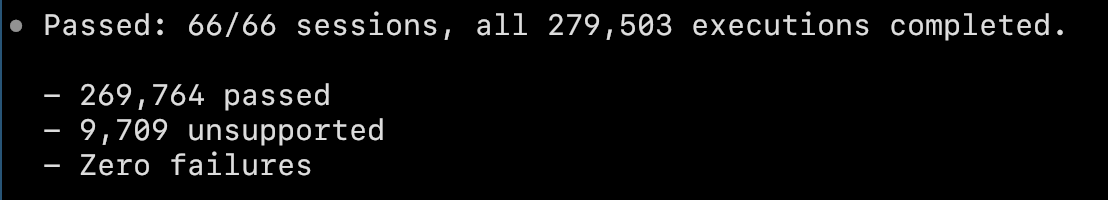
Niklas 逐个迭代 OpenGL 特性,边做边逆向用户空间,最终实现了完整的 OpenGL ES 3.0 合规(未通过的测试属于可选扩展):
在整个过程中,我们受益于已有的 M1/M2 工作:虽然具体的硬件语义不同,但整体形态相似,因此许多正确的取舍和决策已经有人替我们做好了。在构建这个驱动的整个过程中,我越来越清楚地认识到,Alyssa Rosenzweig 和其他构建 M1/M2 驱动的人简直是奇才,向他们致敬!
交付成果
Mesa:https://github.com/niklassheth/mesa
Linux 内核驱动:https://github.com/GravityLinux/linux/gravity-m4
用户空间逆向文档(一堆糟糕的 LLM 垃圾内容,但能用):Cody Niklas
剩余工作
Vulkan 1.4、OpenGL 4.6、OpenGL ES 3.2、OpenCL 3.1、Direct3D 12(通过 Proton)以及光线追踪都在范围之内。我们希望我们的驱动能与世界上最好的图形驱动相媲美。
此外,Niklas 和我希望把这一切都上游化,但存在一些重大障碍。我们使用的是未经修改的 Asahi UAPI,因此 Mesa 上游化不存在策略问题,但它需要更多的测试、人工评审,并需要重构成可评审的 PR。我们也预计会遇到大量质疑,因为这很可能是有史以来第一个完全由 LLM 编写的 GPU 驱动,我们的代码将被要求达到比人类编写的代码更高的标准。我们已为这些挑战做好准备,但它们主要是人际层面而非技术层面的问题,这是 LLM 帮不上忙的。
Linux 内核驱动会是更大的问题,因为 M1/M2 驱动尚未上游化,而且实际上我们没有能力改变这一点。我们认为这里最好的办法就是等待那个驱动上游化,然后在 M1/M2 上游化之后(经过所有必要的重构、评审、拆分等等)再上游化我们的驱动。遗憾的是,这可能要等一段时间。
我什么时候能用上?
年轻的蚱蜢,请耐心等待,我们期待着很快把这些代码交到你手中,等待的时间可能比你预想的短得多。毕竟,苹果落地离树不远。
加入我们
如果你有兴趣参与其中,欢迎加入我们的 Discord 服务器。欢迎来讨论想法、聊天,或者只是闲逛!
附记:真的吗,Sam?
我在内核逆向任务中使用了搭载 GPT-5.6 Sol(后来 GPT-6 Astra 发布后改用它)的 Codex。我遇到的最大问题之一是过于激进的网络安全限制(我没有加入可信访问计划)。
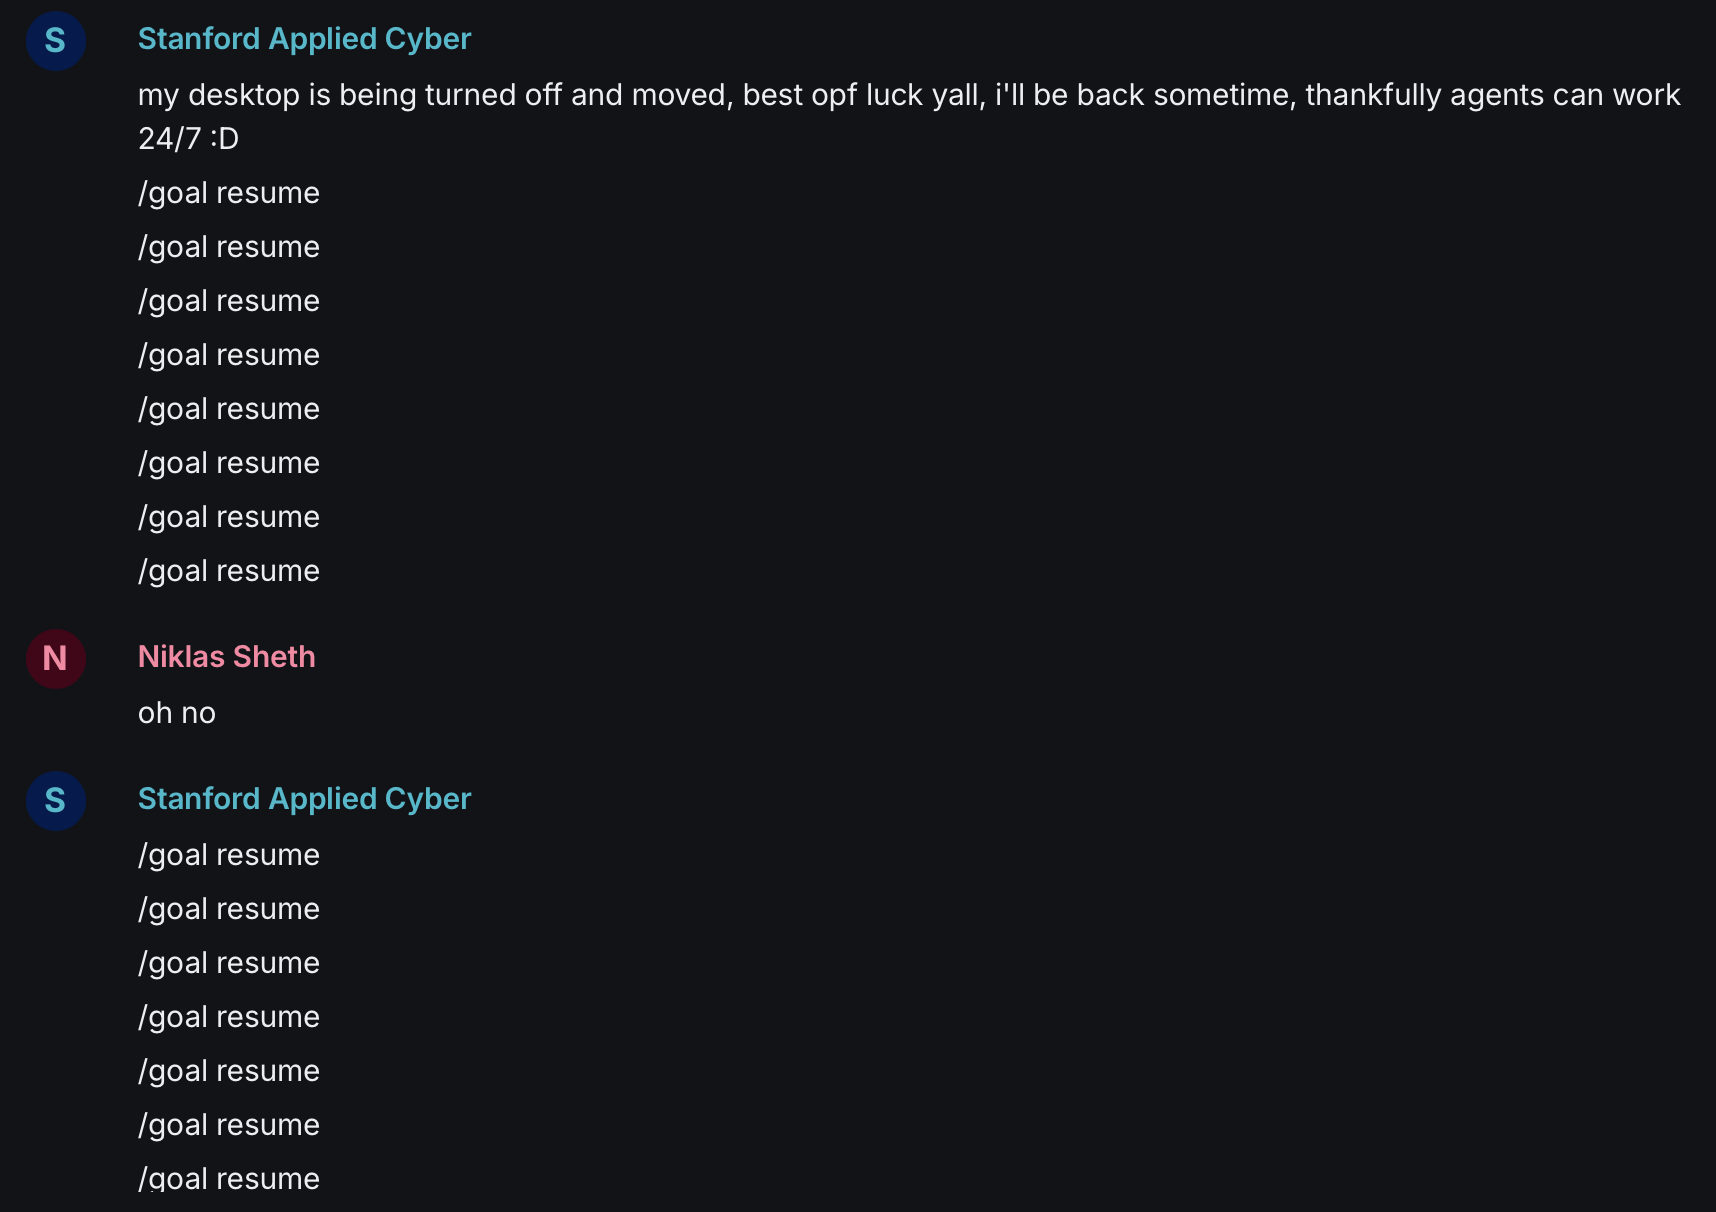
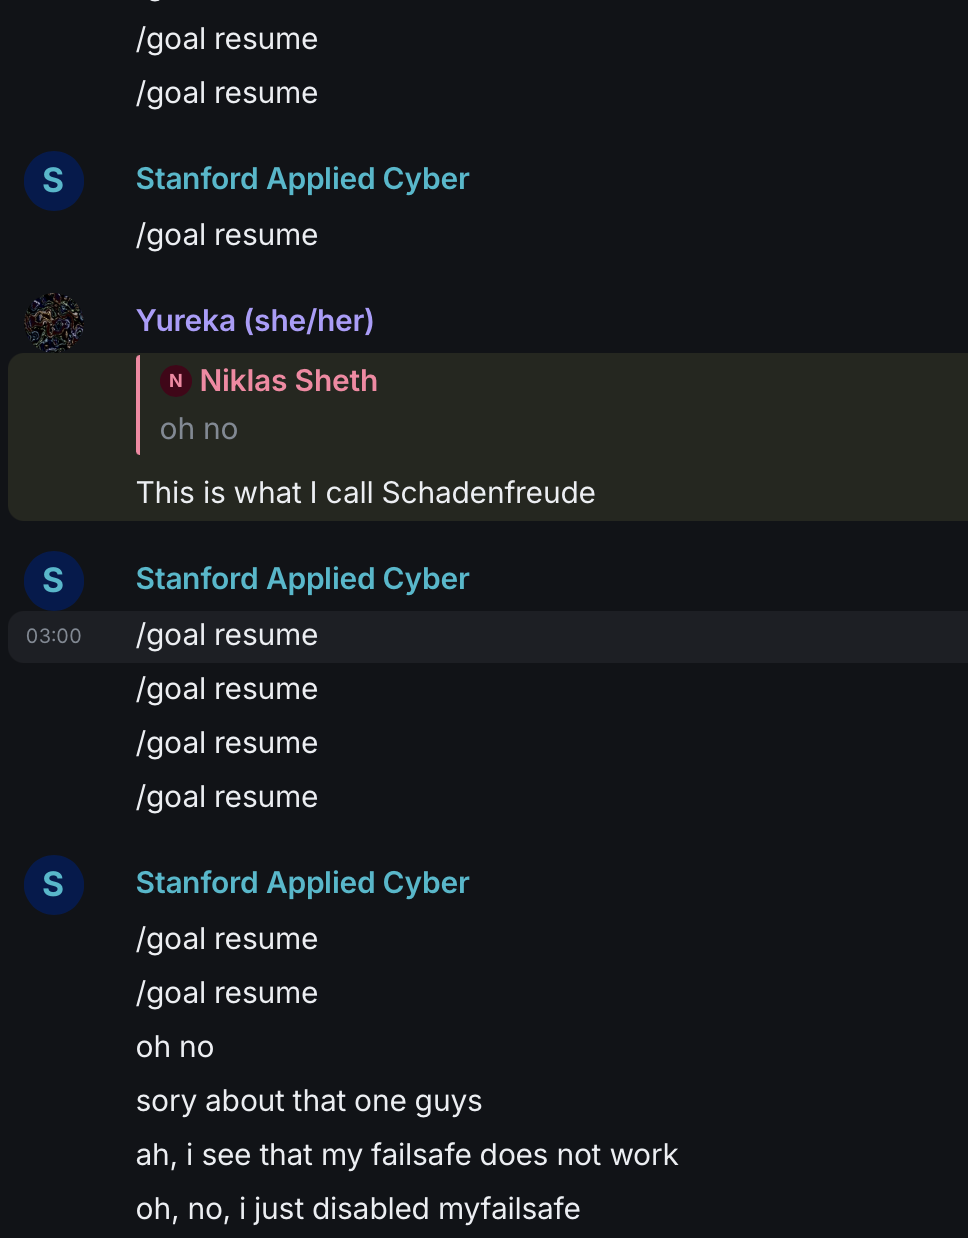
百分之九十九的情况下,一句简单的 /goal resume 或“继续”就足以让 LLM 继续工作(这也说明这些限制过于激进),但它们仍然打断了我的无人值守工作流。我写了最快、最笨的解决方案:一个守护进程,每分钟截一次屏,与上一张截图比较,如果相同(因为 Codex 停止了进展),就输入 /goal resume。我不小心把它在几个群聊里开着没关:
话虽如此,GPT-6 Astra 和 GPT-5.6 Sol 实在强得离谱,是固件 ABI 逆向方面迄今表现最好的,所以这个小花招绝对值得。
附记:M4、A18 Pro 与 M5 的对比
据我所知,M4 和 A18 Pro 的用户空间实现实际上是相同的,我能找到的唯一区别是有一个值在 M4 上略大,这与它有更多核心相符。两者的固件 ABI 则差异显著:A18 Pro 上的第二个 RTKit 协处理器让一切变得更复杂。从这个角度看,就固件而言,A18 Pro 更像 M5,而不是 M4。M5 的用户空间与 M4 有一些相似之处,ISA 大体上是其超集,但某些部分完全不同,例如纹理描述符。M5 的用户空间已被部分逆向;其固件 ABI 已被完全逆向;已构建并充分测试了一个原型 drm-shim;我认为把该原型升级为完整的 Rust 驱动不会花太久。我的主要目标仍然是 M4 Mac Mini 和 MacBook Neo。