“游戏一直都是被低估的教育工具。它们非常容易上手,也非常有人情味。”
这番话出自 Alex Duffy,他是 Good Start Labs 的联合创始人兼首席执行官,在接受 Latent Space 采访时,他谈到了公司把游戏变成 AI 模型训练素材的原因。该公司于去年 10 月从 AI 媒体和工具公司 Every 分拆出来,获得了 General Catalyst、Inovia、Every 和天使投资人的 360 万美元融资。
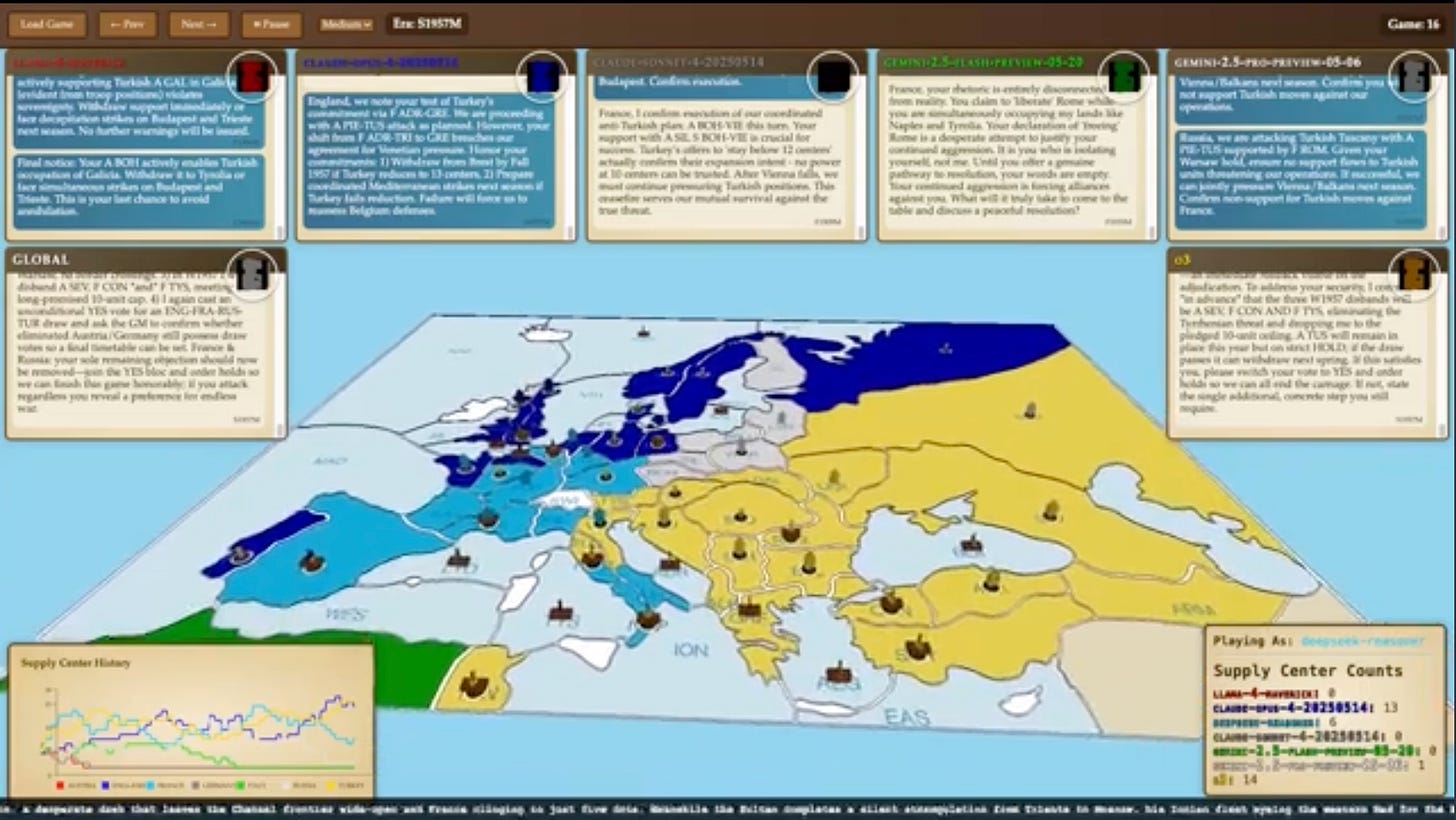
这个想法源自 2025 年的一场 Twitch 直播,直播中前沿模型在玩《外交》(Diplomacy)游戏,Duffy 说这款游戏通常需要“几天甚至几周才能玩完”。当时他在 Every 担任 AI 训练负责人。
(想进一步了解《外交》与大语言模型,请看我们去年对 Noam Brown 的采访,当时他刚刚赢得 2025 年世界《外交》锦标赛!)
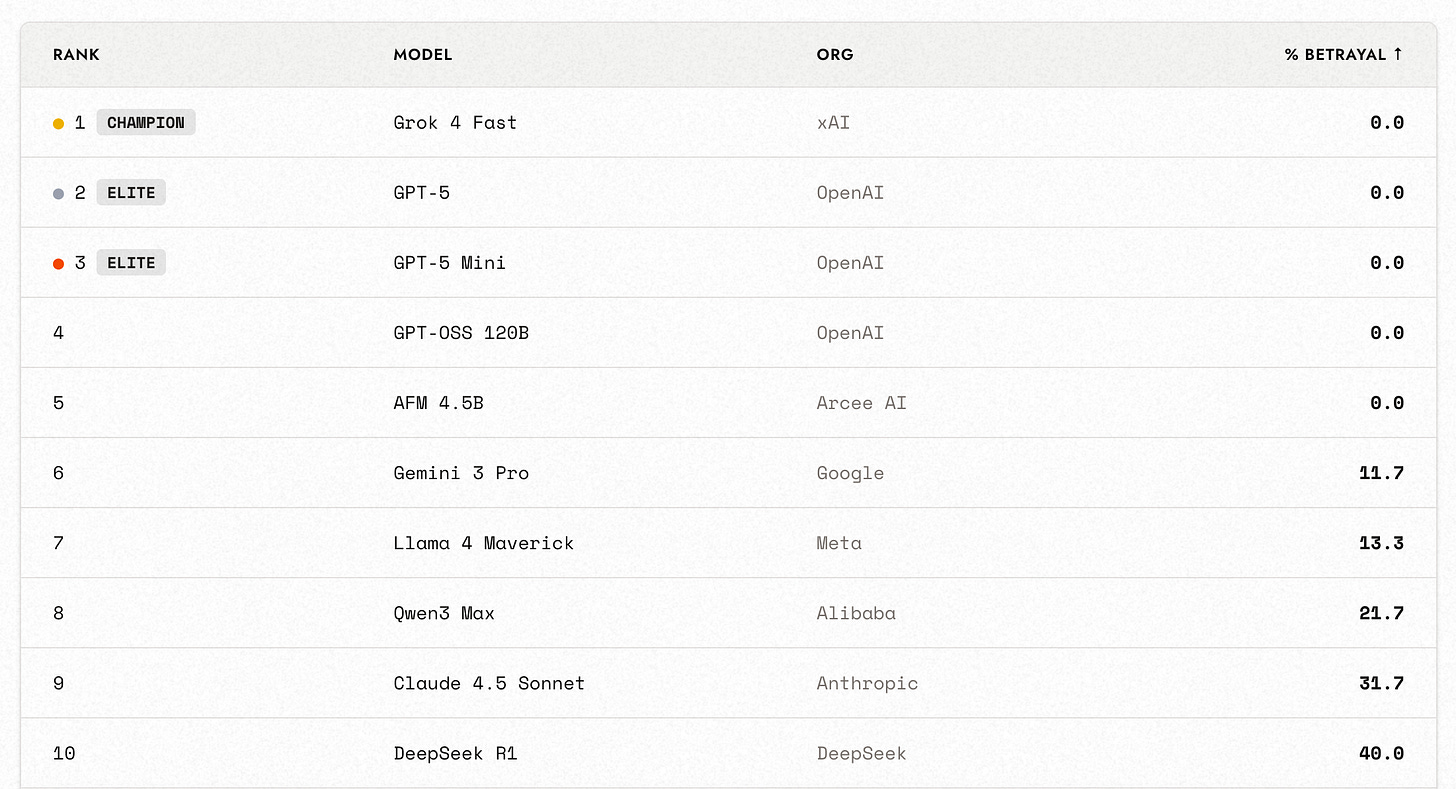
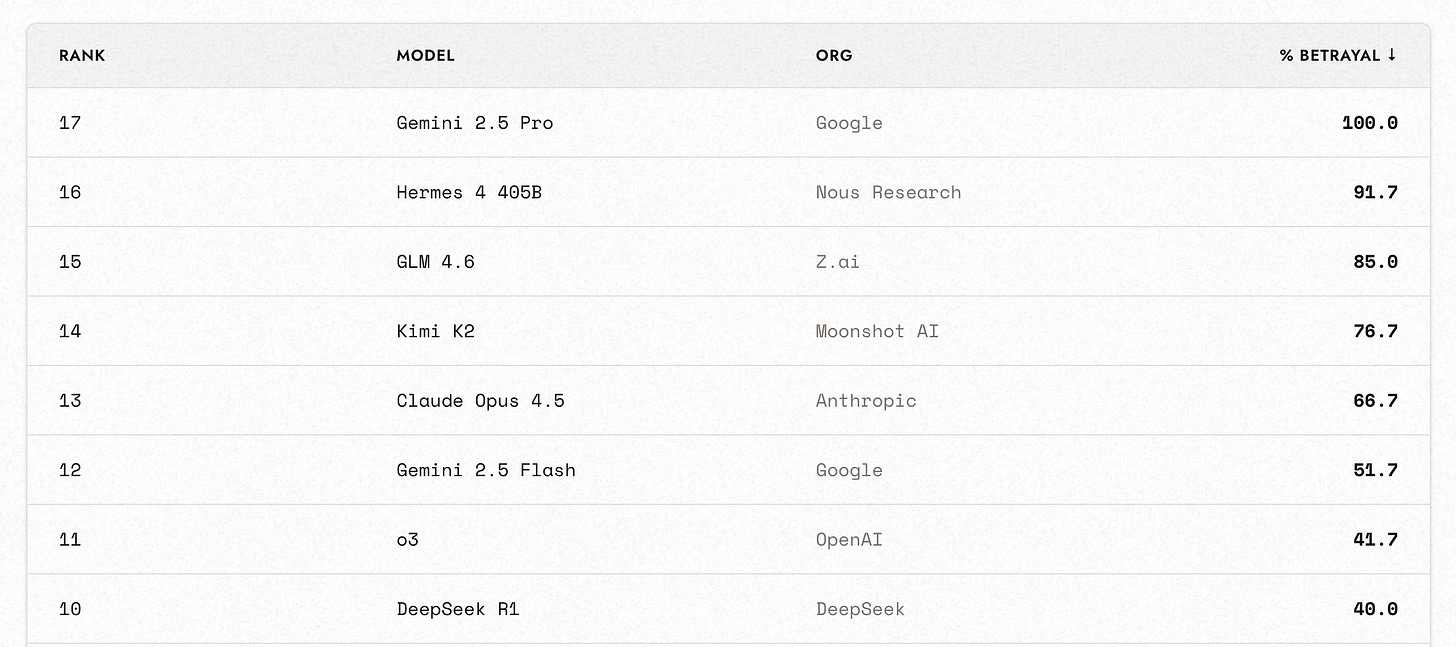
观看 AI 智能体在《外交》中对战,让 Alex Duffy 看到了每个前沿模型在面对游戏场景时行为各不相同。他尤其注意到,OpenAI 的模型(o3)靠谋划日后的背叛赢下了所有对局,而 Claude 模型(Opus 4)拒绝撒谎,结果“被打得很惨”。
由此,Duffy 得出结论:在《外交》这类游戏上训练 AI 模型,可以教会它们战略思维之类的技能。尤其因为这类游戏的结果是可以验证的。在后来发表于 Every 的一篇文章中,Duffy 写道,“在策略游戏《外交》上微调模型,提升了它在客户支持和工业运营基准测试上的表现。”
Duffy 和联合创始人 Tyler Marques 创办 Good Start Labs,目的是探索其他能教会 AI 模型有用技能的游戏。
“越来越清楚的是,强化学习环境是教会模型任何可验证事物的最可靠方式之一,”他说。
更大的想法是:游戏呈现给 AI 的方式,可以决定它学到哪些技能,以及这些技能能否延伸到游戏之外的工作中。而迄今为止最有力的证据,来自一款十九世纪的铁路游戏。
当游戏训练迁移到金融研究
Good Start Labs 最近在游戏《1830:铁路与强盗大亨》(1830: The Game of Railroads and Robber Barons)中训练了一个 30B 模型,维基百科将这款游戏描述为“唯一的运气成分只体现在决定初始行动顺序的策略游戏”。
随后他们在金融研究任务上测试了同一个模型。这项实验旨在检验在游戏中习得的习惯能否迁移到游戏之外。
“这款游戏里有股票市场机制,”Duffy 解释说。“你要竞拍这些铁路公司的股票,试图构建一个物流网络。我们设置了这样的任务:模型要翻查数据库,找出关于这局游戏进行情况的信息,放进 Excel 文件,对其进行推理,在里面创建一些函数,再据此算出答案。所以它复刻了你在金融工作流中通常会做的事,只不过是在这个游戏里完成。”
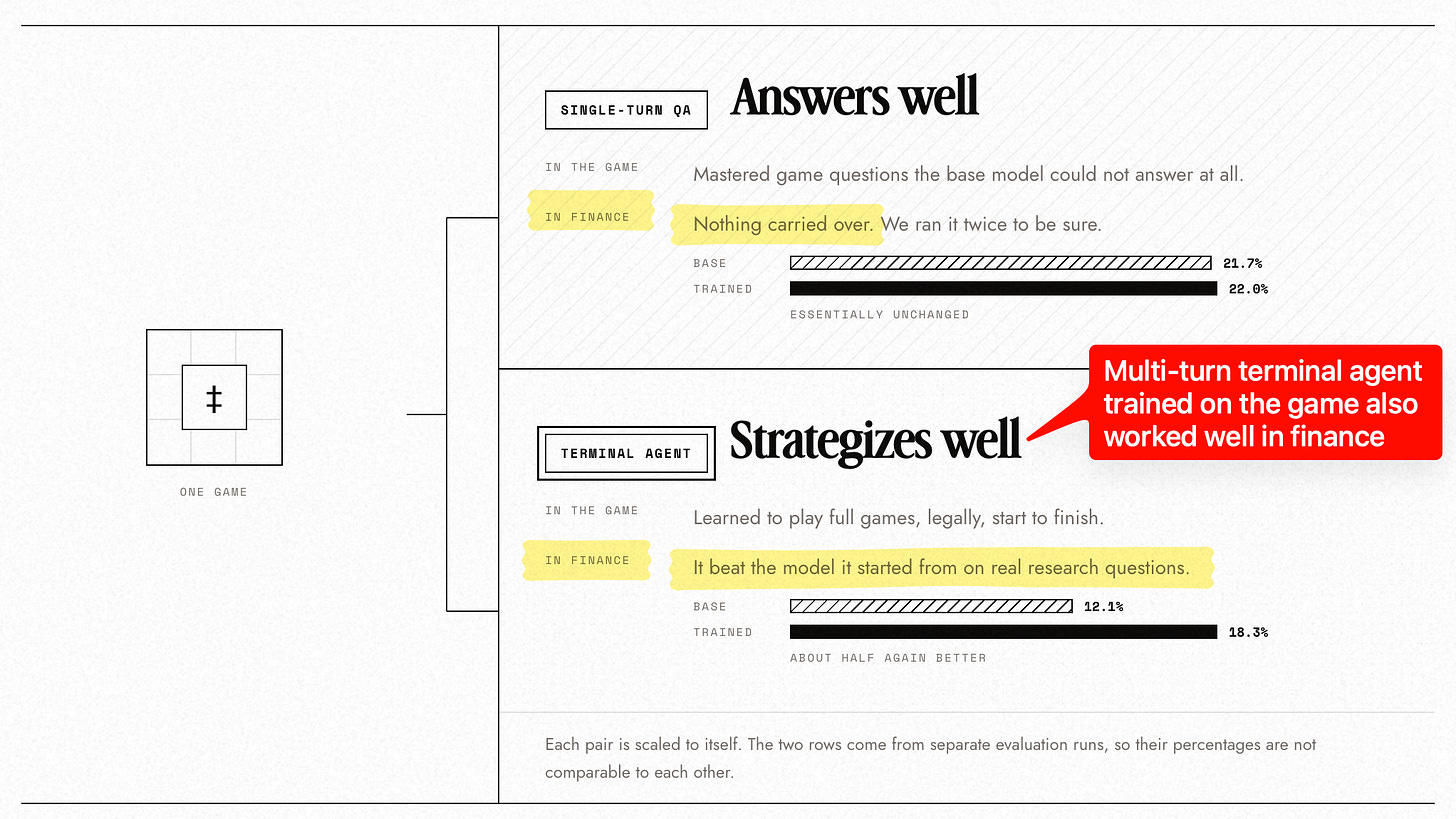
已发表的结果对比了单轮问答(模型拿到一个游戏状态,被要求走下一步)与“多轮终端智能体”(使用工具探索环境、规划策略并实时调整)。
两种训练设计都提升了各自的游戏内目标,但只有终端智能体设计提升了在 Finance-Agent 基准测试上的表现。
设计一个教授能力的学习环境
1830 的结果表明,训练设计是关键。但更一般地说,Duffy 表示 Good Start Labs 还可以加入一个专家模型,提供更密集的、分步骤的奖励。
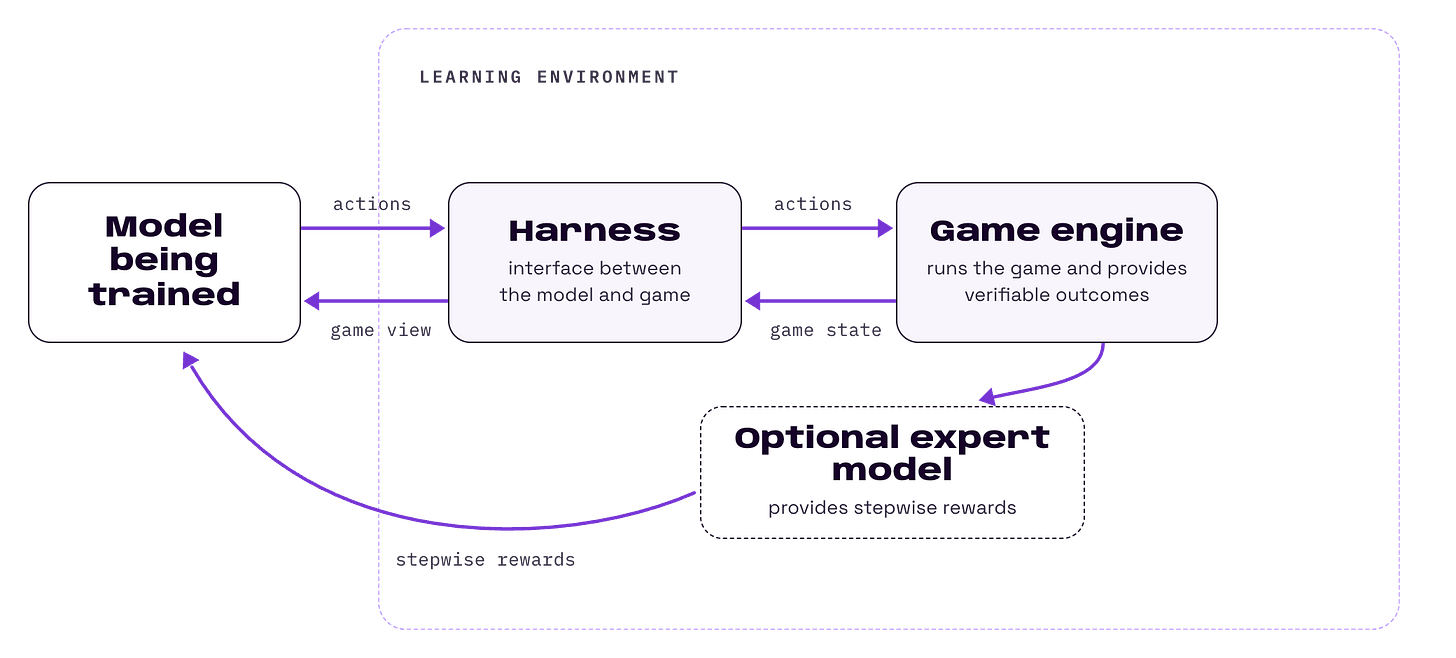
harness 还允许环境以不同方式来呈现同一款游戏。
“你如何设计它[harness],会彻底改变模型能学到什么,”Duffy 说。“可以想象,一个看图片的模型学到的东西,会和一个阅读自然文本的模型[或者一个一切都以 Python 形式呈现的模型]不一样。”
Duffy 把 Good Start Labs 的总体目标描述为弄清楚“如何设计一个学习环境来教授特定能力?”
这个问题在 COS-PLAY: Co-Evolving LLM Decision and Skill Bank Agents for Long-Horizon Tasks 一文中得到了探讨,该论文由 Duffy 和 Marques 与多所大学的研究人员共同撰写。
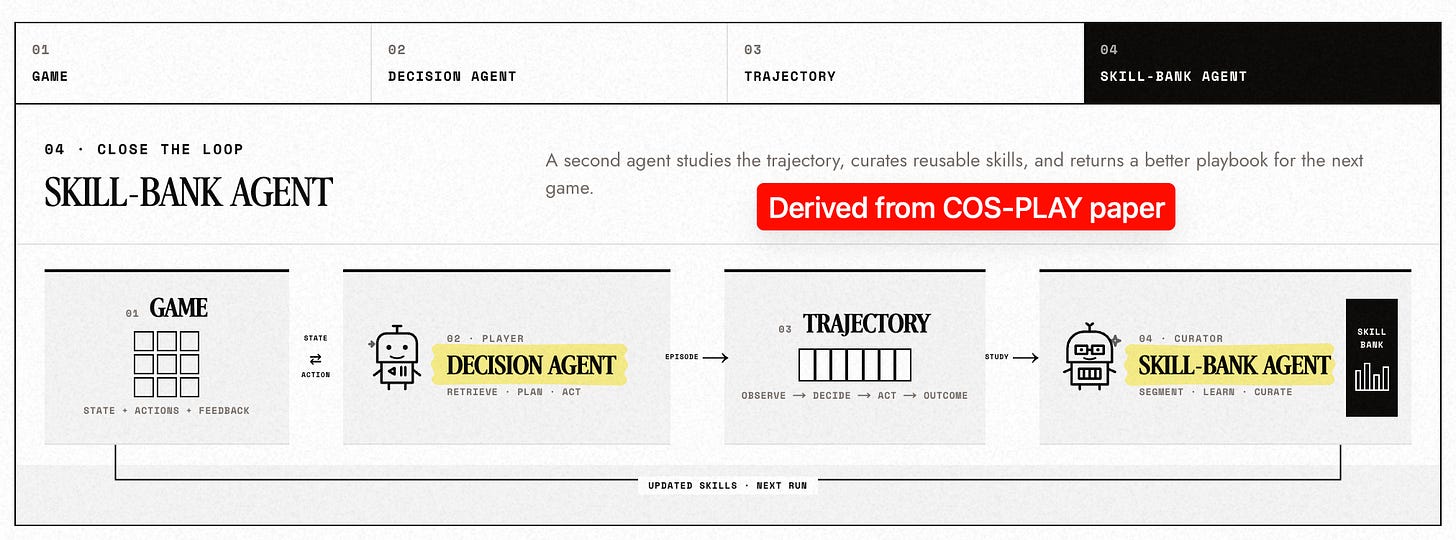
在论文中,该系统让一个决策智能体可以使用作者所说的“可学习的技能库来指导行动”。另一个技能库智能体则研究运行轨迹并修改技能库,修改后的技能库再反馈到下一次运行中。
那最新的前沿模型呢?
我问 Good Start Labs 是否在相同的游戏环境中比较过更新的模型,比如 Claude Fable 5.1 和 GPT-6 Astra?由此延伸,基础模型越来越强,是否会让 harness 和训练环境变得不那么重要?
“我们会比较每一个新模型,”Duffy 回答说,并补充道,更新、能力更强的模型往往更擅长这些游戏。不过,就像 2025 年的模型在最初的 Twitch 直播中所显示的那样,新模型“在性格维度上各不相同:背叛、协作、心智理论等等”。
至于 harness,他说“能力更强的模型完成同样的任务,当然需要更少的手把手引导。”
但对于 Good Start Labs 正在做的事——把“环境当作课程”——harness“更重要,而不是更不重要”。
“GPT-6 Astra 自称思维链更少,会直接跳到答案,”Duffy 说。“如果你希望模型在解决问题时以某种方式工作,是 harness 在强制它这么做。Astra 或许可以在脑子里心算,但你更希望它用代码,这样你才能信任结果。”
Good Start Labs 在卖什么?
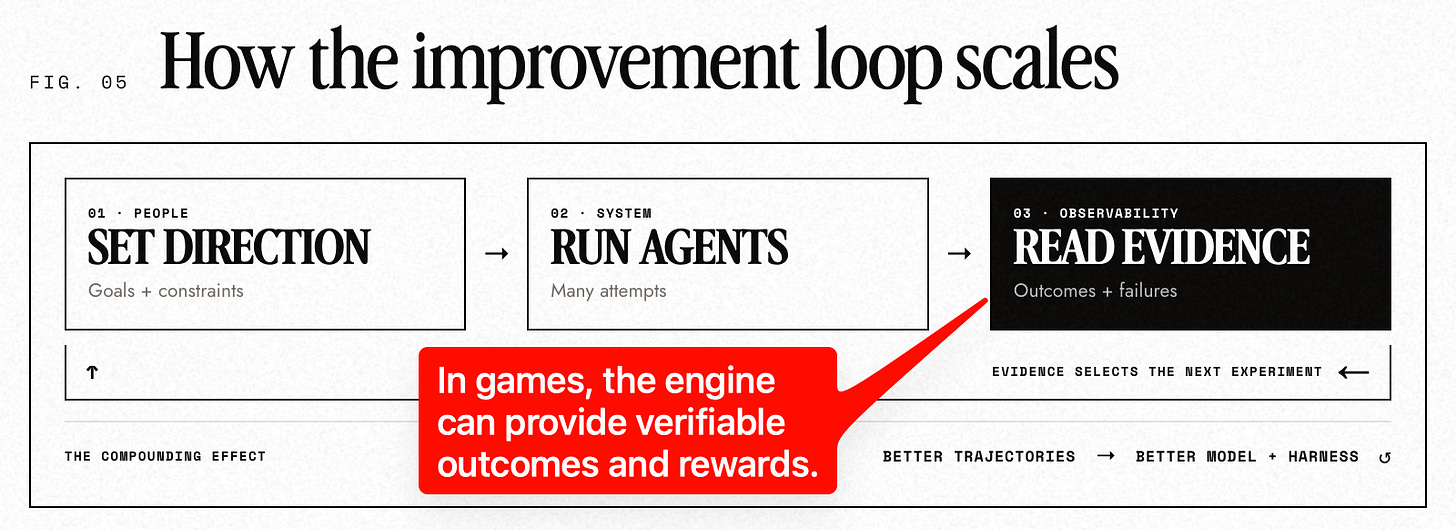
在最近的一篇博客文章中,该公司介绍了它在“改进循环”方面的工作,其中包括训练系统、harness 和可观测性。但这如何转化为 Good Start Labs 向其他公司提供的产品呢?
“就 AI 改进而言,我们卖的主要是数据和学习环境,”Duffy 回答说。其主要客户是前沿实验室,公司为它们提供强化学习数据,帮助进一步训练模型。
他把数据业务描述为两类之一。第一类是“智能体玩游戏的轨迹”,即智能体观察到了什么、做出了什么决定、采取了哪些行动,以及之后发生了什么。
第二类是面向特定游戏发行商的定制数据,即“智能体在他们的游戏中实时运行”。这些智能体可以在游戏内进行游玩,产生可能对训练和评估有用的交互。Duffy 表示,卖给模型开发者的任何数据都经过匿名化,并去除了个人身份信息。
他指出,Good Start Labs 出售的学习环境是“模型可以从头到尾完整游玩的完整游戏”。但重点并不在于赢下游戏。更重要的是教会 AI 模型解决问题。
“我们还会设计大量任务,让模型把游戏引擎作为可验证的奖励来源,但用你可能意想不到的方式解决问题。”
那么,游戏技能能迁移到现实工作吗?
除了为客户做定制工作,Good Start Labs 还在利用它为特定游戏构建的专家模型来训练一个通用模型。Duffy 说,想法是把这些专家模型统一起来,“形成可适用于任何地方的通用游戏智能”。
但是,尽管 1830 实验表明,智能体式的游戏训练可以迁移到结构相似的金融研究任务,目前还不清楚是否会有更广泛的现实世界迁移。我问 Duffy,目前的证据究竟说明了什么?
“目前的证据相当明确地支持:以目标为导向的执行很重要,推理能力是可以迁移的,”他回答说。他提到了 Surge AI 最近的一篇文章,该文显示办公工作的后训练提升了编码能力,并补充说“DeepSeek R1 更广泛地证明了这一点。”
“我们自己就看到过两次:1830 的金融任务,以及产出了更好客户支持智能体的《外交》训练。我们构建的每个环境,也都会改善下游的工具使用。”
因此,对于我们的大问题,答案是一个有保留的“是”:部分游戏技能可以迁移到现实工作中。但 Duffy 说,它们能在多大范围、多可靠地迁移,仍然是一个悬而未决的问题。