缺乏恰当的控制手段时,网站所有者长期面临一个两难的取舍:要么允许自己的内容被用于 AI 训练,要么冒着在搜索中失去可发现性的风险。之所以存在这种取舍,是因为互联网上一些最大的机构使用混合用途爬虫:同一个爬虫既服务于搜索,又服务于 AI 训练。拒绝其一,就等于拒绝了另一个。
今天,Cloudflare 宣布推出新的禁止 AI 训练(Disallow AI Training)设置,让你可以轻松地保持被搜索收录,同时不让同一个爬虫拿你的内容去训练。Apple、Google 和 Microsoft 已遵守或已承诺(在指定时间范围内)遵守这一设置。
混合用途爬虫是训练问题中最棘手的部分,接下来是 AI 摘要。全站一刀切的“是”或“否”过于粗糙:摘要中出现多少内容,与是否出现同样重要。允许退出 AI 摘要,已经是我们对混合用途爬虫运营方提出的要求之一。我们的目标是在明年年初之前,让你能够控制内容被纳入的程度,只需在 Cloudflare 设置一次,而不必分别向各个运营方设置。
为什么只是请求还不够
大多数网站所有者都希望被人发现:被人类、智能体和(善意的)机器人发现。但开放互联网的很大一部分依靠广告、订阅或与访客的直接关系来维持,而这些模式只有在真正有人访问时才会带来收入。
几乎每个网站所有者都认为搜索是有益的:只有不到 1% 的 Cloudflare 站点选择屏蔽搜索机器人。训练则是另一回事:17% 的站点选择启用某种机制来阻止训练。这正是我们认为网站所有者需要更精细的控制,而不是一刀切的“屏蔽 AI”的原因。
仅靠 robots.txt 指令无法解决这个问题。任何人都可以发布一份 robots.txt,但它无法识别是谁在爬取、判断为何爬取,也无法阻止无视它的爬虫。
不过,网络可以解决:我们发布偏好设置、识别爬取者、对其爬取目的分类、屏蔽无视偏好的爬虫,然后在 Radar 上报告各个运营方的实际做法。
但屏蔽只是移除一个爬虫,并不会改变爬虫的行为。更好的结果是让运营方根本不必让你做选择。因此自 7 月以来,我们一直在直接与他们沟通。回应令人鼓舞:几乎所有运营方都同意,网站所有者应当对其内容如何被使用拥有控制权和透明度,并保证会尊重他们的选择。为了帮助网站所有者了解这一点,我们设立了一个称号:Accountable(负责任)。
Accountable 称号既认可当前已具备的能力,也认可兑现这些能力的具体承诺。要获得资格,机器人运营方必须满足或承诺满足以下要求:
- 为网站所有者提供通过 robots.txt 或类似标准退出 AI 训练的机制。
- 为网站所有者提供退出 AI 摘要的机制,今年直接向运营方设置,明年可通过 Cloudflare 设置(详见下文相关部分)。
- 提供 URL 级别的可见性,显示哪些页面被提供用于训练,以及显示内容在搜索中呈现情况的指标。
- 保证退出 AI 训练不会影响传统搜索结果。
Apple、Google 和 Microsoft 都证明了自己满足成为 Accountable 的条件。它们各自把当前已有的能力与尚在开发中的能力的限时承诺结合起来。下文将分别介绍这几家公司爬虫的详细情况。
新的安全设置选项
Cloudflare 按行为对机器人分类,一个机器人可能表现出不止一种行为。以下三种行为可作为控制项:
- 搜索(Search):为构建搜索索引而进行的爬取。
- 训练(Training):为训练或微调模型而进行的爬取。
- 智能体(Agent):由用户指挥、代表人类访问页面的智能体,例如聊天抓取机器人和浏览器使用型智能体。
混合用途爬虫是同时进行搜索和训练的单一爬虫。缺乏控制手段时,这种组合就会造成上文所述的取舍:网站所有者无法在拒绝其中一种用途的同时不拒绝另一种。
为避免屏蔽 Accountable 的混合用途爬虫(即那些不强迫网站所有者做出这种取舍的爬虫),我们引入了一项新设置:禁止 AI 训练(Disallow AI Training)。该设置的名称取自它在你的 robots.txt 中发布的 Disallow: 指令。
“屏蔽”设置的含义现已不同
“屏蔽”和“在有广告的页面上屏蔽”此前不适用于混合用途爬虫,因为屏蔽它们也可能影响搜索的可发现性。现在有了新的“禁止 AI 训练”设置,“屏蔽”和“在有广告的页面上屏蔽”将适用于所有训练爬虫,包括混合用途爬虫。
训练、搜索和智能体的控制都在域名级别生效。加入“禁止 AI 训练”之后,可用的设置如下:
- 允许:允许所有爬虫,除非被其他设置或 WAF 规则屏蔽。
- 禁止 AI 训练:Bot Preference Sync 会在 robots.txt 中发布适用的禁止训练偏好。Accountable 的混合用途爬虫仍可用于搜索。其他所有训练爬虫都会被屏蔽,包括 Amazon、Anthropic、Meta 和 OpenAI 运营的纯训练爬虫,屏蔽它们不会影响搜索。“禁止 AI 训练”仅作为“训练”的设置提供,不适用于“搜索”或“智能体”。
- 在有广告的页面上屏蔽:仅在检测到投放广告的页面上屏蔽爬虫,包括混合用途爬虫。
- 屏蔽:屏蔽所有爬虫,包括混合用途爬虫。
“禁止 AI 训练”的工作方式是在 robots.txt 中发布一项偏好。“仅在有广告的页面上”这类偏好无法用这种方式表达:Cloudflare 可以检测哪些页面投放广告,但这份列表过大且变化过于频繁,无法在 robots.txt 中逐一列出。这就是没有“在有广告的页面上禁止 AI 训练”选项的原因。
智能体不会像混合用途爬虫那样造成搜索可发现性的取舍,而且互联网上目前也还没有成熟的指令来向智能体表达“禁止”偏好。因此,我们暂时不为智能体提供“禁止”设置。随着 ai-prefs 等标准逐渐成熟,我们将重新审视这一做法。
9 月 15 日会有什么变化?
我们将对 Bot Management 和 AI Crawl Control 做出以下改动:
- “屏蔽”和“在有广告的页面上屏蔽”现在适用于混合用途爬虫,包括 Applebot、Bingbot 和 Googlebot,因此无论选择哪项设置,都会同时影响搜索和训练。若要阻止训练并保留搜索,请使用“禁止 AI 训练”。
- “屏蔽 AI 机器人(Block AI Bots)”将被弃用,由更精细的搜索、训练和智能体控制取代。
- Managed Robots.txt 将被弃用,由 Bot Preference Sync 取代。已启用 Managed Robots.txt 的客户将迁移到新系统。
- 对于某些新域名,“禁止 AI 训练”将成为推荐配置的一部分。
- 现有客户的偏好将按下文所述迁移到新的控制项。
你需要做什么
几乎所有情况下都无需任何操作。你当前的设置会自动沿用。
如果你想彻底屏蔽混合用途爬虫,现在需要明确表态:选择“屏蔽”。这会阻止 Applebot、Bingbot 和 Googlebot 访问你的站点,搜索也包括在内。
从未使用过搜索/训练/智能体控制的现有域名
从未配置过更精细控制项的网站所有者,将根据其旧版“屏蔽 AI 机器人”设置迁移到新设置:
| (旧版) “屏蔽 AI”设置 |
(新版) 搜索设置 |
(新版) 训练设置 |
(新版) 智能体设置 |
|---|---|---|---|
| 已禁用(未选中) | 允许 | 允许 | 允许 |
| 屏蔽 | 允许 | 禁止 AI 训练 | 在有广告的页面上屏蔽 |
| 在有广告的页面上屏蔽 | 允许 | 禁止 AI 训练 | 在有广告的页面上屏蔽 |
此前已配置过搜索/训练/智能体控制的现有域名
对于此前配置过精细控制项的域名,我们将在新的定义下保留其所选设置的实际效果。此前训练选择“屏蔽”或“在有广告的页面上屏蔽”的,将迁移为“禁止 AI 训练”。
| 控制项 | 旧版设置 | 新设置 |
|---|---|---|
| 搜索 | 允许 | 允许 |
| 屏蔽 | 屏蔽 | |
| 在有广告的页面上屏蔽 | 在有广告的页面上屏蔽 | |
| 训练 | 允许 | 允许 |
| 屏蔽 | 禁止 AI 训练 | |
| 在有广告的页面上屏蔽 | 禁止 AI 训练 | |
| 智能体 | 允许 | 允许 |
| 屏蔽 | 屏蔽 | |
| 在有广告的页面上屏蔽 | 在有广告的页面上屏蔽 |
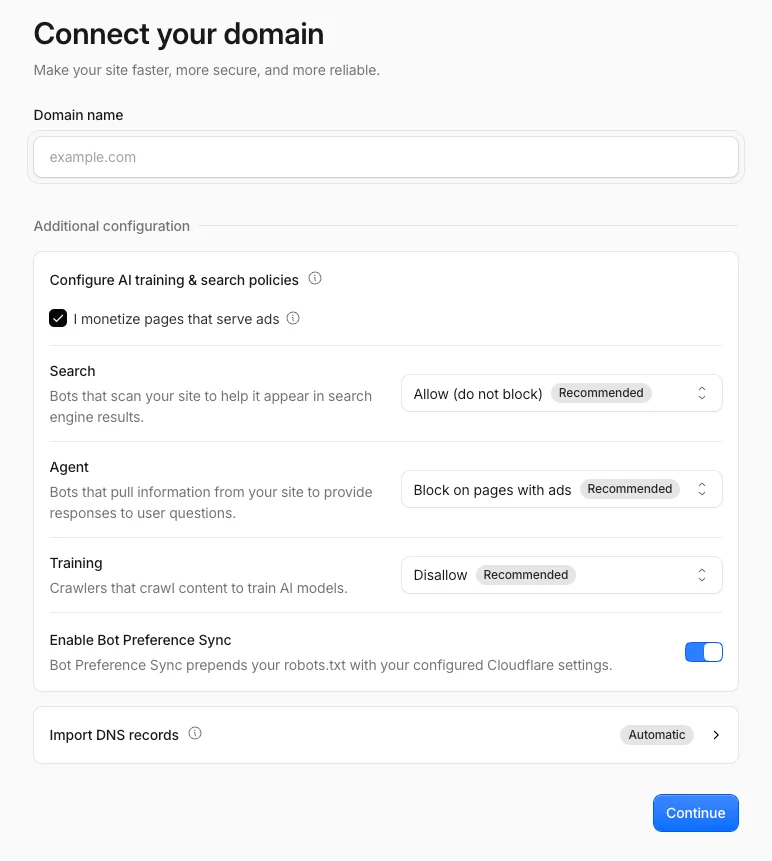
新域名的推荐配置
自 9 月 15 日起,接入新域名的客户将根据站点是否通过广告获利,获得两种预设配置之一。广告收入取决于真人确实看到了页面。训练用一个答案取代了这次访问;智能体抓取页面时,根本没有人去看广告。因此,面向广告变现站点的预设更为严格。你可以在接入过程中或之后随时更改其中任何设置。
| 设置 | 站点不通过广告变现 | 站点通过广告变现 |
|---|---|---|
| 偏好同步(Preference Sync) | 已启用 | 已启用 |
| 搜索 | 允许 | 允许 |
| 训练 | 允许 | 禁止 AI 训练 |
| 智能体 | 允许 | 在有广告的页面上屏蔽 |
新域名的推荐设置
这对具体的混合用途爬虫意味着什么?
Applebot、Bingbot 和 Googlebot 均为 Accountable。Apple、Google 和 Microsoft 都认同发布者选择权和透明度这一共同原则。在“禁止 AI 训练”下,它们仍可继续爬取你的站点用于搜索。选择“屏蔽”则会彻底阻止它们。
我们也将 Amazon、Anthropic、Meta 和 OpenAI 的相关爬虫归为 Accountable。这些机构把搜索爬虫和训练爬虫分开运营,因此 Cloudflare 可以屏蔽训练爬虫而不影响搜索。
Applebot
Applebot 允许网站所有者通过在 robots.txt 中为“Applebot-Extended”添加 Disallow 规则来退出训练。网站所有者目前还可以通过页面 HTML 中的 nosnippet 指令表达对 AI 摘要的偏好。内容也可以被标记为付费墙内容,以将其排除在生成式输出之外。Applebot 尚未提供 URL 级别的检查工具,但我们已与其团队会面,他们分享了明年将推出的解决方案的进展细节。Apple 也已表示,禁止训练不会影响搜索排名。
Googlebot
Googlebot 允许网站所有者通过在 robots.txt 中为“Google-Extended”添加 Disallow 规则来退出训练,并在其网站管理员门户中提供开关,用于将站点内容排除在生成式搜索结果之外。Googlebot 还向网站所有者提供有关搜索结果和 AI 摘要结果的指标与报告。Google 分享了其现有的和近期推出的控制措施,以及正在开发的工作,包括与 Google-Extended 相关、面向网站所有者的更多 URL 级别透明度工具,预计将在未来几周内推出。Google 也已表示,禁止 Google-Extended 不会影响搜索排名。
Bingbot
Bingbot 在其网站管理员工具(Webmaster Tools)中提供精细的控制和透明度。网站所有者目前可以通过 Bing 的 NOARCHIVE meta 标签表达 AI 训练偏好。Microsoft 正在扩展这些能力,并正在构建在域名/站点级别也遵守 robots.txt 中“禁止训练”偏好的机制,目标是 2027 年初。对于希望现在就在 Bing 中退出训练的 Cloudflare 客户,除使用 NOARCHIVE 标签外,网站所有者还可以使用屏蔽 URL 或内容移除工具。Microsoft 也已表示,使用 NOARCHIVE 不会影响搜索排名。
在该支持上线之前,选择“禁止 AI 训练”不会通过 robots.txt 自动向 Bing 传达禁止训练的偏好。这与此前“训练:屏蔽”设置的实际行为相同,后者并不适用于 Bingbot 等混合用途爬虫。
持续推进
随着这些能力的演进,我们将继续联系并接触所有 AI 爬虫的运营方。Cloudflare Radar 会公开追踪 Accountable 爬虫运营方提供的控制、透明度和报告。
要让互联网变得更好,需要双方都拥有自主权:爬虫需要访问开放网络,而创造这个网络的人则需要对其作品如何被使用拥有切实的控制权。今天的公告标志着在实现这种平衡上取得了切实进展。
进步需要基础设施提供商、内容创作者、科技公司以及互联网工程任务组(IETF)等标准组织共同努力,把这些原则转化为开放、可互操作的标准。
下一步:AI 摘要
训练和 AI 摘要向网站所有者提出了不同的问题。训练关乎内容能否被用于构建 AI 模型;摘要则影响人们如何发现、评估并最终访问一家企业。两者都很重要,但对企业的影响方式不同。
退出 AI 摘要的控制是第一步。被认定为 Accountable 的运营方要么已经提供这项能力,要么正在完成相关工作,这就确立了一条重要的底线:网站所有者可以说不。
但在允许与禁止摘要之间做全站选择,仍然是一种粗糙的手段。正确的决定取决于站点、内容和业务结果。对于出版商而言,训练引发了关于控制权、补偿以及原创内容可持续性的根本问题。摘要则带来另一个、往往更为紧迫的分发问题:用户是访问出版商的网站,还是在搜索或 AI 体验中直接获取答案?对许多其他企业来说,AI 摘要越来越多地介于潜在客户和网站之间。它们可能回答问题、比较备选方案、推荐产品,或帮助人们决定是否要访问。
数据显示的影响好坏参半。超过一半的消费者会阅读搜索中的摘要,而这些消费者在阅读摘要后结束搜索的可能性高出 40% 以上。这可能会减少网站获得的访问量。但通过 AI 搜索引流的消费者,其转化率是通过传统搜索引流的消费者的三倍到五倍以上。AI 可能带来更少的访问,但带来的客户意向要强得多。
这本身无所谓好坏。靠广告维持的出版商可能会优先追求受众规模;零售商则可能更希望访客少一些,但更有可能购买。Cloudflare 的角色不是替他们做选择,而是提供做出明智决定所需的可见性和控制手段。
退出摘要是一个有力的开端,但并非终点。我们接下来的重点,是帮助网站所有者了解摘要如何影响他们的业务,并让他们对内容可被使用的程度拥有更多控制权。ai-prefs 等开放标准将是实现这一目标的重要组成部分。
如果你希望在这场讨论中发声或提供反馈,请联系 crawlercontrols@cloudflare.com。
这些新控制项面向所有套餐的所有客户开放,可在域名(zone)的安全设置(Security Settings)中配置。还没用上 Cloudflare?免费开始,立即设置你想要的流量控制。