Cursor 是一个具备持续后台智能的 AI 编程平台,由一支训练智能体编程模型并将其投入生产的研究团队打造。开发者在输入的同时,Cursor 会维护一个实时的代码上下文模型:预测编辑、重构代码,并实时管理上下文。
要提供这样的体验,响应必须落在编辑器的反馈回路之内。这一约束把服务问题从批处理式变成了实时、低延迟的推理。Cursor 与 AI 原生云 Together AI 合作,为这一回路构建基础设施,采用 NVIDIA Blackwell 架构,并调优推理栈以满足严格的延迟目标。
为什么编辑器内的延迟与众不同
编辑器内的智能体是在开发者正在编辑的同时生成输出的,因此时机决定了一条建议是否落在模型生成它时所用的同一局部上下文中。一旦开发者移动到代码的另一个区域,输出往往就不再与它本应支持的状态对得上了。
在 Cursor 中,这些智能体会在开发者继续工作的同时调试问题、生成功能并执行重构。这种工作负载要求在并发下具有可预期的最坏情况延迟,在相互重叠的请求之间保持一致的上下文处理,并在持续负载下稳定运行。
基于 NVIDIA Blackwell 的工程实践
为了在规模化下满足延迟预算,两支团队选用了 NVIDIA Blackwell GB200 NVL72 和 NVIDIA HGX™ B200,它们具备更高的内存带宽和张量吞吐量,可支持更快的服务。在硬件生命周期早期就部署生产工作负载,意味着要在整个技术栈上推动可靠性和优化,涵盖硬件、固件、主机软件和服务层。
- 基于 NVIDIA Blackwell 的前沿基础设施:Together AI 与 Cursor 合作,共同推进 NVIDIA Blackwell 的早期落地。对 Cursor 来说,尽早拿到硬件是一项产品优势,Together 的工程师致力于快速升级和更换,以交付这套全新的前沿基础设施。这些努力让 Cursor 得以快速、可靠地用上这些新芯片。
- 在 ARM 主机上跑满吞吐量:GB200 NVL72 将 GPU 与基于 ARM 指令集的 NVIDIA Grace™ CPU 配对。高性能推理生态的很大一部分都默认主机是 x86。把推理栈移植到 ARM,需要针对 GB200 NVL72 做 kernel 和主机层面的调优。
- 面向 Blackwell Tensor Core 的定制 kernel:Blackwell 引入了针对低精度格式优化的新 Tensor Core 指令。Together AI 为 Blackwell 构建了直接瞄准这些指令的 kernel,从而榨取出硬件更多的吞吐量。
- 跨 NVIDIA GB200 NVL72 的高效并行:GB200 NVL72 以全互联拓扑连接 72 块 NVIDIA Blackwell GPU。把模型分布到这一域内,会在芯片之间增加通信和同步开销。Together 为 GB200 NVL72 设计了并行网格,使协调成本保持在可控范围内,计算上的收益也得以延续到推理中。
缩短从权重到生产的周期
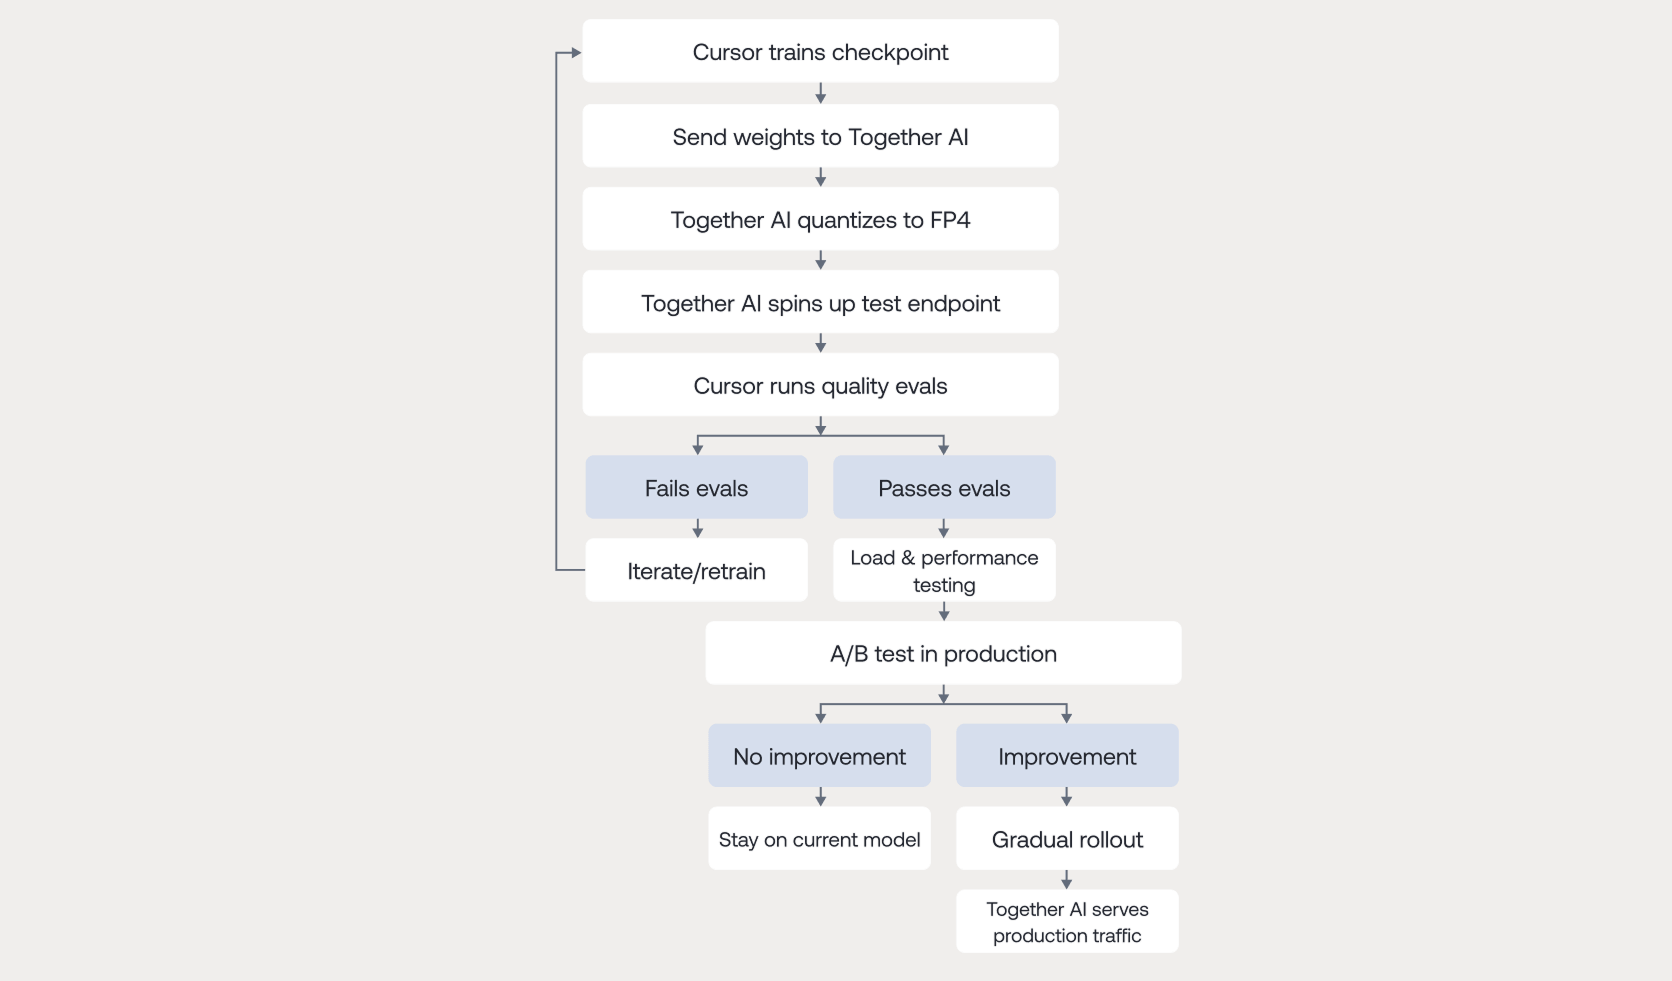
Cursor 的研究团队在内部训练模型,结合专有数据与针对编程工作流的定向优化,产出新的候选权重。与 Together AI 的合作建立了一条可重复的路径,把这些权重迁移到类生产环境的端点上,立即进行测试。
这条路径上的关键一步是量化。实时服务运行在紧张的内存和算力预算之内,而量化通过用更少的比特表示权重,同时降低这两项开销。在编程场景中,质量下降可能表现为细微的逻辑错误或语法错误,因此量化必须在改善延迟和成本的同时保住输出质量。
Together AI 实现了一条围绕 NVIDIA TensorRT LLM 和 Blackwell 上的 NVFP4 构建的量化流水线,在激进的压缩与 Cursor 编程模型所要求的质量门槛之间找到了平衡。每当 Cursor 产出新的候选模型,Together 会对其量化、验证,并在数天内启动一个测试端点。Cursor 运行内部评估套件,然后在生产流量下分阶段进行 A/B 测试,最后才完成切换。切换由验证和实时流量检查把关。
接下来:从延迟到吞吐量
Cursor 的生产部署运行在跨多个数据中心的 NVIDIA Blackwell GPU 上。NVIDIA GB200 NVL72 负责推理,这套基础设施也支撑着 Cursor 研究团队发布新权重时的模型迭代。
随着低延迟路径在生产中稳定运行,重心转向吞吐量和利用率。Cursor 与 Together AI 正在 NVIDIA Blackwell 平台上构建更高吞吐量的端点,以便在用量增长的同时改善单 GPU 的经济性。