我们很高兴与 Adaption 合作,让 Together Fine-Tuning 可以在 Adaptive Data 中使用。Adaption 由 Sara Hooker 和 Sudip Roy 共同创立,两人都曾是 Cohere 的领导者,也是 Google DeepMind 的资深成员。Adaptive Data 针对现代模型训练中的数据难题,帮助团队分析数据集结构、改编样本、评估质量并导出可直接用于模型的数据。Adaption 称,这套能力把通常只有前沿实验室才能用上的数据优化技术带给了日常的构建者,并表示在早期部署中数据质量平均提升了 82%。
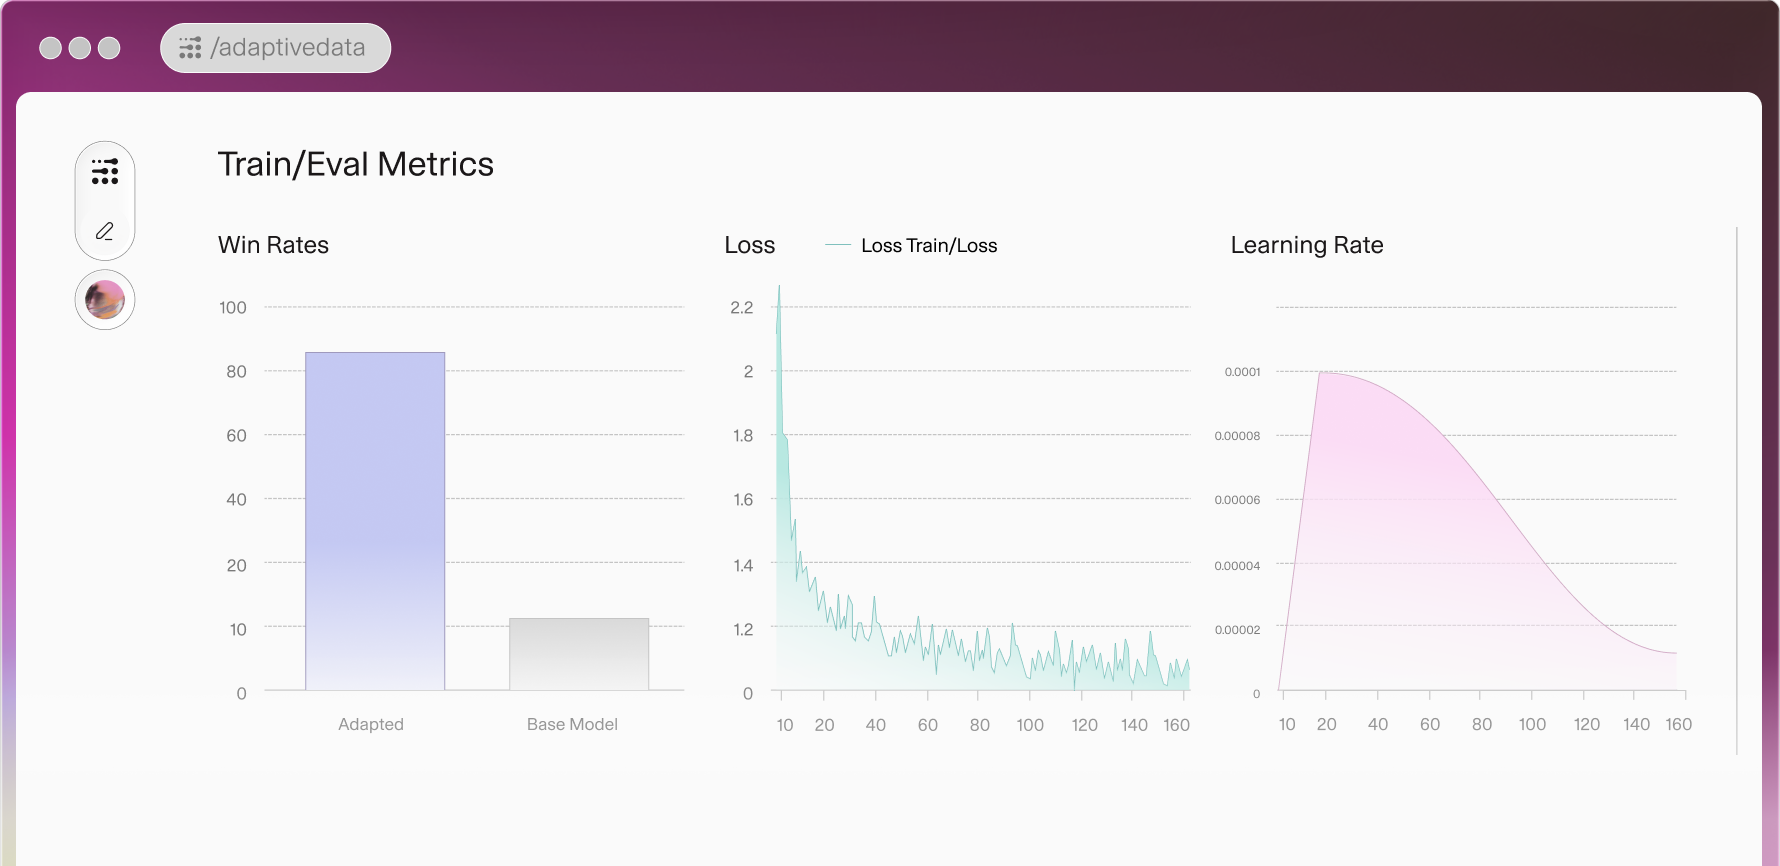
通过此次集成,Adaption 用户可以连接自己的 Together AI 账户,借助无缝的实验工作流,以最快速度获得高质量的微调模型。在 Adaption 中,用户先优化训练数据集,然后直接在该数据上运行 Together 微调,并以优化后的超参数作为起点。训练完成后,微调模型会被部署用于评估,评估结果会展示给用户;之后,用户可以把模型部署到 Together AI 的高性能推理服务上。
Together Fine-Tuning 为 Adaptive Data 用户提供了基础设施,把经过打磨的数据集转化为更强大、更可靠的开源模型。它对 LoRA 和全参数微调、大型开源模型以及实验可见性的支持,帮助我们的用户快速适配、了解发生了哪些变化,并针对目标行为提升性能。
- Sara Hooker,Adaption 联合创始人 & CEO
为什么选择 Together Fine-Tuning
Together Fine-Tuning 是领先的开源后训练与推理提供商,面向希望用自己的数据定制主流开源模型、又不想自己管理基础设施的团队。Together AI
该平台支持主流开源模型,包括 Kimi K2.5、GLM 5.1、Qwen 3.5-397B 等参数量超过 100B 的模型,涵盖结构化工具使用、推理和视觉语言等场景。用户可以在大型数据集上微调,在训练开始前估算任务成本,在运行期间跟踪预计完成时间,并将模型直接导出到 Hugging Face Hub。
通过此次集成,在 Adaptive Data 中打磨好的数据集可以直接进入 Together Fine-Tuning 工作流。Adaptive Data 改进上游数据集;Together Fine-Tuning 则把该数据集转化为专门化的模型行为。
了解更多
→ 阅读 Adaption 发布的集成公告
→ 了解 Together Fine-Tuning 的最新能力
→ 如需微调工作流和部署支持,请联系销售