

我们很高兴开源 Qwen-Image-2.1,这是 Qwen 家族中兼顾生成质量、推理效率和成本的图像模型。Qwen-Image-2.1 在单一模型中统一了文生图和图像编辑,视觉生成组件仅有 7B 参数,并原生支持生成和编辑透明图像。
此次更新带来四项关键改进:
- 小巧高效:轻量化架构与推理优化,在图像质量与计算成本之间取得平衡。
- 原生透明,创作与编辑统一:可根据提示词生成常规图像或透明图像,编辑透明图层,并从照片中提取主体。
- 编辑灵活多样:最多支持 10 张参考图,可指定局部编辑,保持人物和产品一致,并胜任各类任务。
- 真实质感与精致美学:排版、人像光影和细节表现均有提升,让生成的图像更具视觉吸引力。
小巧高效
Qwen-Image-2.1 采用轻量化架构,其视觉生成组件包含 32 层 Single-Stream DiT 和 7B 参数。尽管体量小巧,模型仍能提供出色的图像生成质量。下方的 Qwen-Image-Bench 对比展示了它与其他开源和闭源模型的表现。

推理效率是另一个重点,尤其是在输入多张图像进行编辑时。这一优化来自混合粒度注意力架构。文本(包括系统前缀和编辑指令)使用词元级因果掩码,而图像生成使用块级掩码。KV cache 复用让输入图像和编辑指令作为静态上下文,在第一步中完成计算并缓存,从而提升推理效率、降低显存占用。

原生透明,创作与编辑统一
原生透明是此次发布的一项重要新增能力。2025 年 12 月,我们推出了 Qwen-Image-Layered,作为支持透明图像生成的专用模型。如今,Qwen-Image-2.1 将这一能力整合进统一模型,由提示词决定输出常规图像还是带透明通道的图像。
以下是直接由文本生成的透明图像示例:


除了单个主体,模型还能生成由多个元素组成的更复杂的透明图像,为设计和素材创作带来更多可能。


由于统一了生成与编辑,Qwen-Image-2.1 也支持直接编辑透明图像。例如,它可以在保留透明背景的同时改变主体的表情。左侧为输入,右侧为编辑结果。


透明图层中的文字同样可以编辑。在下面的示例中,“BLOOM”被替换为“Qwen-Image”。


这一能力也适用于真实照片。给定一张 RGB 图像,模型可以将所需主体提取为带透明度的 RGBA 图层,方便在后续的设计和合成工作中复用这些元素。


编辑灵活多样
Qwen-Image-2.1 在四个方面改进了编辑能力:多参考图、局部编辑、保真度和任务覆盖。
多参考图:最多 10 张输入图像
Qwen-Image-2.1 支持最多 10 张参考图,可将多个主体和素材组合成一幅连贯的画面。在下面的合影示例中,左侧的六张单人肖像被合成到同一张照片里。

在虚拟试穿中,模特、衣服、鞋子、包和帽子这五个输入可以组合成一套完整的穿搭。

在室内设计中,模型可以使用 10 张家具图像生成完整的房间布置。

局部编辑:灵活的区域选择
Qwen-Image-2.1 支持用圆圈、涂抹标注和单独的蒙版来指定编辑发生的位置。
第一个示例使用不同颜色的圆圈同时标出三个区域:“去掉蓝色圆圈中的金属手表,把红色圆圈中的头发改成黑色,并把绿色圆圈中的区域替换为灰色短袖亚麻睡衣。”左侧为带标注的输入,右侧为结果。


涂抹标注是指定区域的另一种方式。在这个示例中,模型在输入图像右侧以白色标记的区域添加了一名潜水员。


圆圈和涂抹标注会遮挡部分原始内容。为了保留完整的输入,Qwen-Image-2.1 还支持将原图和单独的蒙版作为两个输入。下面的示例使用这两张图,要求模型生成一名骑在马背上的牛仔:


模型编辑蒙版指定的区域,得到如下结果:
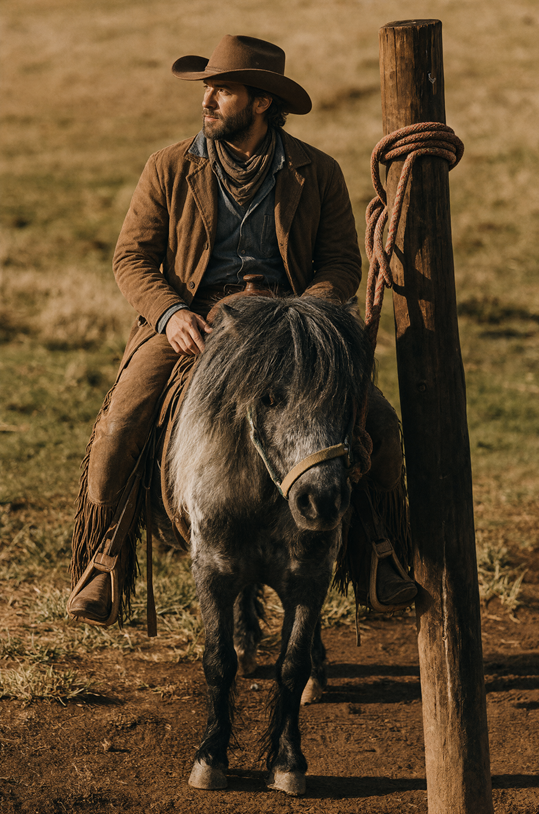
局部编辑还可以支持连续创作。通过在保留场景其余部分的同时逐步修改,编辑后的图像可以组合成简单的动画,如下方的水豚葫芦娃示例所示。
▶ https://qianwen-res.oss-accelerate.aliyuncs.com/Qwen-Image/image2.1/videos/hulu_final_48f_6fps.mp4
00:00
/
00:00
保真度:保持人物与产品一致
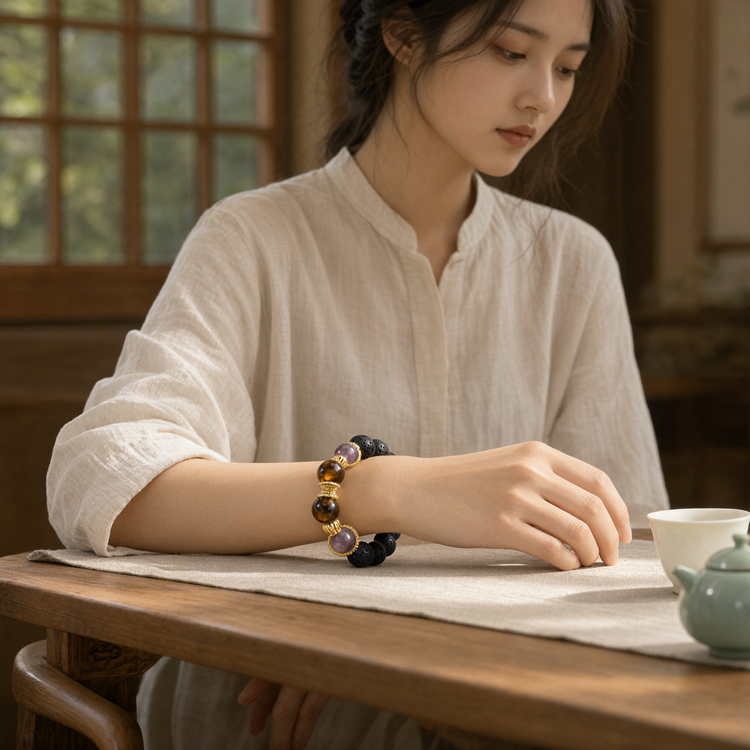
保真度的提升集中在人像身份和产品一致性上。对于人像,模型能更好地保留面部特征,使人物身份在多次编辑中保持更一致。下面每组图中,左侧为输入,右侧为编辑结果。
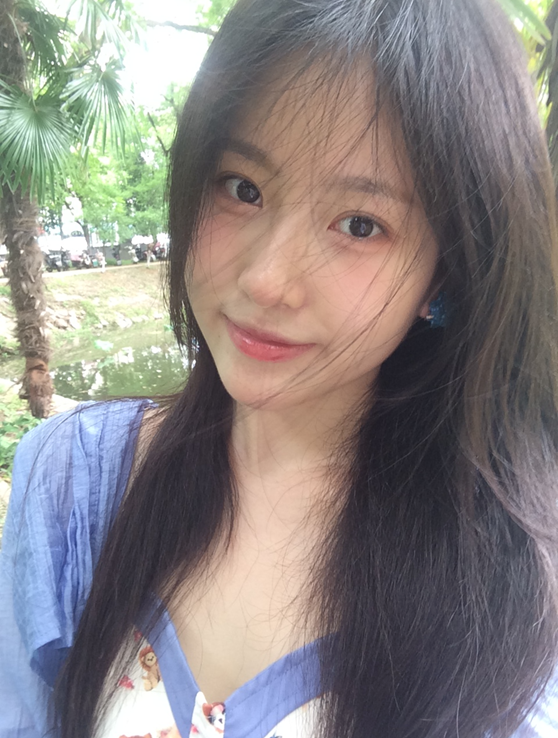
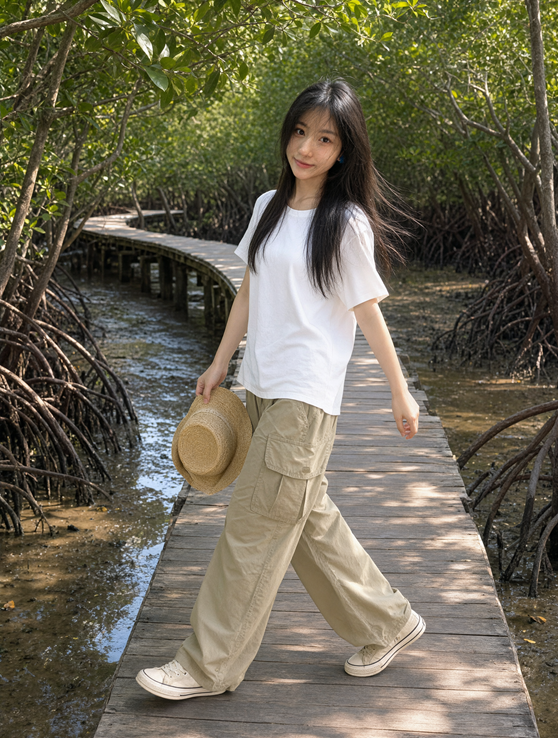
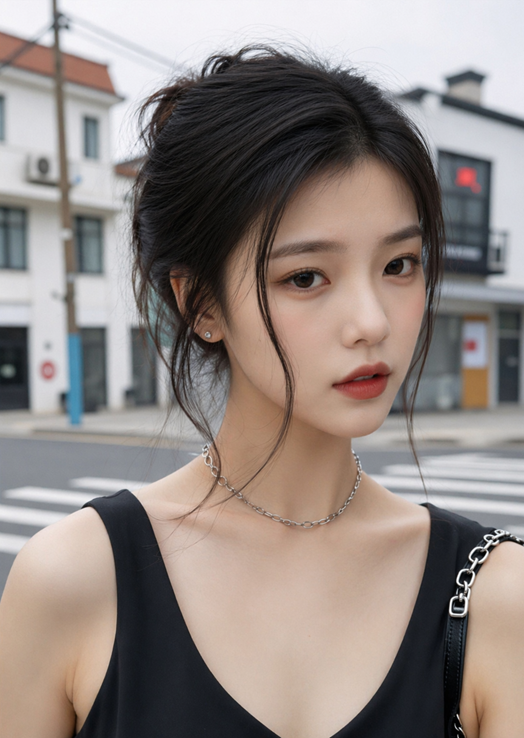
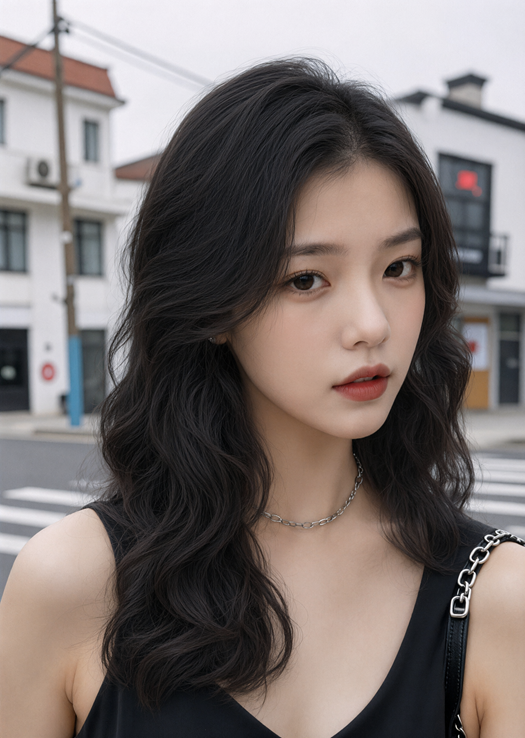
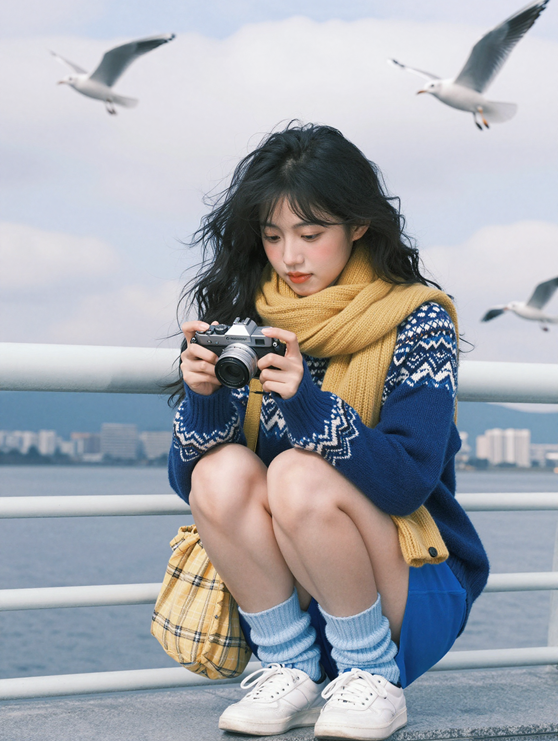
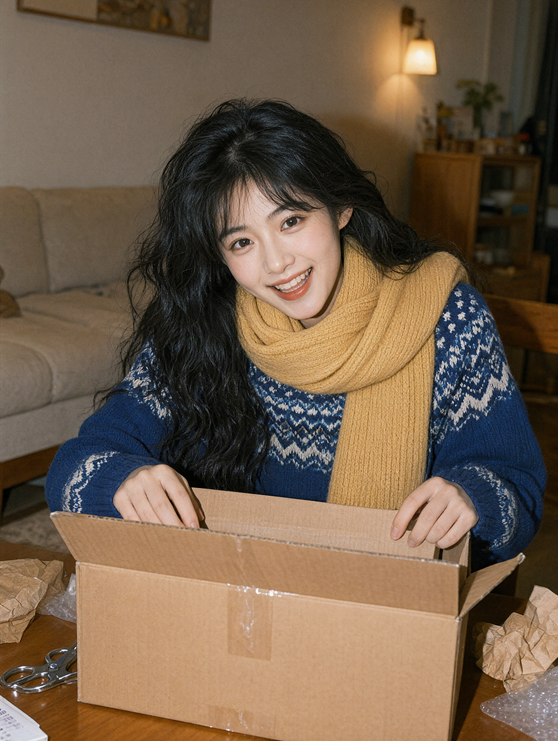
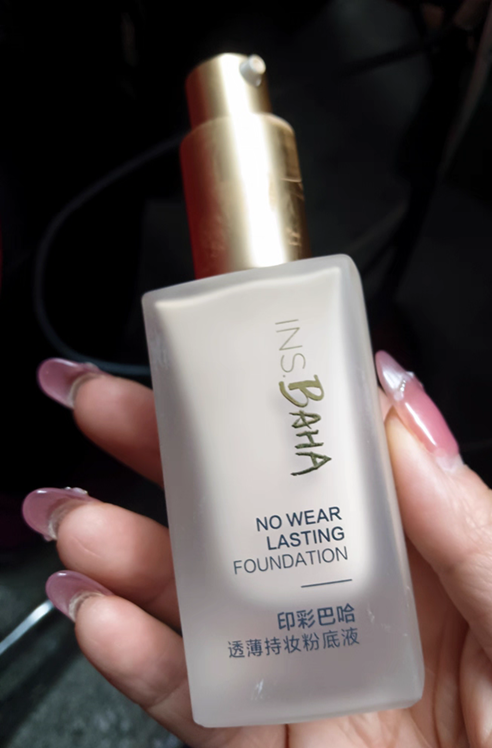
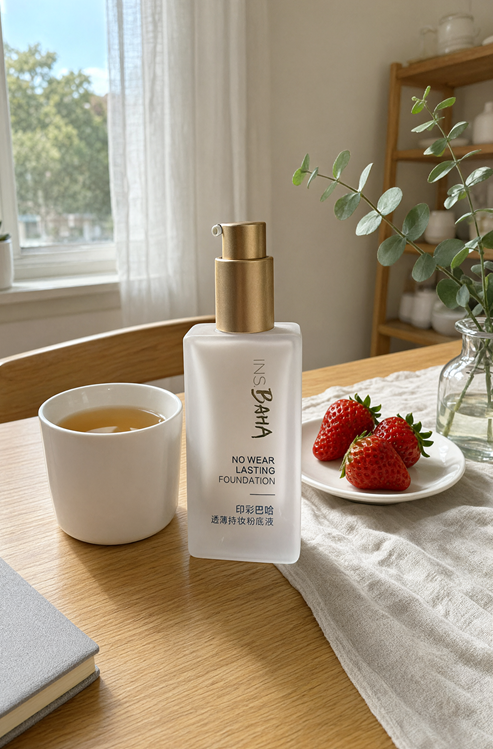
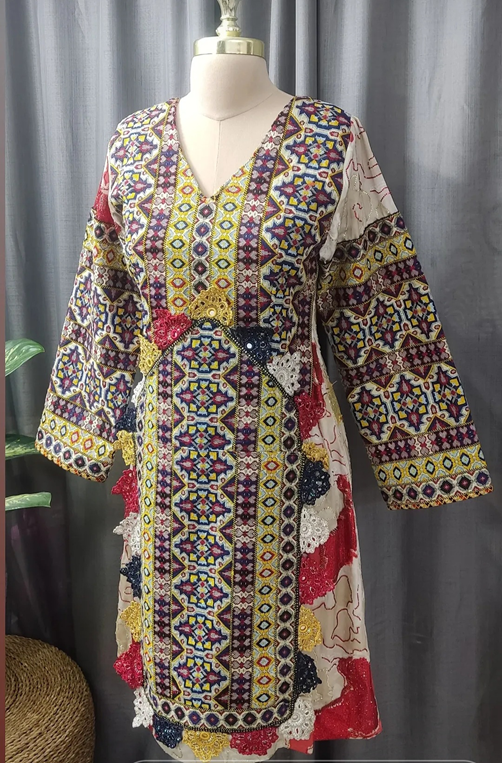
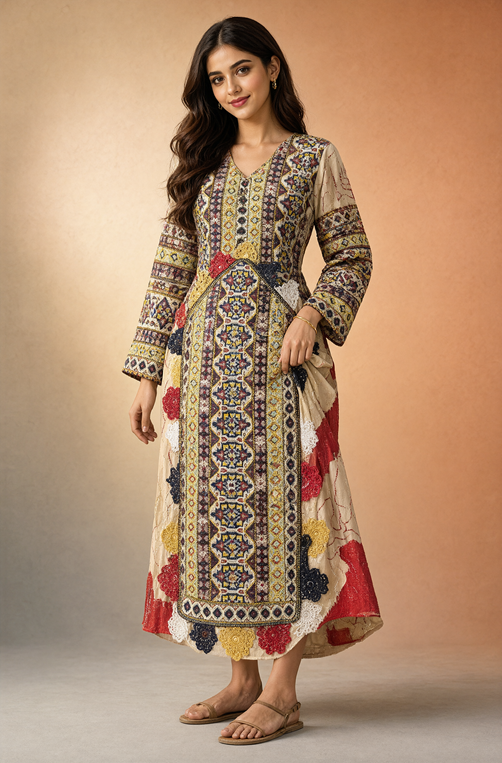
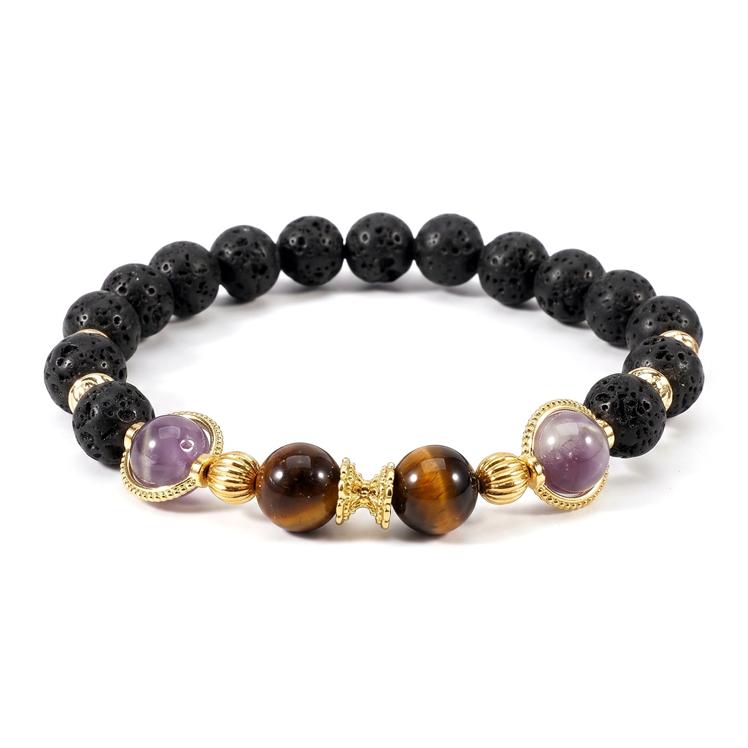
对于产品编辑,模型致力于保留文字、纹理和形状,让产品的标志性特征在新图像中保持一致。
任务覆盖:全景图、信息图与分镜
Qwen-Image-2.1 支持广泛的编辑任务,包括全景图、信息图和分镜生成,在不同应用场景之间均衡兼顾各项能力。
例如,从这张自拍开始:
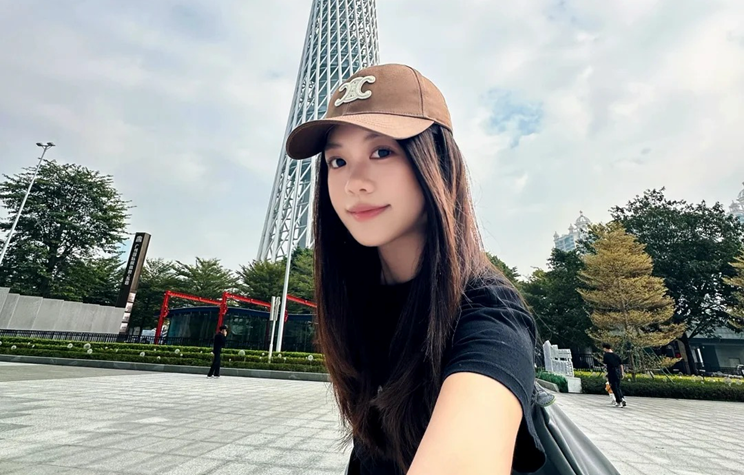
模型生成了如下全景图:
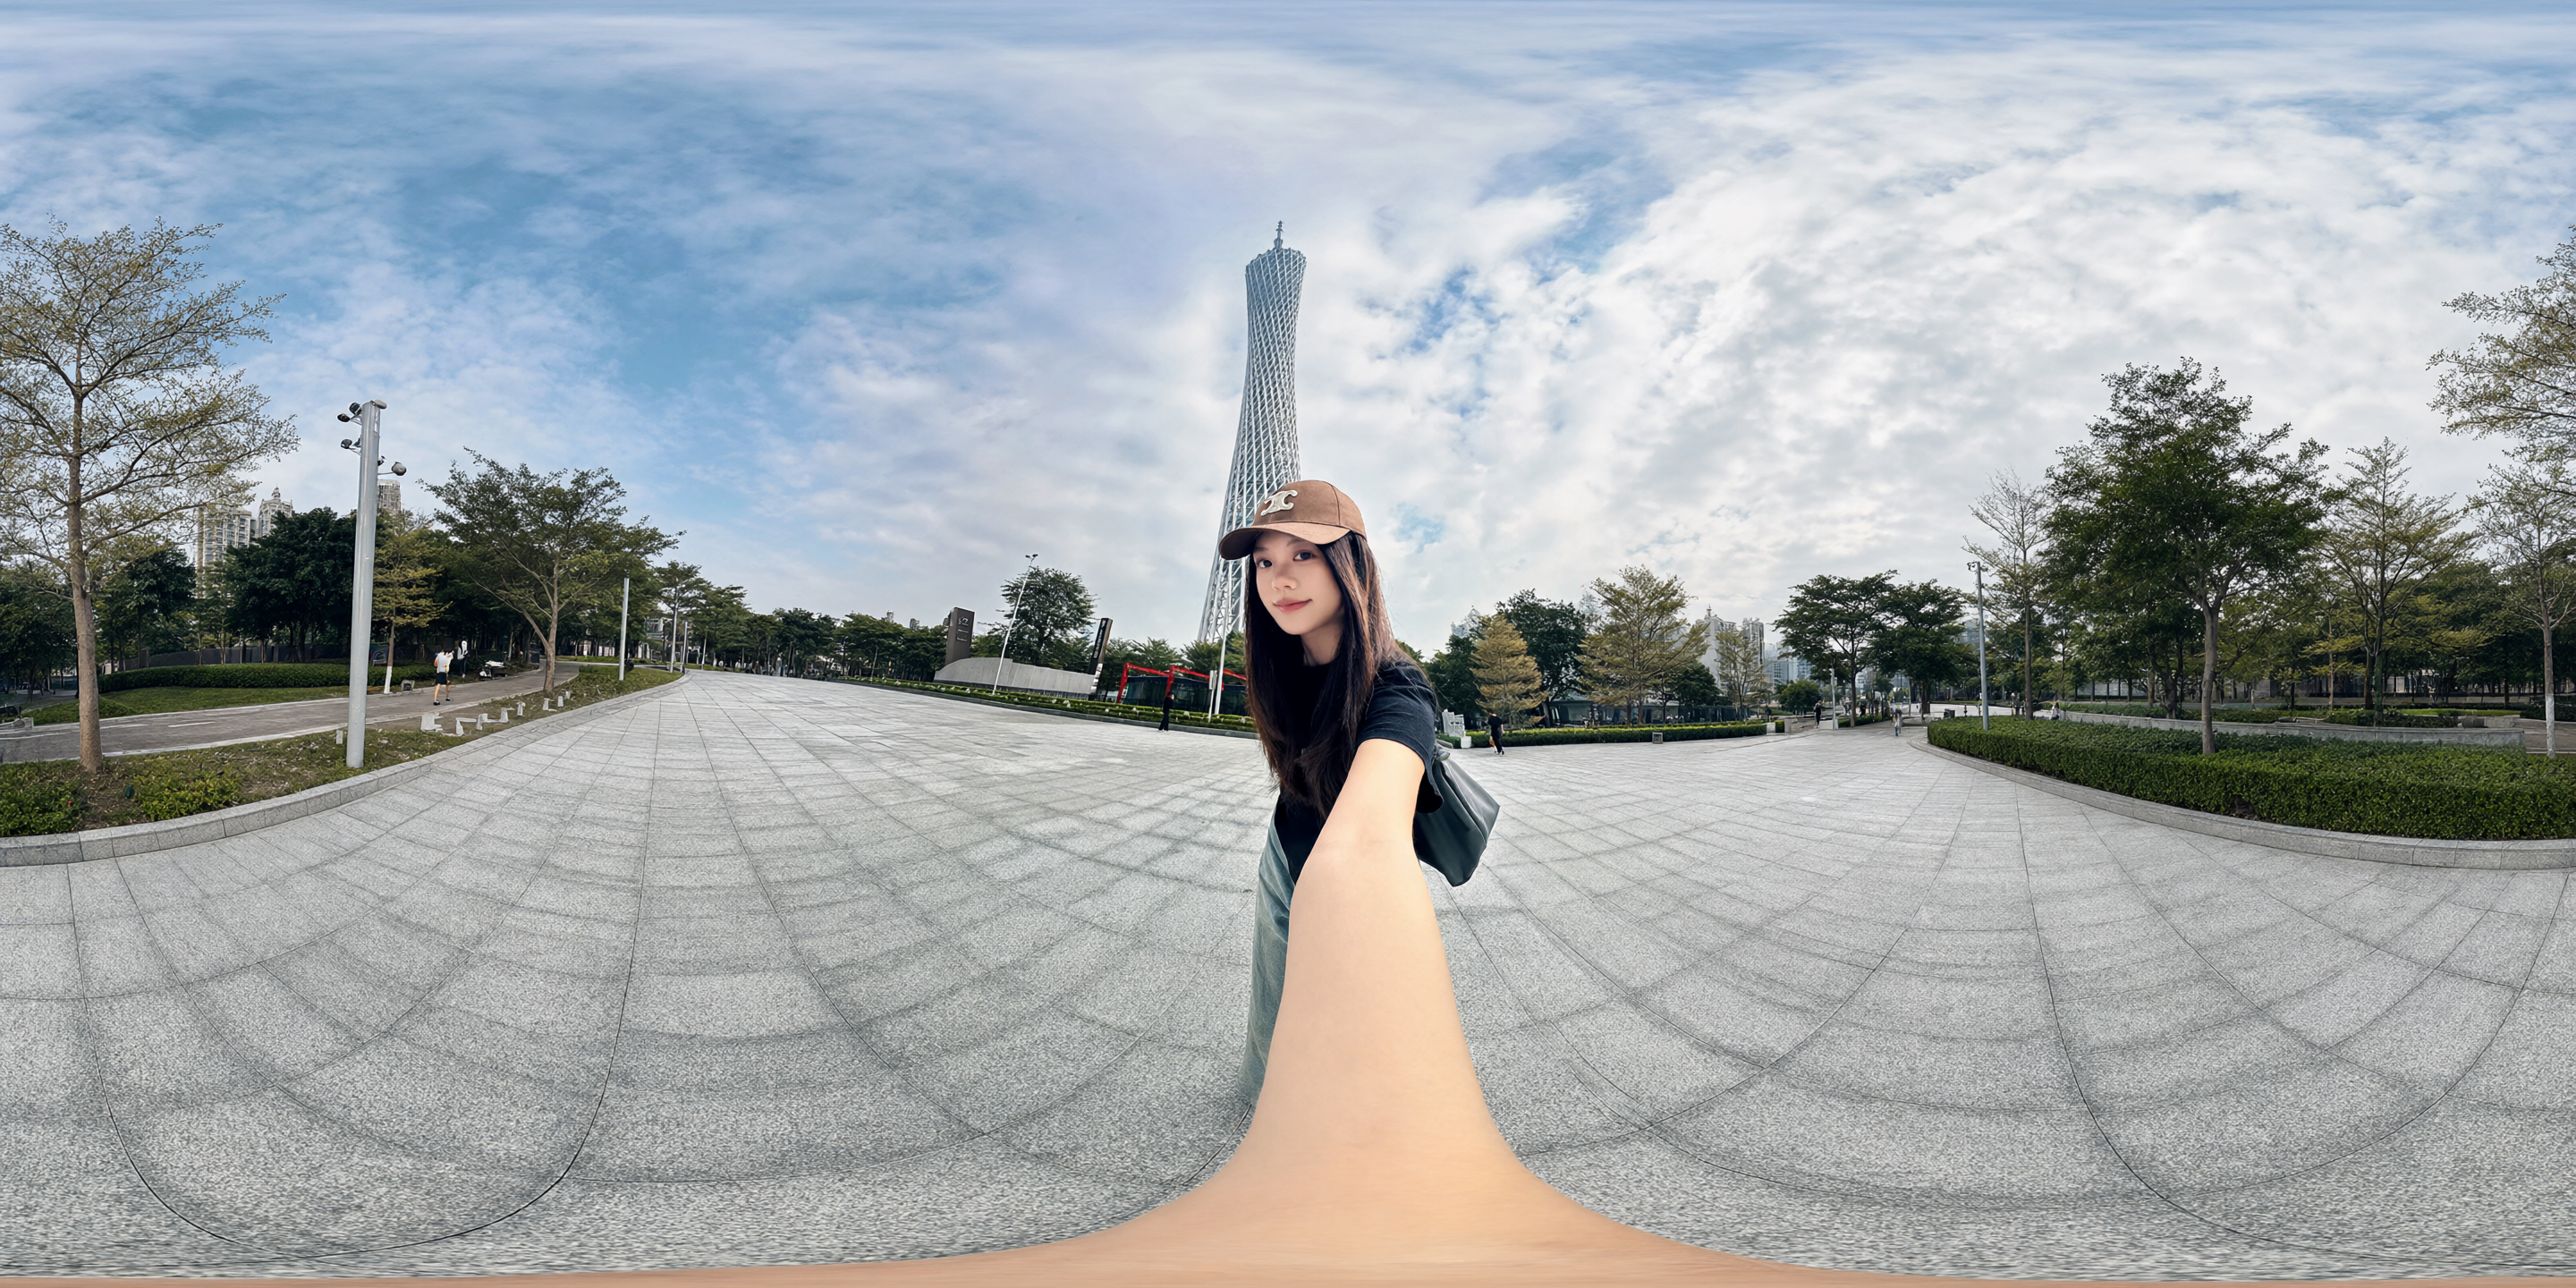
随后可以在可视化工具中从不同的视角方向浏览这张全景图。
00:00
/
00:00
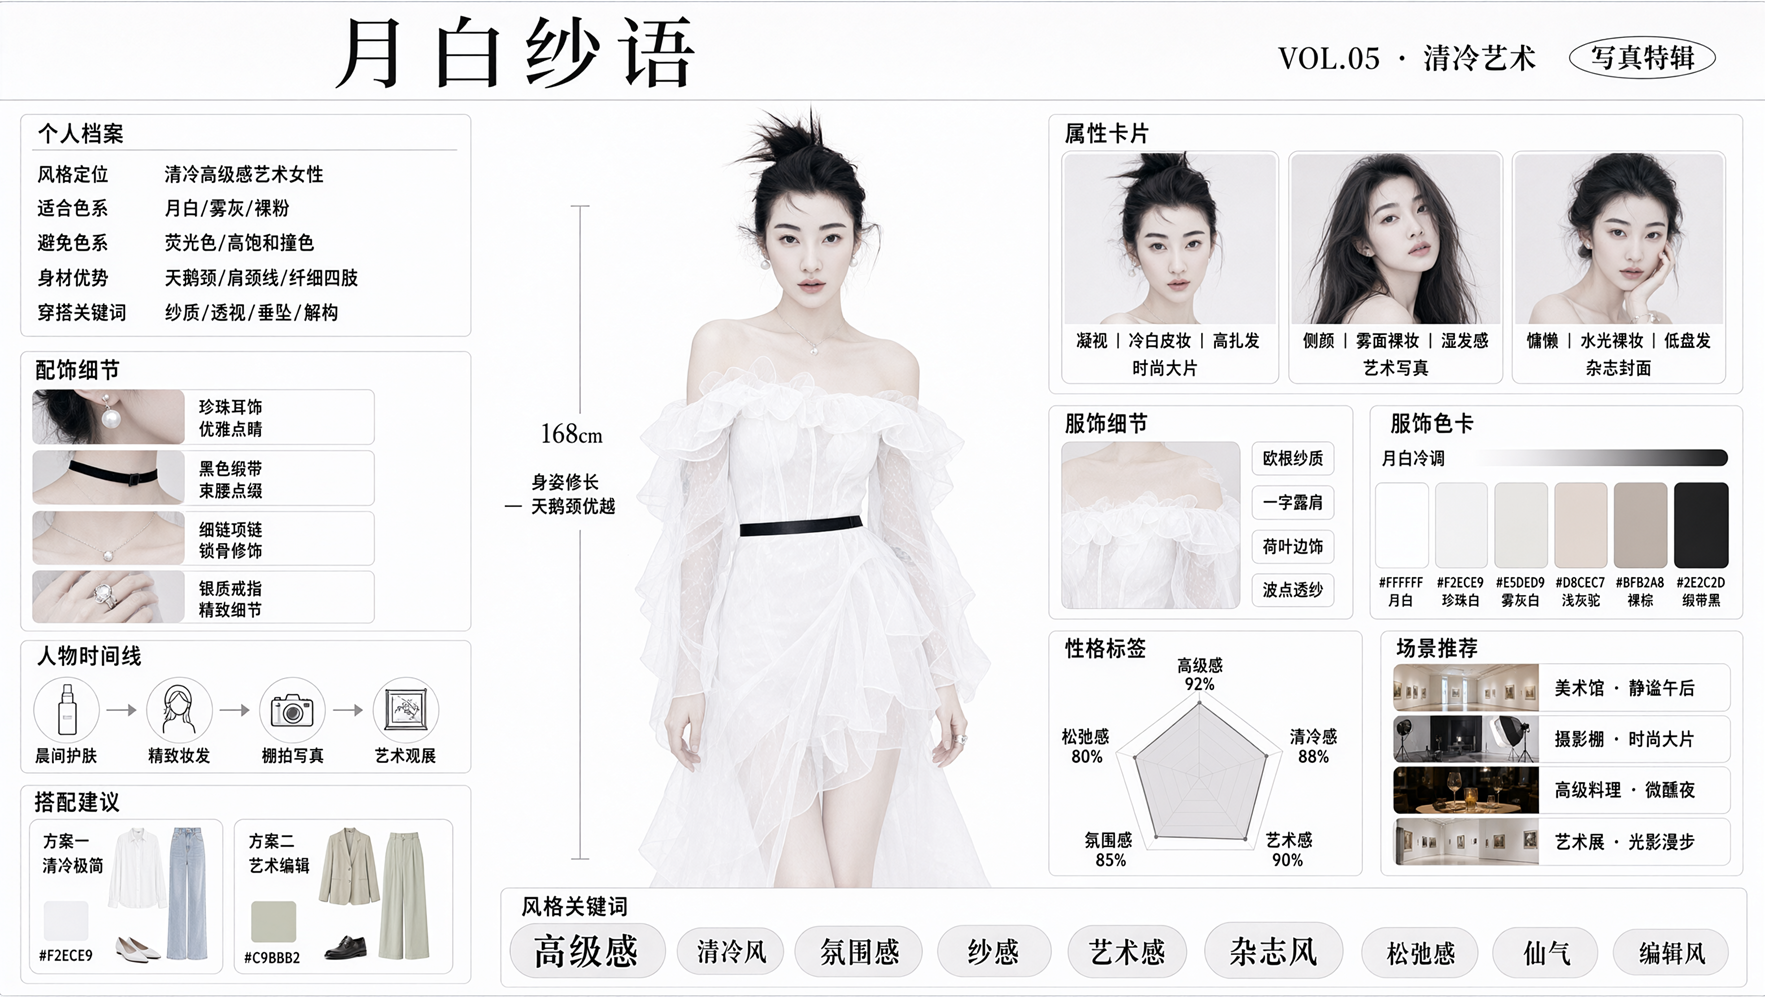
在信息图生成方面,一张模特照片可以被扩展成细节丰富、信息密集的画面。
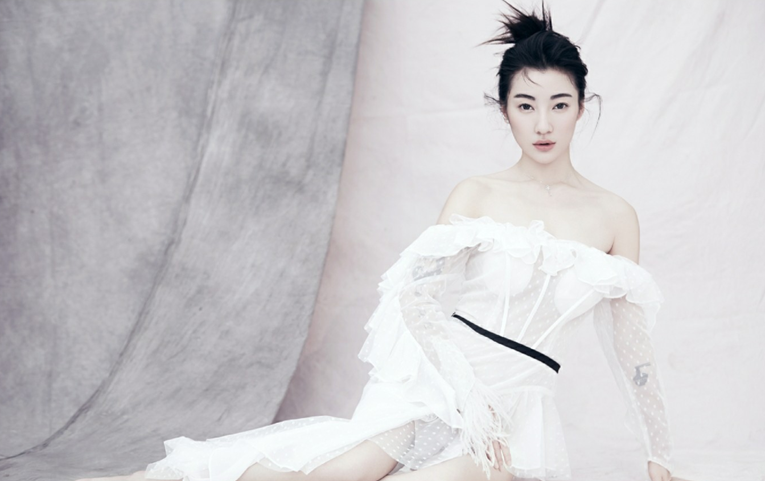
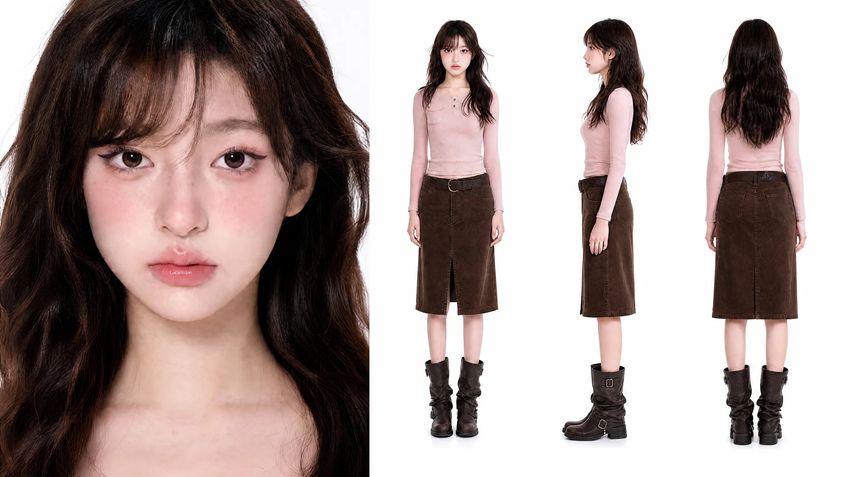
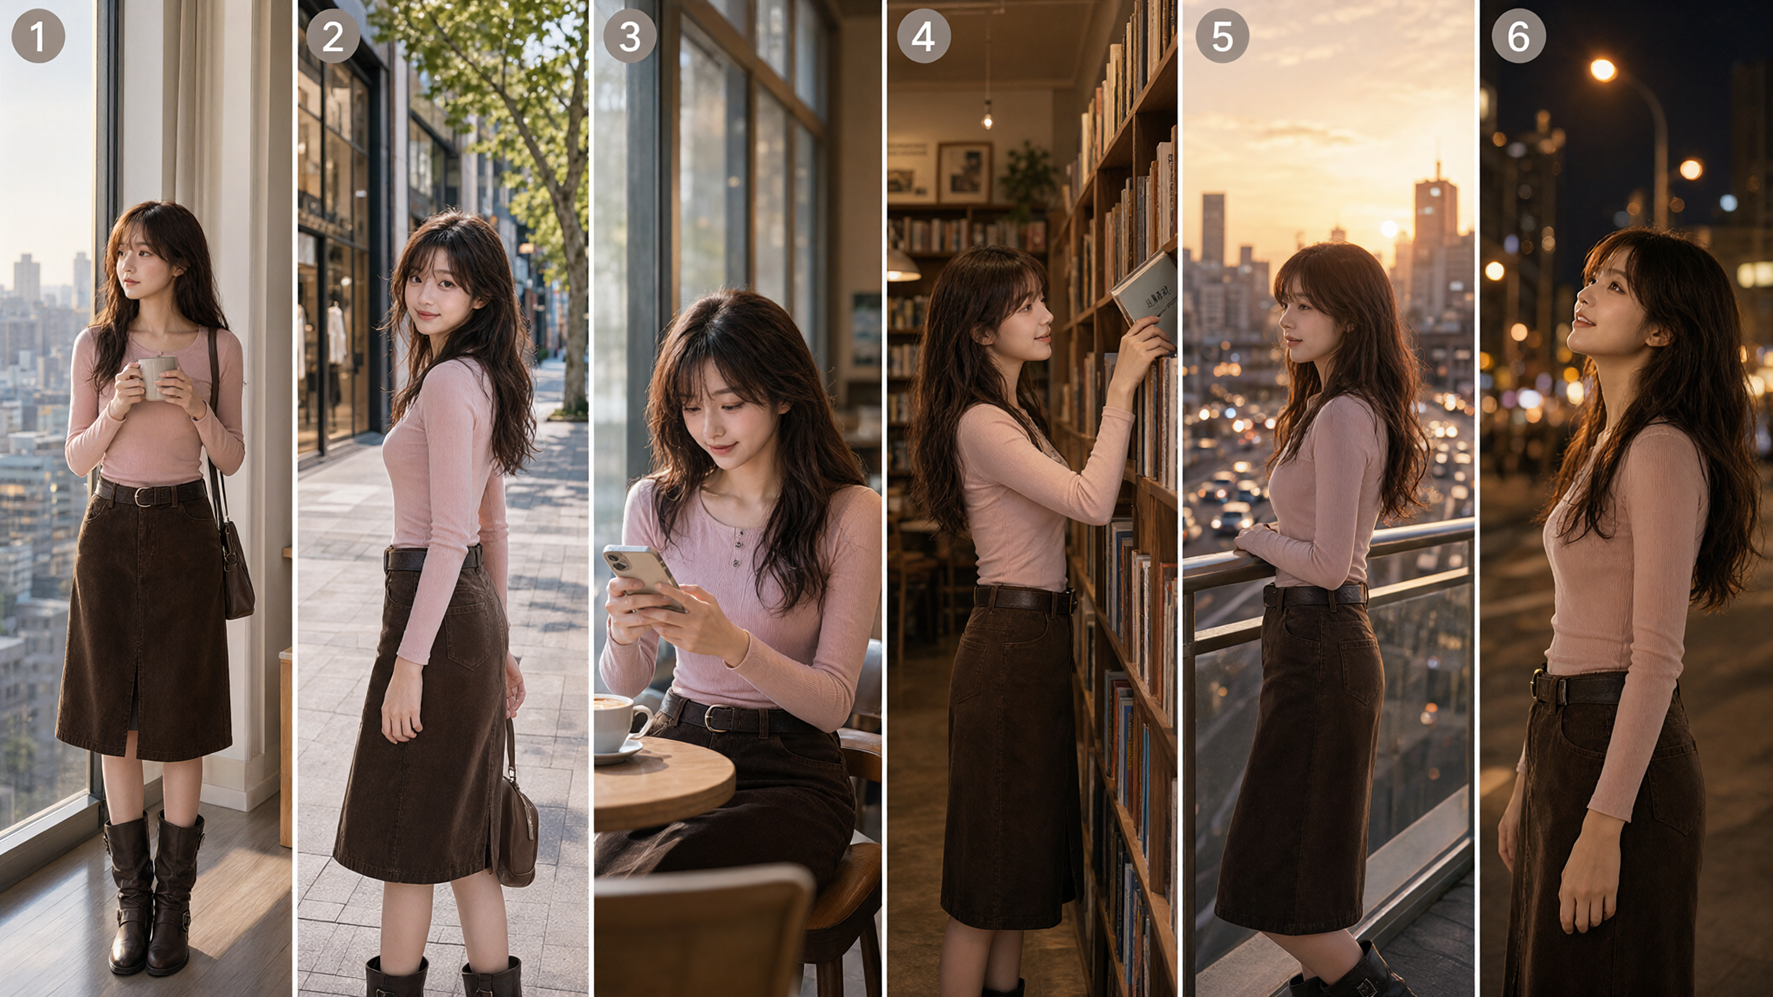
模型还能把角色三视图参考转化为完整的分镜,为讲故事和视觉叙事提供素材。
真实质感与精致美学
Qwen-Image-2.1 进一步提升了视觉质量,尤其注重排版和人像。文字渲染不仅考虑内容本身,还兼顾字体样式、版式及其与整体构图的关系。以下示例展示了不同场景下的文字渲染效果。
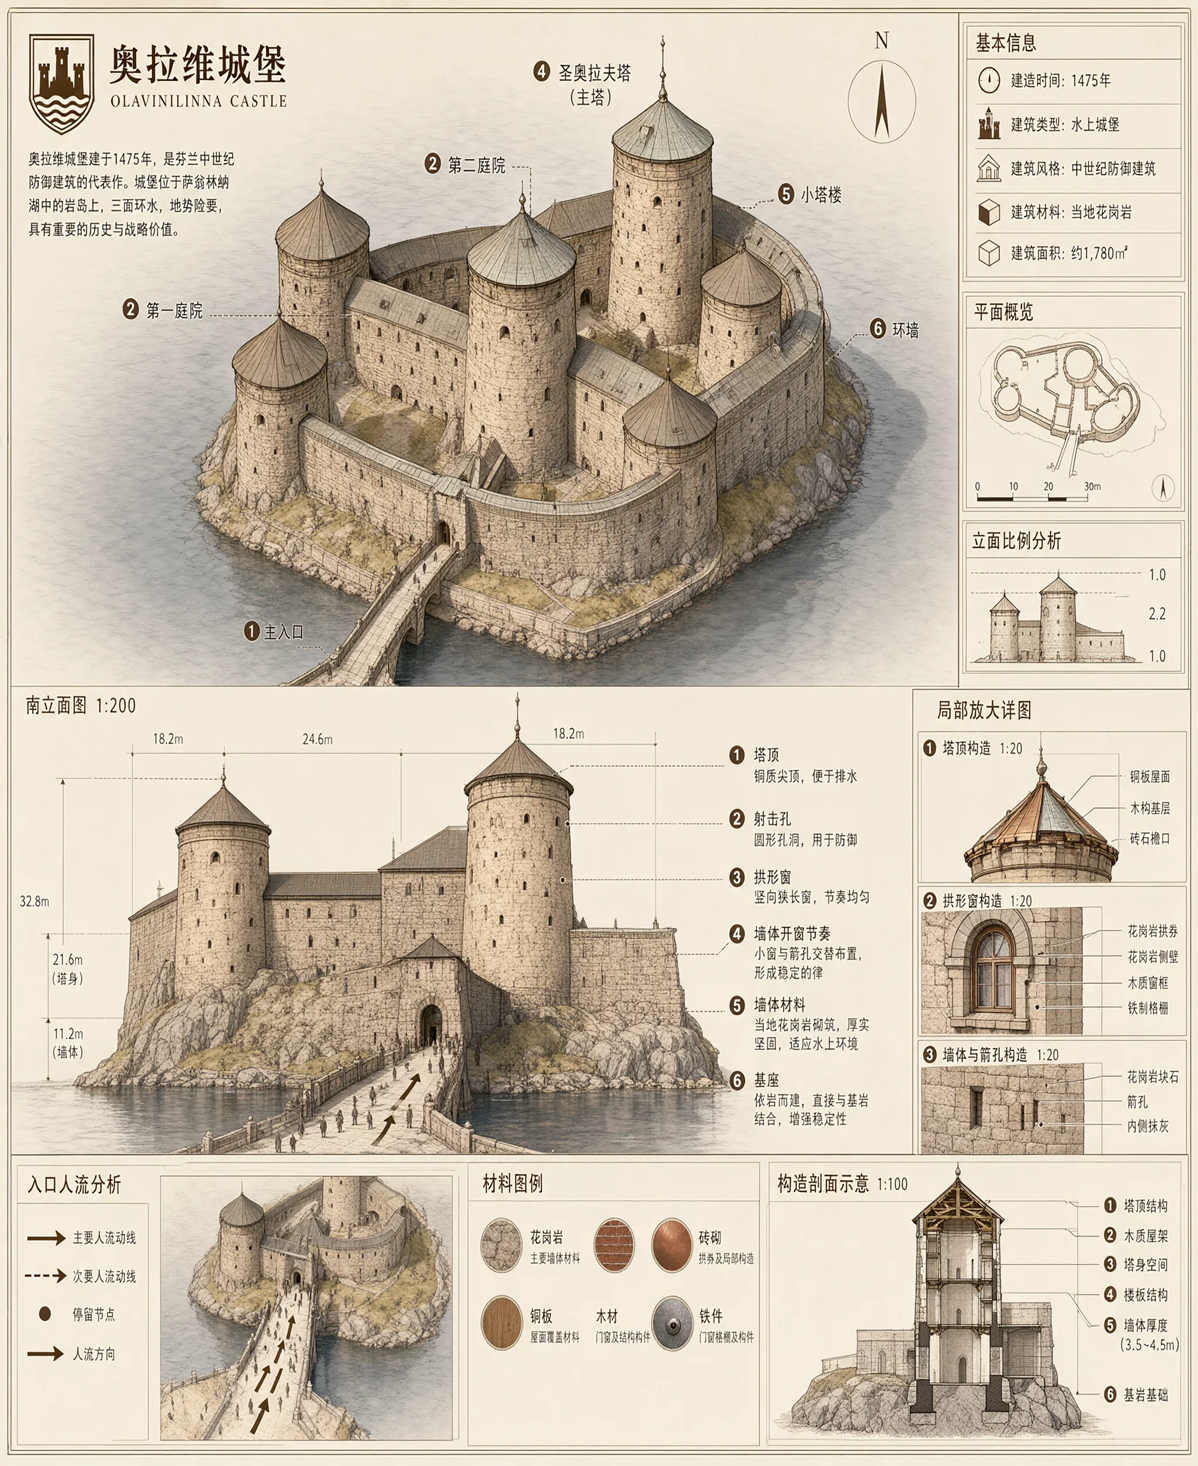
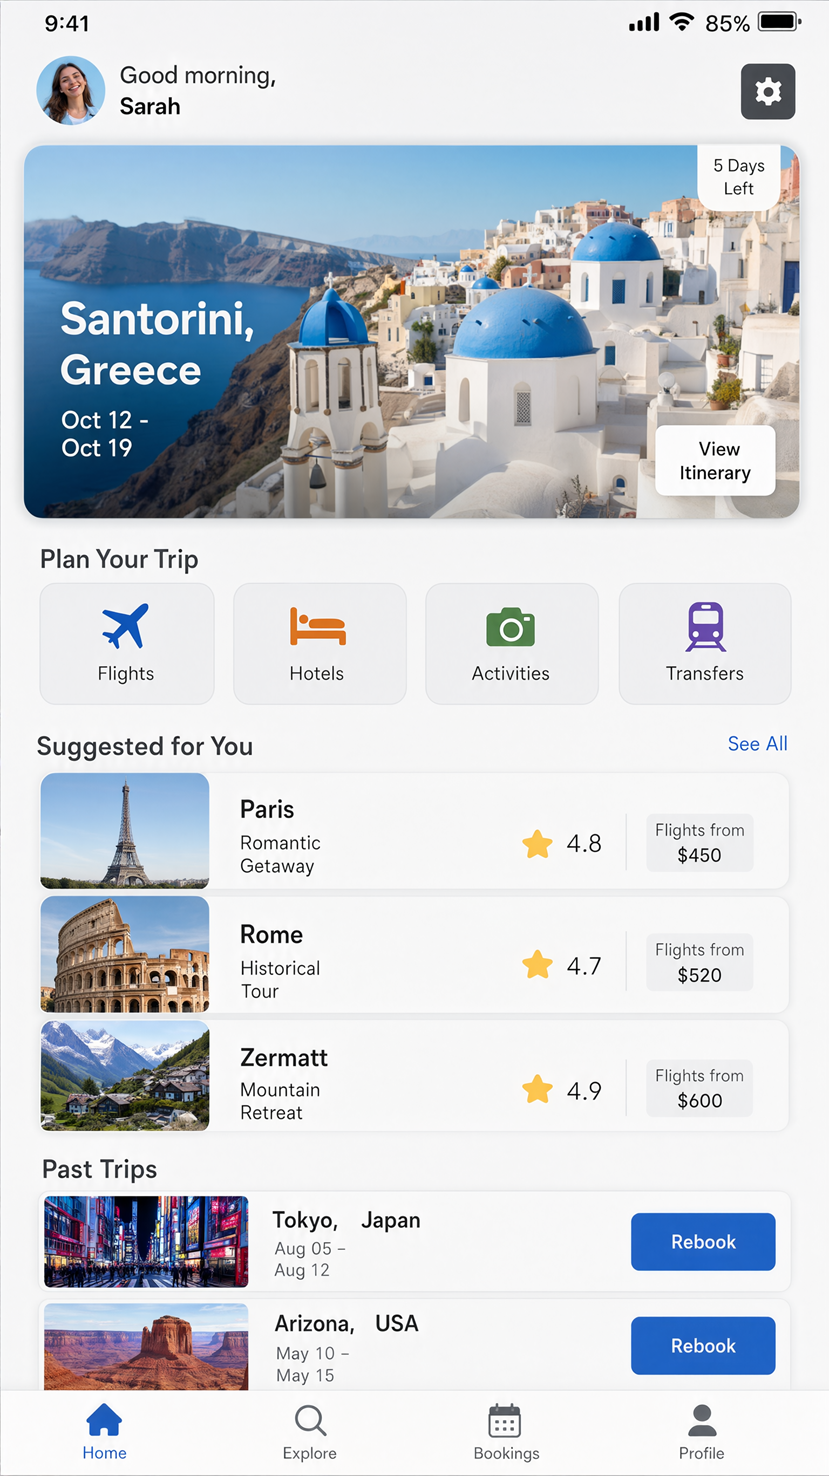
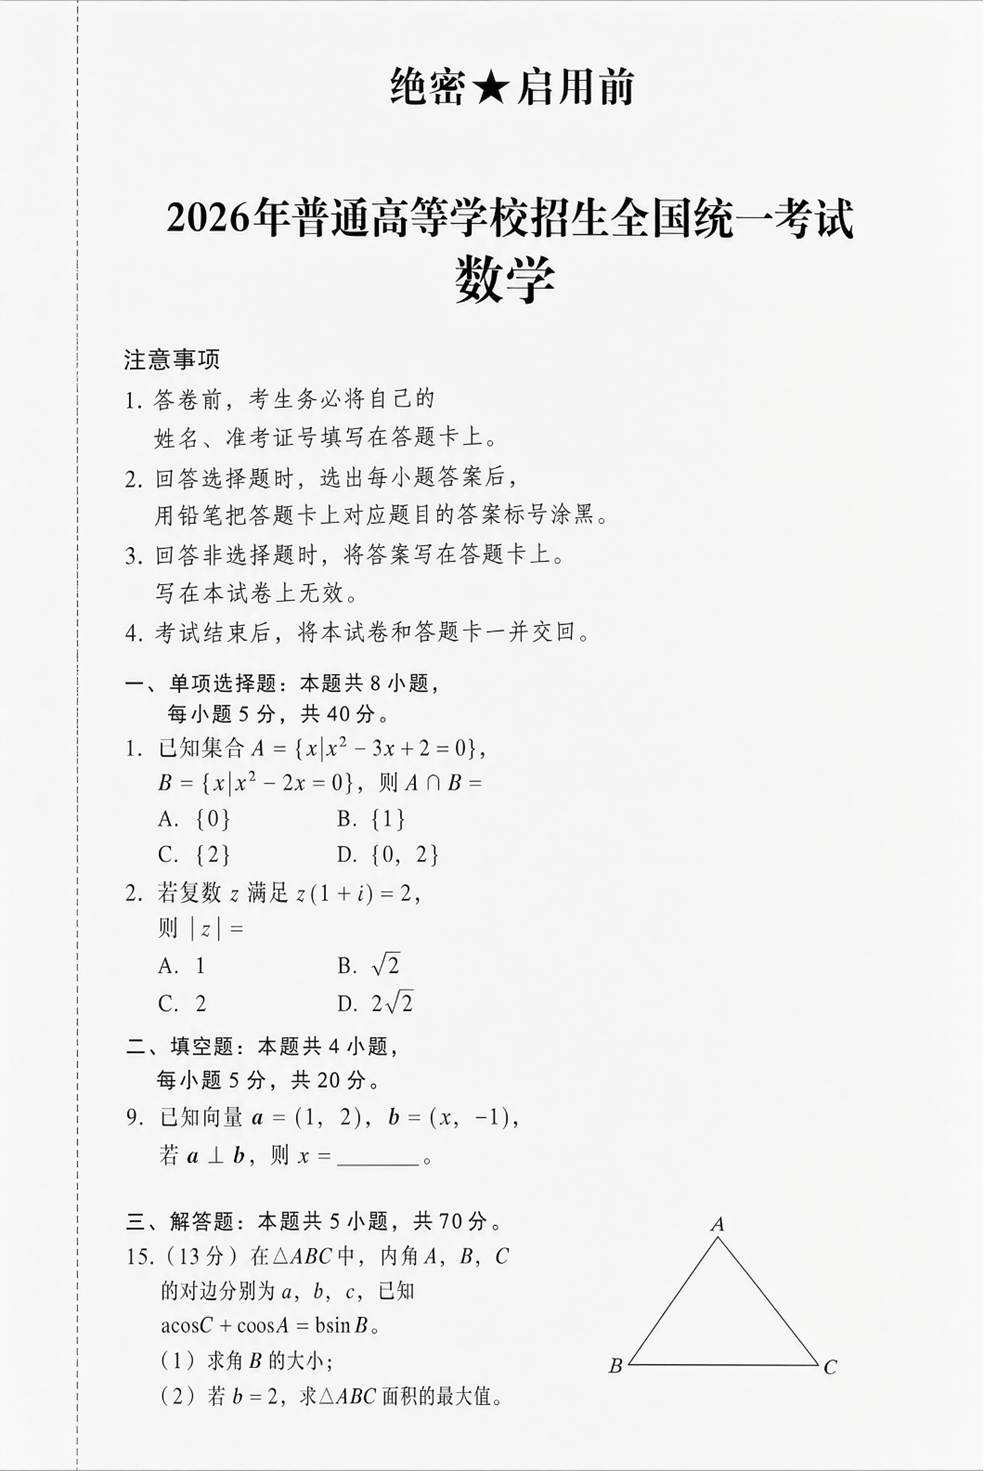
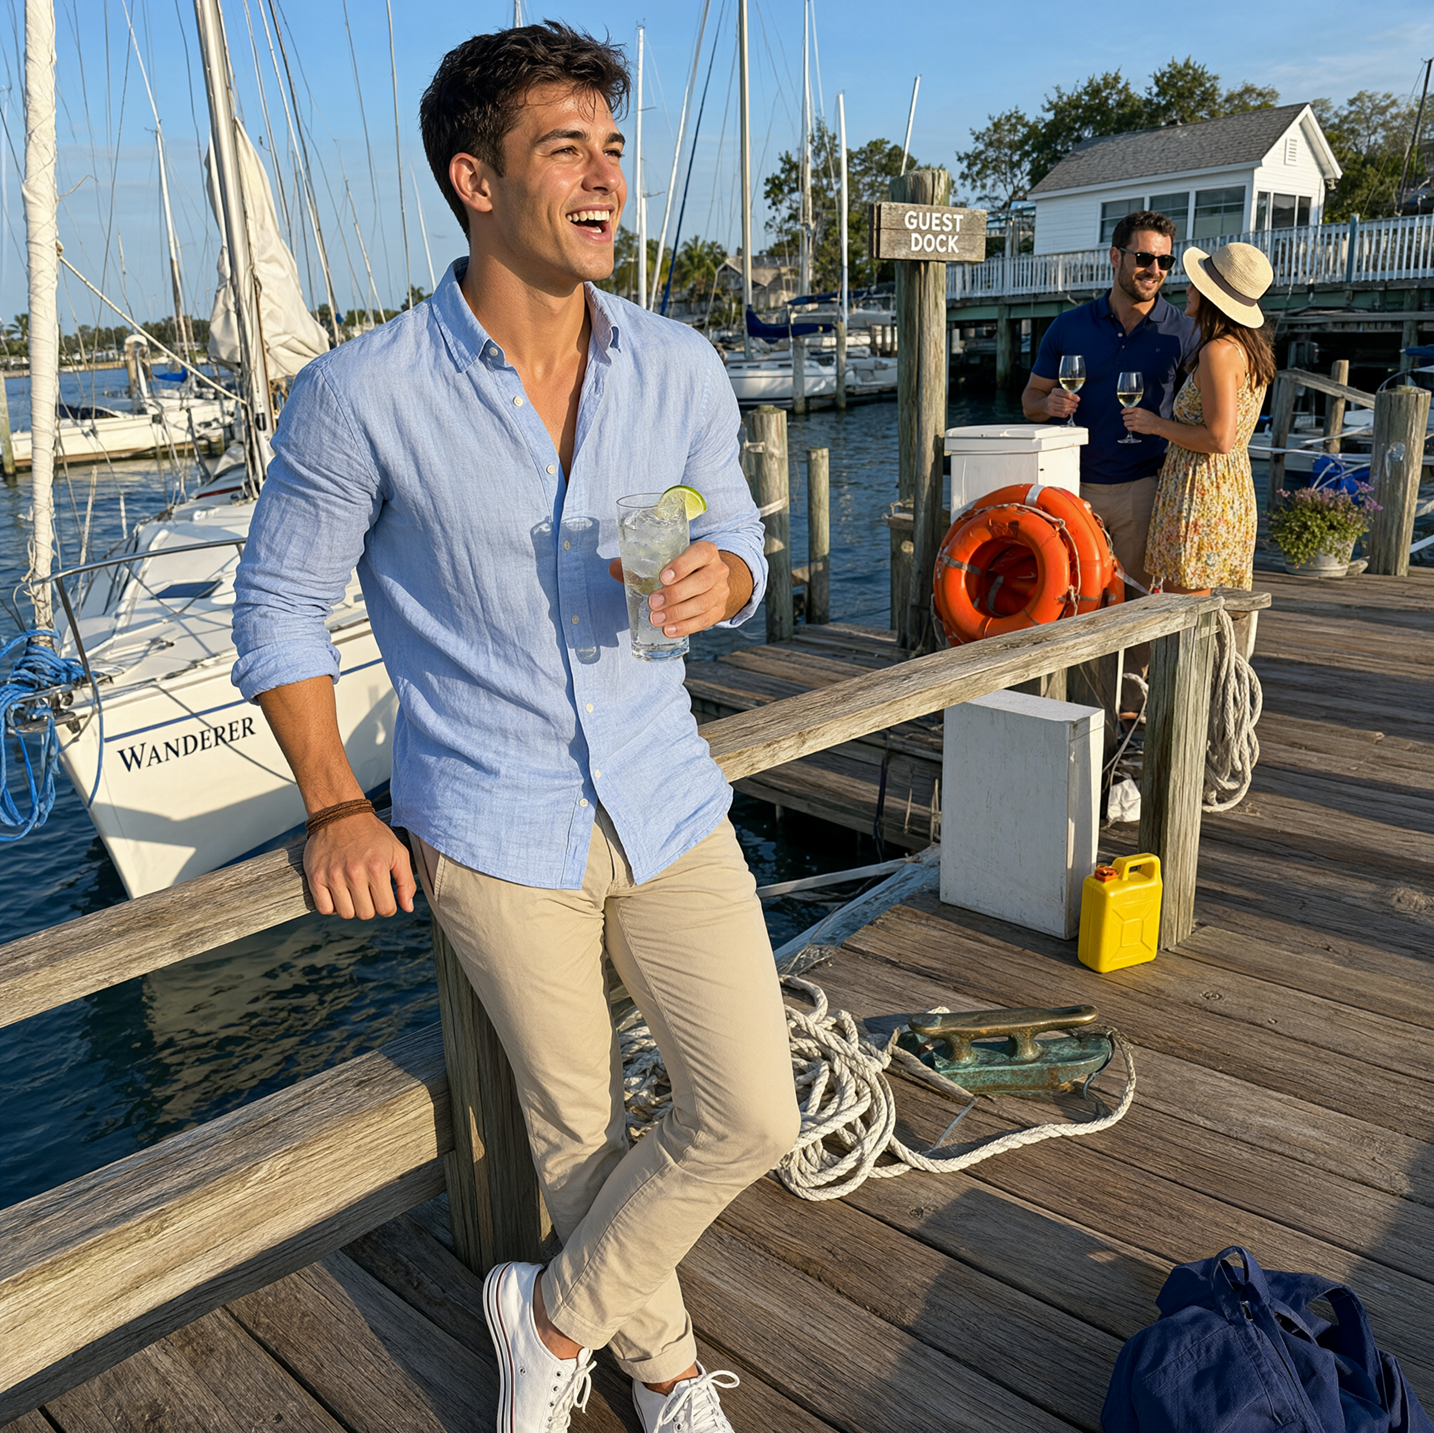
在人像方面,光影和细节的改进让生成的图像看起来更加真实。
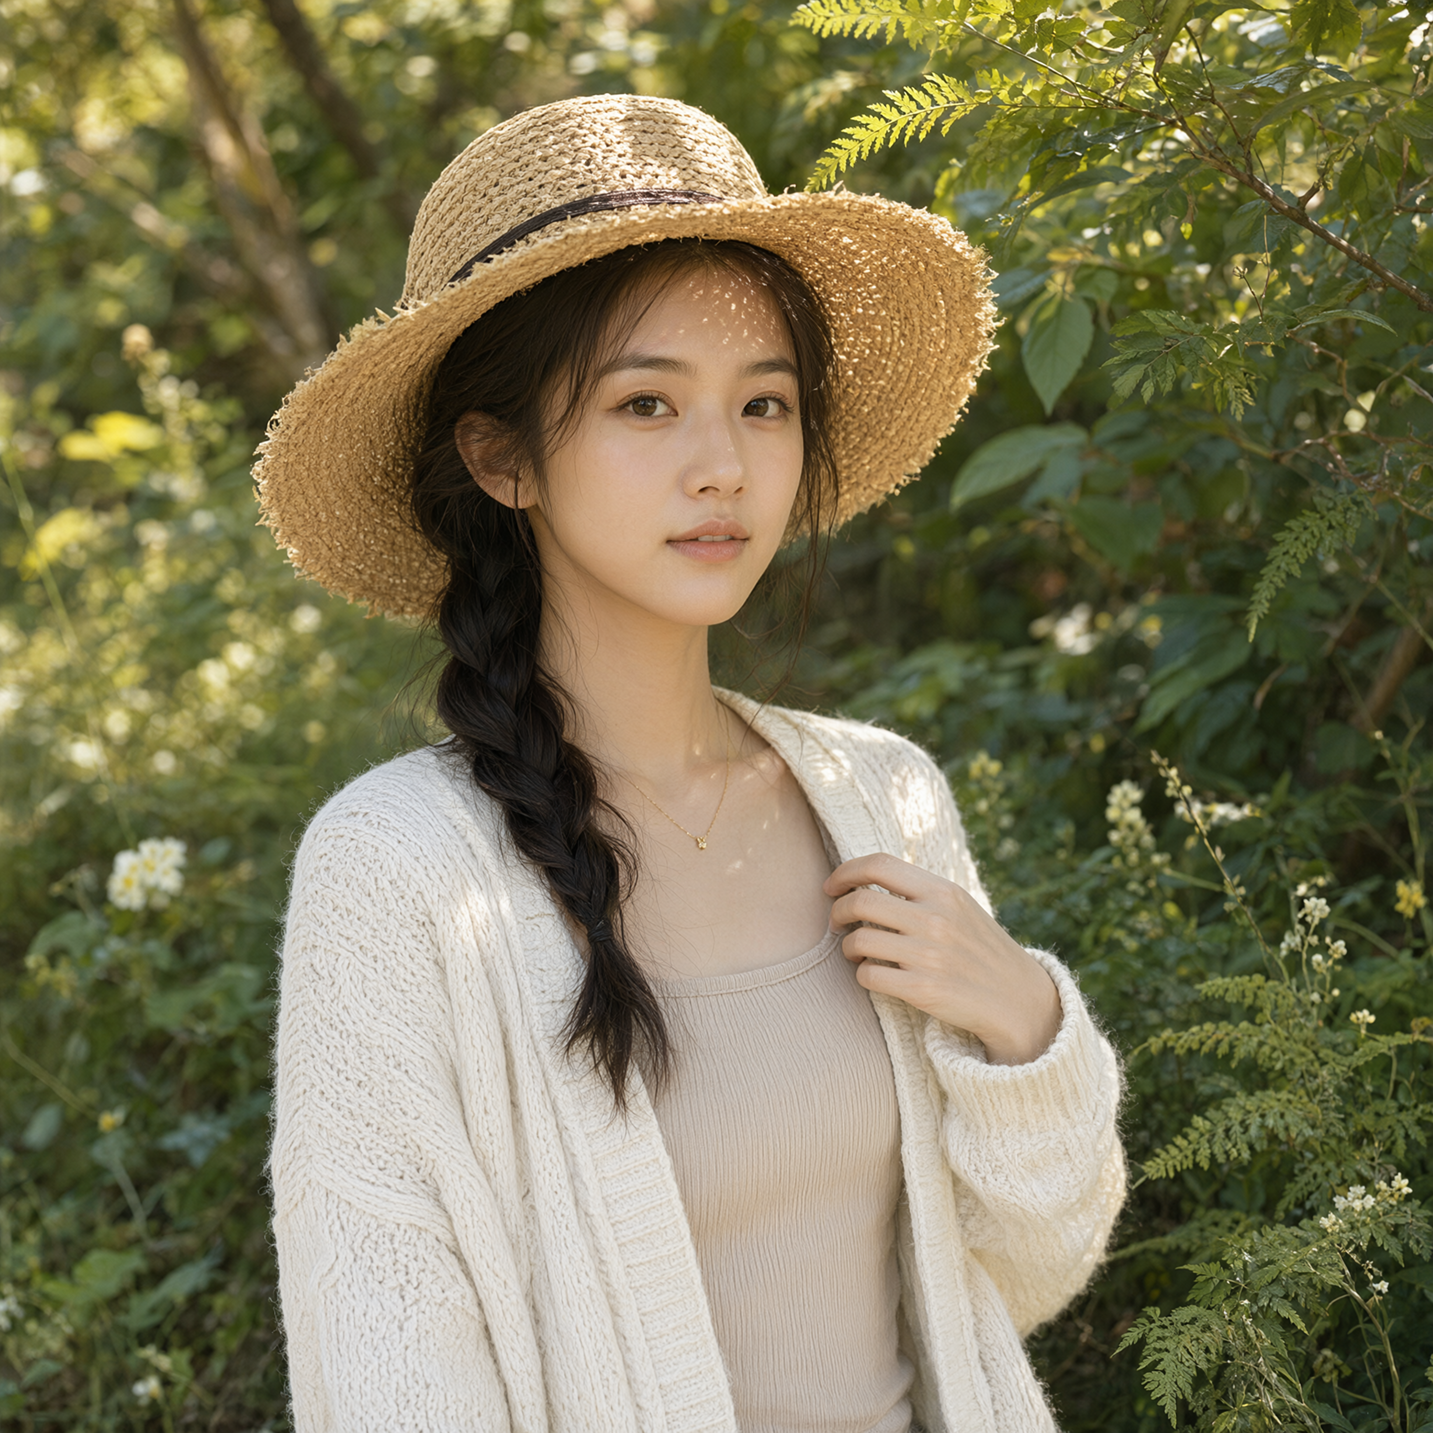
结语
凭借小巧的 7B 视觉生成组件,Qwen-Image-2.1 将图像生成、透明图像和丰富的编辑能力整合在同一个模型中。更快的推理、最多 10 张参考图的支持、灵活的局部编辑,以及对人物和产品保真度的提升,使它成为设计、内容创作、电商和视觉叙事的实用工具。
希望你能用 Qwen-Image-2.1 玩得开心!