摘要
我们提出了 Parcae,这是首批稳定的循环语言模型架构之一,训练过程干净、可预测,却能达到两倍规模 Transformer 的质量。Parcae 开辟了一条提升质量的新途径:靠增加循环次数,而不是单纯扩大数据规模,为训练受内存限制的端侧模型打开了一条高效的前沿路径。
把每个参数的价值榨干
传统的缩放定律告诉我们,想要获得最佳性能,就得扩大 FLOPs,通常的做法是增加参数或数据。但随着模型走向端侧、推理成本飙升,我们不禁想问:能否在不增大内存占用的前提下提升质量?
为此,我们一直在探索循环架构,即让激活值多次经过同一批层,从而增加计算量的模型。这类模型前景可期,但训练一直不稳定。我们直面这个问题,提出了 Parcae,一种稳定的循环架构,它:
- 优于此前的循环模型:与之前的大规模循环方案相比,Parcae 的验证集困惑度最多可降低 6.3%。
- 以小搏大:我们的 770M Parcae 与在相同数据上训练的 1.3B 参数 Transformer 质量相当,用大约一半的参数达到了同样的性能。
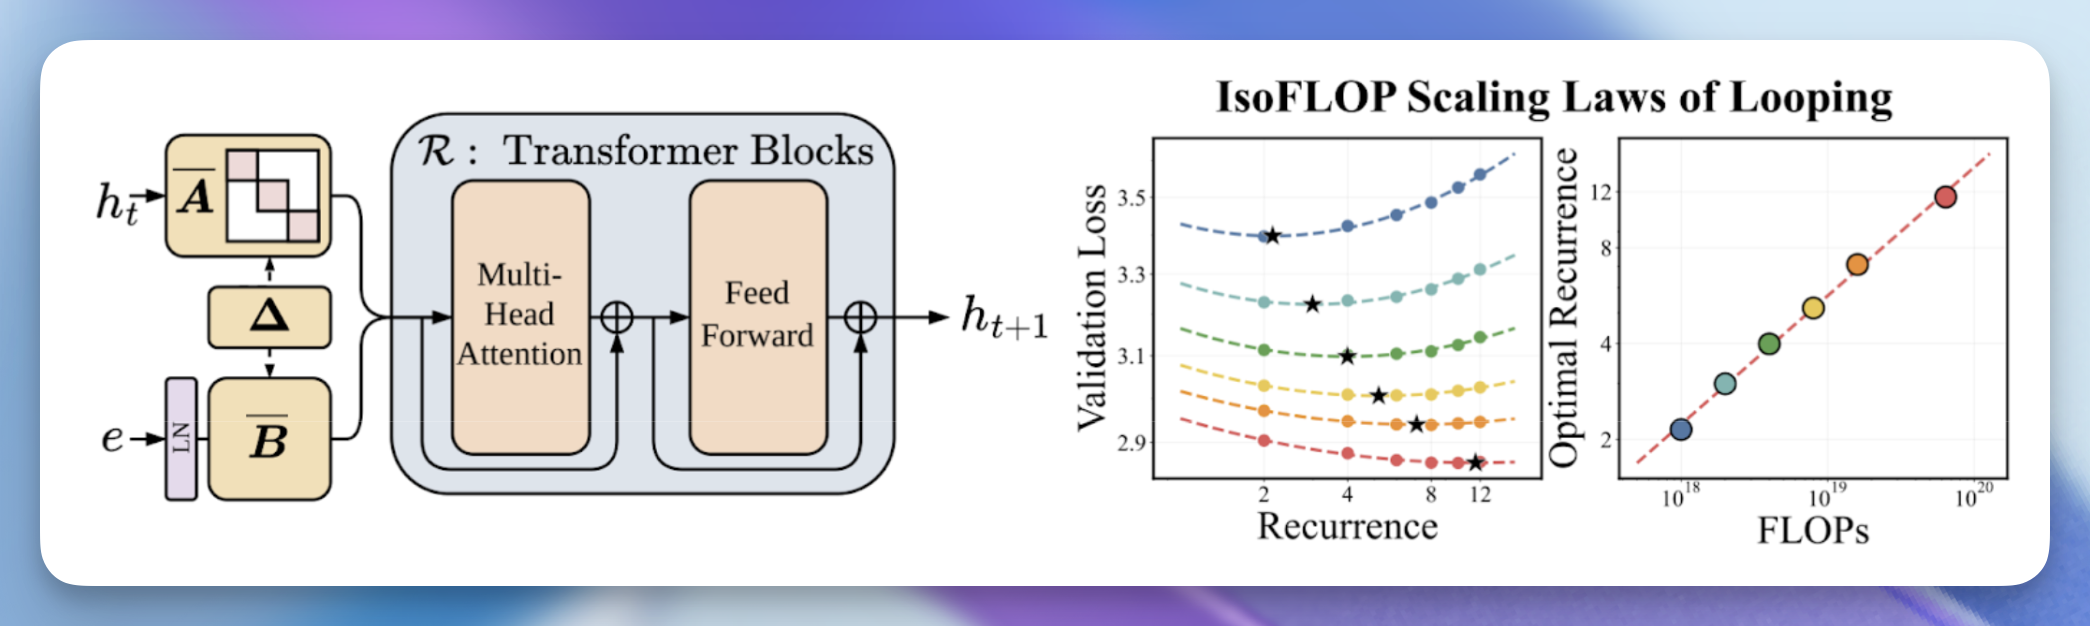
- 可预测地扩展:我们建立了首个针对循环的缩放定律,发现计算最优的训练需要同步增加循环次数和数据量。
循环模型很酷,但实际训练很难
随着模型走向端侧,推理部署占据了越来越多的算力,人们越来越关注如何在不增加参数的情况下提升模型质量。我们一直很看好的一种机制是层循环(layer looping),早期工作已经训练出了质量可与更大的固定深度架构相当的循环模型。
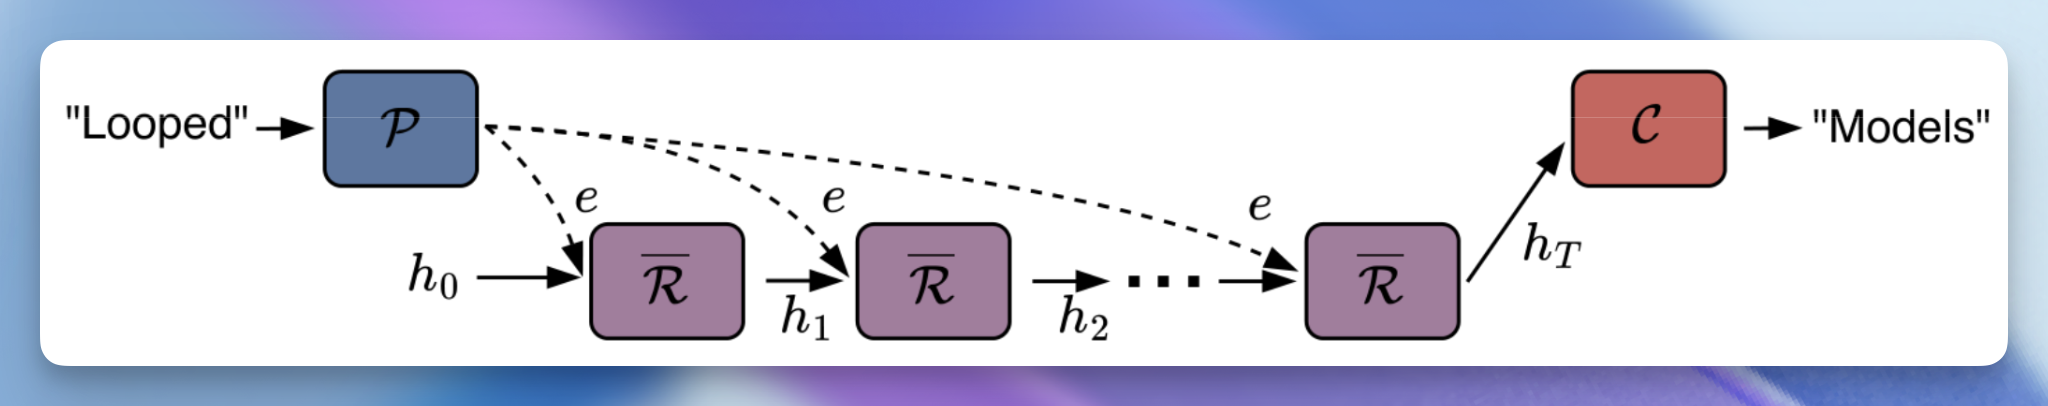
要把普通的 Transformer 变成循环模型,我们沿用已有工作的做法,把它的层划分为三个功能块:前奏块(prelude,$\mathcal{P}$)、循环块(recurrent,$\mathcal{R}$)和尾声块(coda, $\mathcal{C}$)。前向传播分三个阶段:
- 嵌入:前奏块将输入转换为潜在状态 $e$。
- 循环:循环块对隐藏状态 $h_t$ 迭代更新 $T$ 次。为了保持输入的影响,每次循环都会注入 $e$,通常采用加法 <a id="cite-1" href="#ref-1">[1]</a>($h_{t+1} = \mathcal{R}(h_t + e)$),或者拼接后再做投影 <a id="cite-2" href="#ref-2">[2]</a>($h_{t+1} = \mathcal{R}(W[h_t; e])$)。
- 输出:尾声块处理最终的 $h_T$,生成模型的输出。
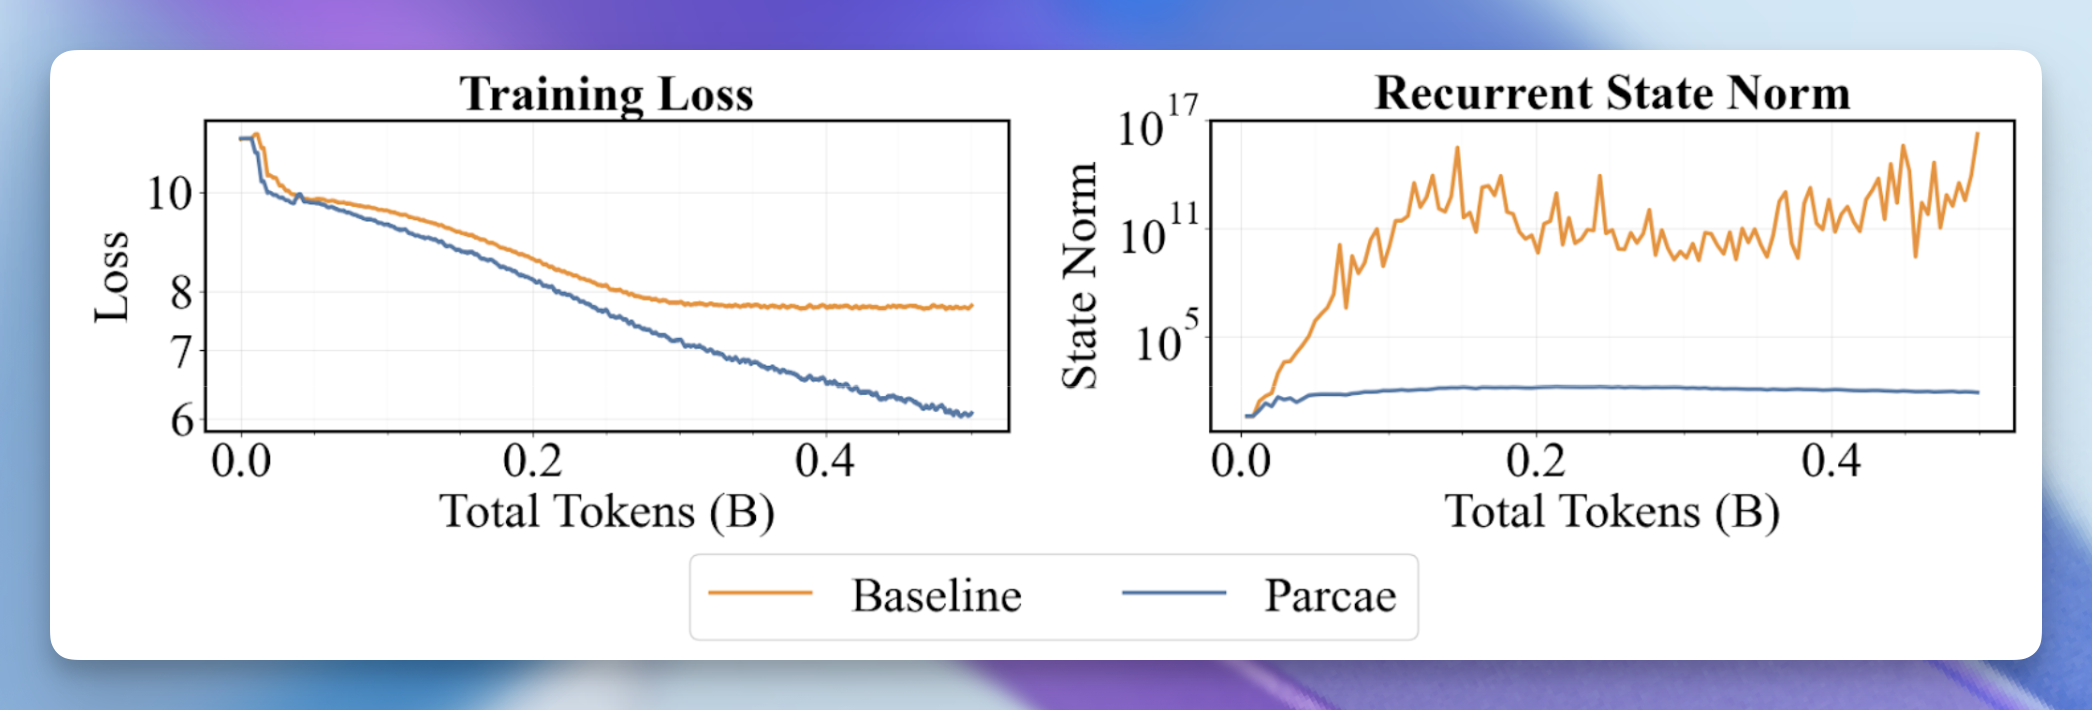
遗憾的是,循环模型训练起来让人头疼 <a id="cite-2b" href="#ref-2">[2]</a><a id="cite-3" href="#ref-3">[3]</a><a id="cite-4" href="#ref-4">[4]</a>。我们亲身发现它们会出现残差状态爆炸和损失尖峰。更棘手的是,循环块由多个普通的 Transformer 块组成,很难判断不稳定性究竟来自哪里。
理解循环的不稳定性
不稳定性是个变幻莫测的对手,但我们发现,一个简单的线性框架就能捕捉到其中一个重要来源。具体来说,我们把循环重新表述为作用在残差上的非线性时变动力系统,其更新规则为:
其中 $\overline{A}, \overline{B}$ 负责注入,$\overline{\mathcal{R}}$ 是 Transformer 块对残差流的贡献。对于热衷次二次序列混合的朋友,请注意:如果忽略非线性项 $\overline{\mathcal{R}}$,得到的系统就是沿模型深度、作用在残差状态上的离散线性时不变(LTI)动力系统。
有意思的是,对于离散 LTI 系统,其稳定性和收敛性由 $\overline{A}$ 的特征值决定。具体而言,稳定性用谱范数 $\rho(\overline{A})$(即 $\overline{A}$ 绝对值最大的特征值)来划分:稳定(收敛)的系统满足 $\rho(\overline{A})<1$,不稳定(发散)的系统满足 $\rho(\overline{A})=1$。
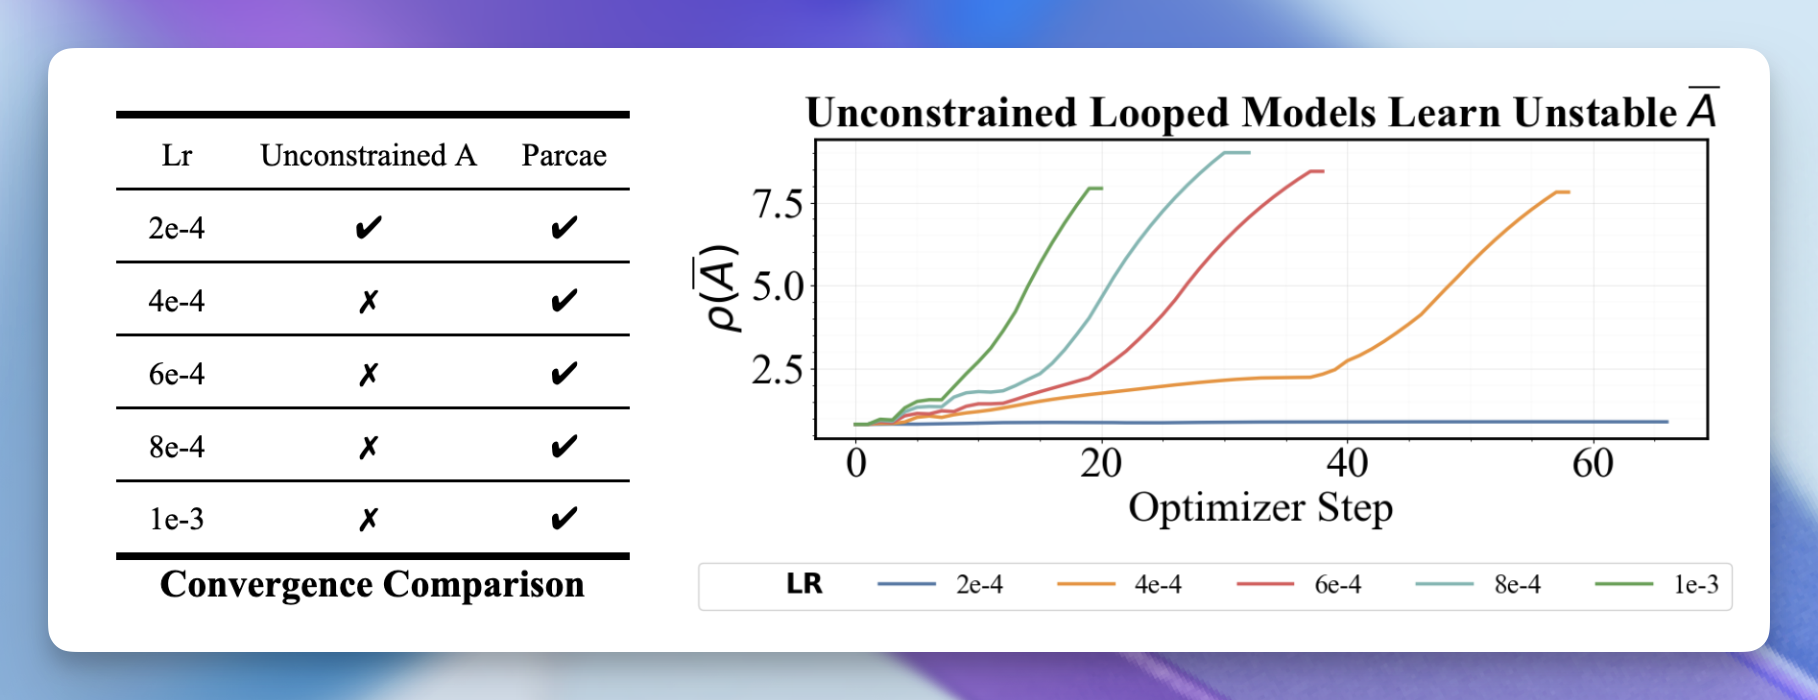
虽然这一分析绕过了循环中的非线性部分(例如 Attention 和 MLP 单元),但上面的表格和图表证实,我们的分析在经验上很重要:发散的运行所学到的谱半径满足 $\rho(\overline{A}) \geq 1$,而收敛的运行则保持 $\rho(\overline{A}) < 1$。当我们用 Parcae 维持 LTI 条件时,循环模型对超参数选择的鲁棒性显著提高。
Parcae:稳定、省心的循环模型
那么,该如何稳定它呢?我们设计了一种新的循环模型 Parcae,它在构造上就显式地维持了上一节观察到的稳定性条件。具体来说,我们用连续形式的 $A, B$ 来参数化输入注入参数,再用 ZOH 和欧拉格式对其离散化(即 $\overline{A} = \exp(\Delta A)$,$\overline{B} = \Delta B$),其中 $\Delta \in \mathbb{R}^{d_h}$ 是可学习的。随后我们把 $A := \texttt{Diag}(-\exp(\texttt{log}_A))$ 约束为负对角矩阵,其中对向量取 $\texttt{Diag}(-\exp(\cdot))$ 可保证其为负,$\texttt{log}_A\in \mathbb{R}^{d_h}$ 是我们的可学习向量。这就保证了 $\rho(\overline{A}) < 1$!
那么,我们是否已经解决了所有问题、让循环模型稳定下来了呢?遗憾的是,要让 Parcae 干净地训练,还需要其他几个小技巧。感兴趣的读者可以查看我们的 [paper](link)。
回到语言建模:扩大 Parcae 的规模
Parcae 不仅训练更可靠,我们还发现,与此前的 RDM 相比,它产出的模型质量更高。我们采用 RDM <a id="cite-2c" href="#ref-2">[2]</a>(一种此前的循环模型)的完全相同的设置,与参数量和数据量都对齐的 RDM 进行对比,发现 Parcae 的验证集困惑度最多降低了 6.3%。
| 参数量 & 模型 | 验证集 PPL(↓) |
|---|---|
| 100M 规模 | |
| └ RDM | 14.23 |
| └ Parcae | 13.59 |
| 350M 规模 | |
| └ RDM | 10.76 |
| └ Parcae | 10.09 |
当把一个非常强的 Transformer 基线改造成 RDM 且不做任何超参数调优时,我们发现 Parcae 相比 RDM 表现稳健(RDM 则直接发散了)。
| 参数量 & 模型 | 验证集损失(↓) | Core(↑) | Core-Extended(↑) |
|---|---|---|---|
| RDM | 发散 | 发散 | 发散 |
| + Parcae 约束的 A | 2.97 | 13.2 ± 0.2 | 9.1 ± 0.5 |
| + 全部 Parcae 技巧 | 2.95 | 14.0 ± 0.2 | 9.7 ± 0.3 |
我们还把 Parcae 作为标准固定深度 Transformer 的直接替代品。借鉴 nanochat 的设置,我们在 FineWeb-Edu 上训练了一系列语言模型,规模最高到 1.3B 参数。我们发现,Parcae 优于所有参数量和数据量对齐的 Transformer,其中 770M 的 Parcae 模型在下游质量上几乎追平了两倍于它的 Transformer!
| 参数量 & 模型 | 验证集 PPL(↓) | Core(↑) | Core-Extended(↑) |
|---|---|---|---|
| 140M 规模 | |||
| └ Transformer | 21.48 | 13.00 ± 0.15 | 8.80 ± 0.21 |
| └ Parcae | 19.06 | 14.04 ± 0.20 | 9.67 ± 0.28 |
| 370M 规模 | |||
| └ Transformer | 15.79 | 17.46 ± 0.03 | 11.71 ± 0.22 |
| └ Parcae | 14.49 | 20.00 ± 0.06 | 12.75 ± 0.31 |
| 770M 规模 | |||
| └ Transformer | 13.08 | 22.42 ± 0.20 | 14.20 ± 0.63 |
| └ Parcae | 12.49 | 25.07 ± 0.33 | 15.19 ± 0.43 |
| 1.3B 规模 | |||
| └ Transformer | 11.95 | 25.45 ± 0.08 | 15.90 ± 0.23 |
| └ Parcae | 11.42 | 28.44 ± 0.28 | 17.08 ± 0.09 |
循环,还是不循环
但循环在 FLOP 上真的高效吗?为了研究这个问题,我们设定了这样一个场景:在参数量和 FLOP 预算固定的情况下,用训练时的平均循环次数去换数据量(例如,增加平均循环次数的同时减少训练数据,以保持 FLOP 预算不变)。
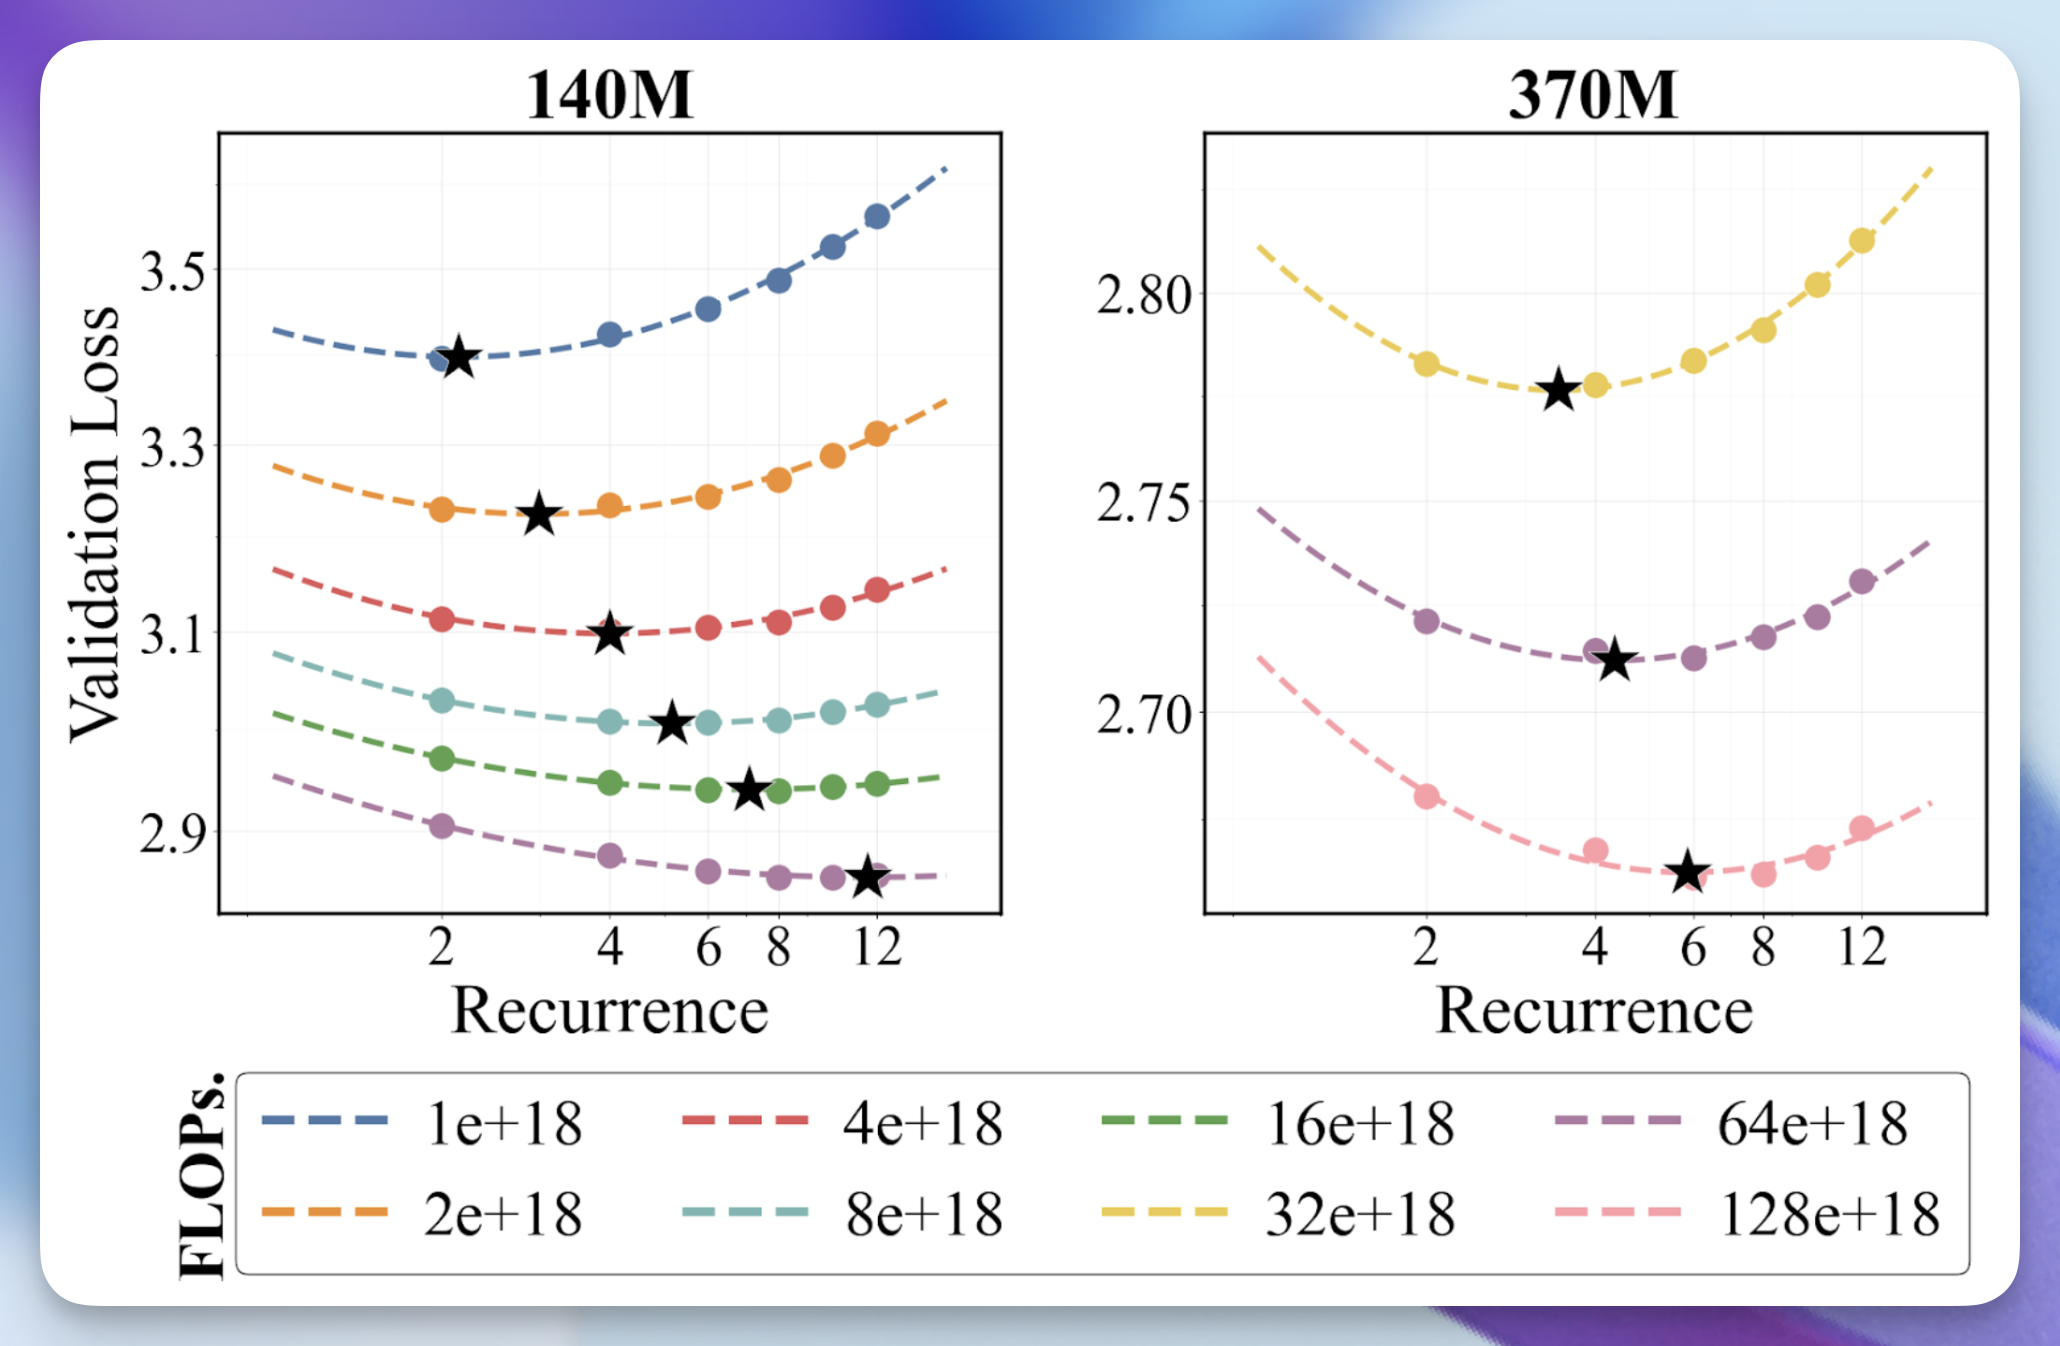
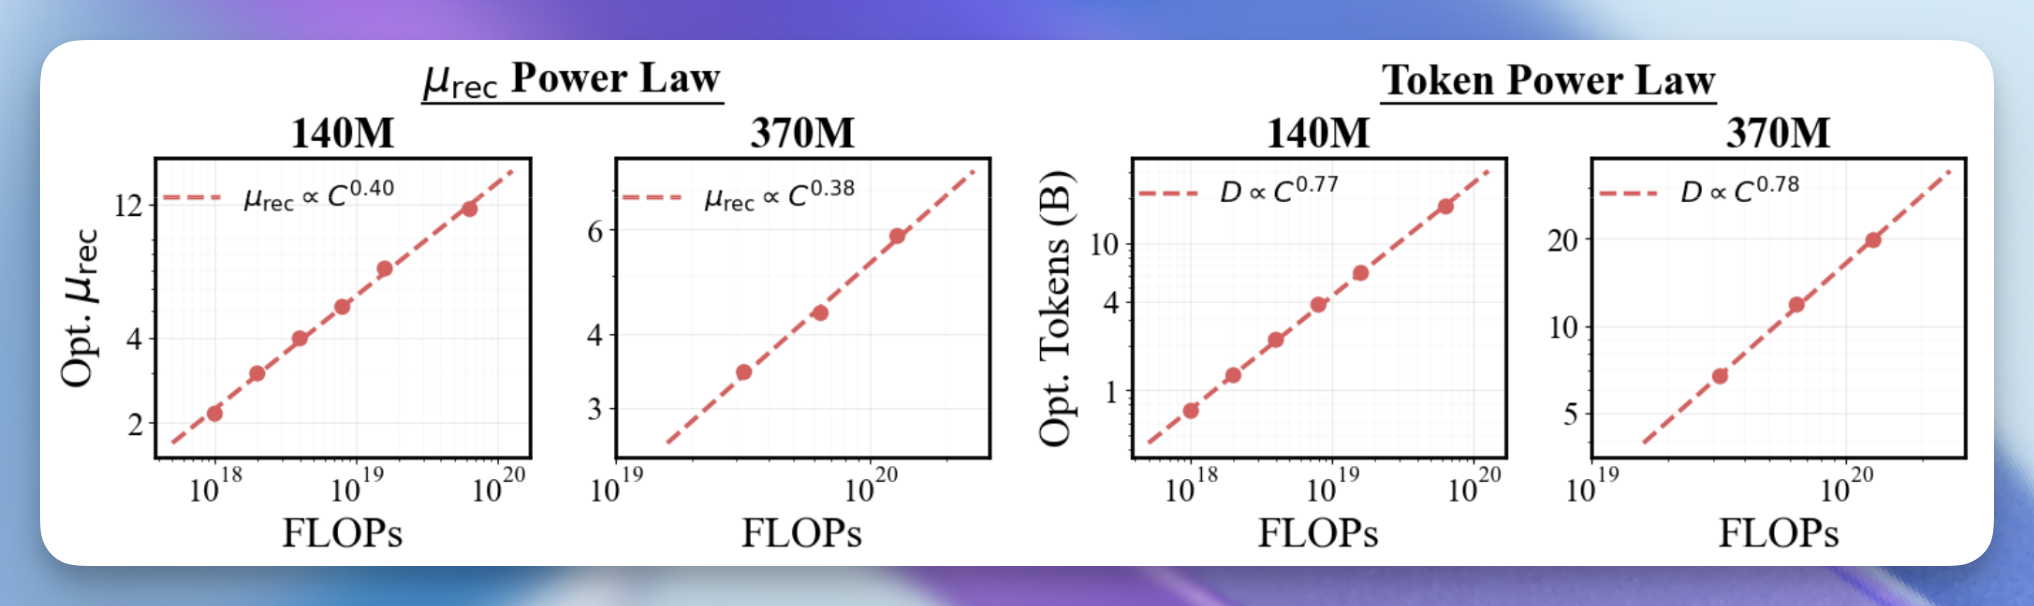
在两种规模下,我们发现,提高训练时使用的平均循环次数 $mu_{\text{rec}}$ 并按比例减少词元数,得到的验证集损失比低循环次数加更多数据的训练方式更低。更有意思的是,如果用抛物线拟合来提取每个 FLOP 水平下的最优 $mu_{\text{rec}}$ 和词元预算,就会发现两者都遵循幂律,且指数一致。
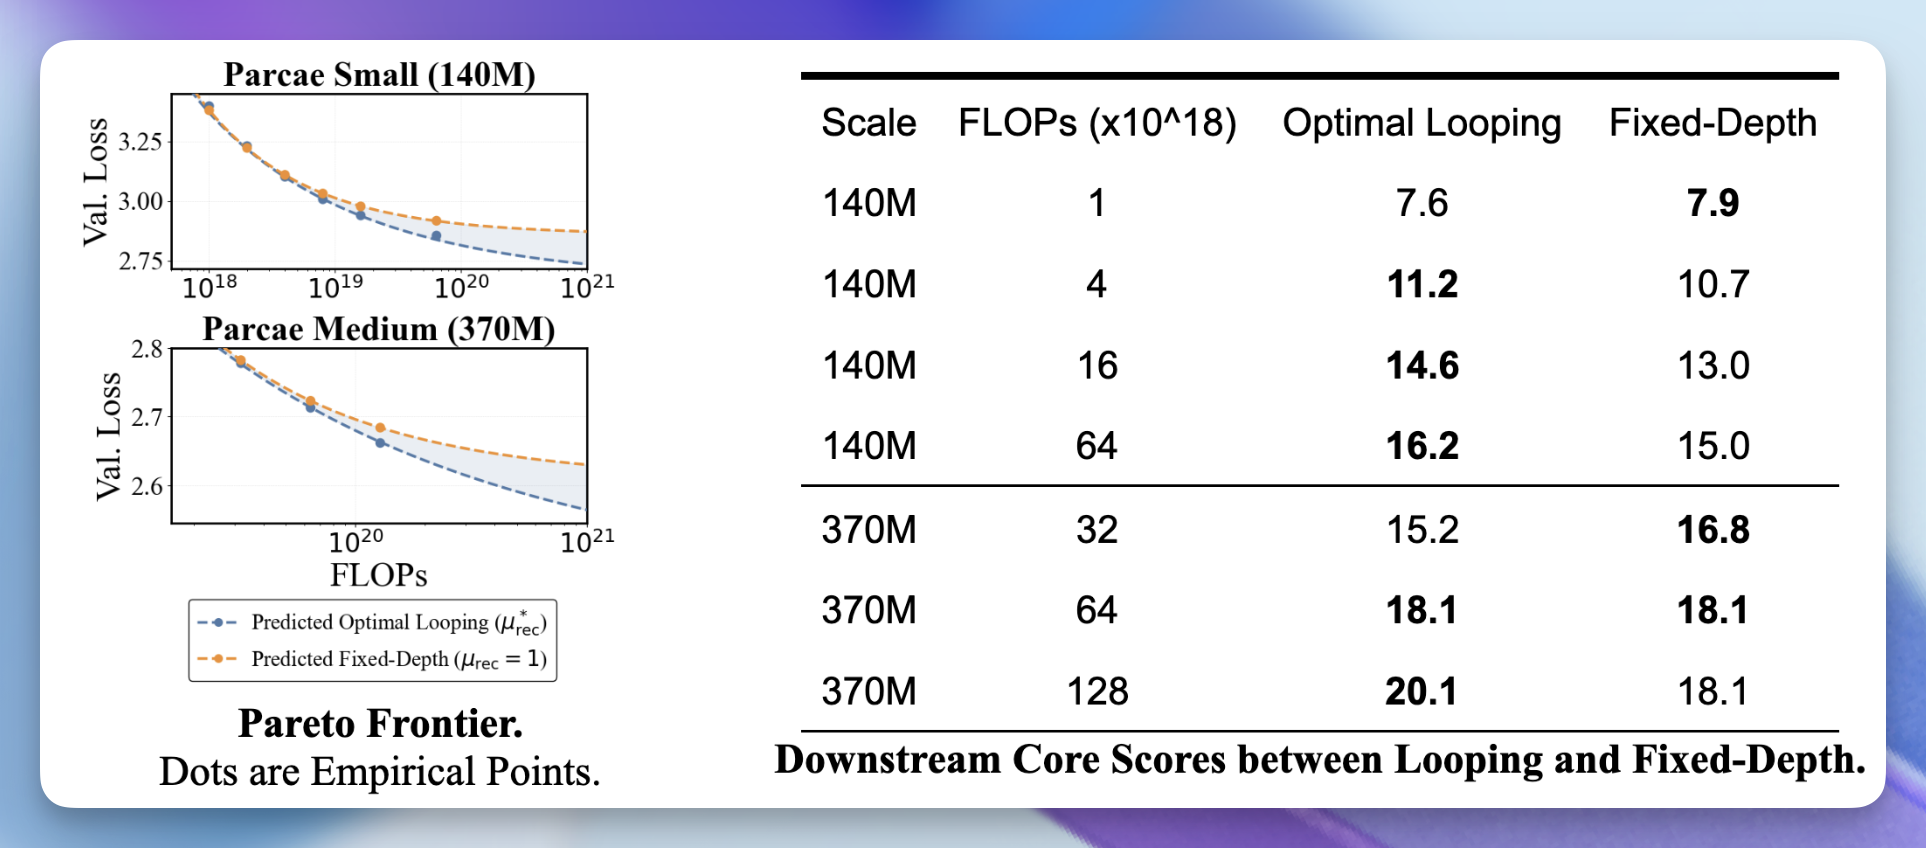
好,好。但我们能打败固定深度的模型吗?利用我们得到的最优循环缩放定律,我们将固定深度的 Parcae 模型(即 $\mu_{\text{rec}}=1$ 的模型)与按缩放定律预测的最优平均循环次数训练的循环 Parcae 模型做了比较。我们发现,循环创造出了在验证集损失上更严格的帕累托前沿(见下图),并转化为更好的下游质量(见下表)。
下一步 & 亲自试试 Parcae
我们对参数效率还能推进多远感到非常兴奋。随着推理期间内存开销的成本不断上升,我们认为层循环这类参数复用方法还有很多值得探索的空间。为了加快这一进程,我们发布了训练代码和模型。我们的工作还没有结束,我们还有大量新想法来进一步推进循环模型,敬请期待后续进展!
如果你有任何问题,或想与我们一起探索 Parcae 的下一步,请联系 Hayden Prairie:hprairie@ucsd.edu。
PaRCae 这个名字是向罗马神话中的三位命运女神致敬:Nona(前奏块 $\mathcal{P}$)负责开启计算的生命之线,Decima(循环块 $\mathcal{R}$)负责丈量这根线,并随模型深度不断演化,Morta(尾声块 $\mathcal{C}$)则通过剪断这根线来收束序列,产生最终输出。
致谢
感谢 Together AI 与我们合作,并为这些实验提供算力。同时感谢 Austin Silveria 和 Jonah Yi 对这篇博客文章提出的宝贵意见。
参考文献
- Liu Yang, Kangwook Lee, Robert D. Nowak 和 Dimitris Papailiopoulos。Looped Transformers Are Better at Learning Learning Algorithms(循环 Transformer 更擅长学习学习算法)。载于 The Twelfth International Conference on Learning Representations(第十二届国际学习表征会议),2024 年。↩
- Jonas Geiping, Sean Michael McLeish, Neel Jain, John Kirchenbauer, Siddharth Singh, Brian R. Bartoldson, Bhavya Kailkhura, Abhinav Bhatele 和 Tom Goldstein。Scaling Up Test-Time Compute with Latent Reasoning: A Recurrent Depth Approach(通过潜在推理扩展测试时计算:一种循环深度方法)。载于 The Thirty-Ninth Annual Conference on Neural Information Processing Systems(第三十九届神经信息处理系统年会),2025 年。↩
- Ahmadreza Jeddi, Marco Ciccone 和 Babak Taati。LoopFormer: Elastic-Depth Looped Transformers for Latent Reasoning via Shortcut Modulation(LoopFormer:通过捷径调制实现潜在推理的弹性深度循环 Transformer)。载于 The Fourteenth International Conference on Learning Representations(第十四届国际学习表征会议),2026 年。↩
- Sean McLeish, Ang Li, John Kirchenbauer, Dayal Singh Kalra, Brian R. Bartoldson, Bhavya Kailkhura, Avi Schwarzschild, Jonas Geiping, Tom Goldstein 和 Micah Goldblum。Teaching Pretrained Language Models to Think Deeper with Retrofitted Recurrence(通过改造式循环让预训练语言模型思考得更深)。arXiv preprint arXiv:2511.07384,2025 年。↩