Nvidia 发布了 Rubin CPX,这是一款专为预填充(prefill)阶段优化的方案,其单芯片 Rubin CPX 极度侧重计算 FLOPS,而非内存带宽。这对推理而言是颠覆性的变化,其重要性仅次于 2024 年 3 月发布的 GB200 NVL72 Oberon 机架级形态。只有针对推理中截然不同的两个阶段,即预填充和解码(decode),采用专门的硬件,分离式服务(disaggregated serving)才能充分发挥潜力。
因此,Nvidia 与竞争对手在机架系统设计上的差距已经大如峡谷。AMD 和定制芯片厂商或许在模仿 Nvidia 的 72-GPU 机架级设计上迈出了小小一步,但 Nvidia 刚刚又实现了一次“巨大飞跃”,再次把竞争对手远远甩在后视镜里,成了遥远的小点。
AMD 和 ASIC 厂商早已在自家机架级方案上投入重金,试图追赶。尤其是 AMD,一直在不懈地改进其软件栈,努力缩小与 Nvidia 的差距,但现在所有人都需要再次加倍投入,因为他们必须开发自己的预填充芯片,这进一步推迟了他们追平差距的时间表。这次发布之后,Nvidia 的所有竞争对手都将被打回绘图板,重新调整整个路线图,就像 Oberon 当年改变了整个行业的路线图一样。
Rubin CPX
由于推理中的预填充阶段往往大量使用算力(FLOPS)而只轻度使用内存带宽,在配备大量昂贵的、具有极高内存带宽的 HBM 的芯片上运行预填充是一种浪费。答案是一款内存带宽“瘦”、算力相对“胖”的芯片。Rubin CPX GPU 应运而生。
Rubin CPX 具备 20 PFLOPS 的 FP4 稠密算力,但内存带宽仅为 2TB/s。它还配备 128GB 的 GDDR7 内存,与 VR200 相比,内存容量更小、也更便宜。相比之下,双芯片的 R200 提供 33.3 PFLOPS 的 FP4 稠密算力,以及 288GB 的 HBM,带宽为 20.5 TB/s。
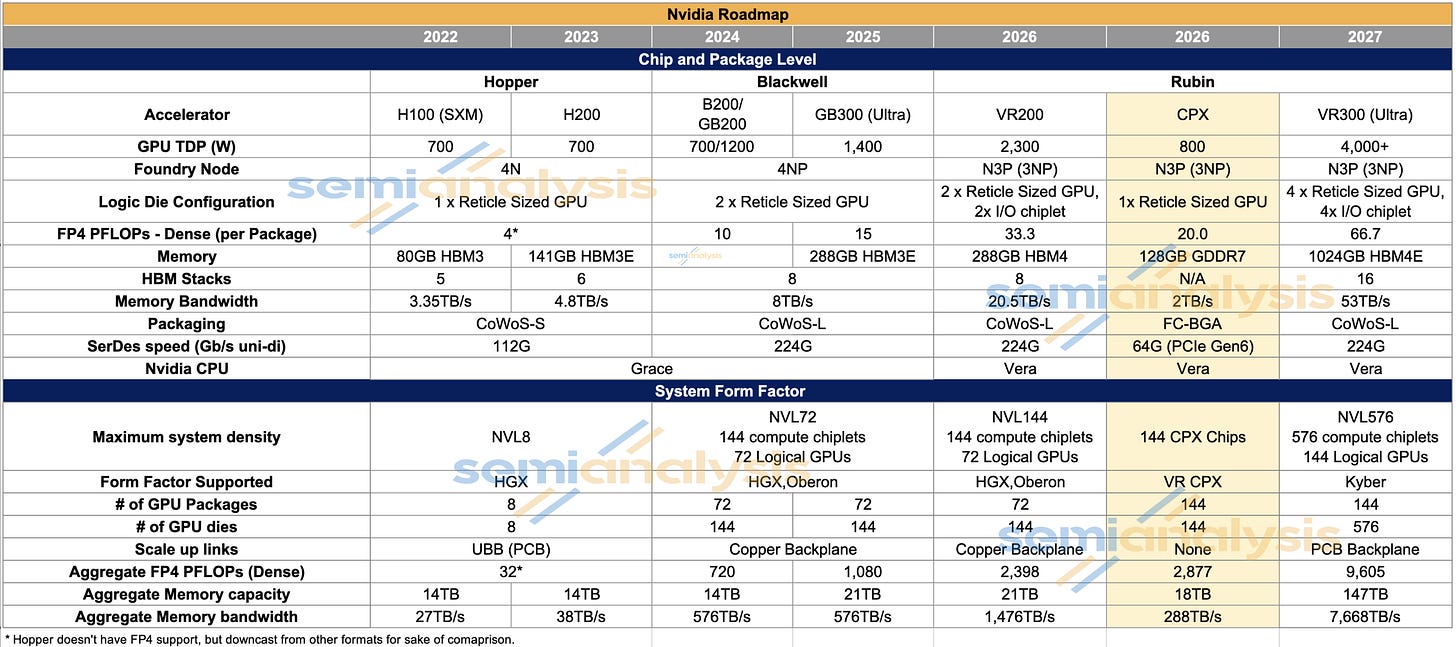
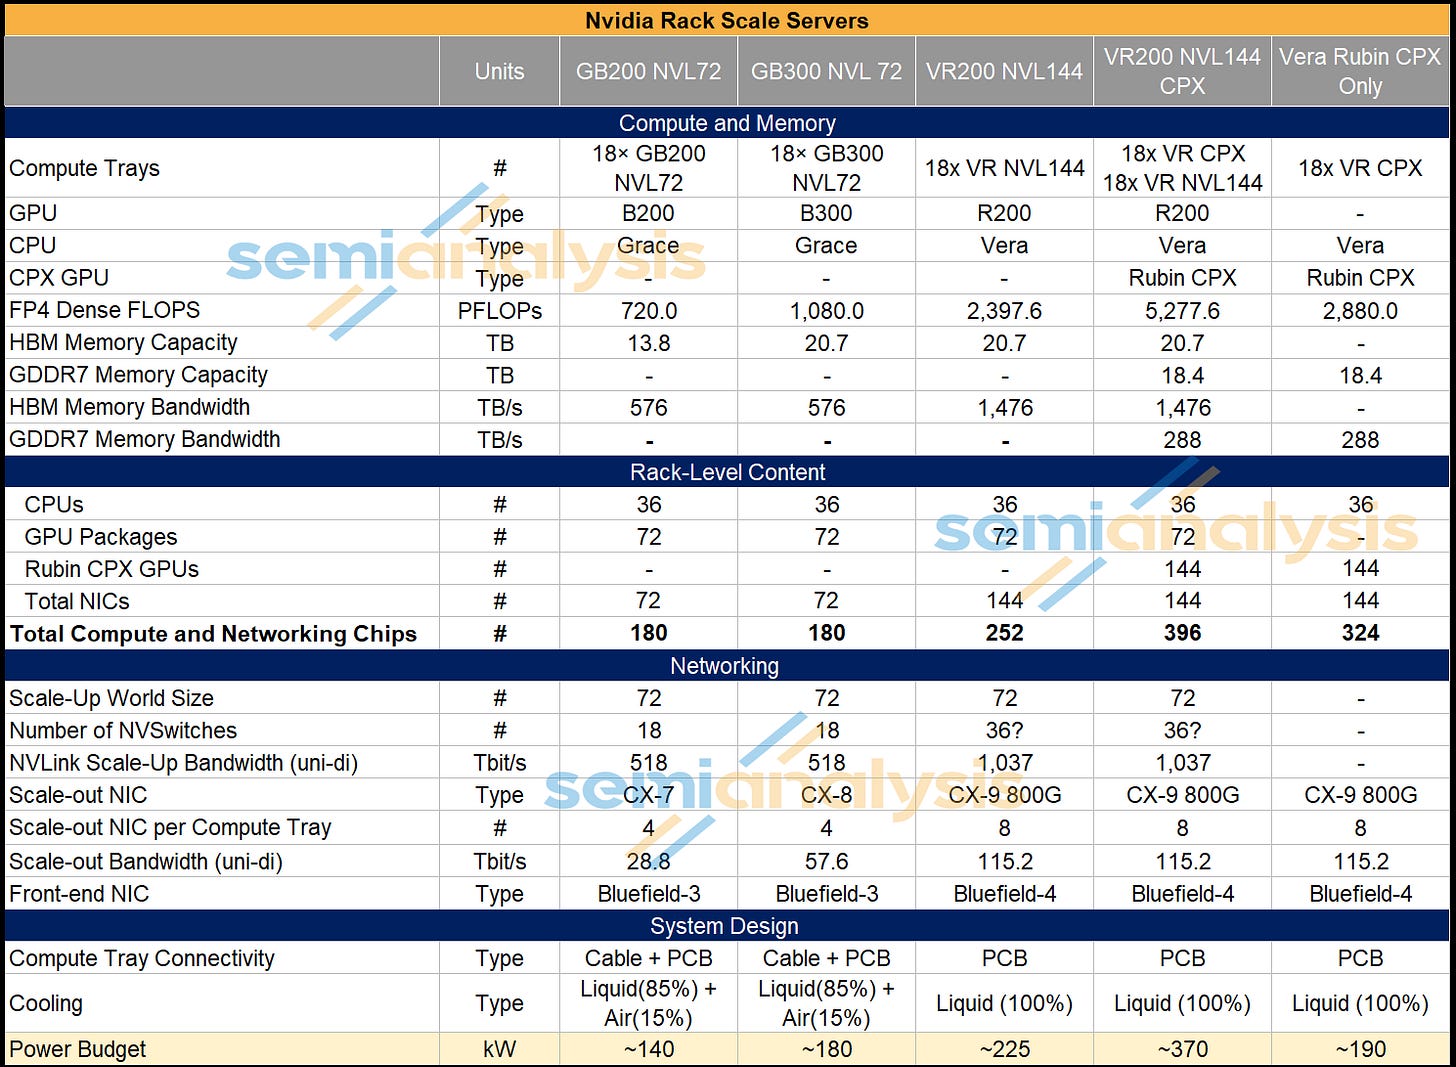
Rubin CPX 的引入把 VR200 系列机架级服务器扩展为三种形态:
- VR200 NVL144:18 个计算托盘共 72 个 GPU 封装,每个计算托盘有 4 个 R200 GPU 封装。
- VR200 NVL144 CPX:18 个计算托盘中,除 72 个逻辑 GPU 封装外,还有 144 个 Rubin CPX GPU 封装,每个计算托盘有 4 个 R200 GPU 封装和 8 个 Rubin CPX GPU 封装。
- Vera Rubin CPX 双机架:两个独立机架,一个 VR200 NVL144 机架加一个 VR CPX 机架,后者在 18 个计算托盘中共有 144 个 Rubin CPX GPU,每个计算托盘有 8 个 Rubin CPX GPU。
在本报告中,我们将首先讲述迄今为止的来龙去脉,以及开发 Rubin CPX 的动因,这源于内存在推理的预填充和解码阶段所扮演的不同角色。随后,我们将深入剖析 Rubin CPX 芯片的架构及其部署所在的机架级方案。接着,我们会把焦点从过去和现在转向未来,探讨分离式推理服务的前景,以及今天的发布将如何影响其他商用加速器厂商和定制芯片项目的未来路线图与竞争力。在文章的最后部分,我们将简要列出两种机架的关键物料清单(BoM)项目的完整清单,以及按主要组件组划分的功耗预算分析。
内存:迄今为止的故事
内存墙一直是 AI 最重要的约束。更大的内存容量对于把更大的模型加载到加速器中必不可少,而内存带宽则一直是推理和训练 token 吞吐量的主要限制因素。这就是为什么每个 GPU 的高带宽内存(HBM)容量和带宽增长如此迅速:从 H100 的 80GB 和 3.4TB/s,到 GB300 的 288GB 和 8.0TB/s,在不到三年的时间里,内存容量增加了两倍多,带宽提高了约 2.5 倍。
因此,从 Hopper 到 Blackwell,HBM 在加速器 BOM 中的占比持续上升,如今 HBM 已是 GB300 封装 BOM 中最大的单项组件。HBM 对训练和推理都极具价值,但当我们把推理拆解为预填充和解码这两个组成步骤时,HBM 只在解码步骤中具有高价值。在计算密集的预填充阶段,由于预填充的并行特性,生成 KVCache 对带宽的需求要低得多,因此这一步中 HBM 没有被充分利用。
HBM 相对于其他形式的 DRAM 之所以溢价如此之高,是因为它额外的带宽,而当这些带宽没有被充分利用时,这些 HBM 就被“浪费”了。HBM 在 BOM 中占比不断攀升,构成了又一堵“墙”,也是开发 Rubin CPX GPU 的动因。
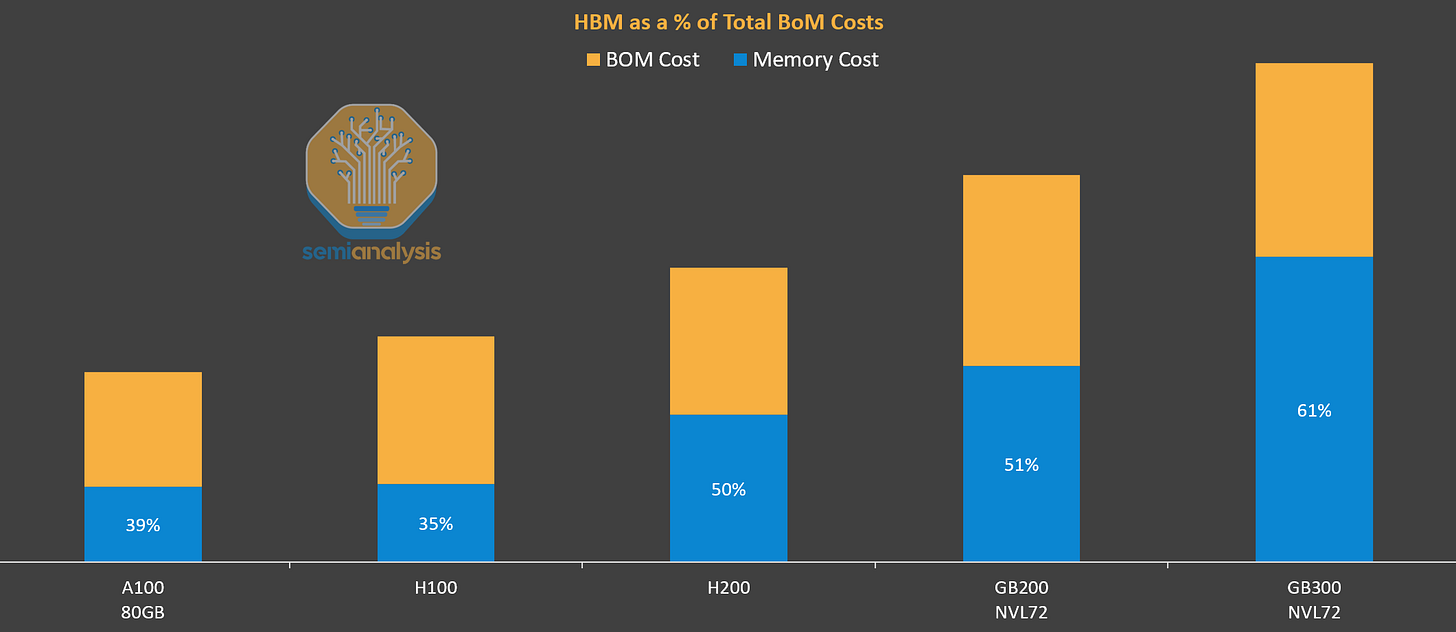
既然我们已经简要探讨了内存迄今所扮演的角色,下面让我们转向今天的发布,详细探讨 Rubin CPX 的架构及其部署所在的机架级服务器。
带宽与算力的差异
每颗 Rubin CPX 芯片将是一个采用传统倒装芯片 BGA 封装的单片 SoC。Rubin CPX 不使用 HBM,而是配备 128GB 的 GDDR7 DRAM。从 HBM 切换到更便宜的 GDDR7 内存,可使每 GB 成本降低 50% 以上。
内存速率很可能为 32Gbps,总线位宽 512 位。这使每颗 Rubin CPX 的内存带宽达到 2TB/s,而每颗 R200 为 20.5TB/s。值得注意的是,借这次主题演讲,Nvidia 还确认了对常规 Rubin 的一次重大带宽升级。正如我们在此前的加速器与 HBM 模型中讨论过的,R200 的 HBM4 速率已被大幅提高到 10Gbps,使每颗 R200 达到 20.5TB/s 的内存带宽。相比之下,R200 最初发布时的规格“仅”为 6.4Gbps 速率档位下 13TB/s 的内存带宽。我们同样在模型中讨论并量化了对 HBM 供应商的影响。144 颗各提供 2.0 TB/s 内存带宽的 CPX 芯片,与 72 颗提供 20.5TB/s 的 R200 芯片合计,可提供 1.7PB/s 的系统总内存带宽。
在算力方面,每颗 CPX 提供 30 PFLOPs 的稀疏 FP4 计算吞吐量(20 PFLOP 稠密),而 R200 为 50 PFLOPs 稀疏 FP4(33.3 PFLOPs 稠密)。Rubin CPX 的稠密 PFLOPs 与 R200 遵循相同的 3:2 稀疏对稠密比,因为它继承了与 Rubin R200 相似的张量核心架构。相对于 R200 的两颗计算芯片,CPX 以单颗计算芯片就提供了非常强的 FP4 计算吞吐量。这一增益很可能来自削减更高精度的计算单元,以获得更多的 FP4 ALU。B300 就是这样做的,因而在仍采用同一 4NP 工艺节点的情况下,获得了比 B200 更高的 FP4 吞吐量。
然而,一如既往,理论峰值 FLOPs 在实践中极难达到。与 Nvidia 其他受功耗限制的 GPU 一样,鉴于我们估计其额定功耗仅约 800W,Rubin CPX 很难持续接近峰值 FLOPs:我们认为功率密度难以突破 1W/mm2,尤其是在板卡集成为夹层形态的情况下(详见下文)。
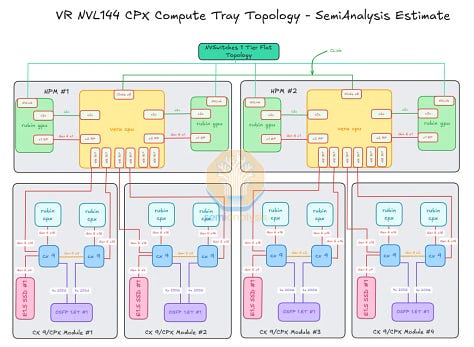
另一个不同之处在于网络。它没有用于纵向扩展(scale-up)的 NVLink SerDes,而是依靠 PCIe Gen 6,通过横向扩展(scale-out)网络上的 CX-9 网卡与其他 GPU 通信。这种缩减的网络能力完全可以通过实现流水线并行来弥补,我们将在下文讨论。
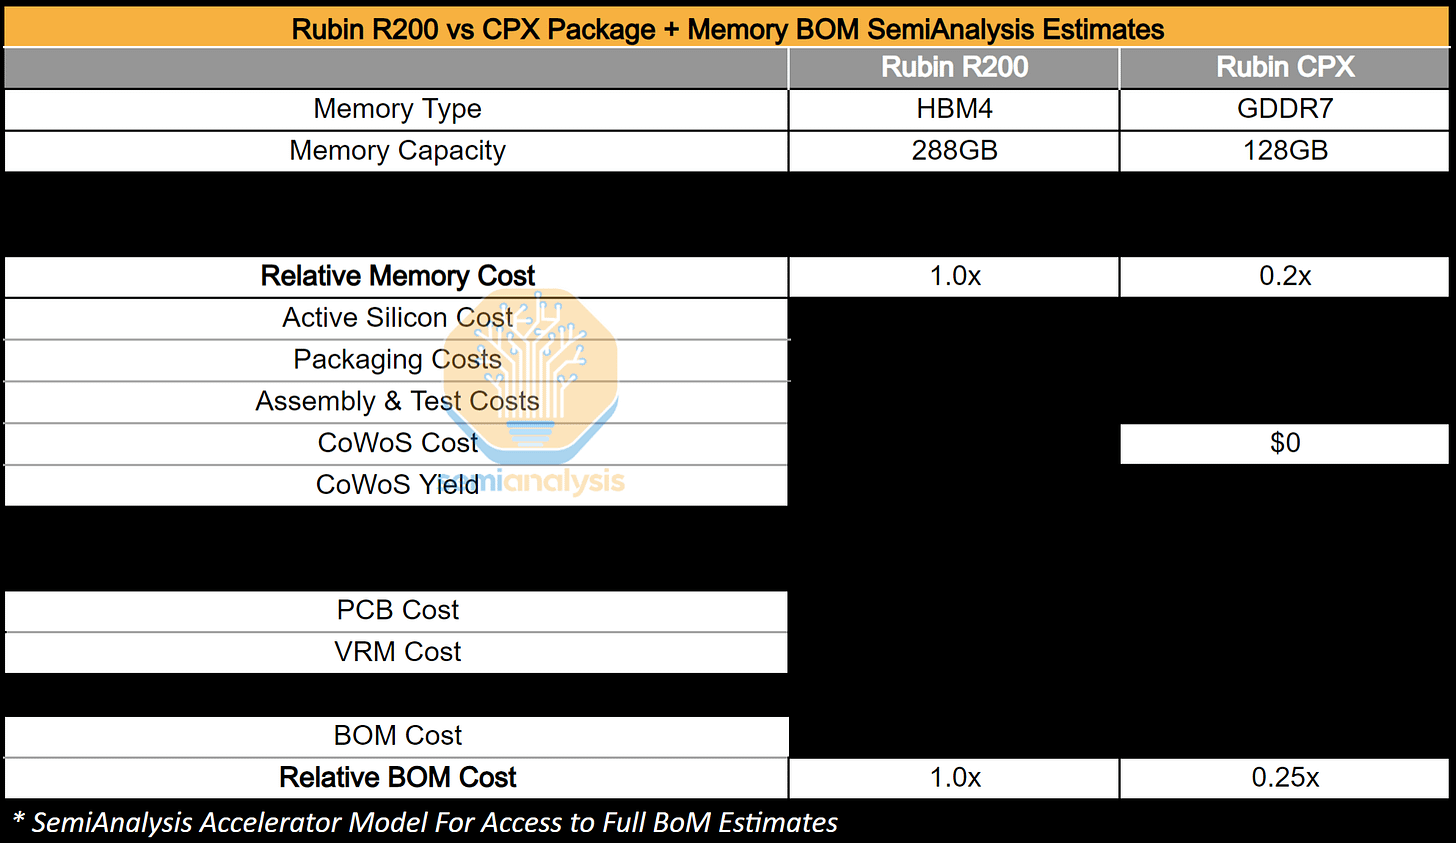
由于硅片总用量更低、内存更便宜,Rubin CPX 的生产成本远低于 R200。降低内存总容量并使用成本更低的 GDDR7,意味着内存成本低了 5 倍。芯片架构也简单得多:避开 HBM,只有一颗光罩尺寸的单芯片、没有任何 I/O 小芯片(chiplet),意味着不需要 CoWoS 封装。作为参照,Rubin CPX 的设计类似于下一代 RTX 5090 或 RTX PRO 6000 Blackwell,二者都采用大型单片芯片,配 512 位宽的 GDDR7 内存接口。由于这些芯片基于消费级 Blackwell GPU 芯片,它们的 FLOPS 只有配备 HBM 的“大哥”B200 的 20%。而 Rubin CPX 这一比例跃升至 60%,因为它将是一次单独的流片,看起来更接近 R200 的计算芯片。就“单位成本下获得最大 FLOPS”而言,Rubin CPX 无出其右。
在文章后面,我们将拆解 Rubin CPX 的 BOM 优势,并估算把预填充从 R200 转移到 Rubin CPX 上能节省多少成本。
Nvidia Oberon 机架架构升级:VR NVL144 CPX、VR NVL144、VR CPX
接下来,我们离开 Rubin CPX 芯片本身,来看承载 CPX 的两款全新 Vera Rubin 机架。
去年 3 月的 GTC 2024 上,Nvidia 发布了第一代 Oberon 架构:GB200 NVL72。一年半之后,第二代 Oberon,即 GB300 NVL72,即将进入量产出货阶段。这两代之间的设计变化和升级非常少。第三代 Oberon 架构 Vera Rubin(VR)则是 Ian 今天在 AI Infra Summit 上演讲的重点。VR 将于 2026 年推出,距 Oberon 机架级形态首次亮相不到三年,相比 GB200/GB300 会有重大的设计变化和升级。
Vera Rubin Oberon 把 Oberon 架构的功率密度推到了极限,需要大幅升级供电部分的用料,并改动散热方案的设计。选择无线缆设计,是为了克服 GB200/GB300 组装时飞线(flyover)线缆走线困难的问题&托盘内线缆带来的可靠性挑战。连接 OSFP 笼(cage)与 ConnectX 网卡的线缆已被取消;从 PCIe 连接到前端 Bluefield DPU & 本地 NVMe 存储的线缆也已取消,其他边带(side band)线缆同样如此。
Vera Rubin 的关键变化与升级,集中在以下三款 Vera Rubin(VR)计算托盘 SKU 的全面改版上:
- VR NVL144(仅 Rubin)
- VR CPX(仅 Rubin CPX)
- VR NVL144 CPX(同一托盘内同时包含 Rubin 与 Rubin CPX)
这三种计算托盘是下面所讨论的三种机架方案的基本构件:
- VR NVL144
- VR NVL144 CPX
- VR NVL144 + VR CPX(双机架)
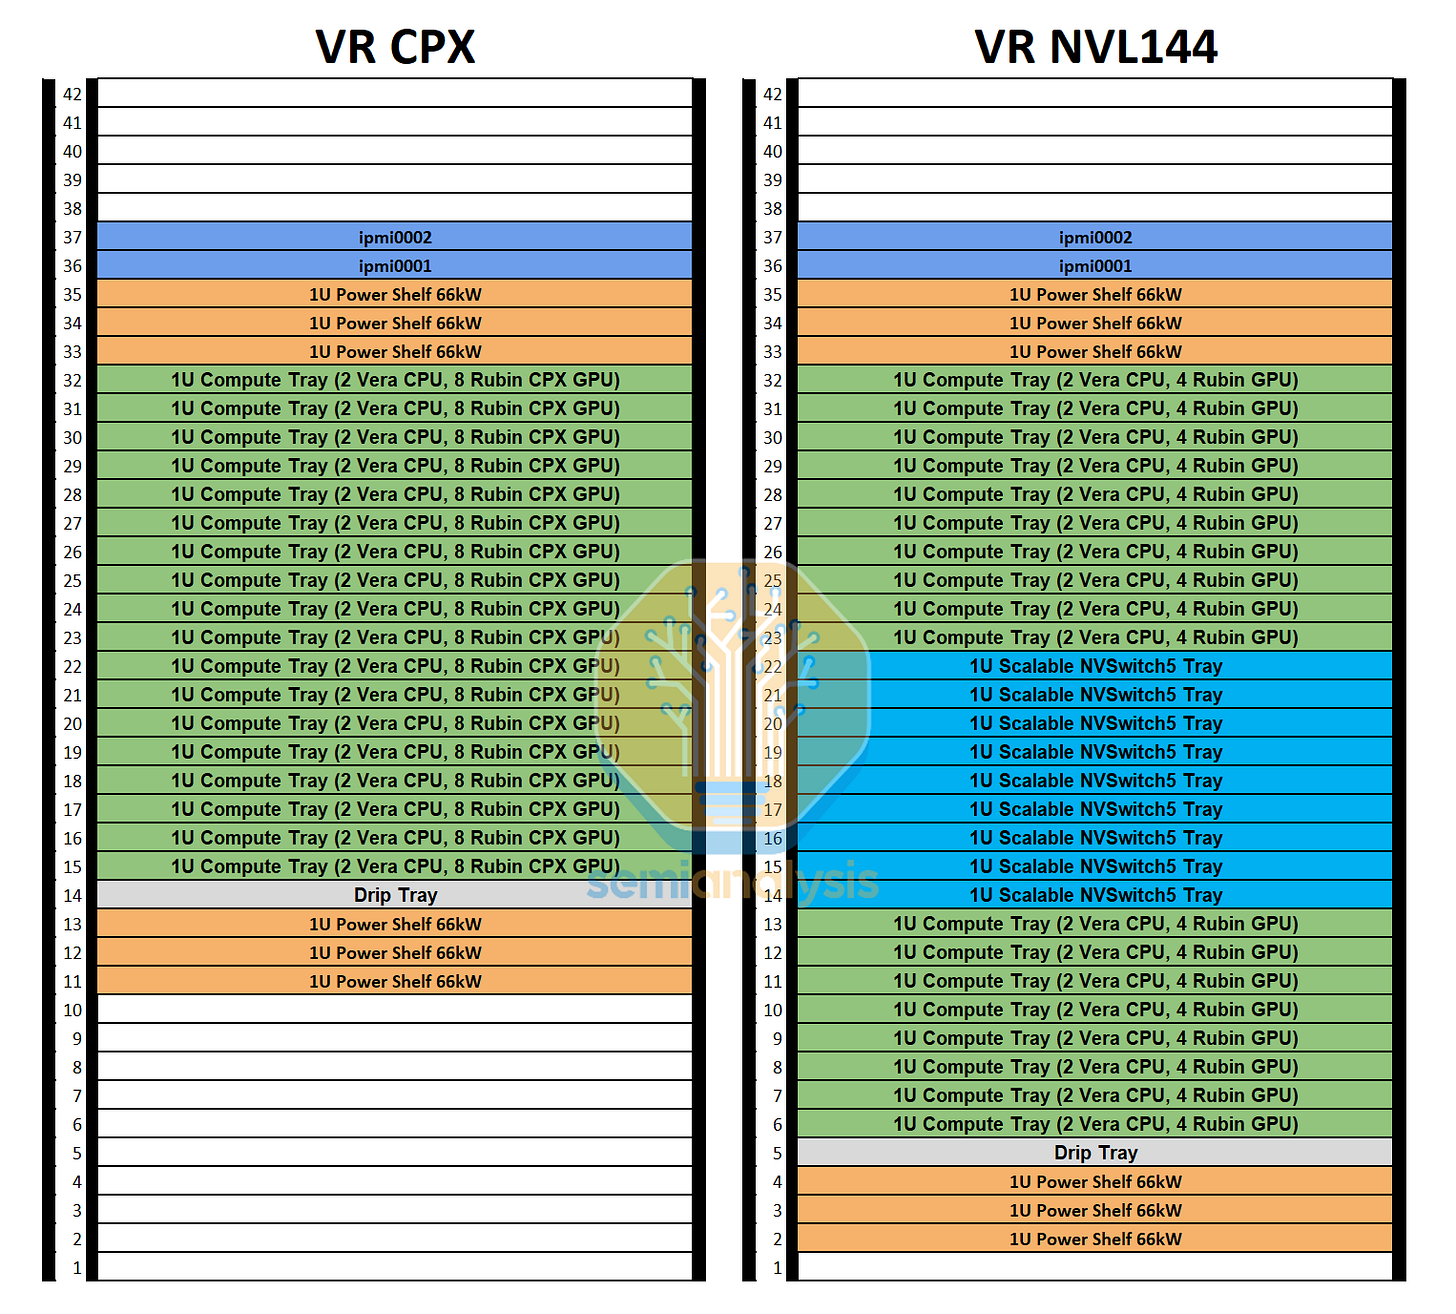
首先介绍的是 VR NVL144 CPX 机架。它与 VR NVL144 类似,区别在于 VR NVL144 CPX 的 18 个计算托盘中,每个托盘除了 4 颗 R200 GPU 和 2 颗 Vera CPU 之外,还额外配有 8 颗 Rubin CPX GPU。
VR NVL144 CPX 机架同样采用液冷,但功率预算高得多,约为 370kW,而 VR NVL144 约为 190kW。
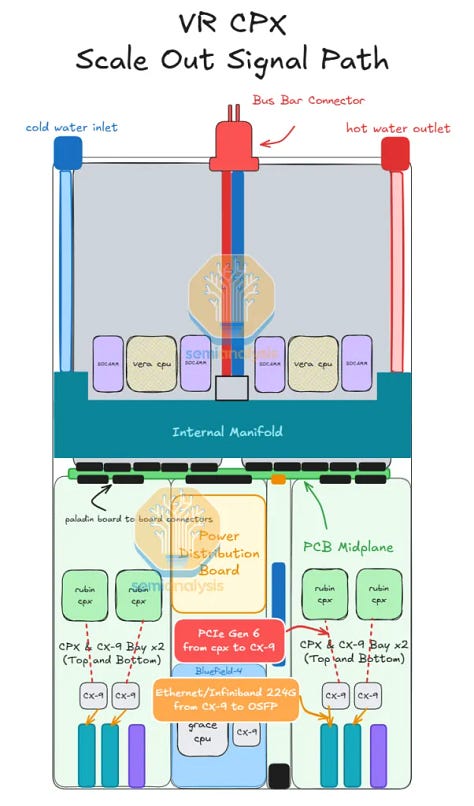
另一种部署方式是 Vera Rubin CPX 双机架方案。顾名思义,已部署 VR NVL144 机架的客户之后可以在数据中心里再增加 VR CPX 机架,从而获得面向分离式 PD 推理(预填充与解码分离)的专用硬件。VR CPX 不通过 NVLink 连接,因此 VR CPX 机架不含 NVSwitch 托盘。VR CPX 机架通过 InfiniBand 或以太网等横向扩展(scale-out)网络接入集群,后续可以放在方便的物理位置,不必与 VR NVL144 物理相邻。
与 VR NVL144 CPX 相比,双机架方案灵活得多,客户可以按自己的意愿设计预填充与解码的配比。此外,并非每家的数据中心基础设施都能承受约 370kW 的 VR NVL144 CPX。同时,与单机架方案相比,故障的爆炸半径也更小。
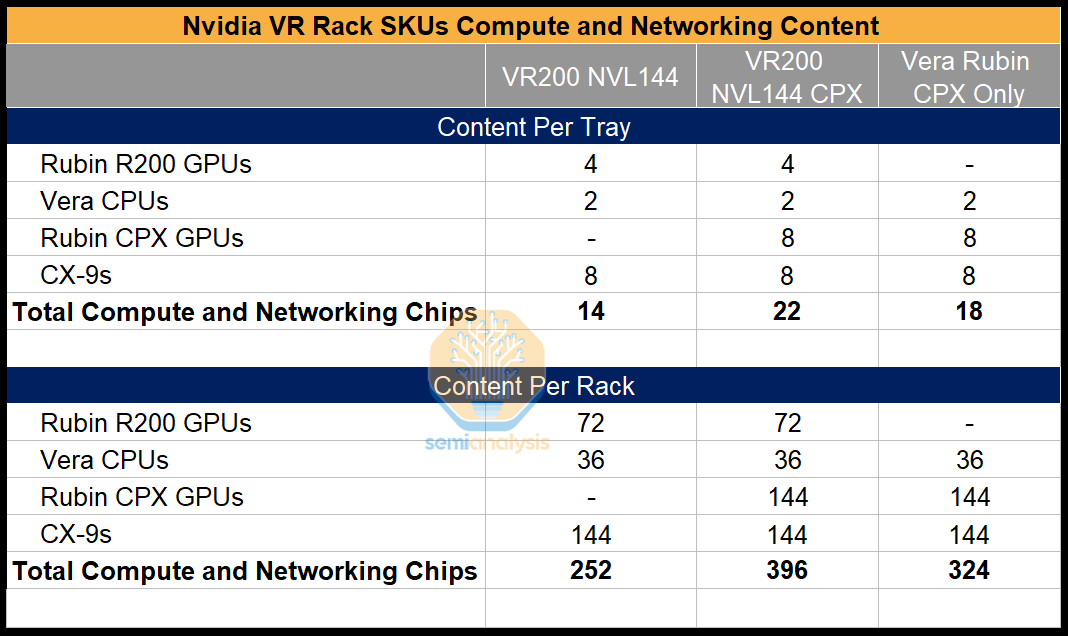
从下表可以看到,一个计算托盘里塞进了多少计算和网络内容:每个计算托盘共有 22 颗 Nvidia 芯片(其中 14 颗是 XPU),每个 VR NVL144 CPX 机架共有 396 颗芯片。为了把以上所有内容塞进单个计算托盘,Nvidia 转向了无线缆的模块化设计,并重新设计了计算托盘内部的冷却回路。
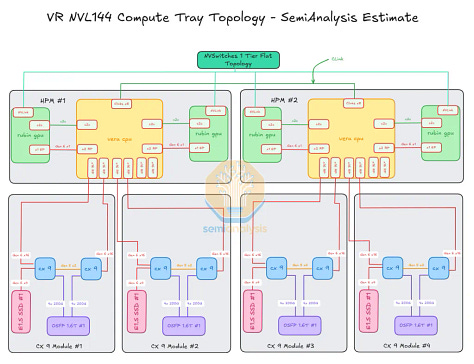
NVL144 CPX 在计算托盘机箱的后半部分保持与 GB200/GB300 相似的计算板布局。值得注意的差异是,CPU 所用内存由焊接的 LPDDR5X 改为可插拔的 SOCAMM DRAM 模块。VR NVL144 CPX 与 GB200/GB300 的大部分差异,在机箱前半部分、位于主机处理器主板(Host Processor Motherboard,简称“HPM”)计算板之下的区域;该计算板在 Blackwell 一代也被称为“Bianca”板。
在前部,VR NVL144 CPX 的设计是模块化的,由 7 个子卡模块构成。
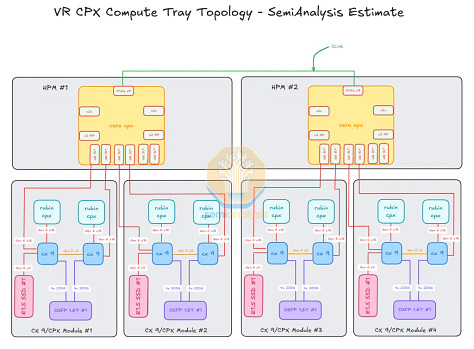
- 机箱两侧各放置四个子卡模块中的两个,每侧有两块子卡上下叠放。这四块子卡各包含两个 800G CX-9 网卡、一个 1.6T OSFP 笼、一个 E1.S SSD NVMe 模块,以及两颗 Rubin CPX。
- 机箱中间有一块子卡(下图的中下部),容纳 Bluefield-4 模块,其中包含一颗 Grace CPU 和一个 CX-9 网卡。
- 叠在该 Bluefield-4 模块上方的一块子卡容纳供电板(PDB)。电力从后部的汇流排(busbar)接口进入机箱时,PDB 负责把电压从 48-54V 降至 12-13.5V。
- 最后一块子卡小得多,放在 Bluefield-4 模块的右侧。它要纤薄得多,容纳管理模块,其中包括 BMC、HMC、DC-SCM 以及管理 I/O 等部件。
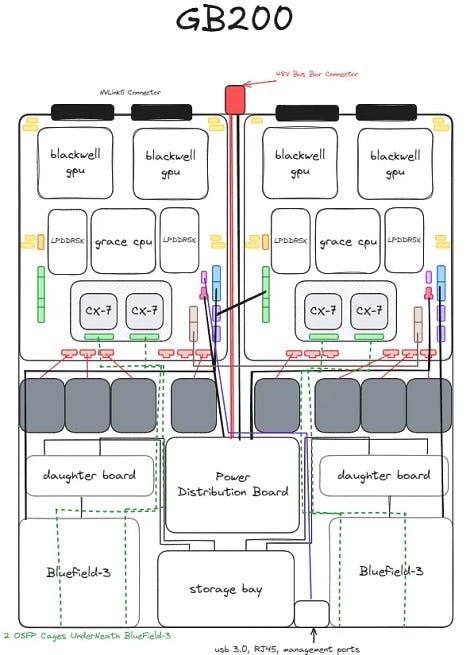
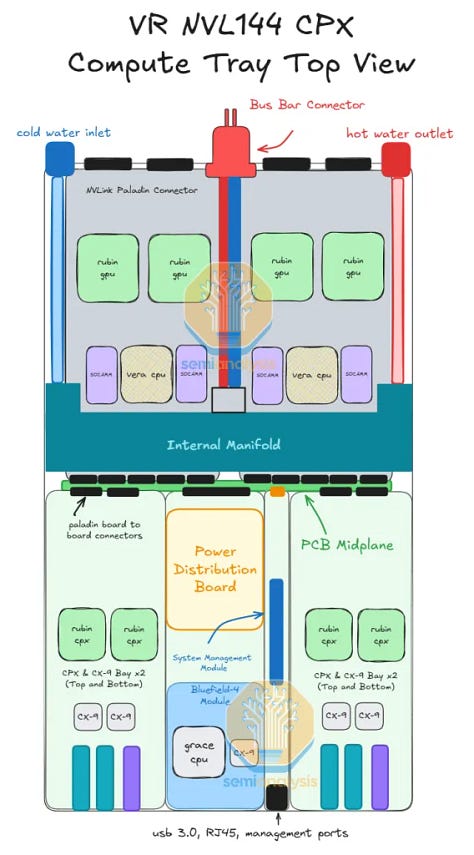
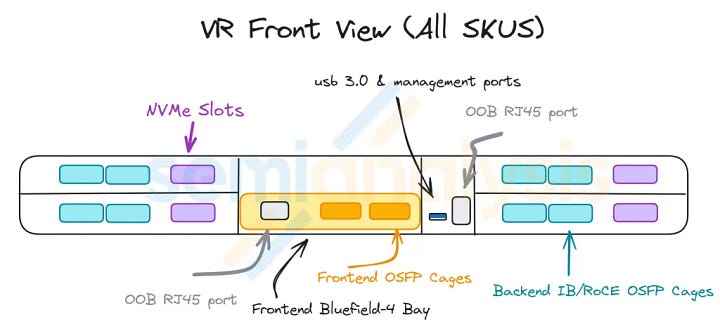
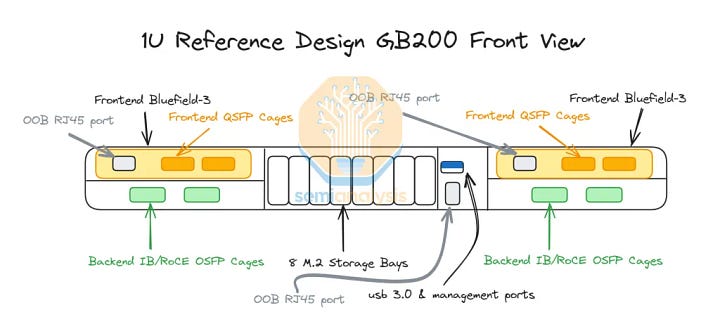
我们估计 Rubin CPX 芯片的 TDP 约为 800W,若把包含 GDDR7 内存的整个模块计算在内,则升至共 880W。要给计算托盘前部总计 7,040W 的 Rubin CPX 模块散热,机箱前部的冷却必须从风冷升级为液冷。
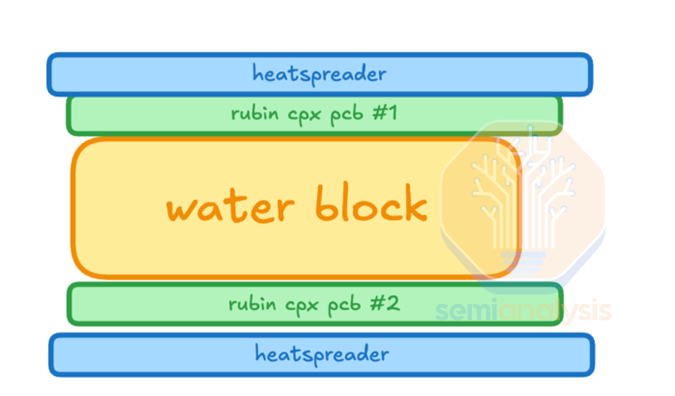
为此,NVIDIA 重新启用了其 2009 年 GTX 295 的一种设计:Rubin CPX 与 CX9 子卡以夹心结构排布,中间共用一块液冷冷板。
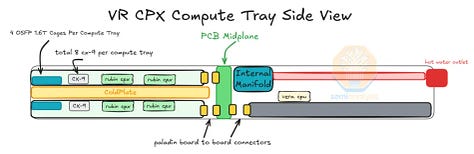
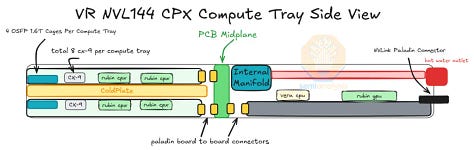
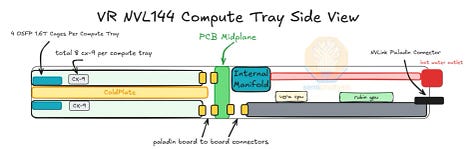
在 PCB 的外侧,热管和均热板把每个贝壳式(clamshell)GDDR7 内存模块背面的热量传导到主冷板。充分利用 1U 托盘的高度并使用冷板的两面,使容纳这些 GPU 所需的计算托盘面积减半,从而实现最大密度。
VR NVL144 CPX 的另一项关键设计变化是采用无线缆设计。正如我们在PCB 超级周期核心研究报告以及近期关于Amphenol 的 AI 业务的核心研究报告中所讨论的,采用这种设计有两个原因。第一,飞线线缆存在多个故障点,很容易在组装过程中损坏。第二,VR NVL144 CPX 的高密度设计没有留出走线的空间。
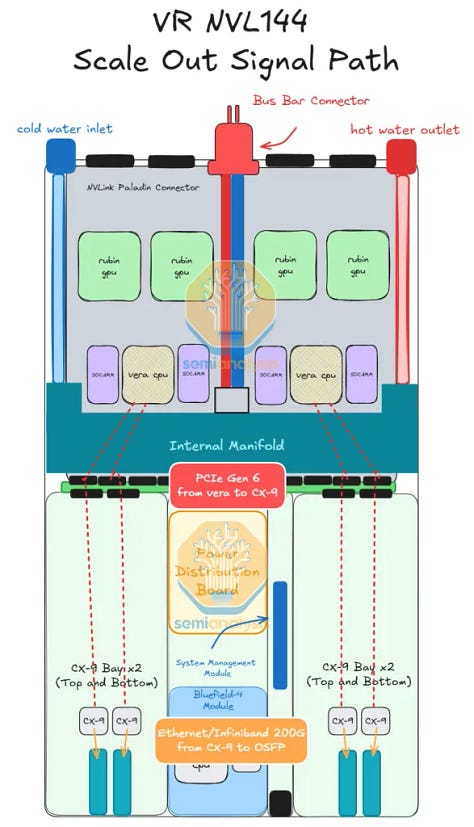
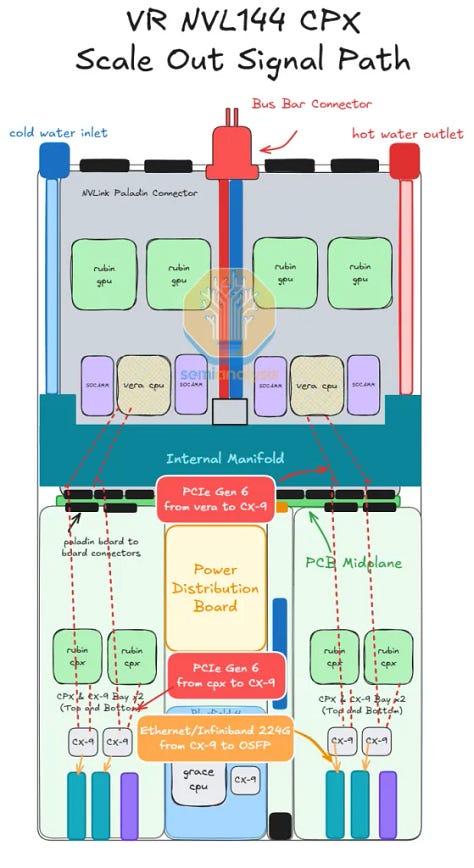
那么,没有线缆,信号是如何传输的呢?答案很简单:来自 HPM(Bianca)板的信号经由 Amphenol 的 Paladin 板对板连接器离开主板,再通过位于机箱中部的 PCB 中板(midplane)进行传输。在 PCB 中板的另一侧,子卡通过另一组 Paladin 板对板连接器与中板相连。更多细节请参见我们近期关于 Amphenol AI 业务的文章。
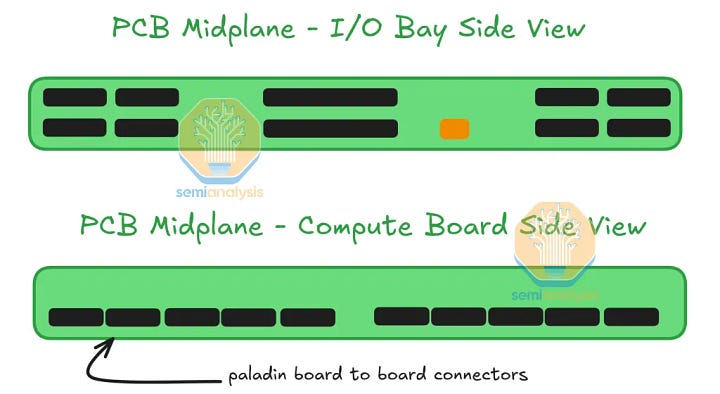
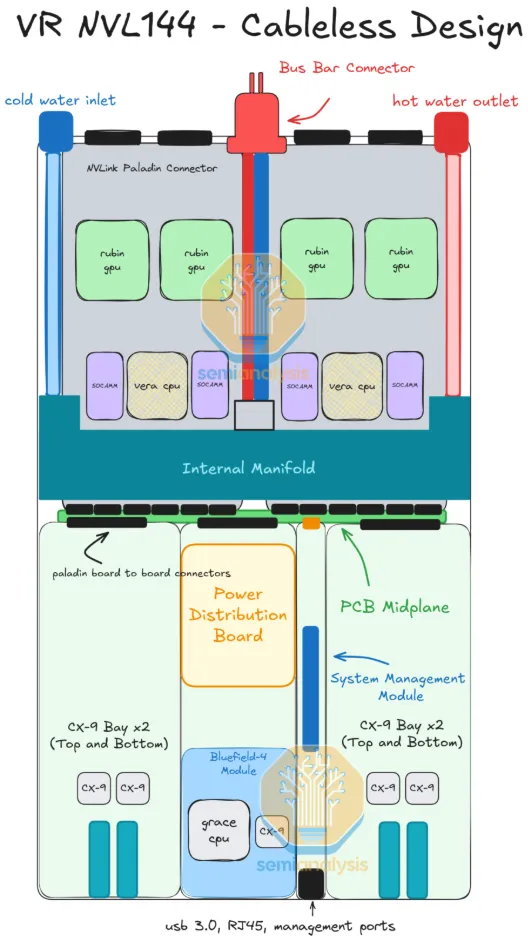
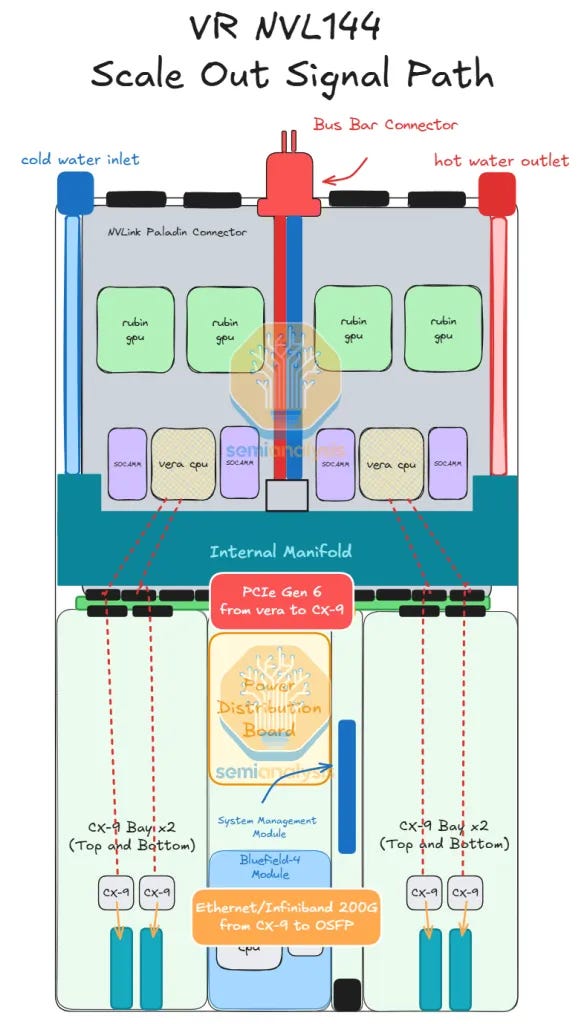
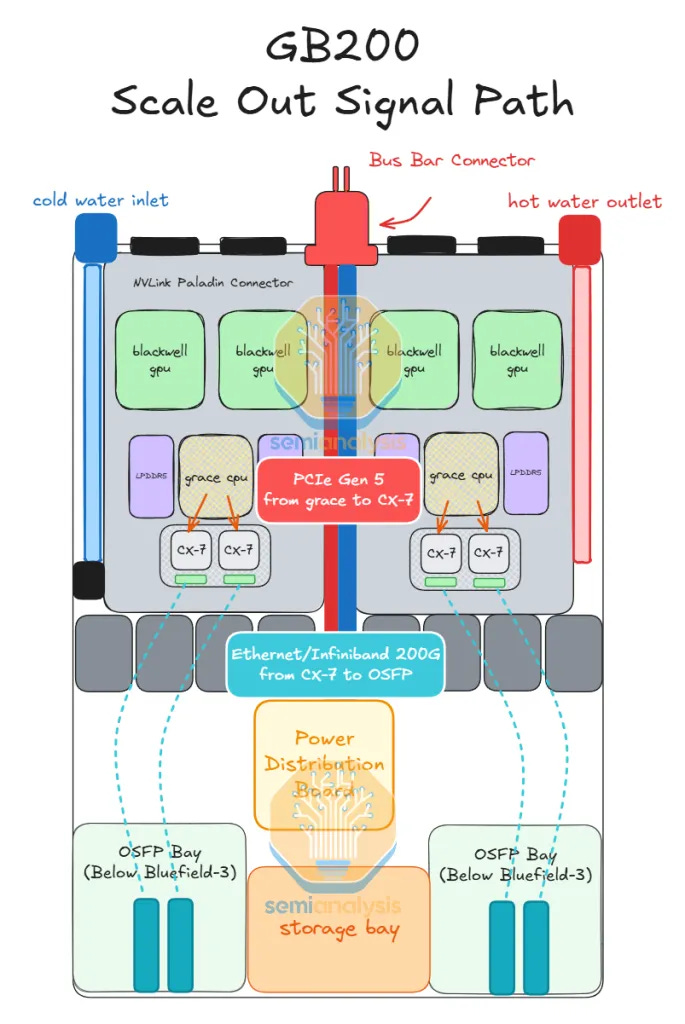
为了适应这种无线缆设计,HPM(Bianca)板上部的 CX-9 网卡如下图所示,从机箱后半部移到了前半部。在 GB200/GB300 中,GPU/CPU 与 CX-7/8 之间的 PCIe 信号距离,比 CX-7/8 与 OSFP 笼之间的以太网/InfiniBand 信号距离更短。
以前,要把 200G 的以太网/InfiniBand 信号从计算托盘后半部的网卡传到前部的 OSFP 笼,就必须使用飞线线缆,因为每通道 200Gbit/s(单向)的信号在 PCB 上的损耗太高。
但现在网卡离 OSFP 笼更近了,每通道速率较低的 PCIe Gen6 信号(每通道单向 64Gbit/s)需要走更长的距离,这段连接可以通过 PCB 布线实现。尽管在 PCB 上驱动 PCIe Gen6 信号仍然具有挑战性,但通过升级 PCB 材料,仍可实现良好的信号完整性。
为了便于维护,子卡也被设计成模块。每个子卡模块都可以滑入和滑出子卡模块仓。计算托盘内部为此设计了内部导轨套件。
下面我们展示信号在不同 Vera Rubin 计算托盘 SKU 内部如何走线,以及 VR Rubin 各 SKU 的计算托盘拓扑。这些图的一个亮点是,CX-9 在支持 Rubin CPX 和横向扩展连接方面起着关键作用,因为它同时也是一个集成的 PCIe 交换机。
巨大飞跃:分离式服务
今天发布的 Rubin CPX 将改变推理领域的游戏规则,其意义仅次于当初发布 GB200 NVL72 Oberon 机架级形态。只有针对推理中截然不同的两个阶段,即预填充和解码,使用专用硬件,才能真正实现分离式服务。
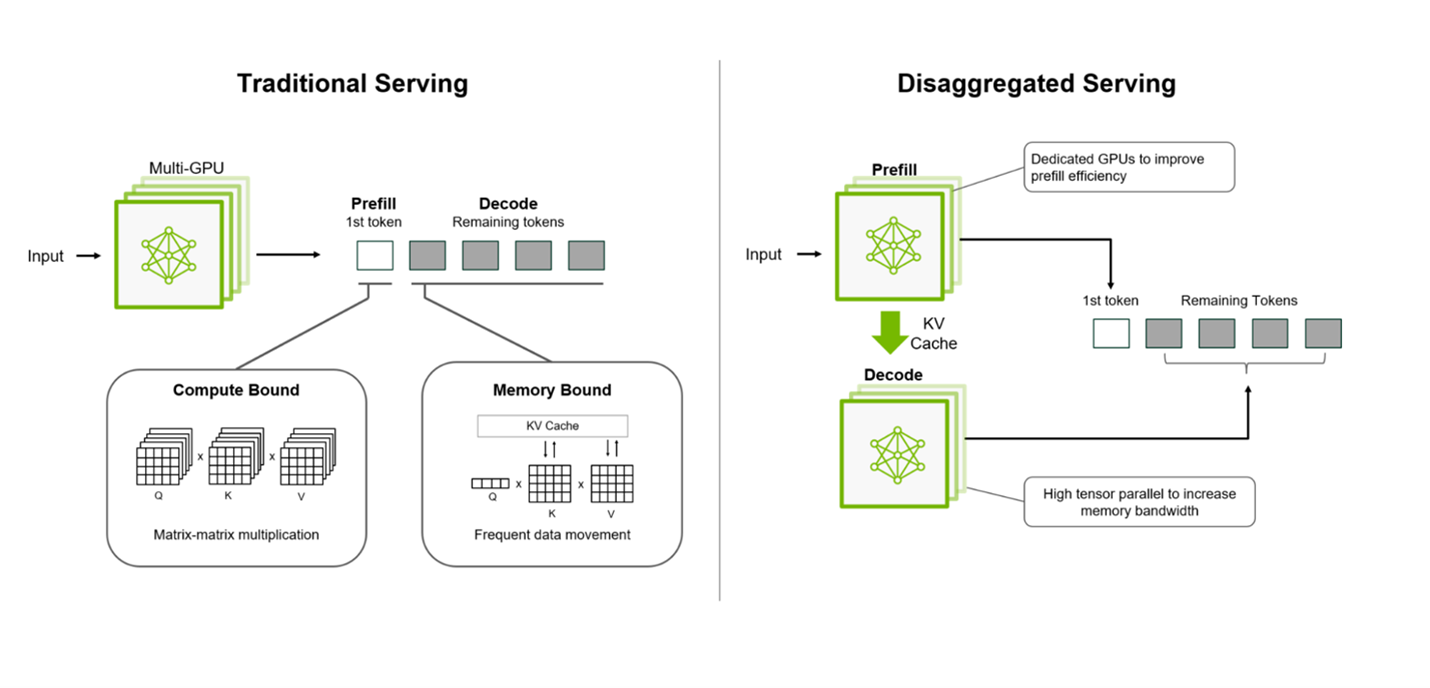
本节将解释从传统服务到使用统一硬件的分离式服务的演进,并以对使用专用硬件的分离式服务的分析作结。我们将展示统一硬件上的分离式服务会造成多大的浪费。一旦专用推理硬件普及,继续使用统一硬件就像买一把风镐去拍死一只虫子。
正如我们在文章前面提到的,Rubin CPX 的发布将迫使 Nvidia 的竞争对手回到绘图板前,重新规划路线图。如果不推出自己的预填充专用芯片,就等于让自家客户背上低效的系统,注定让这些客户在 token 经济学(tokenomics)的市场竞争中落败。
处理一次 LLM 请求包含两个阶段:预填充(prefill)阶段和解码(decode)阶段。在预填充阶段,LLM 根据用户提示词生成第一个 token。这一阶段影响首 token 时间(TTFT),通常受计算限制,内存带宽利用不足。而在解码阶段,模型一边从 KV 缓存中加载之前的 token,一边生成新的 token。这一阶段影响每输出 token 时间(TPOT),始终受内存限制,计算资源利用不足。
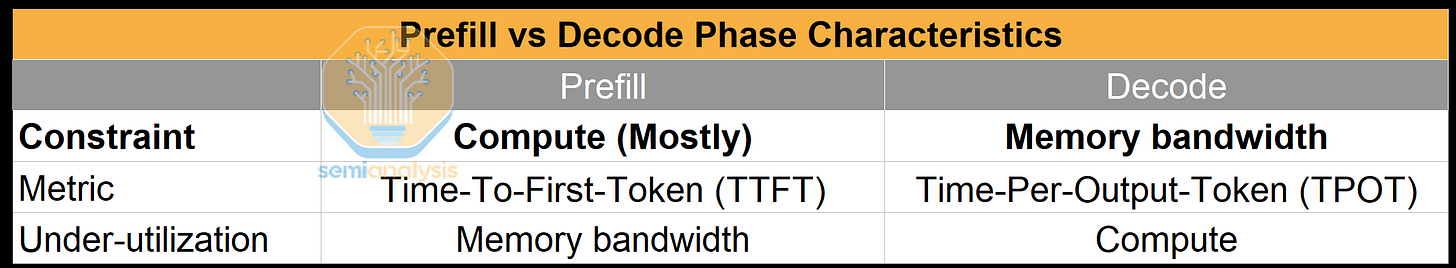
下图是一个示意性的例子,说明在同一系统上同时进行预填充和解码时,内存带宽与 FLOPS 利用率之间的权衡。预填充单个 token 所需的 FLOPS 与输入序列长度成线性关系。解码所需的 FLOPS 同样随系统上的用户数(即批大小)和序列长度而增长。
较短的输入序列可能无法占满推理系统的可用 FLOPS,此时系统的输出受限于参数加载到芯片内存的速度,而这取决于内存带宽。然而,随着输入序列长度增加,工作负载最终会用尽推理系统的全部可用 FLOPS,此时受限于系统的总 FLOPS。在下图右半部分可以看到,当序列长度超过 32k 时,FLOPS 利用率达到 100%,而内存带宽利用率则下降。
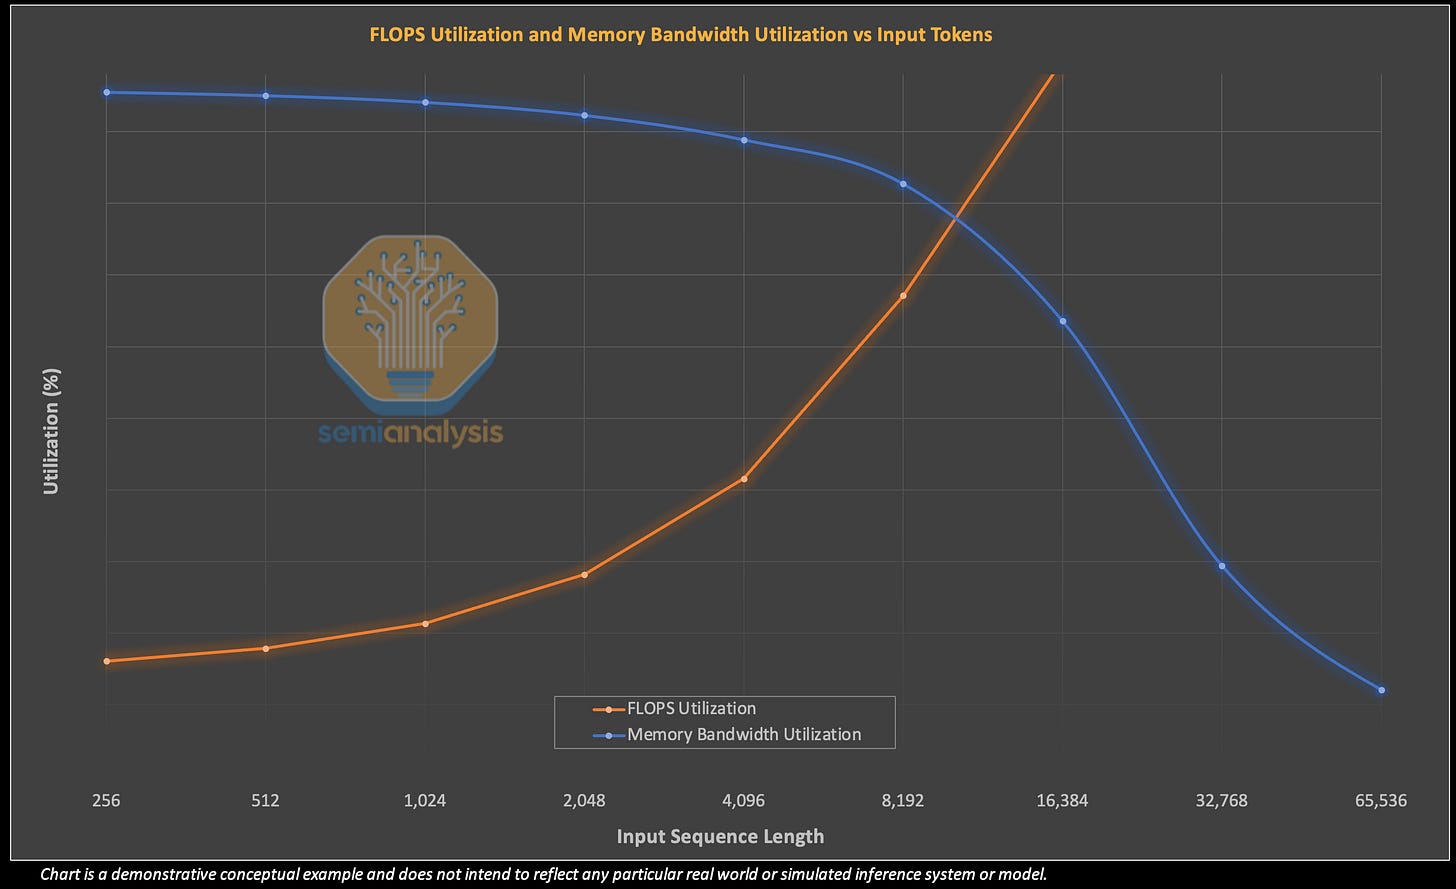
由此可见,当节点执行预填充占主导的工作负载,即序列很长或批大小很大时,内存带宽处于闲置状态。正如上一节所述,过去几年内存在芯片 BOM 中的占比持续上升,这最终造成了非常昂贵的资源利用不足!
低效还源于预填充和解码两个阶段的工作负载特征本质上差异极大,以至于二者并发处理时,预填充请求和解码请求总会相互干扰性能。人们有许多优化手段试图兼顾两者,例如加入预填充计算来决定如何让请求长度大致均匀以提高利用率,但这些做法总是要付出权衡的代价。另一种做法是把预填充和解码阶段完全分开,但如果优先解码阶段,预填充就得等待,导致首 token 时间很长;反过来,如果优先预填充,解码阶段就被迫等待,token 间延迟会变慢,同时内存带宽又得不到充分利用。
第一步:在相同硬件上分离预填充与解码
最直接的解决方案是实施分离式服务:把预填充请求和解码请求路由到不同的计算单元,先解决相互干扰的问题,让性能更容易推断。这样做的好处是能更好地管理服务等级协议(SLA),这类协议往往关注某一水平的每用户每秒 token 数。不过也有几个问题。这种完全分离似乎只在特定的输入/输出序列长度比下,以及解码长度较长时才有出色的效果,其他场景的收益并不理想。此外,这种分离仍然存在“规格不匹配”的问题:纯预填充操作几乎总是严重低利用内存带宽。
在下面的示意性例子中,我们展示了 R200 在仅用于预填充时,几乎用不到多少内存带宽。随着序列长度增加、对可用 FLOPS 的利用更加充分,内存带宽利用率变得越来越低,相当于白白浪费了非常昂贵的 HBM 内存。
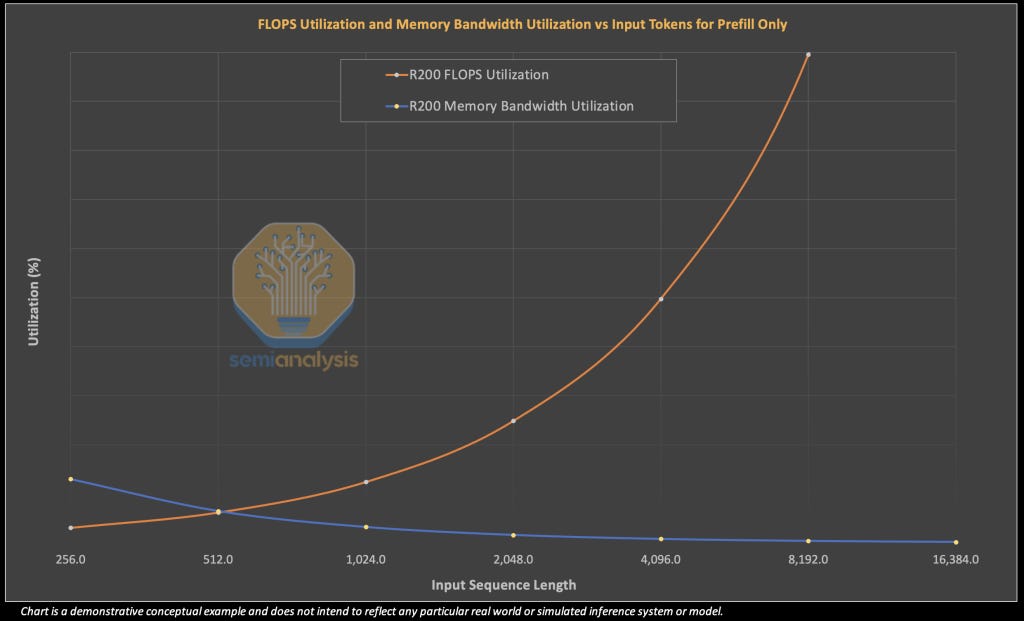
下一步:在专用硬件上分离预填充与解码,Rubin CPX 登场
既然预填充天生会让内存带宽资源利用不足,减少浪费的一种办法就是降低内存的数量和成本。这正是 Rubin CPX 采用的做法:使用数量更少、价格更低的 GDDR7 内存。
在下面的示意性例子中,我们展示了 R200 在仅用于预填充时几乎用不到多少内存带宽。相比之下,Rubin CPX 在相当短的输入长度下,实际利用了更高比例的内存带宽,随后在我们认为典型的输入长度下降得更低。
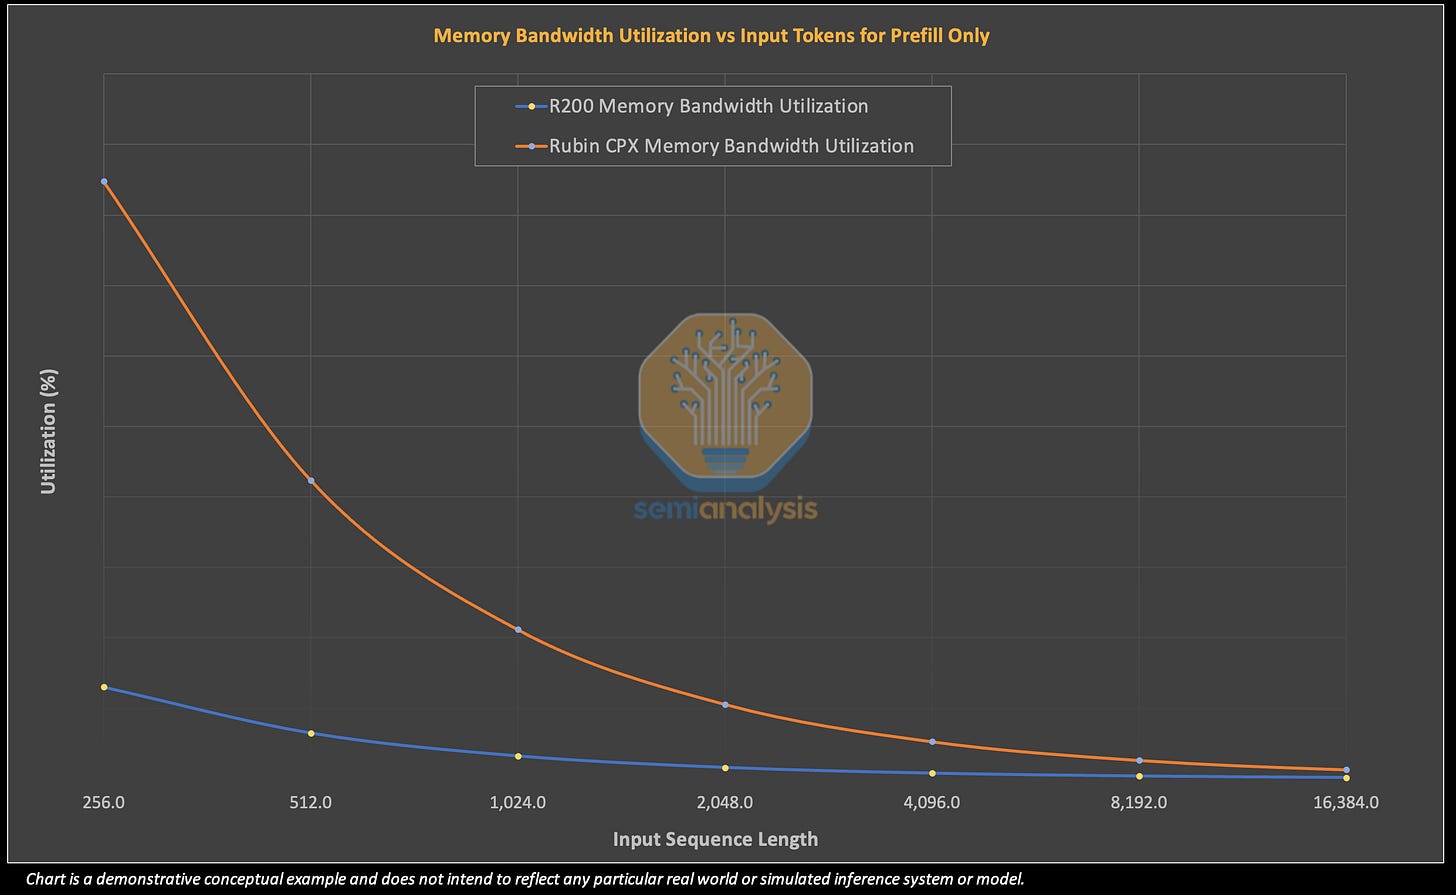
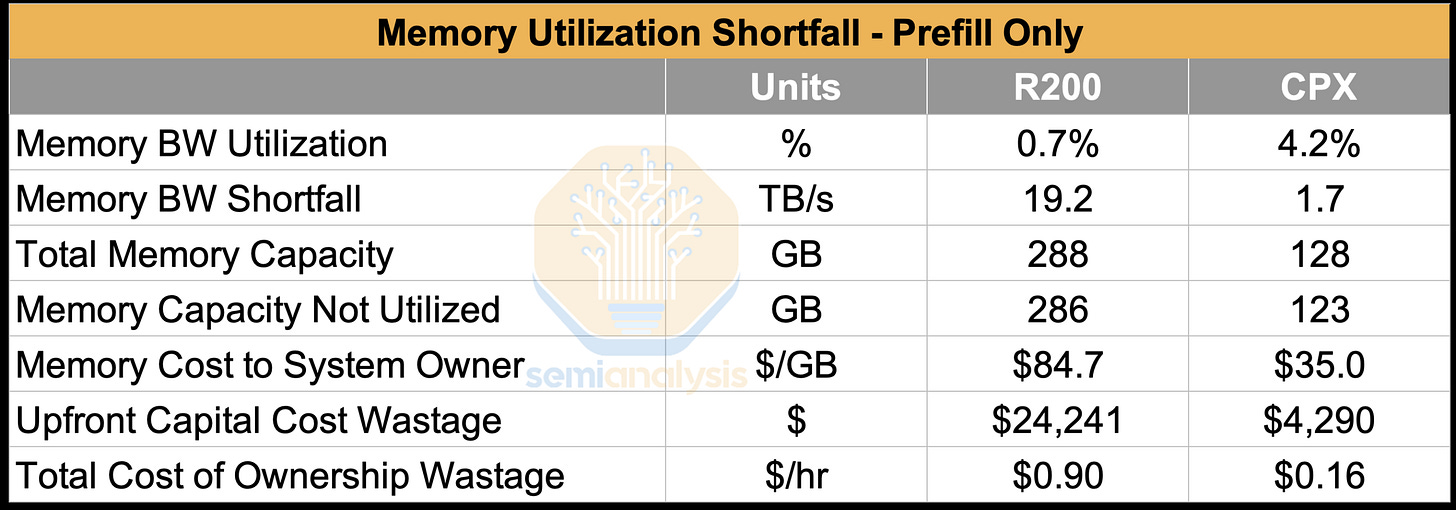
确实,我们要强调,这并不是为了效率而追求效率,它对利润有巨大影响!在下表中,我们给出一个例子,比较 R200 GPU 和 Rubin CPX GPU 的内存带宽利用率。在这个场景中,两者的内存带宽利用率都很低,但区别在于 Rubin CPX GPU 至少只是闲置了数量更少、便宜得多的内存。对于 R200,运行与 CPX 完全相同的预填充工作负载,会造成每小时 0.90 美元的总拥有成本(TCO)浪费!
Rubin CPX 带来了更大的内存容量,但这些比特是“低质量”的,因为它们是 GDDR7,按每 GB 计算,成本不到 HBM 的一半。从内存厂商的角度看,GDDR7 的利润较低,因为它技术要求较低、竞争也更多(例如 Samsung 就能供货)。
这意味着 CPX 系统的使用会降低 HBM 在系统总价值中的占比。与同样花在独立 VR200 NVL144 机架上的一美元相比,花在 VR200 NVL144 CPX 或 VR CPX 机架上的每一美元里,用于 HBM 的比例更低。在其他条件相同的情况下,假定 AI 系统的支出金额固定,每花一美元所对应的 HBM 需求将会下降。
为什么不进一步削减内存?
许多读者无疑对少花钱买 HBM 的想法垂涎三尺,并在想:为什么不把系统里的内存再削减得更多?如果典型的预填充序列长度意味着内存利用率只有低位两位数甚至个位数,为什么不把内存容量缩小到原来的 1/10th?这是否意味着 HBM 乃至整个内存需求的末日?
然而,技术上的事情没那么简单。Rubin CPX 所做的是降低预填充和 token 的成本。token 成本降低会刺激需求,这意味着对解码的需求也会增加。与许多压低成本的其他技术创新一样,需求的增长通常会超过成本的下降,最终使总的市场规模以美元计更大。
GDDR7 的这一需求还会带来额外的供应链影响。RTX Pro 6000 同样使用 GDDR7,但速度较低,为 28Gbps。Nvidia 已为 RTX Pro SKU 下了大量供应链订单,最初的计划是在 H20 的出口许可重新发放之前,向中国销售这款芯片作为 H20 的替代品。这些订单主要下给了 Samsung,因为只有它有产能满足这些突如其来的急单。SK Hynix 和 Micron 则无法满足这一需求,因为它们的晶圆产能被 HBM 订单等业务占用。由于 Samsung 能提供有竞争力的 GDDR7,它同样可能从 Rubin CPX 中受益。
再谈预填充流水线并行:Rubin CPX 分离式预填充的一个有趣优势
上一节我们概述了 Rubin CPX 如何减少内存浪费,而 Rubin CPX 放弃使用 NVLink 这类速度极快的纵向扩展(scale-up)网络方案,是另一大节省。Rubin CPX 的片外 I/O 限于 16 条 PCIe Gen6 通道,单向带宽约为 1Tbit/s,而 R200 的 NVLink 为 14.4Tbit/s。这样的 I/O 足以执行预填充,即使面对现代 MoE 前沿 LLM 也是如此。
例如,DeepSeek V3 以 NVFP4 数字格式运行时,加载全部模型权重需要 335GB 内存容量,超出了单颗 CPX 芯片 128GB 的内存容量。这可以通过流水线并行(pipeline parallelism,简称“PP”)来解决,即把模型的多个层拆分到不同的 GPU 上。在 PP 中,每个 GPU 依次处理 token,并把激活值沿流水线向下传递。
PP 的缺点是 token 要依次经过许多 GPU,层间通信会带来延迟。一个重要的含义是:PP 往往比专家并行(Expert Parallelism,EP)提供更高的单 GPU token 吞吐量,但代价是 PP 的首 token 时间(TTFT)比 EP 更高。PP 的每 GPU 每秒 token 吞吐量更高,是因为 EP 的通信开销很大,需要全对全(all-to-all)集合操作,而 PP 只是简单的发送和接收操作。
因此,对于流水线并行推理,更简单的通信需求意味着预填充几乎永远不会占满通信链路,也就无需配置昂贵的高速纵向扩展网络。和 HBM 一样,这是又一个可以省钱的地方:剥离在纯预填充操作中闲置的又一层设备,为系统所有者省下白白浪费的 TCO 美元。
在下表中我们看到,DeepSeek 的预填充若采用 PP8 或 PP4 并行方案,每个 token 的消息大小为 7kB。如果让消息把 PCIe Gen6 x16 通道的 I/O 完全占满,这意味着我们最多能传输(因而也就是处理)每秒 1830 万个 token。这就是通信上限。
再看计算上限的情形:预填充每个 token 的计算量为 0.074 TFLOP。因此,用 Rubin CPX 的稠密 FP4 吞吐量 19,800 PFLOPS 除以 0.074 TFLOP,得出的最大 token 吞吐量为每秒 26.76 万个 token。
这远低于通信上限,甚至连相当普通的 PCIe Gen6 I/O 都远未占满,更不用说带宽超过 16 条 PCIe Gen6 通道 14 倍的 NVLink。
我们估计,终端系统所有者承担的 NVLink 纵向扩展总成本(包括 NVSwitch 和背板)约为每 GPU 约 8,000 美元,略高于每 GPU 集群总成本的 10%。这是 Rubin CPX 为最终用户带来可观节省的另一个维度。
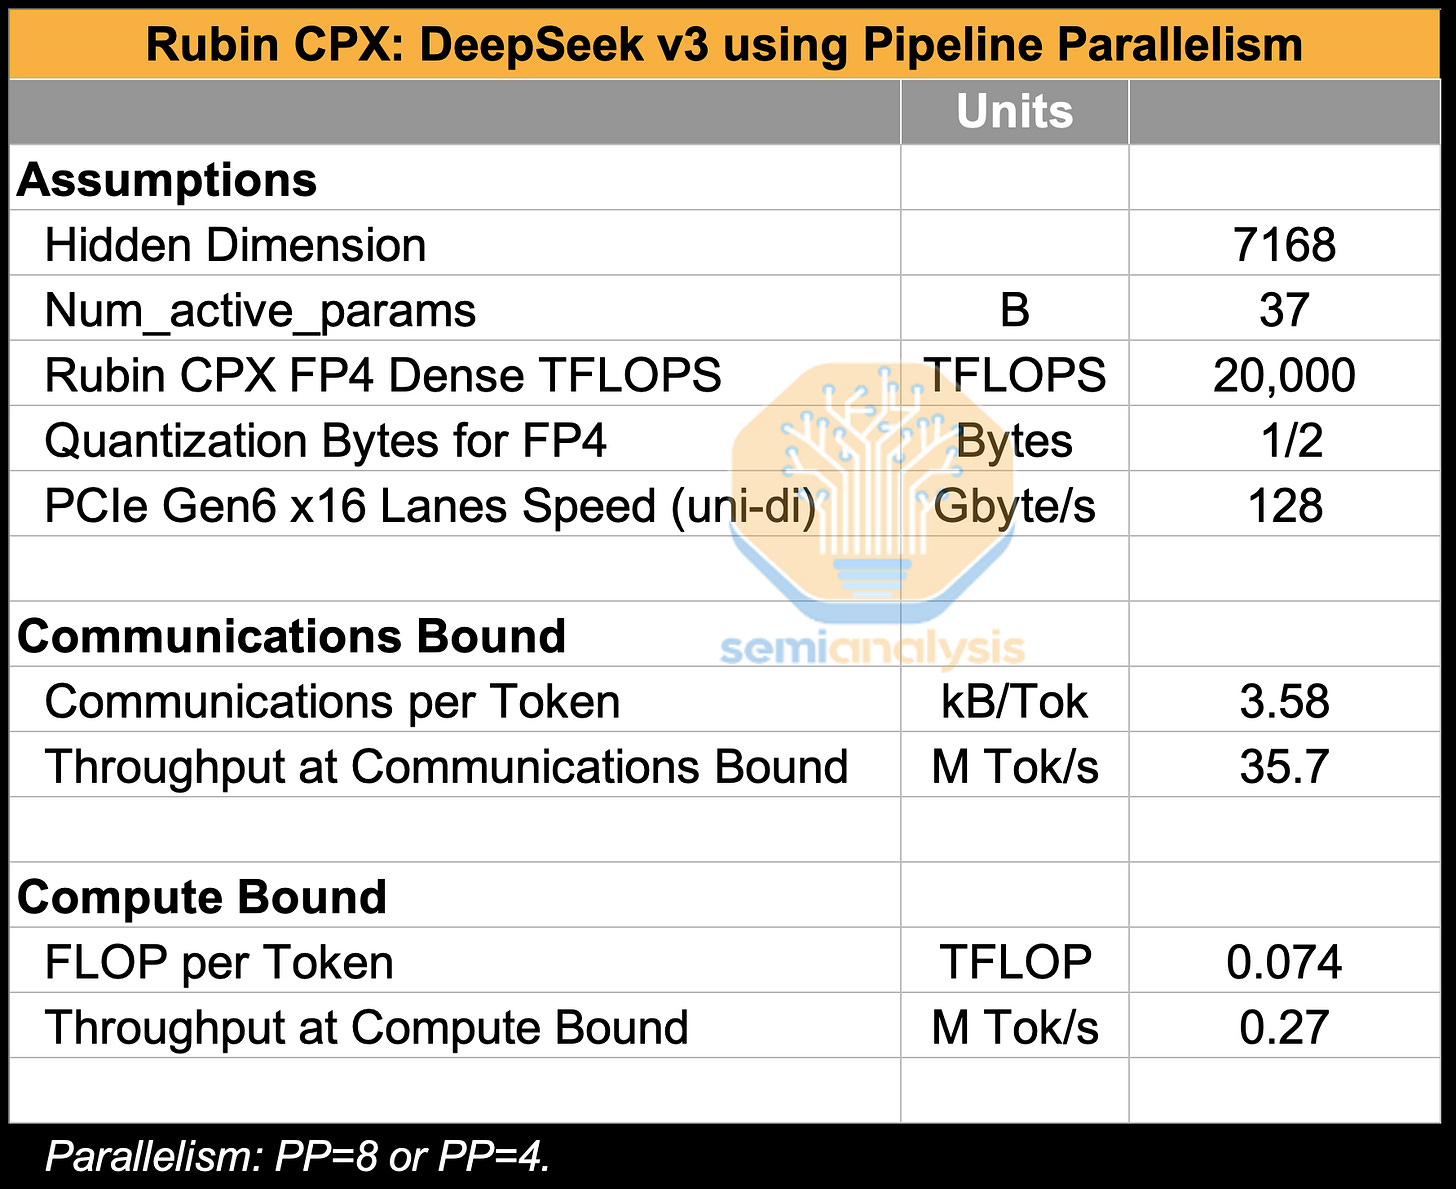
然而,如果试图在较低速度的网络连接上使用专家并行,就会导致延迟问题和瓶颈。通信需求随 top_k 与层数的乘积而扩大。DeepSeek V3 的 top_k 为 8,有 61 层,因此粗略估算表明,使用 EP 而非 PP 会使通信需求增加约 488 倍。
关于扩展与黄氏定律的又一点
今天的讨论聚焦于使用 NVFP4 数字格式的推理指标。确实,推理服务商一直在通过采用越来越低精度的数字格式来释放更多吞吐量。然而,一旦到了 FP4,可榨取的空间就所剩无几了。
稀疏性被当作另一个可以继续释放更多吞吐量的杠杆,这也是大多数营销规格和演示文稿都以稀疏 TFLOPS 来表述的主要原因。然而,稀疏性尚未真正兑现所承诺的收益,远未达到它所承诺的 2 倍提升。
今天的发布会还公布了 Rubin 的稀疏性。这种稀疏方案不同于 Hopper 和 Ampere 所用的 2:4 结构化稀疏,也不同于 Blackwell 的 4:8 成对结构化稀疏。我们希望 Rubin 稀疏性能带来有意义的吞吐量收益,让黄氏定律继续保持下去!
硬件专用化的分离式服务的缺点
预填充专用芯片的出现固然令人兴奋,但我们还没有到达涅槃之境,硬件专用化的分离式服务也有其缺点。随着服务商的工作负载和模型发生变化,能够调整预填充与解码实例的比例(PD 比)至关重要。
定制芯片现在怎么办?
最优的 PD 比对许多因素都很敏感,包括模型架构、SLA、网络带宽等。然而,Vera Rubin NVL144 CPX 的一个关键缺点是,Rubin 与 Rubin CPX 芯片的数量和比例是固定的,因此一旦想要改变 PD 比,灵活性就较差。
Nvidia 在芯片演进上的敏捷,正在迅速改变其竞争对手所处的格局。每当竞争对手在性能或架构上逼近与 Nvidia 持平的距离时,Nvidia 就沿着另一个维度演进其产品。下面我们来讨论 Rubin CPX GPU 的广泛采用会如何影响各竞争方案。
Google TPU
TPU 的 3D Torus 纵向扩展网络具有独特的优势,最大 pod 规模可达 9,216 颗 TPU。这是业内最大的 world size,而每个加速器的纵向扩展网络成本却是最低的之一。这使得它可以支持非常广泛的并行方案,是其他较小 world size 可能无法支持的。
话虽如此,Google 最理想的做法是开发一款仅用于预填充的芯片,以继续保持其内部工作负载的每美元性能优势。他们拥有足够的内部工作负载来产生基础需求,为预填充专用芯片的开发提供启动和资金支持,这款芯片之后也可以对外销售。
Google 独特的拓扑意味着,在某些推理系统配置和模型上,其性能甚至可能超过某些 Nvidia 系统。
AWS Trainium3 Max NVL72、AWS EFA 网卡与 Meta MTIAv4 SUE72
拥有内部工作负载、但所追求的设计是模仿 NVL72 机架形态的服务商,构成另一类。这些服务商同样有内部工作负载来启动预填充专用芯片的开发,而为了与 Nvidia 的 VR200 NVL144 CPX 保持同等水平,这样做对它们来说是理想之选。
例如,与 Trainium3 Teton-3 Max NL72(具有 72 个逻辑 GPU,纵向扩展规模采用与 VR200 NVL144 相同的全对全交换)配套使用的预填充专用芯片,可以借助 Anthropic 的需求来共同设计,并推动其推理工作负载采用。
AWS 的 VR 144 CPX 将面临重大的上市时间挑战,因为他们的 1U 计算托盘已经高度集成,塞满了 4 个大型 Rubin GPU 封装和 8 个 CPX GPU 封装,没有空间再把 AWS 自研的 EFA 网卡放进计算托盘。Amazon 不想使用 ConnectX-9。AWS 热爱 EFA!
我们认为他们会继续使用 EFA,并通过把 EFA 网卡拆分到一个仅含 EFA 网卡的侧挂(sidecar)机架来克服这一挑战,使用外部 PCIe AEC 线缆连接 VR 144 CPX 机架与仅含 EFA 网卡的侧挂机架。此外,由于他们不会使用集成了 PCIe 交换机的 ConnectX-9 网卡,还需要使用 Astera Labs 的专用 PCIe 交换机,来连接 Vera CPU、本地 NVMe、Rubin CPX GPU,以及通往侧挂机架中 EFA 网卡的外部 PCIe AEC 线缆。
MTIAv4 的 SUE72 设计(具有 72 个逻辑 GPU,纵向扩展规模采用与 VR200 NVL144 相同的全对全交换)同样可以借助 Meta 内部的推理工作负载。甚至 OpenAI 与 Broadcom 合作的芯片等新兴设计也有望参与竞争,因为它们会针对前沿模型来共同设计,并有内部工作负载兜底。
尽管同样享有内部需求的好处,MTIAv3 因其仅有 16 个 GPU 的 world size 太小而被排除在这一类别之外。它现在实际上需要开发预填充专用芯片,才有可能与即将推出的 Nvidia 系统持平。
AMD MI400 系列 UALoE72 与 MI500 UAL256
然而,随着 Rubin CPX GPU 的推出,AMD 的追赶策略现在看起来既不够快也不够激进,AMD 将再次发现自己在追赶 Nvidia。AMD 本来即将凭借机架级的 MI400 追上,但 Nvidia 抬高了门槛。
AMD 与上述服务商的关键区别在于,AMD 缺乏足够强的内部工作负载,无法为又一个仅为跟上对手而启动的芯片开发项目提供收入和需求兜底。
AMD 今年早些时候在其 Advancing AI 活动上引起轰动,推出了 MI400 72 GPU 机架级系统。我们当时的分析指出,相对于 FP4 FLOPS,MI400 可以提供比 VR200 NVL144 系统更低的总拥有成本,同时提供 19.8TB/s 的内存带宽,而 VR200 NVL144 最初宣传的内存带宽为 13.0 TB/s。
Nvidia 的 VR200 NVL144 现在宣传每个逻辑 GPU 的内存带宽约为 20.5TB/s,方法是向供应商要求速度等级高得多的产品。VR200 的内存带宽现已追平 AMD MI400,且 HBM 站点更少。
如果 MI400 的 FP4 有效稠密 FLOPS(即微基准测试实际能交付的性能,而非宣传的吞吐量)与 VR200 NVL144 相当或更低,AMD 实际上就是比 Nvidia 更晚地推出了 VR200 NVL144 的翻版。与此同时,Nvidia 将再次拉开差距,因为在长上下文长度下,VR200 CPX NVL144 的每 TCO 性能更好。AMD 随后将不得不再等到 2027 年才能追上。
然而,我们认为 AMD 仍处于战时状态,现在除了开发机架级系统、改进软件之外,还需要另开一条战线来打预填充专用芯片这场仗,才有机会在 2027 年前追上 Nvidia。
Nvidia
最后,为什么 Nvidia 只做预填充专用芯片就止步了,为什么不也做一款解码专用芯片呢?Nvidia 迄今只推出了预填充专用芯片,解码步骤仍然由现有的 R200 芯片承担,而没有解码专用的 SKU。
解码专用芯片将与预填充芯片相反:计算精简,内存带宽充沛。这款芯片看起来会像 R200,但不需要那么多计算。理想情况下,通过保持 I/O 小芯片(chiplet)的尺寸,内存和封装外 I/O 都能得以保留,而主计算裸片朝向 I/O 裸片的边可以缩短,同时保持每条边容纳 2 个 HBM 站点的边长。结果是一颗小得多的计算裸片。
还可以通过以下方式进一步节省成本:大量屏蔽 SM 功能,从而显著提高参数良率;以及降低 TDP,从而降低供电和热管理相关的成本。这与预填充芯片的情形正好相反:预填充芯片保留了 HBM 的用量,同时削减系统的其他部分,使 HBM 在 BOM 中的占比重新升高。