概述
Together AI 平台上的专用模型推理(Dedicated Model Inference)由三部分组成:端点(endpoint)(你或你的客户端调用的稳定名称)、部署(deployments)(在端点背后运行副本的具体“模型 + 硬件”组合)以及配置(configs)(描述模型如何运行的方案)。一套感知容量的流量拆分机制把这三类实体串联起来。这一架构使滚动发布、A/B 测试、影子实验、零停机变更等多种功能成为可能。下面我们将在一个有实测流量的线上端点上,演示感知容量的路由是如何工作的。
资源模型如何运作
- 配置(config)是一份方案,指定引擎、GPU 类型和数量,以及并行方式和优化档位(吞吐量、延迟、均衡)。配置是不可变的,每个配置都有形如
cr_...的 ID。你的部署始终指向经过测试的那个确切配置。 - 部署(deployment)把一个模型(指定版本)绑定到一个配置,赋予它自动扩缩容策略,并运行副本。部署被有意设计为可随时丢弃的,创建和销毁都应视为日常操作。
- 端点(endpoint)是一个固定的身份标识:一个限定名称(
<project_slug>/<endpoint_name>),你的应用在常规推理 API 中将它作为model参数传入。端点带有一个流量拆分(traffic split),用来决定请求如何在其各个部署之间路由。
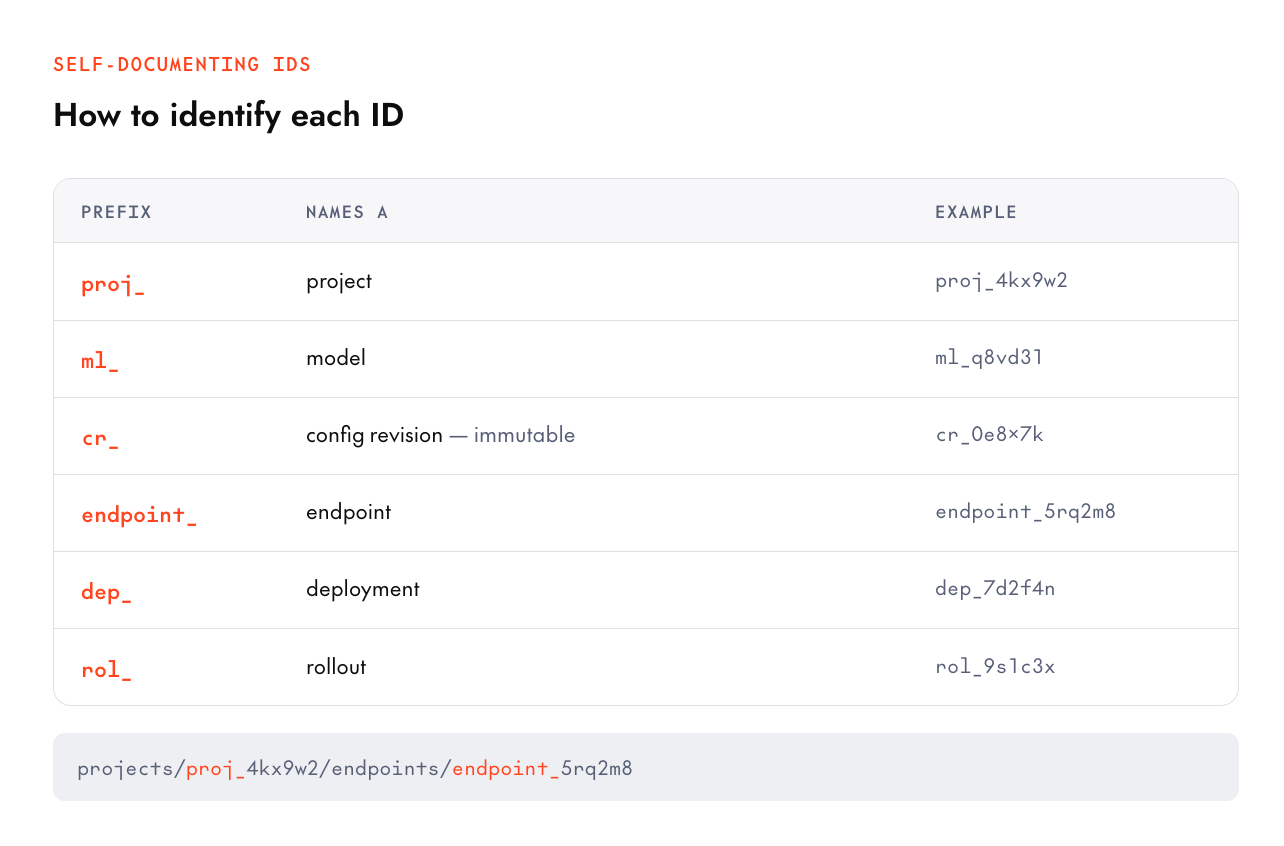
理解这一点有个简单的办法,就是看 ID:系统中的每个 ID 都通过前缀表明自己是什么,这让日志和脚本具备自描述性:proj_(项目)、ml_(模型)、cr_(配置修订版)、endpoint_、dep_(部署)、rol_(滚动发布)。
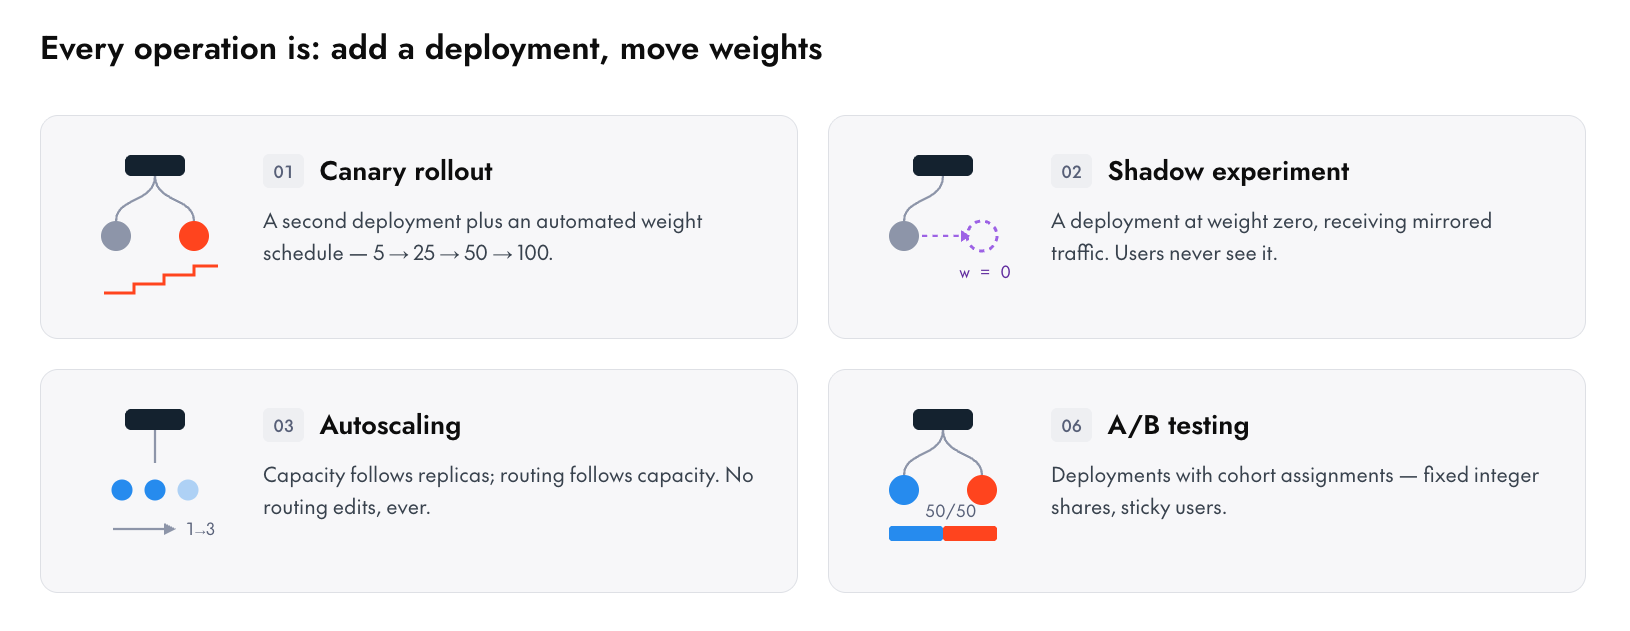
平台上的每一项高级操作,本质上都是“添加一个部署,并为它分配一个流量路由权重”。A/B 测试就是带有分组分配的若干部署。影子实验就是权重为零、接收镜像流量的部署。停止一个部署,就是把最小和最大副本数限定为 0/0。
基于权重的流量拆分
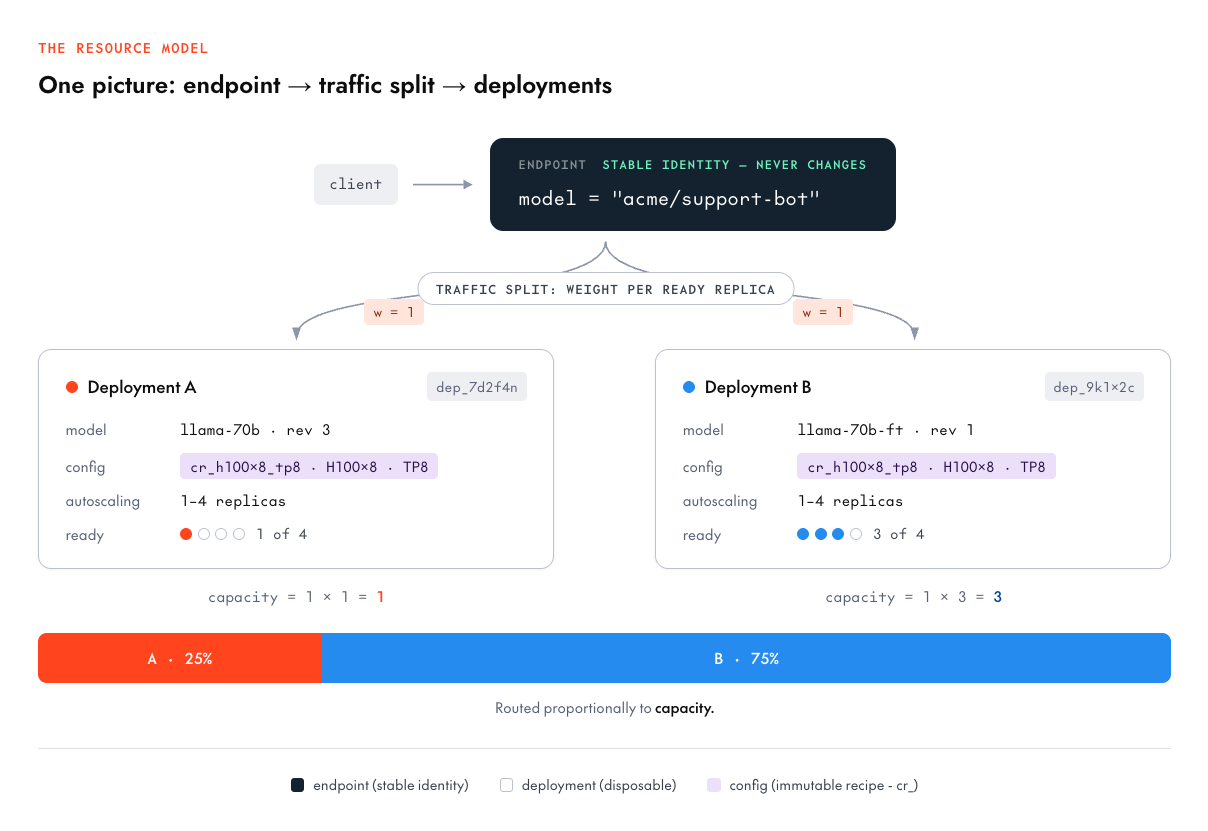
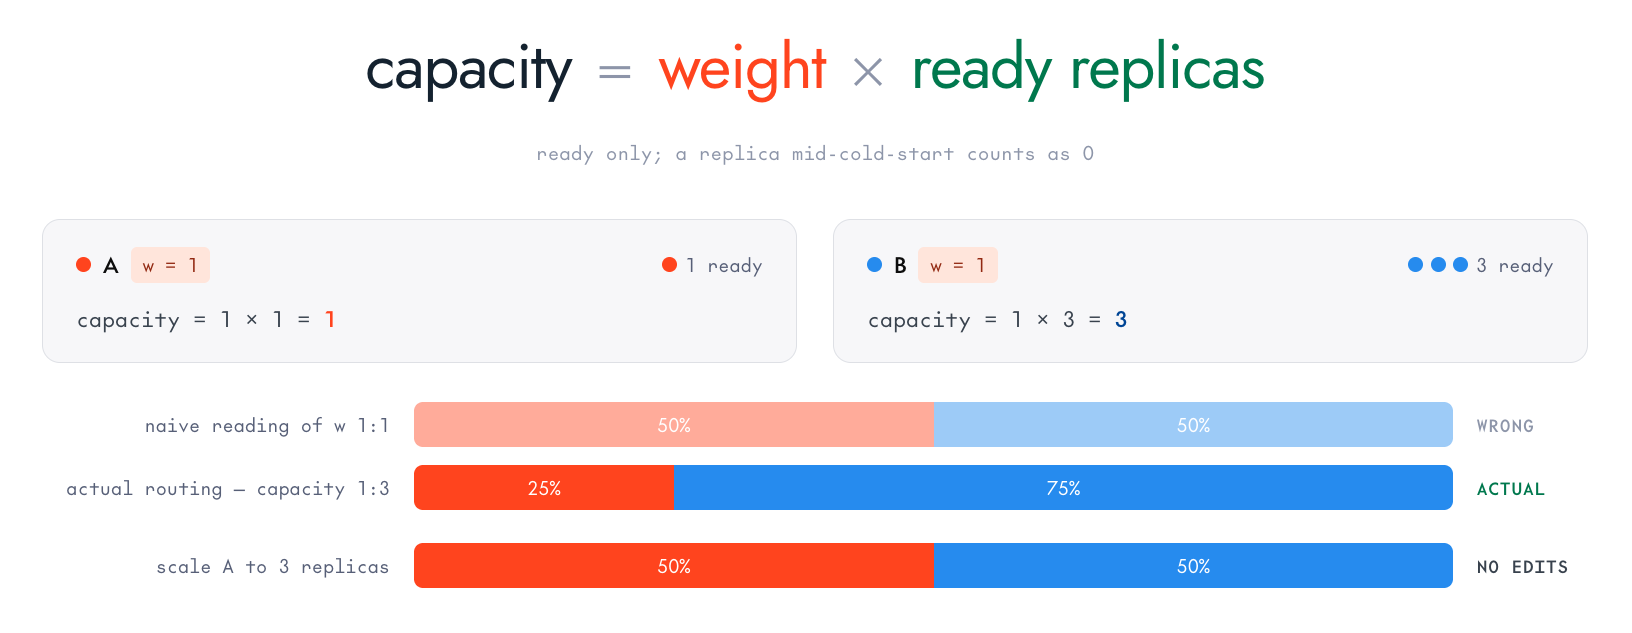
流量拆分是一组 {deployment_id, weight} 条目,其中权重是按就绪副本计算的**.** 路由器把每个部署的有效容量计算为 weight × ready_replicas,并按该容量成比例地路由。
看上面的示意图:两个部署的权重都是 1,但部署 A 有 1 个就绪副本(容量为 1),部署 B 有 3 个(容量为 3),因此流量按 25%/75% 拆分。权重相等意味着每个副本的负载相等,而不是流量份额相等。
我们这样设计,是因为它让路由和扩缩容成了同一件事:
- 自动扩缩容天然可以组合。当部署 A 从 1 个副本扩到 3 个时,它的容量变为三倍,自动按比例吸收更多流量。若使用朴素的百分比,固定在“25%”的部署在缩容时会过载,扩容时又会闲置。
- 你控制的是每个副本的负载。权重 1 对权重 2,意思是“B 的每个副本应当比 A 的每个副本多干一倍的活”。
- 未就绪的副本不计入。处于冷启动中、或降级到 0 个就绪副本的部署,贡献的容量为零,因此流量会流向真正能提供服务的部署。
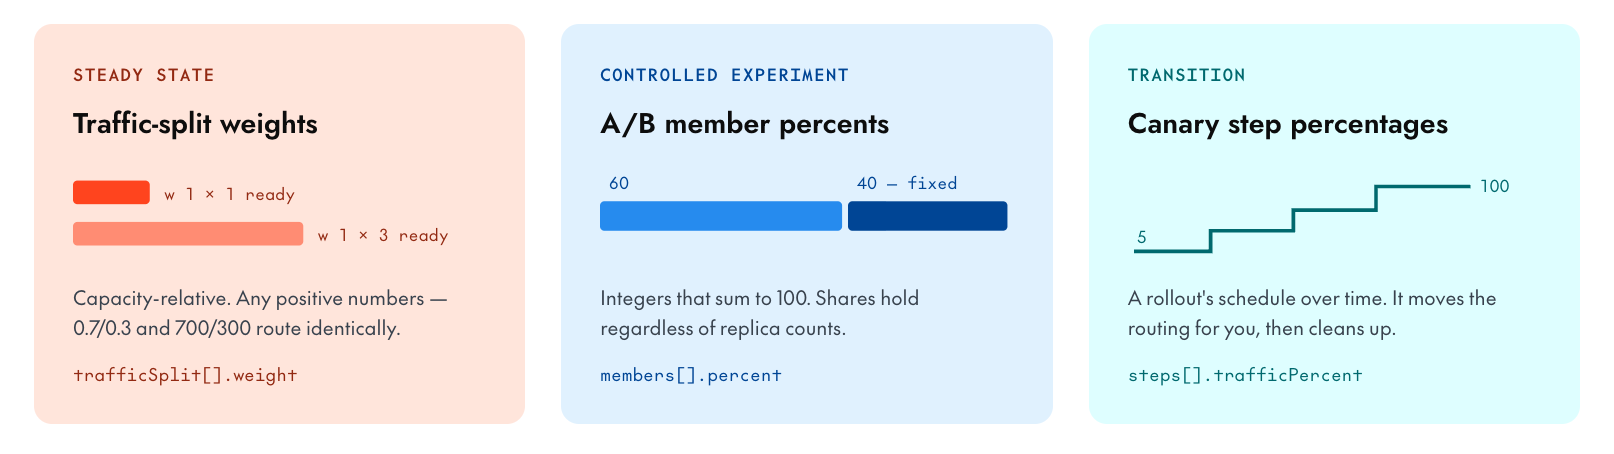
权重是正数,没有总和约束,所以 0.7/0.3 和 700/300 描述的是完全相同的路由。如果你希望无论副本数多少都保持固定的流量份额,可以设置 A/B 实验分组,它允许使用总和为 100% 的整数百分比。
设置流量拆分只需一次带字段掩码的 PATCH:
      tg beta endpoints update $DEPLOYMENT_A --traffic-weight 1
tg beta endpoints update $DEPLOYMENT_B --traffic-weight 1

# take a deployment out of rotation without scaling it down
tg beta endpoints update $DEPLOYMENT_B --traffic-weight 0
⚠️ Important

A brand-new deployment will not get any traffic until it appears in the endpoint's traffic split. If you create an endpoint and a deployment and have it `READY`, send a request, and get back a `routing_error` it is probably because the traffic split is not specified and the router hasn’t yet been told that this deployment should receive traffic. The CLI's `together beta endpoints deploy` sets the split for you, which is why the quickstart "just works" but the raw-API/SDK path needs this set.
幕后:选择配置
你不需要从零开始编写配置。支持模型目录中的每个模型都附带部署档案(deployment profiles),即我们做过基准测试并持续改进的、经过认证的“模型 + 配置”组合:
      tg beta models public zai-org/GLM-5.2 --json | jq '.data[0].deploymentProfiles[]'

# or, once you have the model ID, list its deployable configs directly:
tg beta models configs ml_CcEtnFUbitJYNja6TTR6U
{
  "profileId": "profile-cabcbcec874c",
  "certifiedConfigRevisionId": "cr_Cd35DNpQuHM3RihtCkN59",
  "certifiedModelRevisionId": "rv_CcEuPu4Gk6c4M7v4PTYuG",
  "gpuType": "NVIDIA-B200",
  "gpuCount": 4,
  "quantization": "FP4",
  "performanceBenchmarks": {},
  "config": "projects/proj_CbdXDuLRFhUPv1mGfxwUc/configs/cr_Cd35DNpQuHM3RihtCkN59",
  "model": "projects/proj_CbdXDuLRFhUPv1mGfxwUc/models/ml_CcEtnFUbitJYNja6TTR6U/revisions/rv_CcEuPu4Gk6c4M7v4PTYuG",
  "parallelism": "TP4"
}
接下来,你可以把模型和配置的资源名称复制到创建部署的请求中:
      tg beta endpoints deploy zai-org/GLM-5.2 \
  --endpoint my-glm-endpoint \
  --config cr_Cd35DNpQuHM3RihtCkN59 \
  --traffic-weight 1
当你在不同配置之间做选择时,选择器会告诉你每个方案优化的是什么:
| 选择器 | 取值 | 它所体现的权衡 | ||
|---|---|---|---|---|
| accelerator_type | H100, H200, B200, … | 成本、显存带宽与可用性之间的权衡 | ||
| accelerator_count | 1, 2, 4, 8 | 容纳模型并为 KV 缓存留出余量 | ||
| optimization | latency / throughput / balanced | 最根本的推理服务权衡(见下文) | ||
| topology | 例如 aggregated/disaggregated | 模型如何在多块 GPU 之间切分 |
optimization 这一维度,是你要花最多时间做取舍的地方。
- 延迟(latency)档位优化的是首词元时间(time-to-first-token):批次更小、调度更积极,每个请求更早得到处理,代价是每块 GPU 的总词元数/秒降低。
- 吞吐量(throughput)档位会把批次打得更大:最大化每 GPU 小时的总词元数,而单个请求需要多等一会儿才能加入批次。如果你在构建交互式聊天,大概会选延迟档位;而离线流水线和批量摘要可以使用吞吐量配置。
- 当你的流量两者兼有时,balanced 是不错的默认选择。
配置之所以不可变,是因为 cr_ 修订版永远不会改变,也就是说,部署的行为不会因为有人在共享配置上“随手改了个参数”而发生漂移。每次变更都是一个新的修订版;旧版本仍然是有效且经过测试的回滚目标。推测解码(speculative decoding)也可以从这里触发,因为草稿模型是配置的一个属性。
边界情况
1. 某个部署在拆分中,但有 0 个就绪副本。
由于容量 = 权重 × 0 = 0,它不会收到流量;其他部署会吸收它的份额。待副本恢复后,流量会自动按比例回流。
2. 可以删除仍在流量拆分中的部署吗?
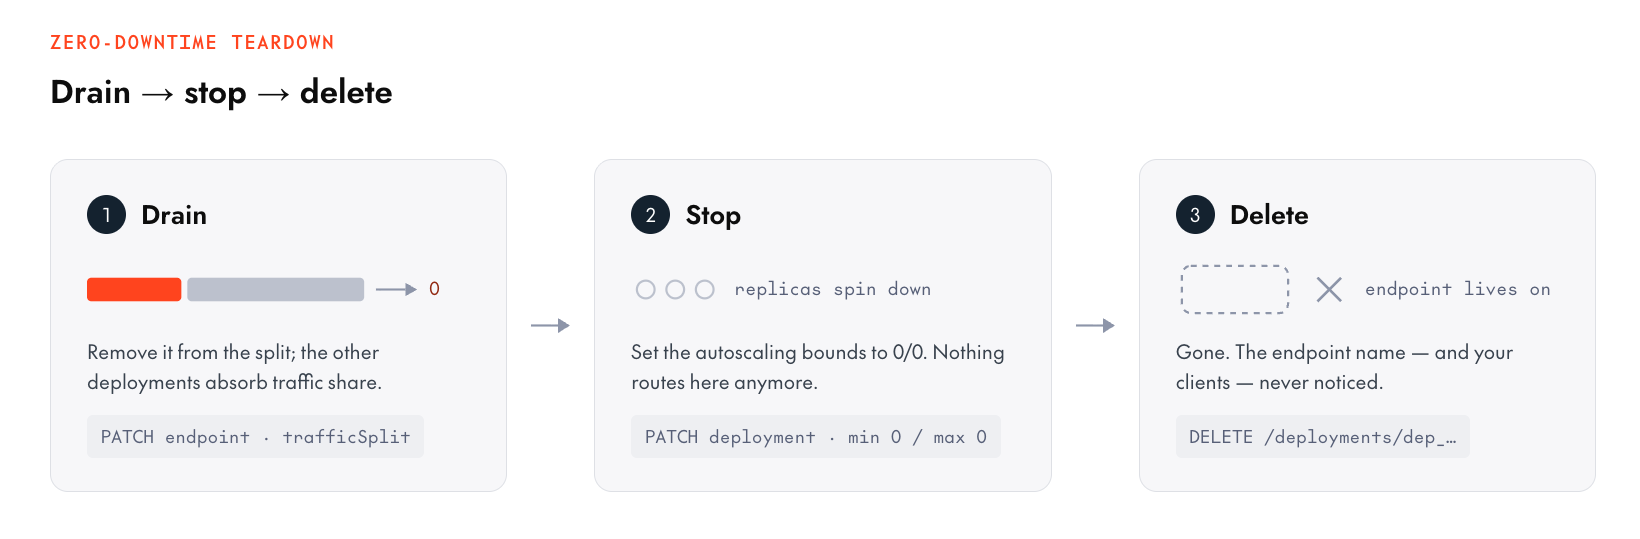
应当先把它从拆分中移除,再删除。下线流程是:排空流量 → 停止 → 删除,API 也会引导你遵循这个顺序。
3. 流量拆分、A/B 成员百分比与金丝雀步进百分比
流量拆分权重(相对容量,用于稳态路由)、A/B 成员百分比(整数分组份额,总和为 100,与副本数无关而固定)和金丝雀步进百分比(滚动发布的过渡计划)。这是针对三种不同工作的三种不同工具,它们按固定顺序组合:路由首先解析权重拆分(按容量抽样出一个候选部署),然后如果该候选是某个 A/B 实验的对照组,则由实验重新抽样(把对照组的份额细分给各分支),接着如果该候选是某个进行中的滚动发布的源部署,则由发布重新抽样(按当前步进百分比在源和目标之间拆分),最后在胜出的部署内部选定一个集群。滚动发布会代你操作它所处的阶段。
4. 我的客户端使用的名称是什么?
形如 <project_slug>/<endpoint_name> 的端点可以作为 model 字符串传入标准推理 API。即使你执行滚动发布、更换硬件、运行 A/B 测试,这个名称也保持不变。
演示感知容量路由的实验
我们在一个线上端点上运行了这个实验,端点有两个单 H100 的部署,用来展示权重模型的流量拆分实际效果。两个部署的权重均为 1,起初各有 1 个就绪副本。我们发送了 599 个带标记的请求,并把每个请求归因到为其提供服务的部署,然后把 A 从 1 个副本扩到 2 个,再发送 599 个请求,部署侧捕获到的路由情况如下:
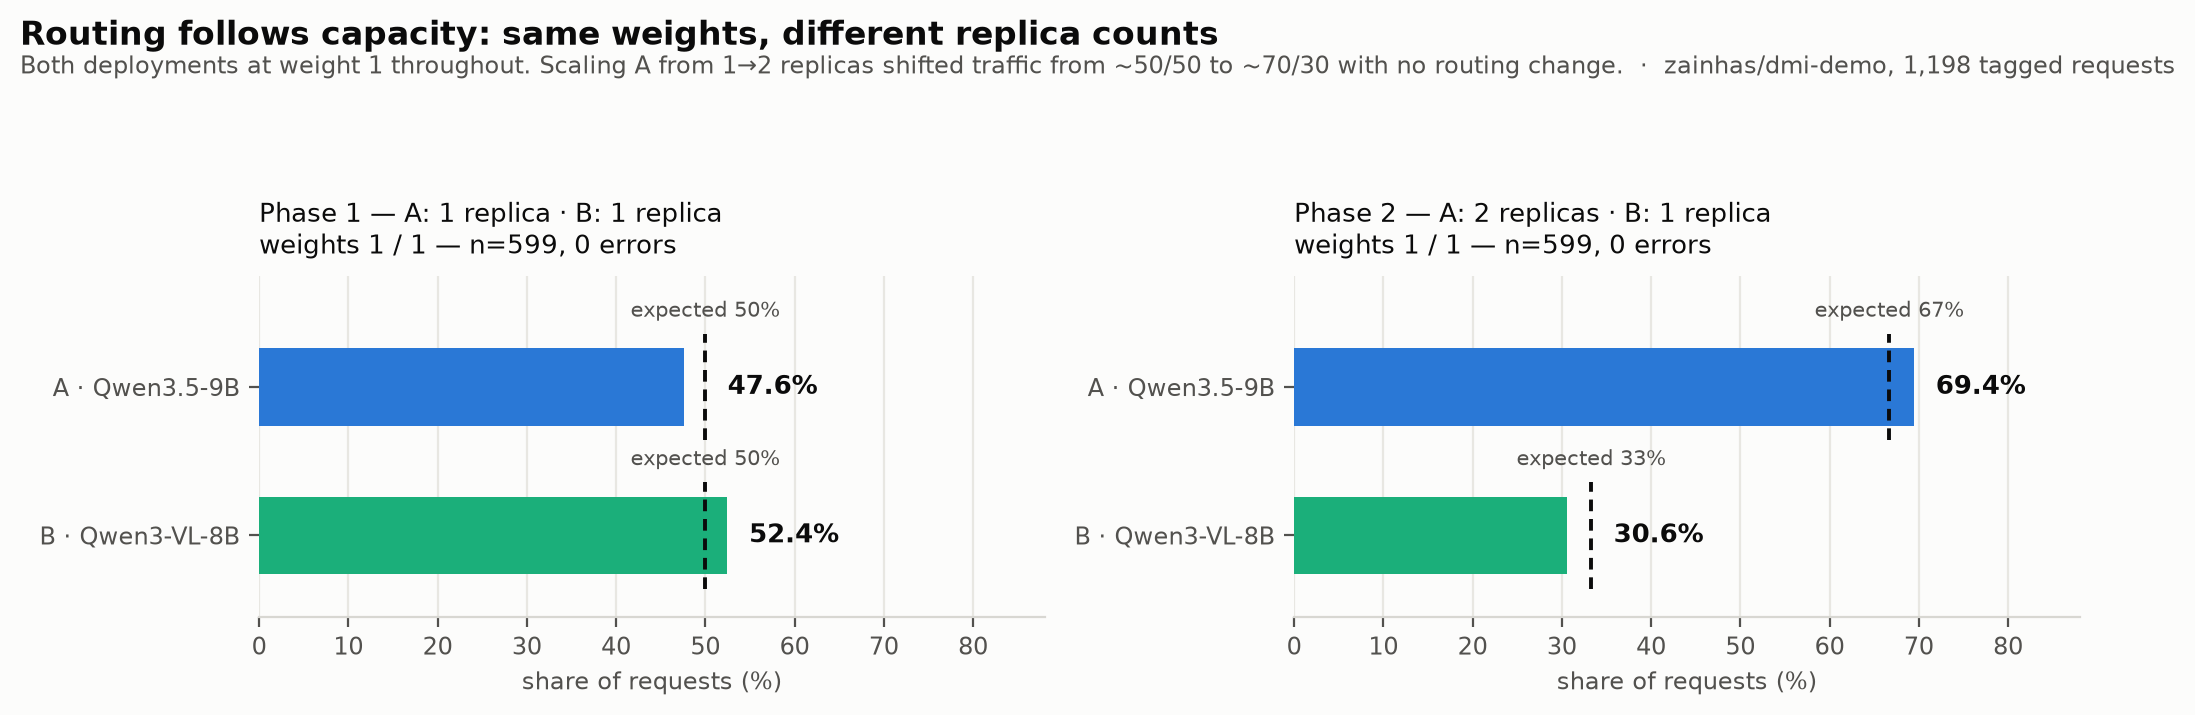
| 阶段 | 副本数(A : B) | 预期份额 | 实测份额 | n |
|---|---|---|---|---|
| 1 | 1 : 1 | 50 / 50 | 47.6 / 52.4 | 599 |
| 2 | 2 : 1 | 66.7 / 33.3 | 69.4 / 30.6 | 599 |
这是因为路由遵循容量,而容量又跟随副本数。在部署 A 内部,它的两个 pod 各自承担了总流量的约 30–40%(39.6% 和 29.9%),也就是说路由器在 pod 之间同样做了均衡。
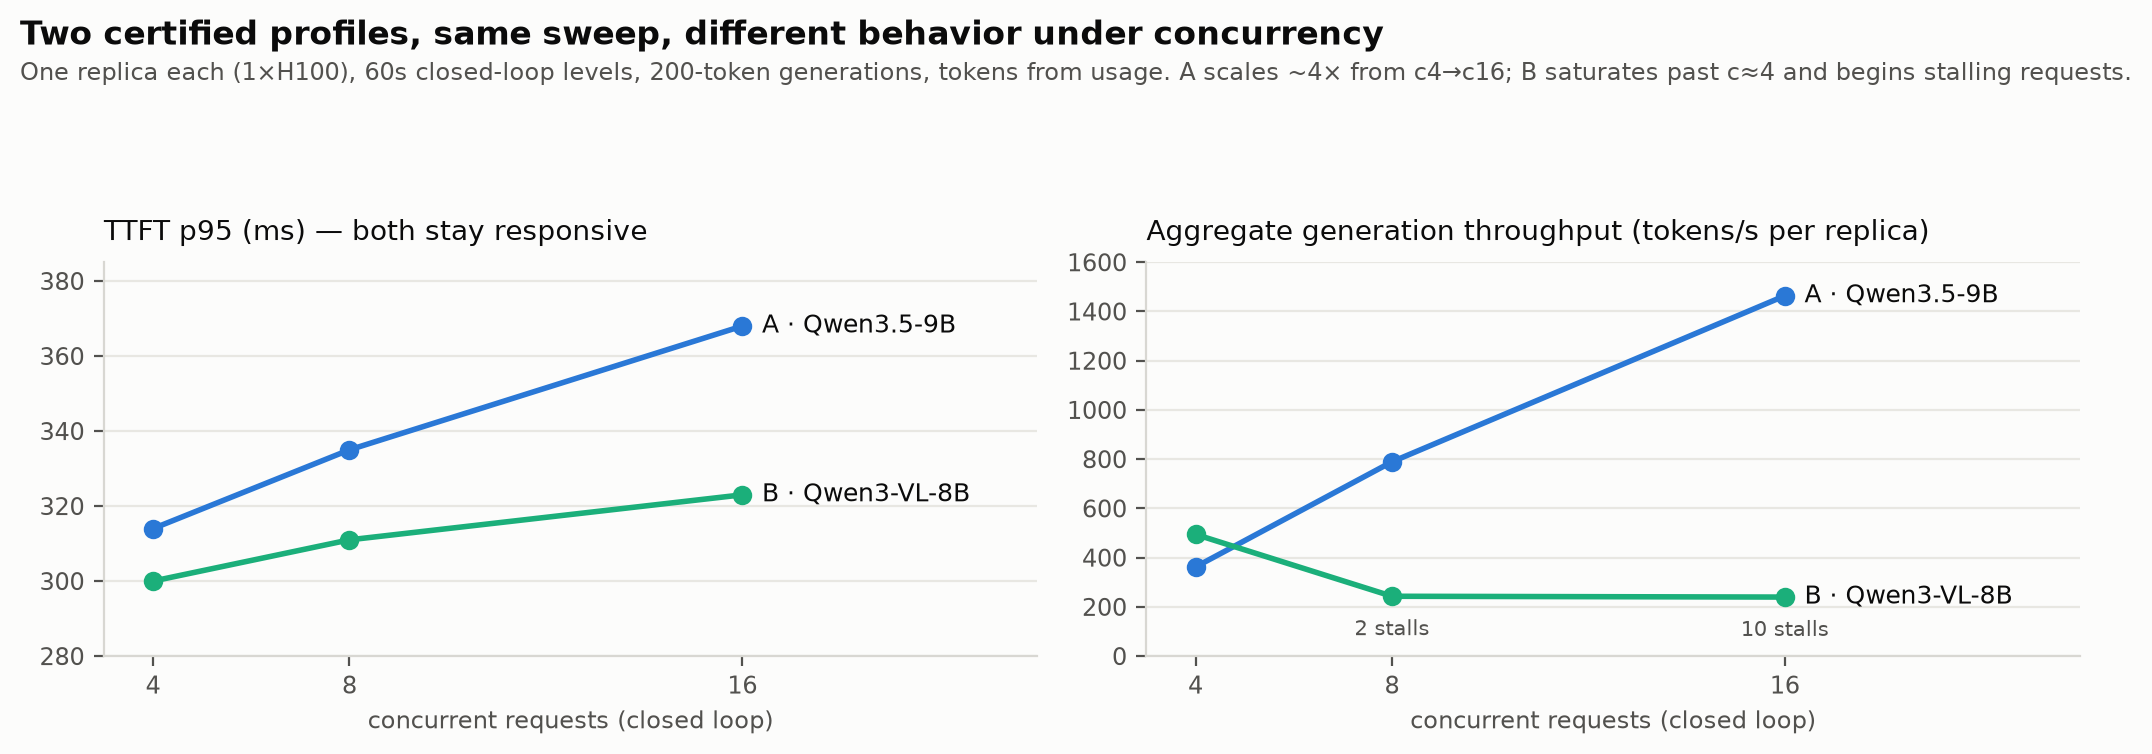
为了让档位的权衡更具体,我们对演示端点上的两个认证档位各用一个副本做了扫描测试:60 秒的闭环压测,并发度分别为 4 / 8 / 16,每次生成 200 个词元,词元数取自 API 自身返回的 usage 字段:
| 档位 | c=4 | c=8 | c=16 | TTFT p95 @ c16 |
|---|---|---|---|---|
| A · Qwen3.5-9B (BF16, TP1) | 362 tok/s | 789 tok/s | 1,464 tok/s | 368 ms |
| B · Qwen3-VL-8B (BF16, TP1) | 495 tok/s | 243 tok/s | 240 tok/s | 323 ms |
这张表就是“必须实测”的全部理由:B 在低并发下胜出,随后急剧退化。A 的批处理表现良好,从 c4 到 c16 吞吐量达到 4 倍,而 TTFT p95 仅上升约 17%。B 在并发 4 时比 A 更快,随后便饱和了:超过 c≈4 之后,它的有效请求速率不再增长,总吞吐量减半,每分钟还有少量请求开始彻底卡住。如果你只在并发 4 下做过压测,就会为高并发工作负载选中 B,并且直到上了生产环境才会发现这种行为。
这两个档位都不是“错的”,它们只是推理服务前沿曲线上的不同点,而你的模型的档位也会有各自的曲线。起始配置为你提供了测试起点的途径;像这样一小时的扫描测试,则能告诉你哪一个适合你的流量。
亲自试一试!
整个模型,五条命令即可:
      # 1. Identity: who am I / what project
tg whoami

# 2. Pick a certified profile for your model
tg beta models public --product dedicated

# 3. One command: endpoint + deployment + traffic split + wait
tg beta endpoints deploy $MODEL --endpoint my-endpoint --traffic-weight 1

# 4. Call it — the qualified name is the model string
resp = client.chat.completions.create(
model="my-project/my-endpoint",   # the endpoint's qualified name IS the model string
messages=[{"role": "user", "content": "Hello!"}],
)

# 5. See what you built
together beta endpoints get $ENDPOINT_ID
从这里开始,本系列的其余内容都只差一个部署。