每个发往 Vercel 的请求都会经过我们的 CDN,CDN 平均每秒执行超过 8000 万条路由指令。其中一部分工作是查找元数据,以确定哪些路径存在以及如何提供服务。当这些元数据未被缓存时,CDN 必须先获取它们,才能返回响应。
过去,我们逐个路径获取并缓存元数据,每次查找只取所需的部分。这在当时看起来很高效,但大型部署可能包含数十万个路径,每个路径都有自己的缓存条目。每次新部署都会产生全新的元数据,使缓存未命中成为频繁部署的大型站点反复承担的成本。
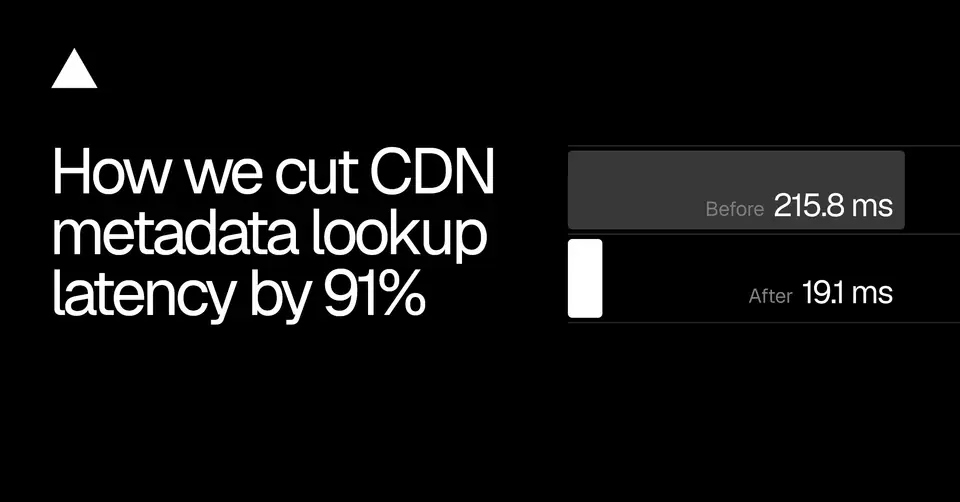
一次获取更多元数据,让这些查找变快了。通过把路径分组,每次获取都能为后续许多次查找填充缓存。但获取得太多也会带来自身的成本。通过生产环境实验,我们找到了一个平衡点,将元数据查找的 P99 延迟降低了 91%,同时让部署也变快了。
CDN 如何找到正确的路由
请求中的路径并不总是与提供服务的内容或函数的路径一致,二者由框架的路由规则连接起来。例如,对 /blog/hello-world 的请求可能会解析到动态路由 /blog/[slug],而对该页面 React Server Component 载荷的请求可能会解析到 /blog/[slug].rsc。CDN 在应用这些规则时,可能需要检查多个目标路径才能找到正确的响应。
框架在构建期间描述这些路由。借助框架定义的基础设施,应用代码会声明哪些输出是静态的、哪些需要 Functions,以及哪些响应可以被缓存或重新生成。框架把这些意图转换为 Build Output API 的输出,Vercel 则生成 CDN 读取的路由元数据。
在请求时,CDN 需要判断哪些目标路径存在,并获取它们的元数据。我们加入全局路由的 Bloom filter 可以排除肯定不存在的路径,其余路径则需要进行精确的元数据查找。
最初,我们为每个目标路径单独存储一个元数据对象,CDN 独立地获取并缓存每个对象。这对部署不频繁的小型项目效果不错。但每次新部署都会产生一组全新的缓存键,因此每个路径的首次查找都会未命中缓存。
分组获取元数据
为了减少缓存未命中,我们把许多路径的元数据分组放进称为分片(shard)的文件里,并限定每个分片的大小,以控制一次查找需要获取的数据量。获取一个分片,就会把其中所有路径的元数据带入缓存,之后对这些路径的查找就可以复用它。
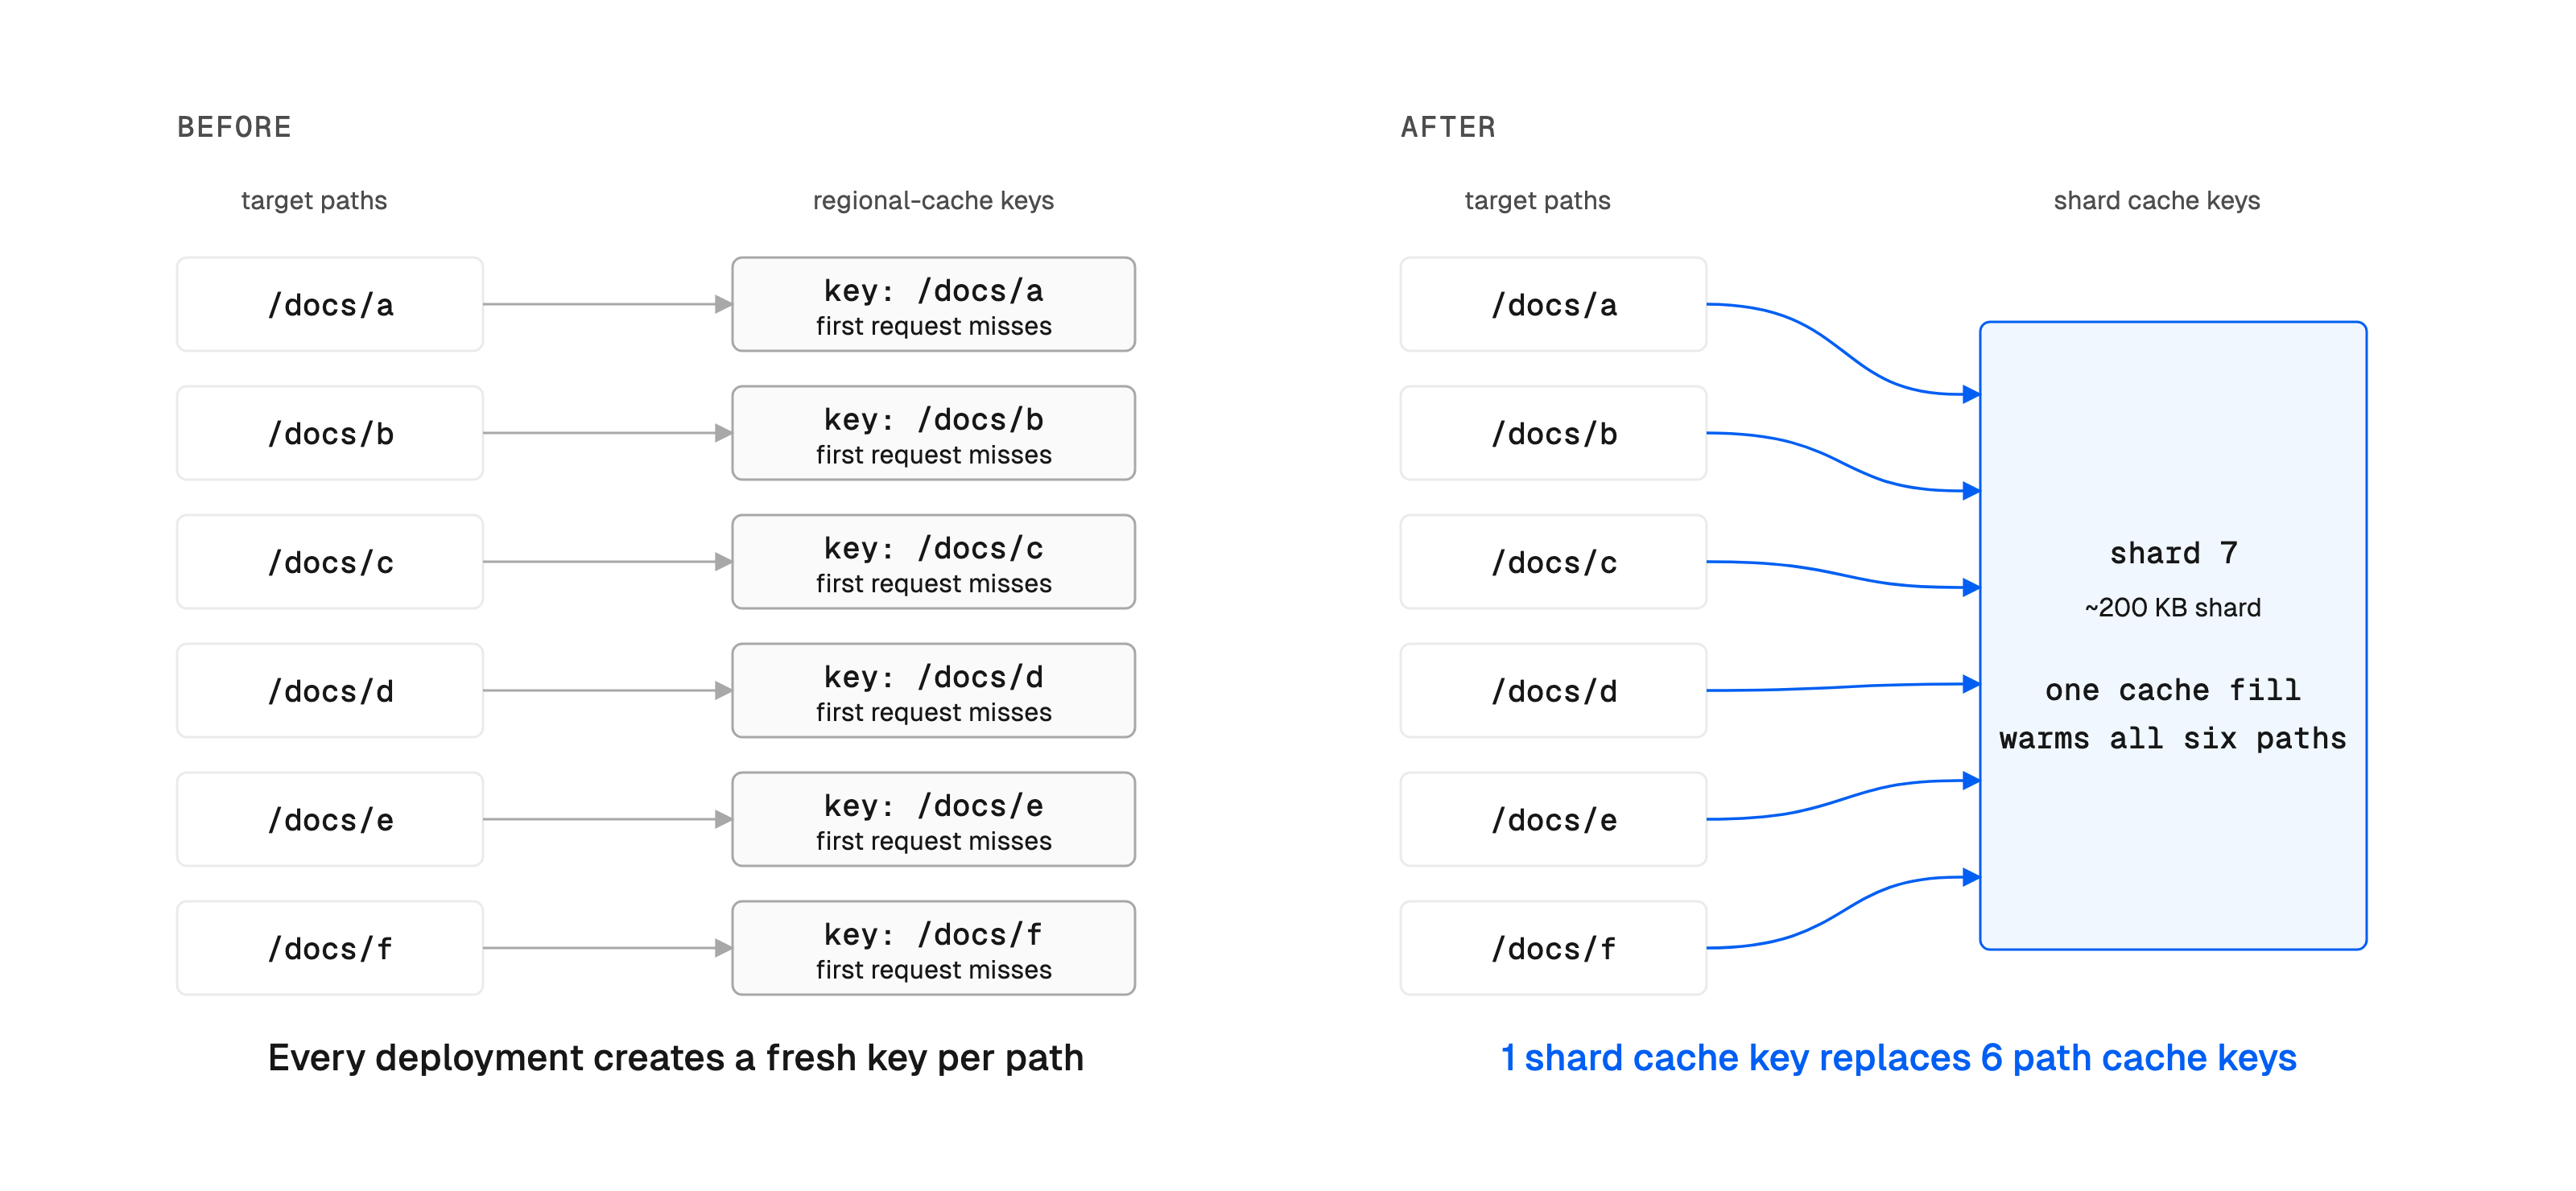
按路径填充缓存只能预热一个路径,而填充一个分片会预热分配给该分片的所有路径。
每个分片还包含一个索引,让 CDN 无需解码、解压或解析其他条目,就能定位单个路径的元数据。每次获取都能预热许多路径,而每次查找仍然只解析它所需的那条记录。
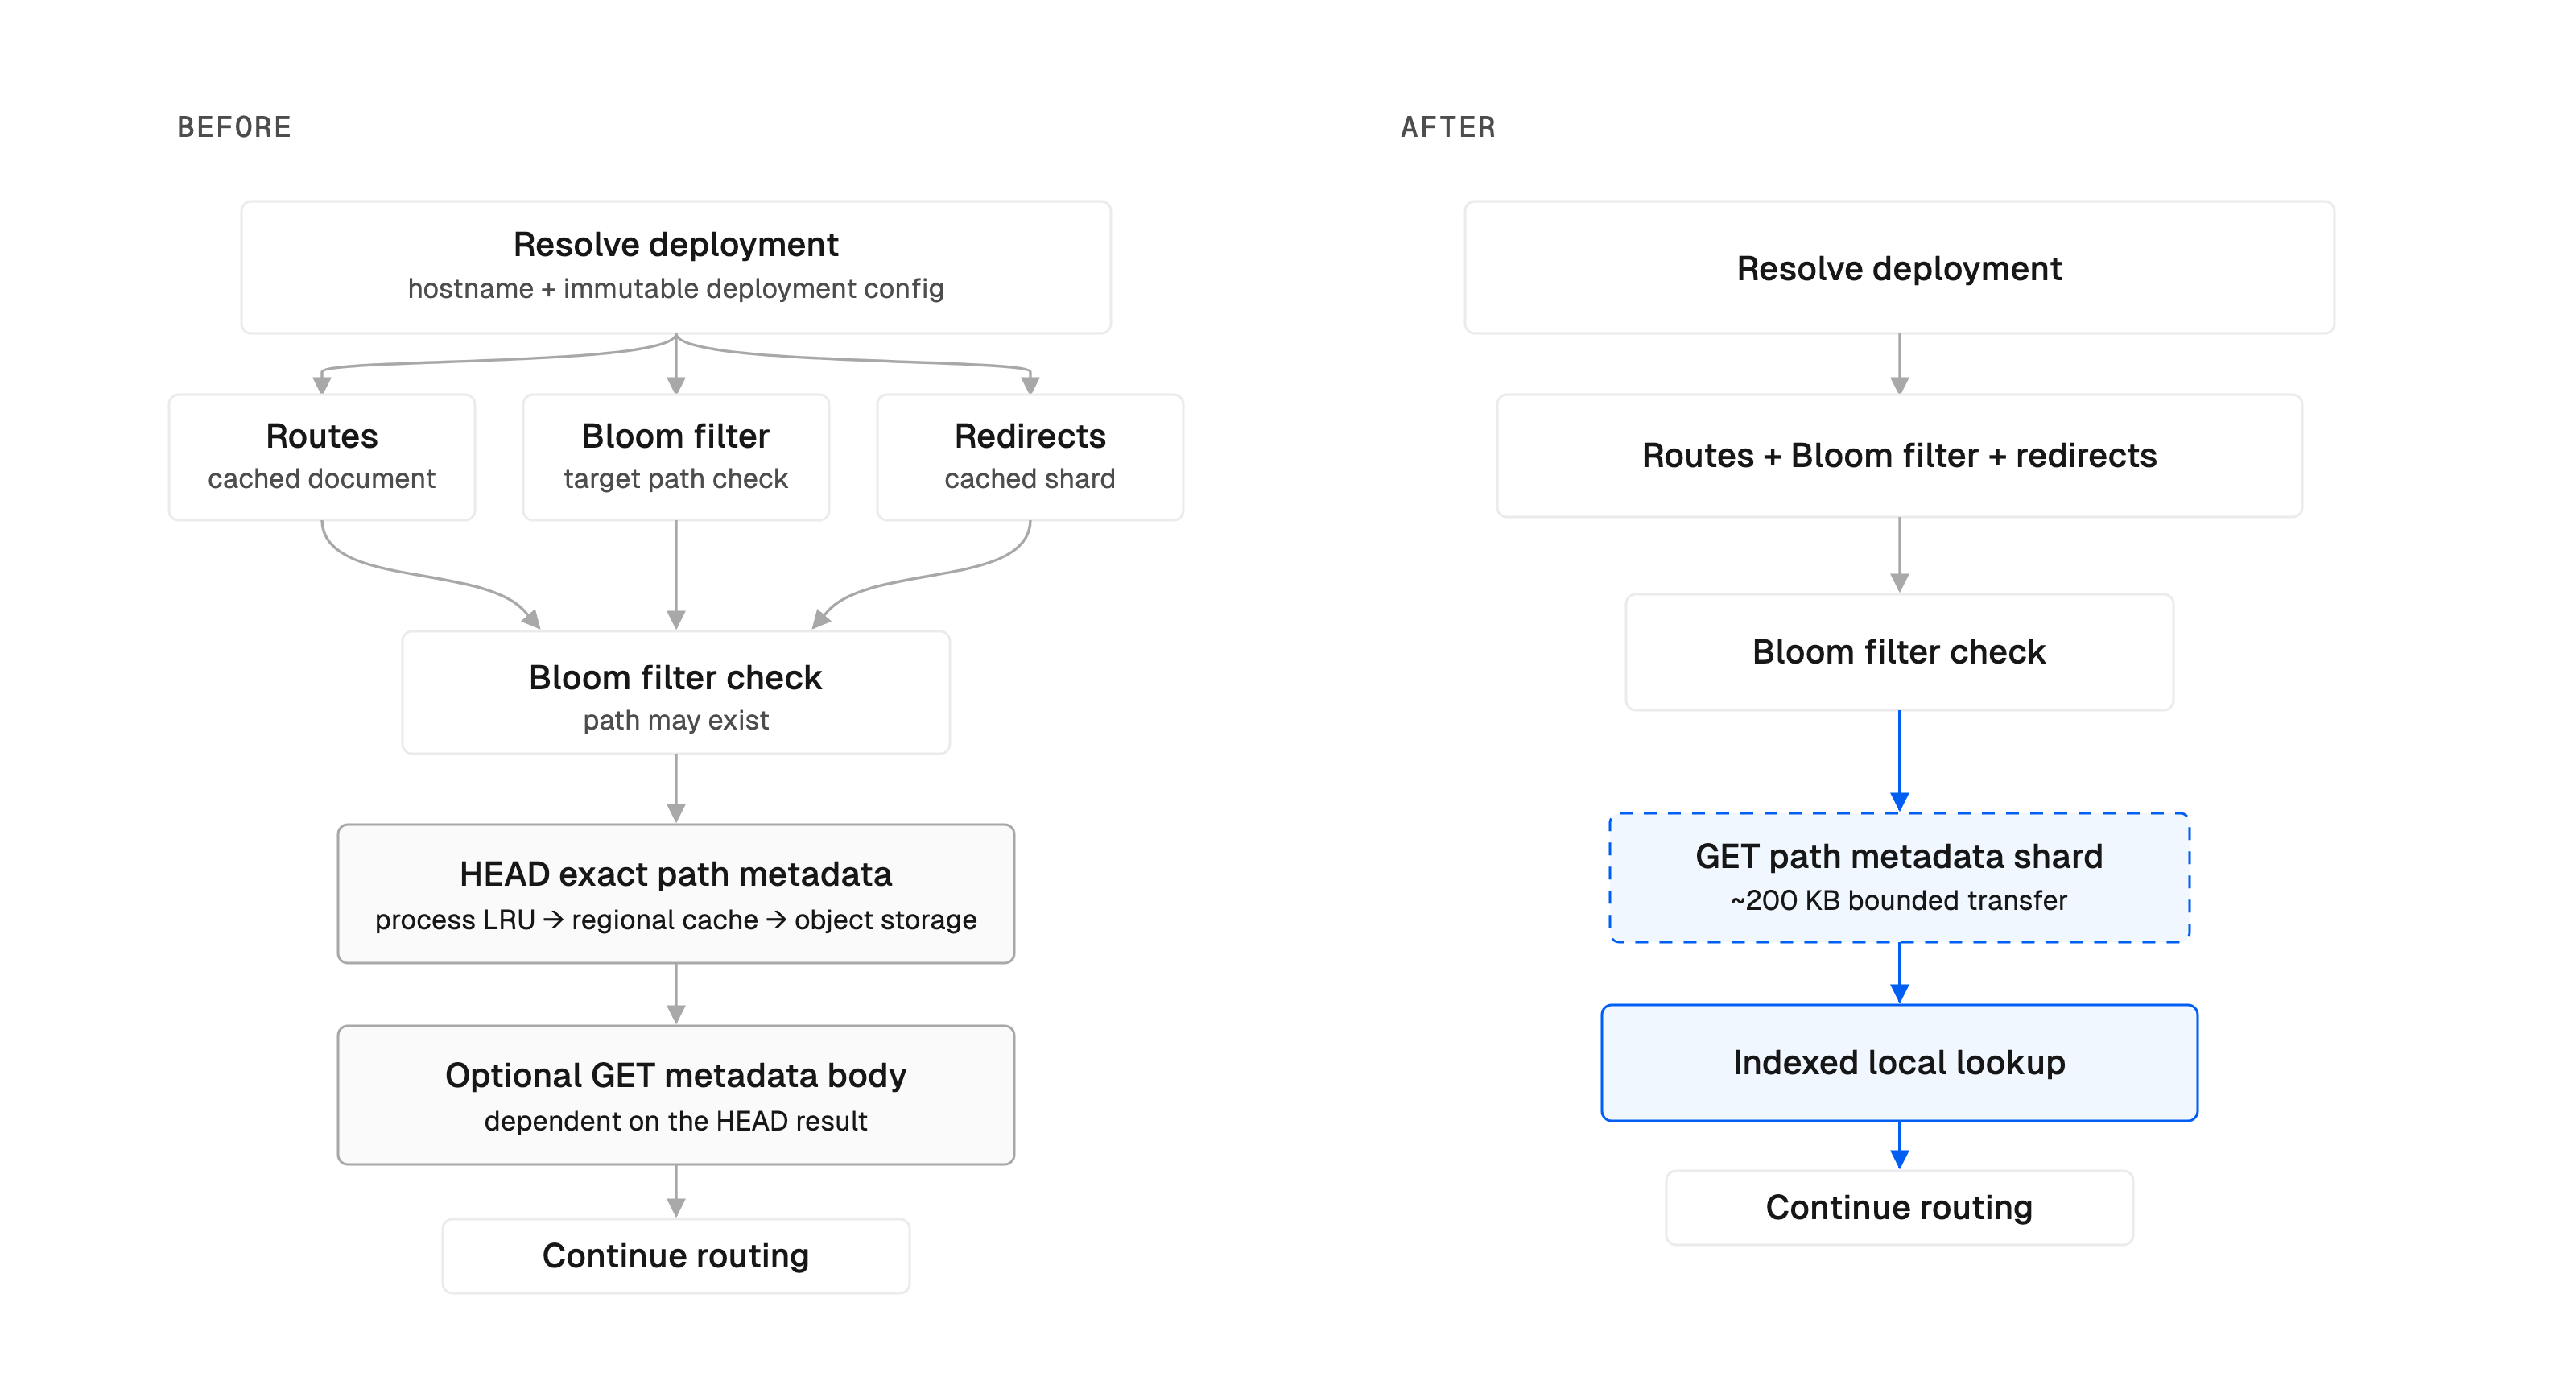
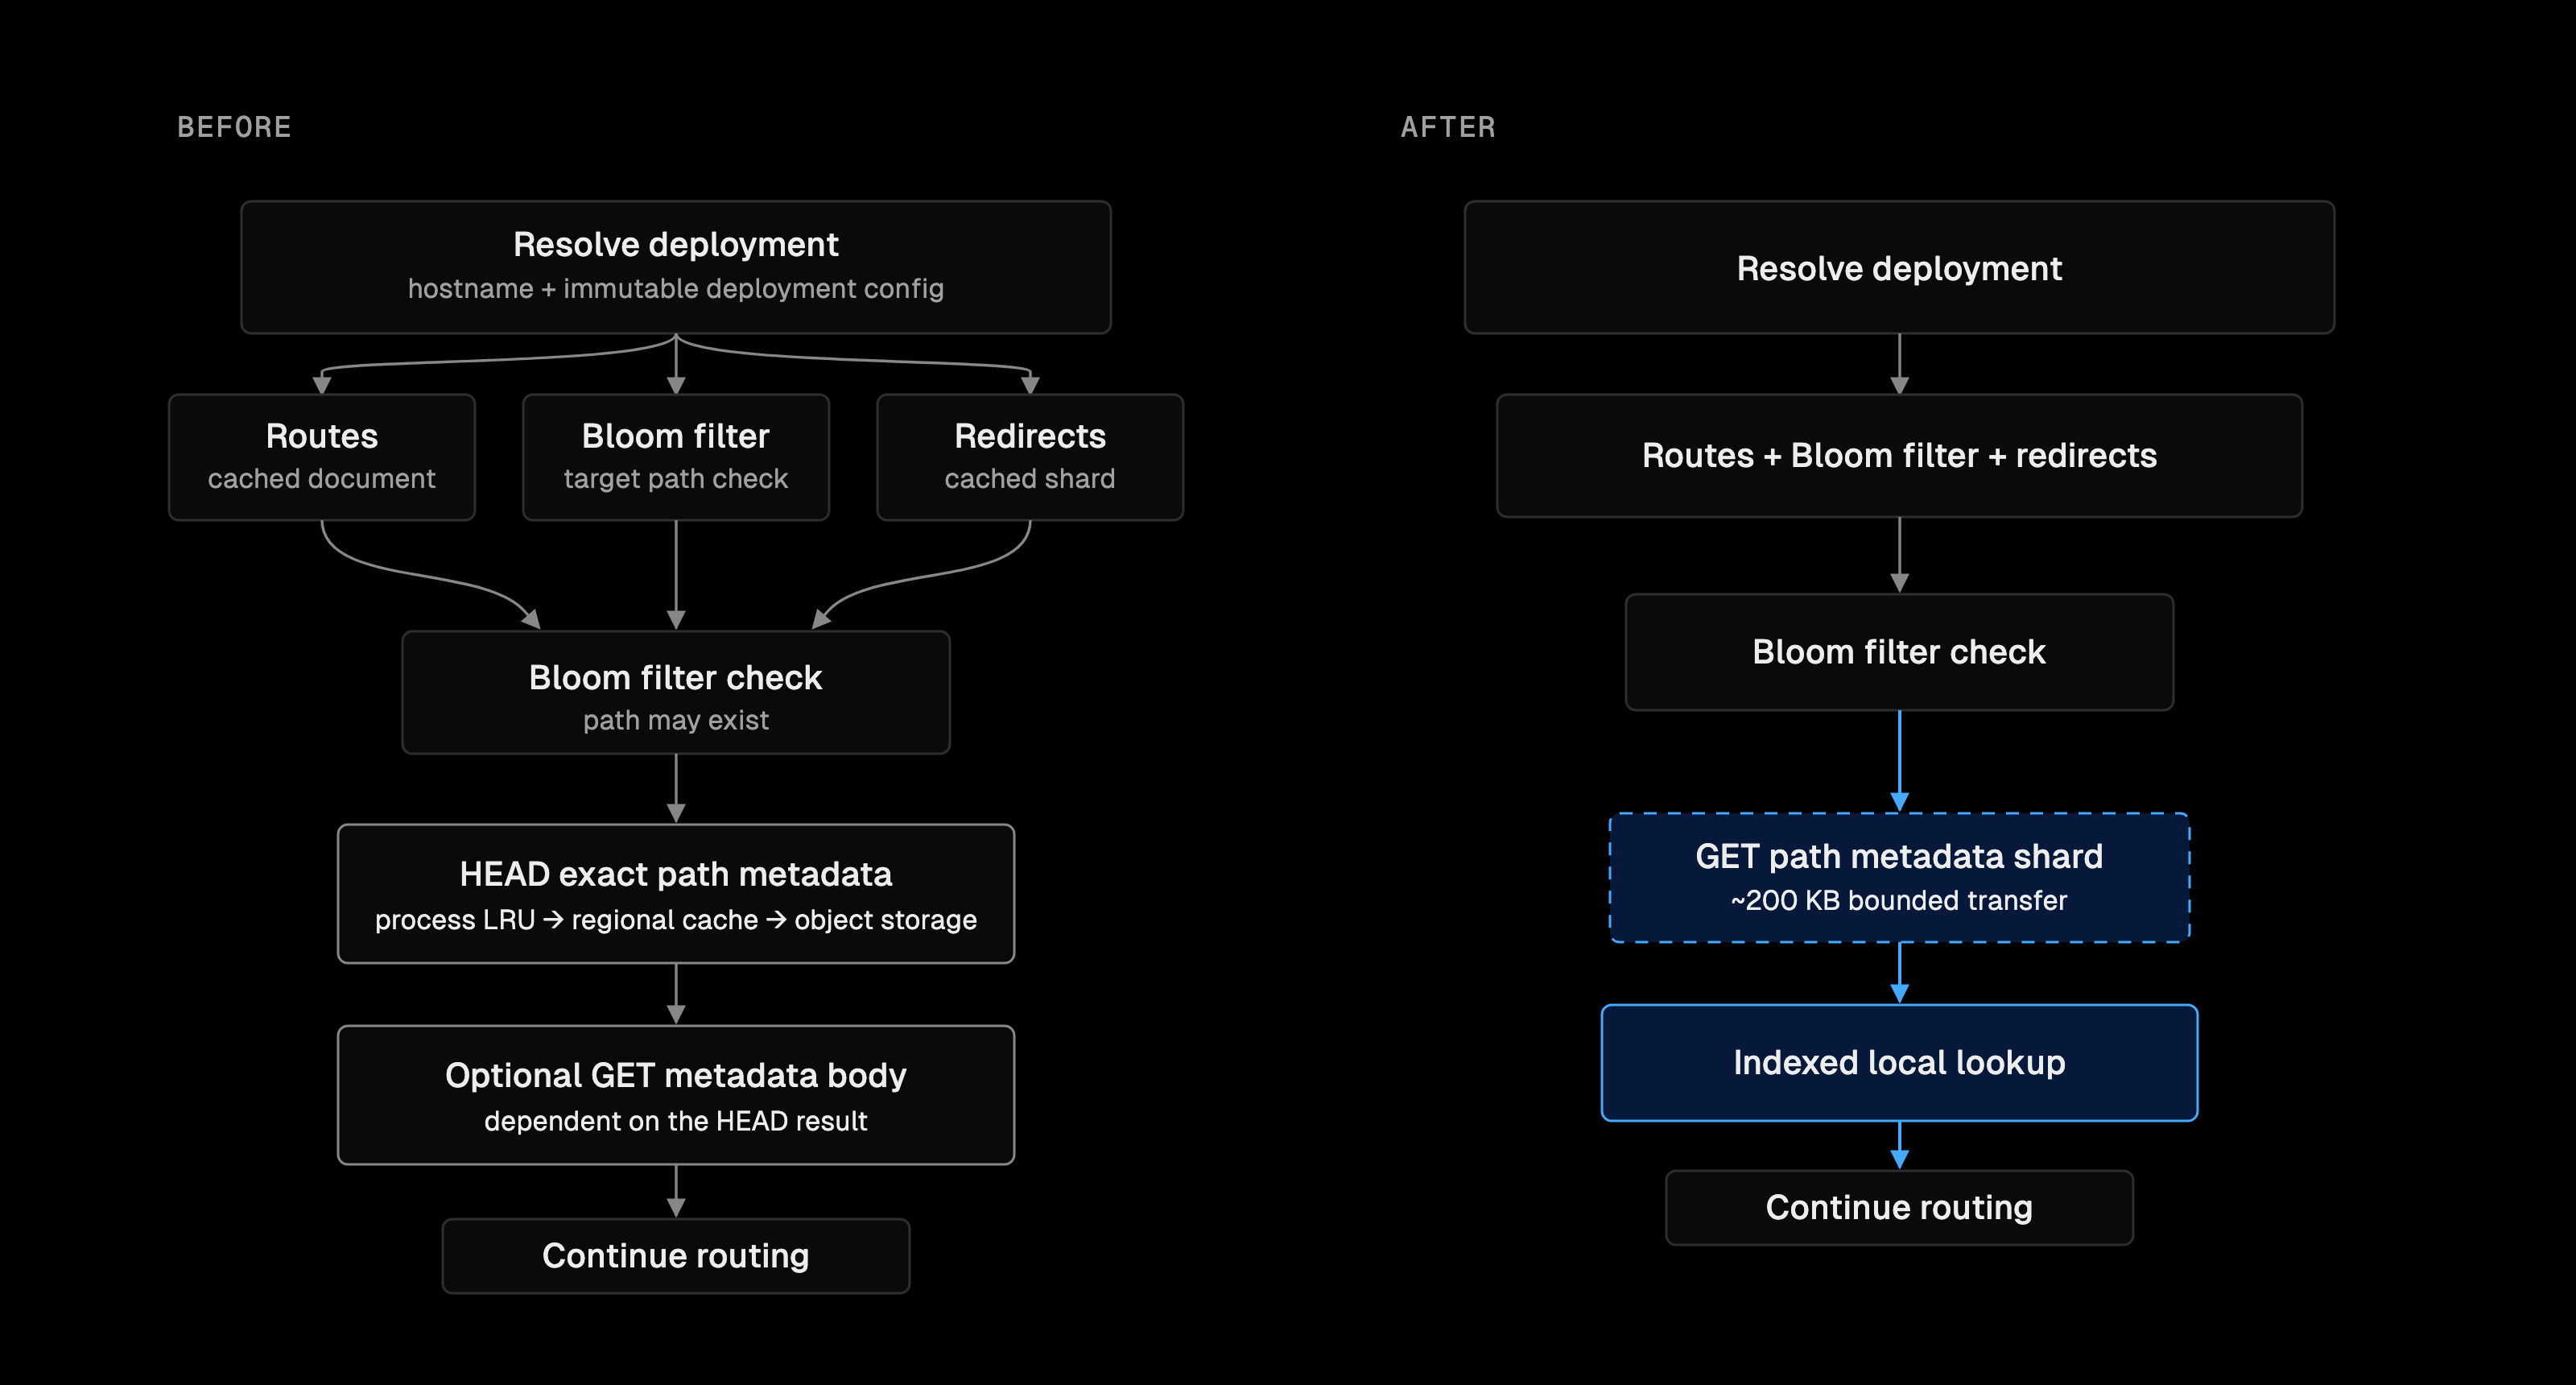
按路径查找需要先后进行相互依赖的 HEAD 和 GET 请求,而新的路径在通过 Bloom filter 检查后只需获取一个大小有界的分片,并在本地查找该路径。
多获取,但不多解析
我们用 Vercel 其他大型路由数据集已在使用的 JSONL 布局来构建分片。JSONL 每行存储一个 JSON 值。我们借鉴了 Bulk Redirects 中排序的、键值交替排列的记录,以及最初为 Bloom filter 构建的可直接寻址的 Base64 数据结构。
我们把数据布局与建立在其上的查找结构分开,这样每种工作负载都可以选择自己需要的特性:
- 可检查的、排序的键值 JSONL 记录,支持随机访问
- 可选的内联索引,用于低开销的二分查找
- 嵌入的 Base64 数据,支持基于偏移量的解码
- 大小有界的分片,用于控制传输和缓存成本
每个分片以交替的 JSONL 记录存储排序后的目标路径及其元数据。内联索引记录了每个条目的起始位置,因此路由进程可以直接跳转到该位置。这些位置以定长指针存储,每个指针占整数个六位的 Base64 字符,因此任何单个指针都可以就地解码,无需先将索引行作为 JSON 解析,也无需解码完整的 Base64 字符串。
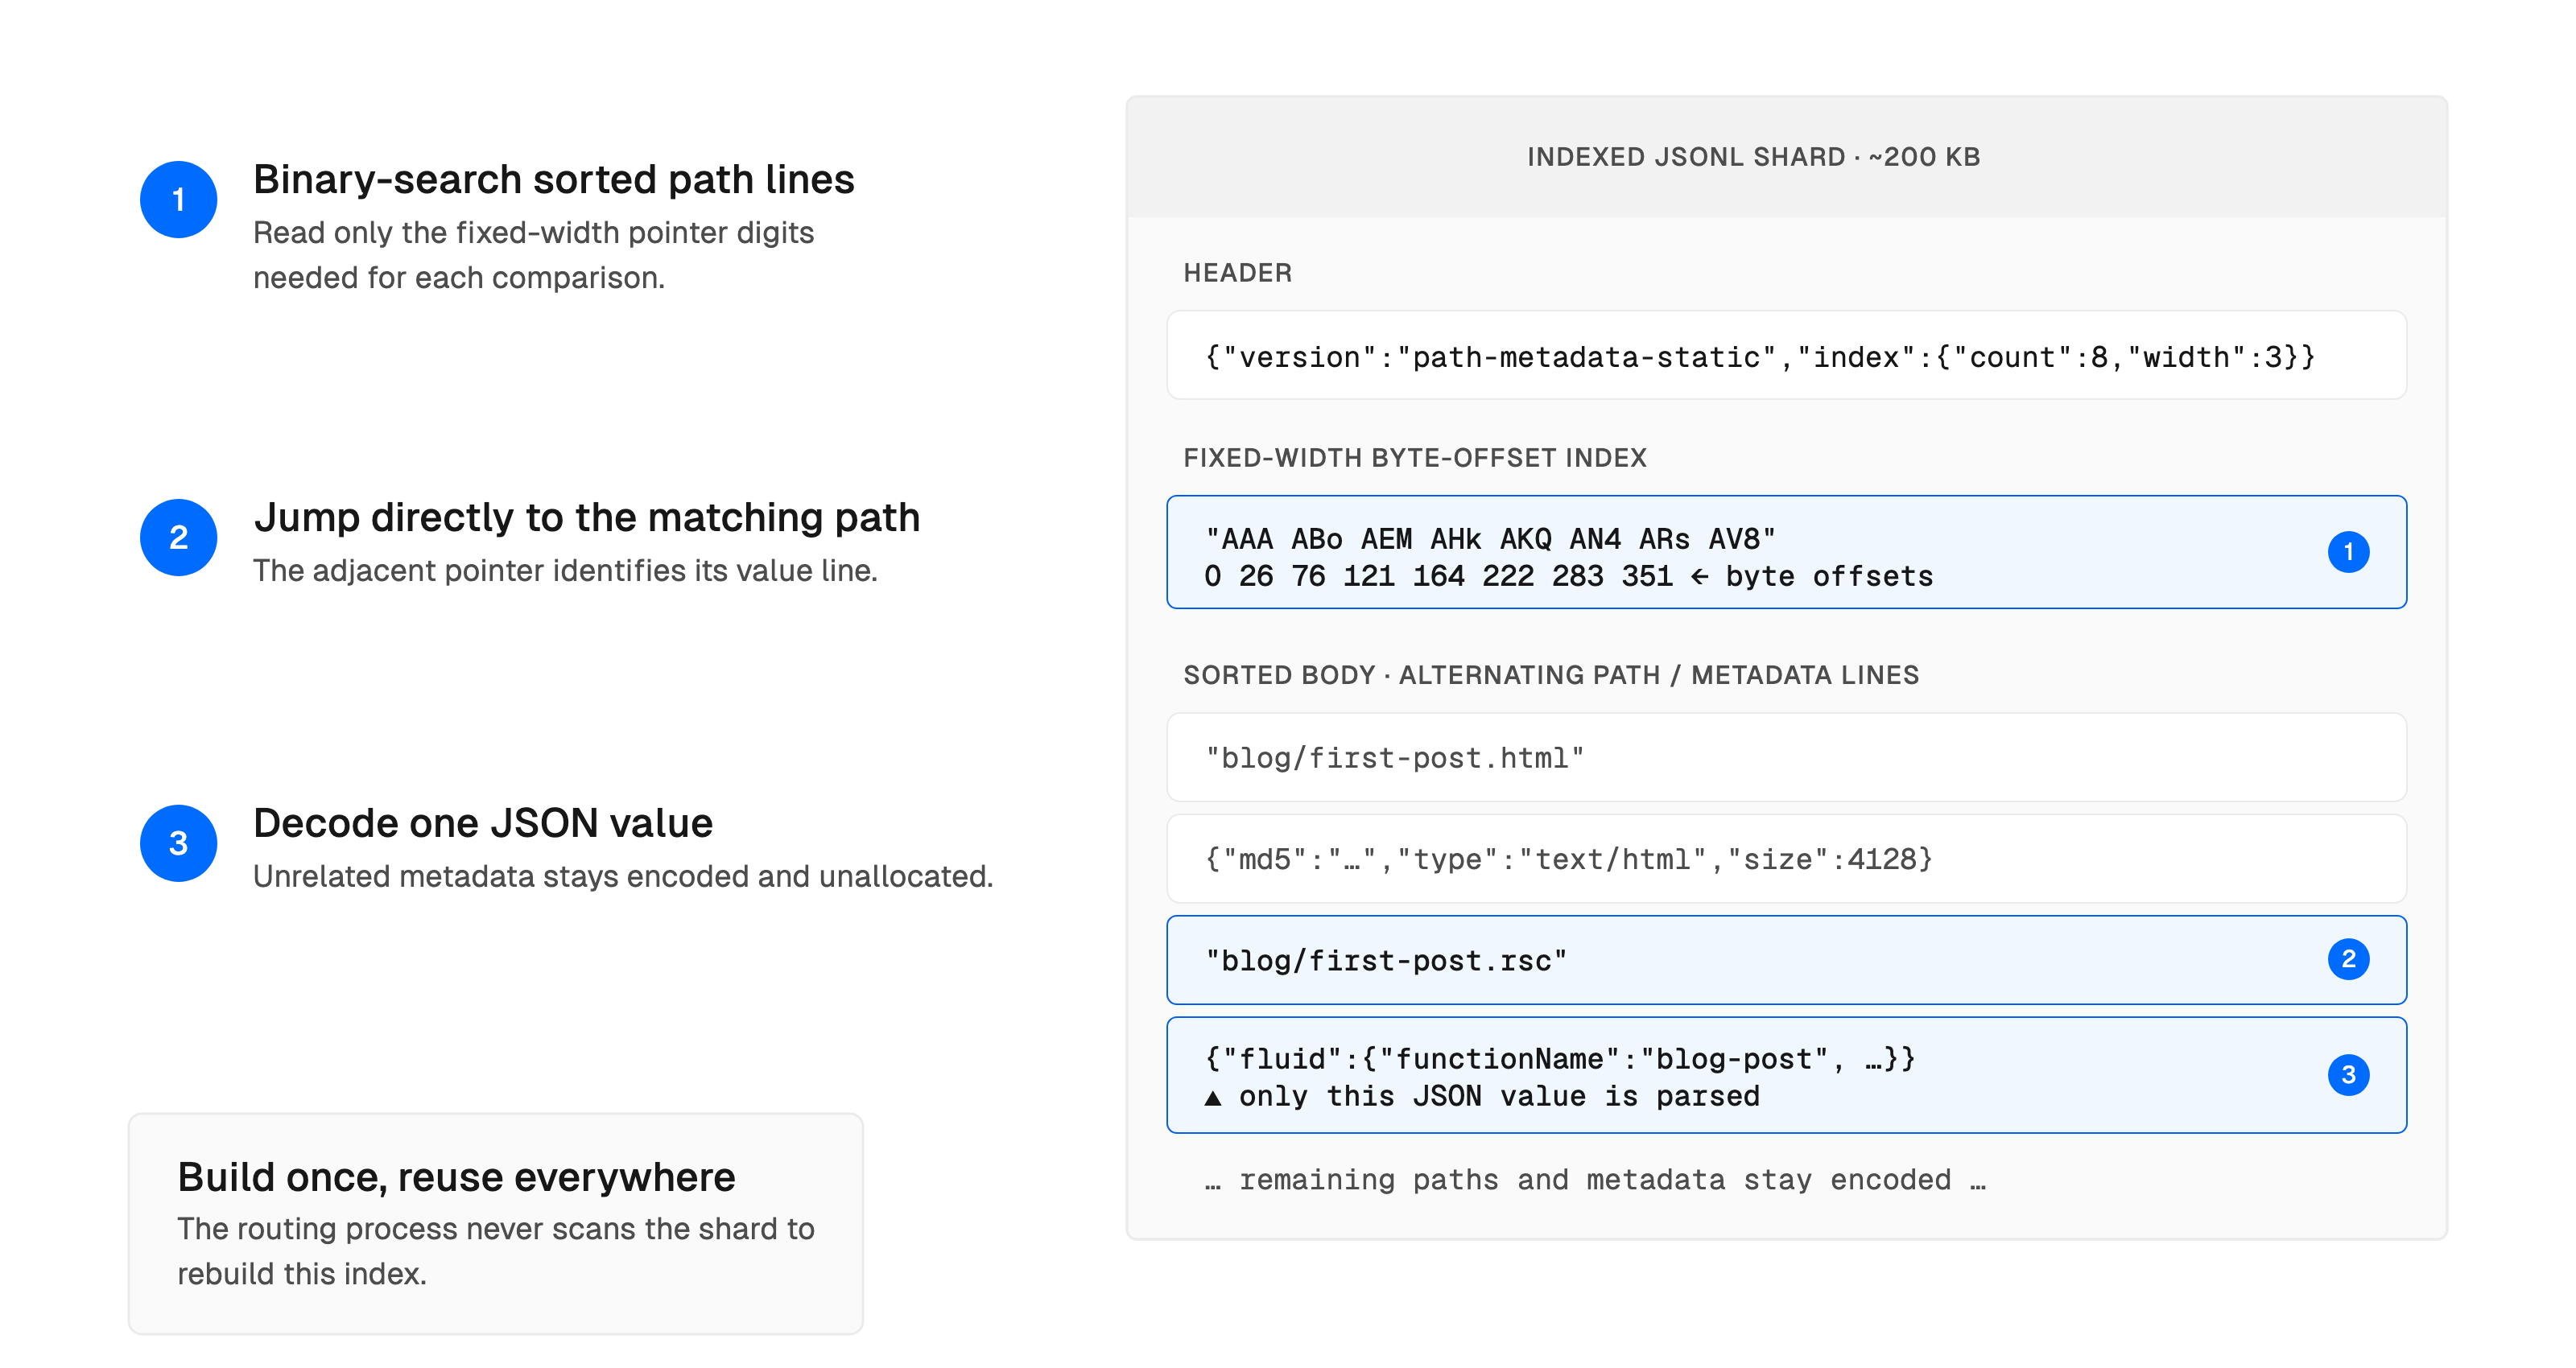
路由进程利用构建时确定的字节偏移量,对编码后的路径进行二分查找,然后只解析匹配的那个 JSON 值。
与 Bulk Redirects 一样,一次部署的首次元数据获取就已经能确定某个路径位于哪个分片,因此选择分片不会增加额外的往返。
在该分片内,路由进程利用索引指针对编码后的路径进行二分查找。找到一个路径需要 O(log n) 次指针读取和字符串比较。一旦找到匹配项,它会解析下一行的元数据值,分片的其余部分则保持未解析状态。
在生产环境中找到合适的分片大小
我们最初希望大多数部署的路径元数据能放进单个分片。由于索引和二分查找让解析开销很低,我们一开始采用了数 MB 的分片。
只有当大分片能一直缓存在离请求较近的位置时,它们才有意义。每个路由进程在内存中保留一个小型的最近最少使用(LRU)缓存来存放最近的分片,其前面还有一个由该区域所有进程共享的更大缓存。每个部署只有少数几个分片,我们预期大多数时候能命中 LRU,从而抵消传输较大分片的成本。
在测试中,区域缓存命中率很高,但 LRU 命中率很低,因为请求分散到了每个区域的众多进程上。传输数 MB 的分片的开销也比我们预期的更大。
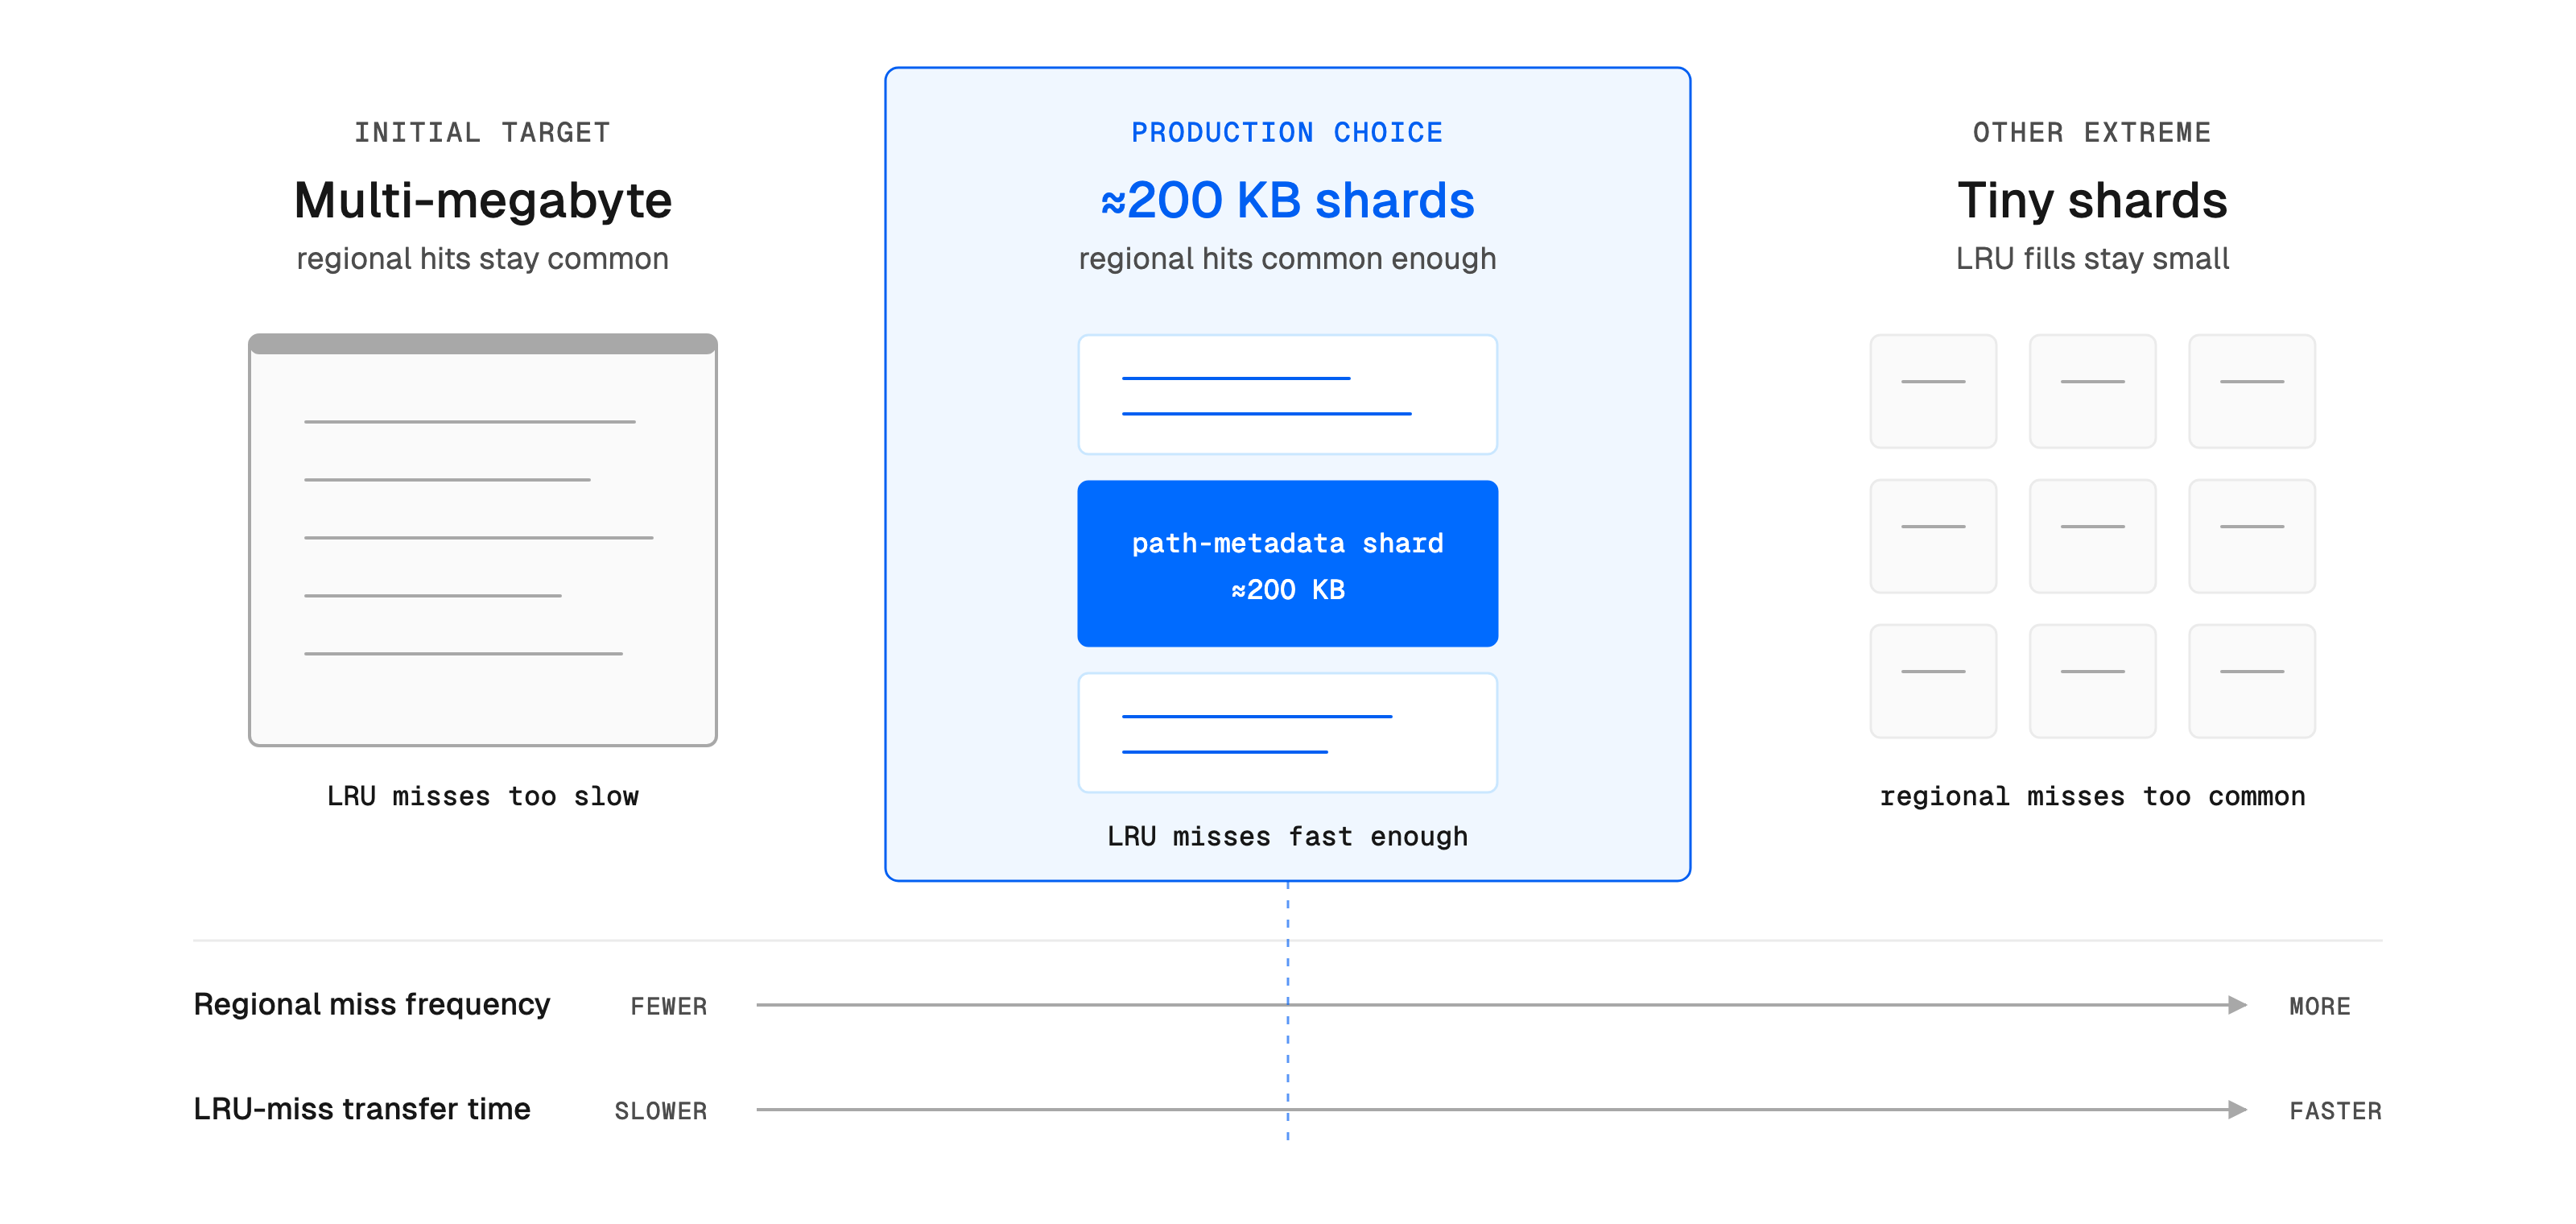
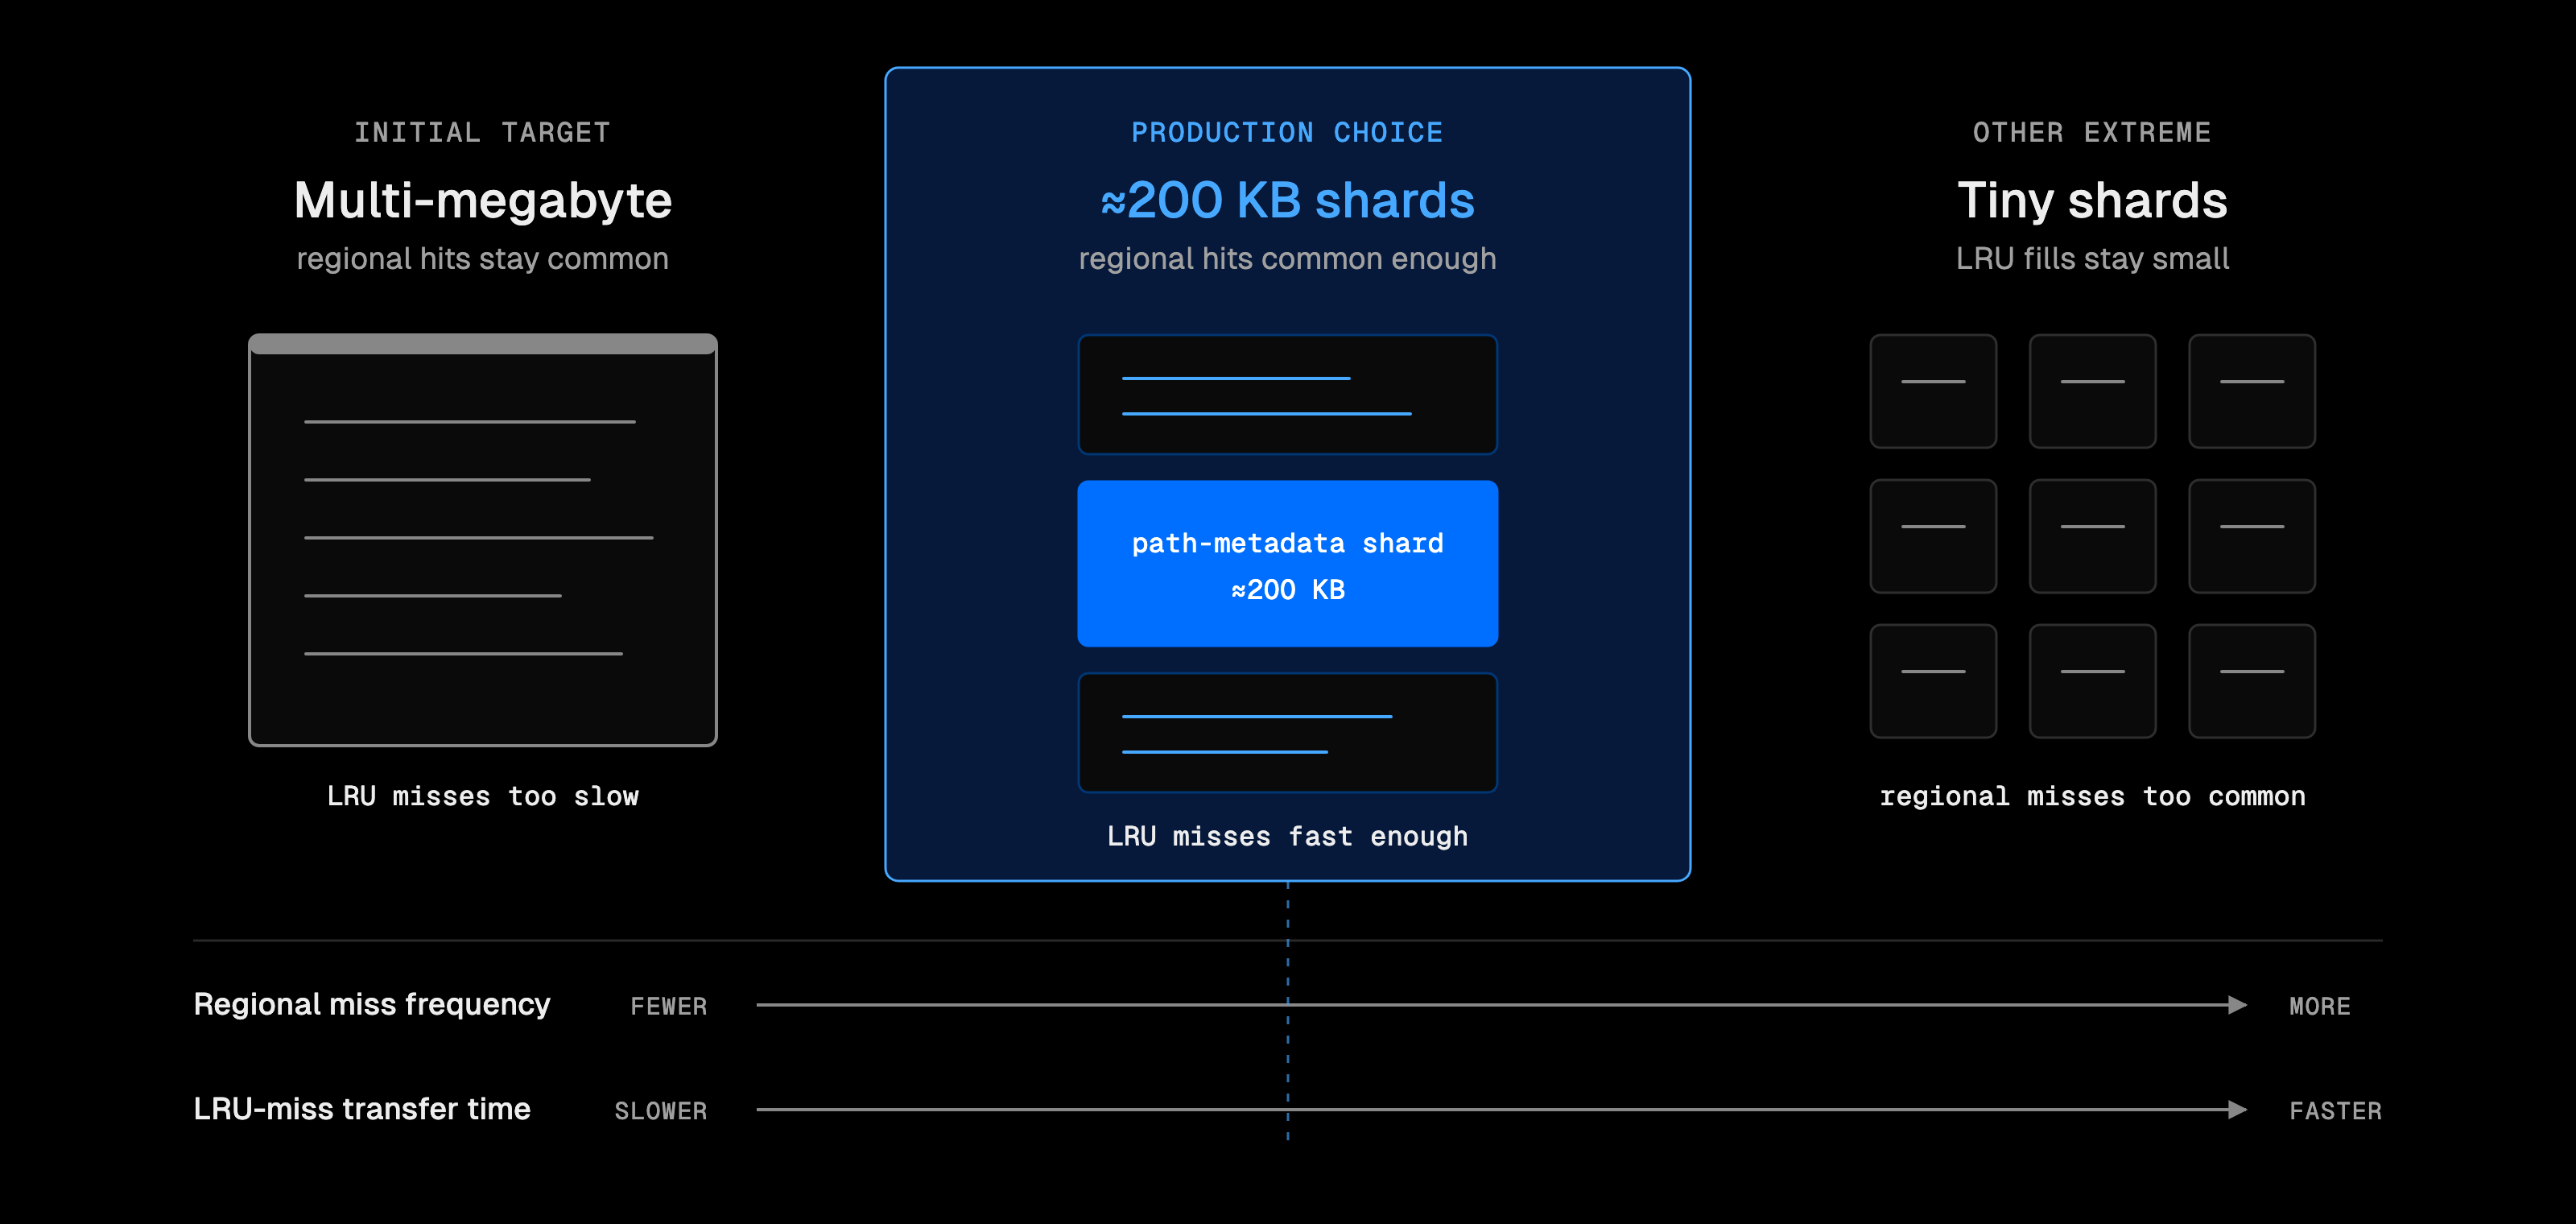
大分片使 LRU 未命中时太慢,而过小的分片又使区域缓存未命中太常见。生产环境测试在约 200 KB 处找到了一个切实可行的平衡点。
我们最终选定约 200 KB 的分片,这既让区域缓存命中率保持在高位,也让 LRU 未命中时的填充成本很低。
生产环境的测量结果显示,平均查找延迟和 P99 查找延迟都有所降低:
| 元数据查找指标 | 之前:按路径存储元数据 | 之后:带索引的分片 | 改善幅度 |
|---|---|---|---|
| P99 延迟 | 215.8 ms | 19.1 ms | 降低 91% |
| 平均延迟 | 8.59 ms | 1.81 ms | 降低 79% |
| 标准差 | 44.9 ms | 19.0 ms | 降低 58% |
基于生产流量测得,时间为 2026 年 8 月 5 日至 12 日。
进一步缩小分片不值得为此推出新版本
让每个分片包含更少的条目可以降低传输成本,但会增加分片数量。我们还评估了在不增加分片数量的前提下,通过更紧凑地编码相同条目来缩小分片。我们测试了三种方案:
- 对排序后的路径做前缀压缩(front-coding),使每条路径只存储与前一条不同的部分。
- 将分片拆分为 JSONL 文档,对元数据去重。
- 使用更紧凑的自定义序列化格式。
我们通过离线模拟来测量编码后的大小和查找成本。
每种方案都能产生小得多的分片,但模拟预测的延迟改善只是有限的。我们认为,为这次迁移额外投入编码、兼容性和上线方面的工作并不值得。等到其他工作负载认为更多索引或压缩值得投入时,这些能力会被纳入共享库。
安全地更改路由
CDN 对每个部署的请求都会执行这种查找。如果分片元数据与按路径存储的元数据不一致,我们就可能返回过期的路由、错误的状态码,或者对一个实际存在的路径返回 404。
我们先在离线环境、再在生产环境中检查是否存在这种不一致。离线时,我们构建了测试部署,并在其上运行测试工具,用两种方式查找每个路径并比对结果。
在生产环境中,我们在功能开关之后,让路由系统对随机抽样的请求同时执行两种查找,但仍返回旧的结果。它在后台把新结果与旧结果进行比较,我们在数周内持续观察是否出现不一致,而不会拖慢生产请求。我们把这称为影子模式(shadow mode)。
影子模式发现了差异,但极为罕见。其中一个是旧编码中的 bug:旧编码把路径打包成 RFC 2047 编码字(encoded word),以便把非 ASCII 文本塞进只允许 ASCII 的字段,而这个 bug 只有在一个 emoji 被拆分到两个编码字中时才会出现。新格式以纯 UTF-8 存储路径,因此那里不会出现这个 bug。发现这个边缘情况增强了我们对比对结果的信心,于是我们开始让分片处理生产流量。
更快的构建
分片开始处理生产流量之后,我们回到构建流水线,去掉了因此变得多余的工作:
- 跳过按路径的元数据上传,节省约 9.7 秒。
- 将路由组元数据写入清单(manifest),节省约 4.5 秒。
- 不再上传这两项改动之后变空的文件,节省约 2.4 秒。
合计节省约 16.6 秒。在所有部署中,部署步骤平均快了约 10%;对于以这些步骤为主要耗时的、元数据密集型部署,我们估计提升接近 25%。
为你的下一次部署带来更快的路由
更快的元数据查找提升了整体的路由解析速度。对于大型站点,P99 路由解析现在大约快了一倍。在我们自己的营销站点和文档站点上,P99 元数据查找延迟从 203 ms 降到了 31 ms,而元数据查找延迟的中位数保持在 0.7 ms 左右。
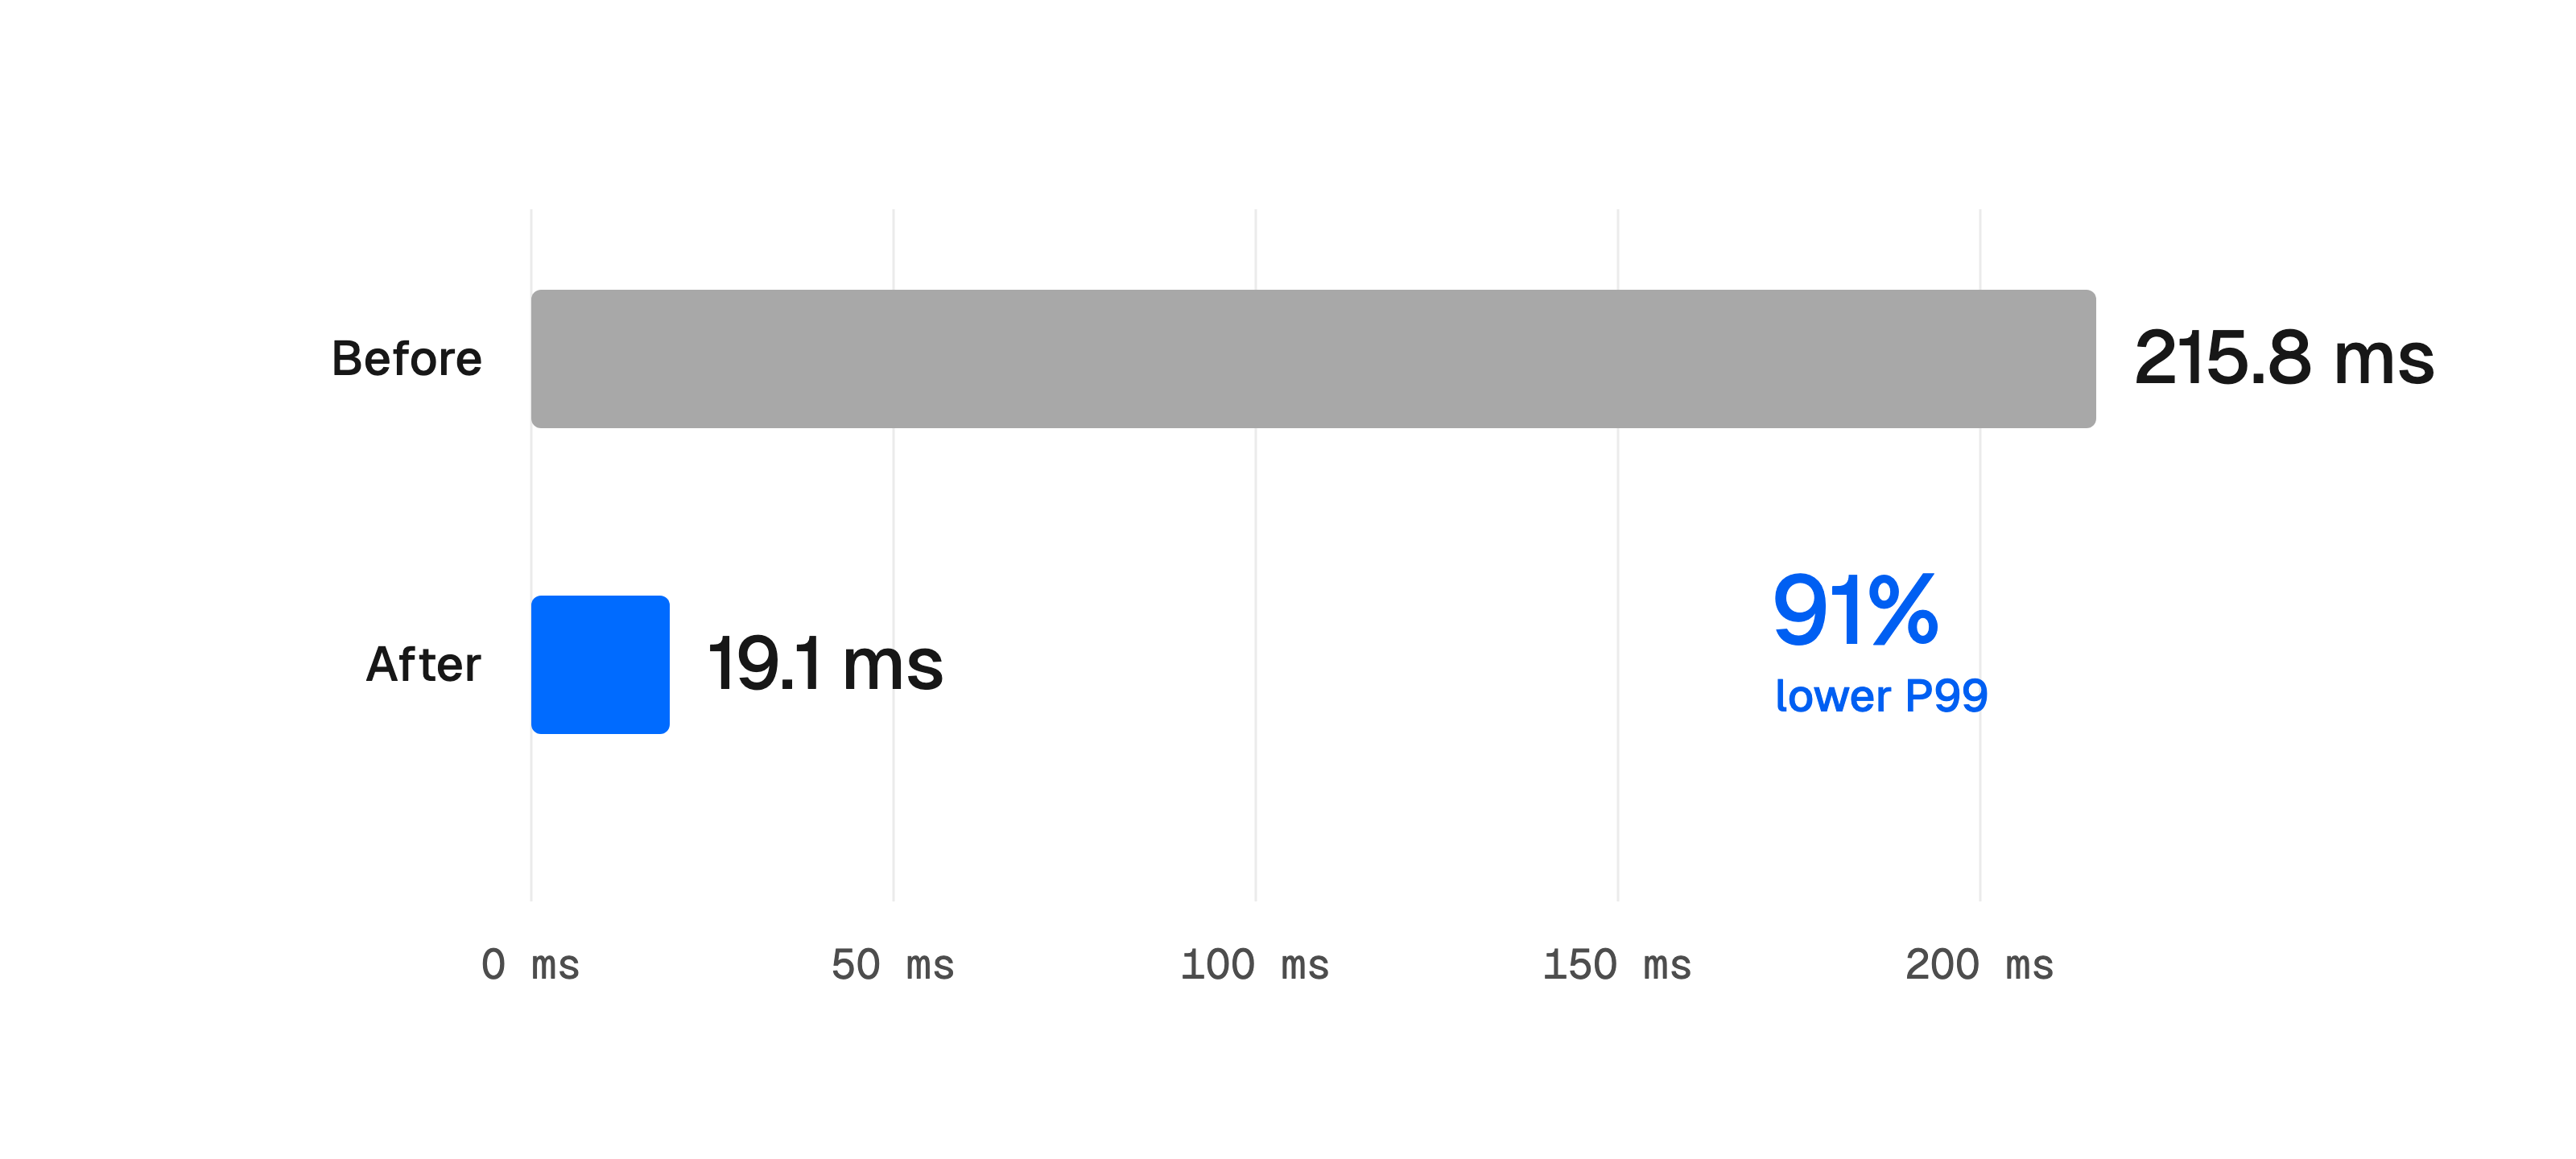
带索引的分片将 P99 元数据查找延迟降低了 91%。
应用的 Build Output API 契约保持不变。框架仍然描述应用的需求,而 Vercel 改进的是 CDN 提供这些服务的方式。
2026 年 7 月 17 日之后构建的部署已经使用了新的元数据分片。对于更早的部署,请重新部署你的项目以获得更快的查找。