Web 始终需要适应新的标准。它先学会了与网页浏览器对话,后来又学会了与搜索引擎对话。现在,它需要学会与 AI 智能体对话。
今天,我们很高兴推出 isitagentready.com,这是一个新工具,帮助站点所有者了解如何针对智能体优化自己的站点,涵盖如何引导智能体完成身份验证、控制智能体能看到哪些内容、以何种格式接收内容,以及如何为内容付费。我们还在 Cloudflare Radar 中引入了一个新数据集,用于追踪各项智能体标准在整个互联网上的总体采用情况。
我们希望以身作则。因此,我们也会分享最近如何全面改造 Cloudflare 的开发者文档,使其成为对智能体最友好的文档站点,让 AI 工具回答问题更快,成本也显著更低。
如今的 Web 对智能体准备得如何?
简短的回答是:不太好。这在意料之中,但也说明,如果这些标准得到采用,智能体能比现在有效得多。
为了分析这一点,Cloudflare Radar 选取了互联网上访问量最高的 20 万个域名,过滤掉对智能体就绪度并不重要的类别(如重定向、广告服务器和隧道服务),把重点放在 AI 智能体可能确实需要与之交互的企业、出版商和平台上,然后用我们的新工具对它们进行了扫描。
结果是一张新的“AI 智能体标准采用情况”图表,现已可在 Cloudflare Radar AI Insights 页面中查看,我们可以在多个域名类别中衡量每项标准的采用情况。
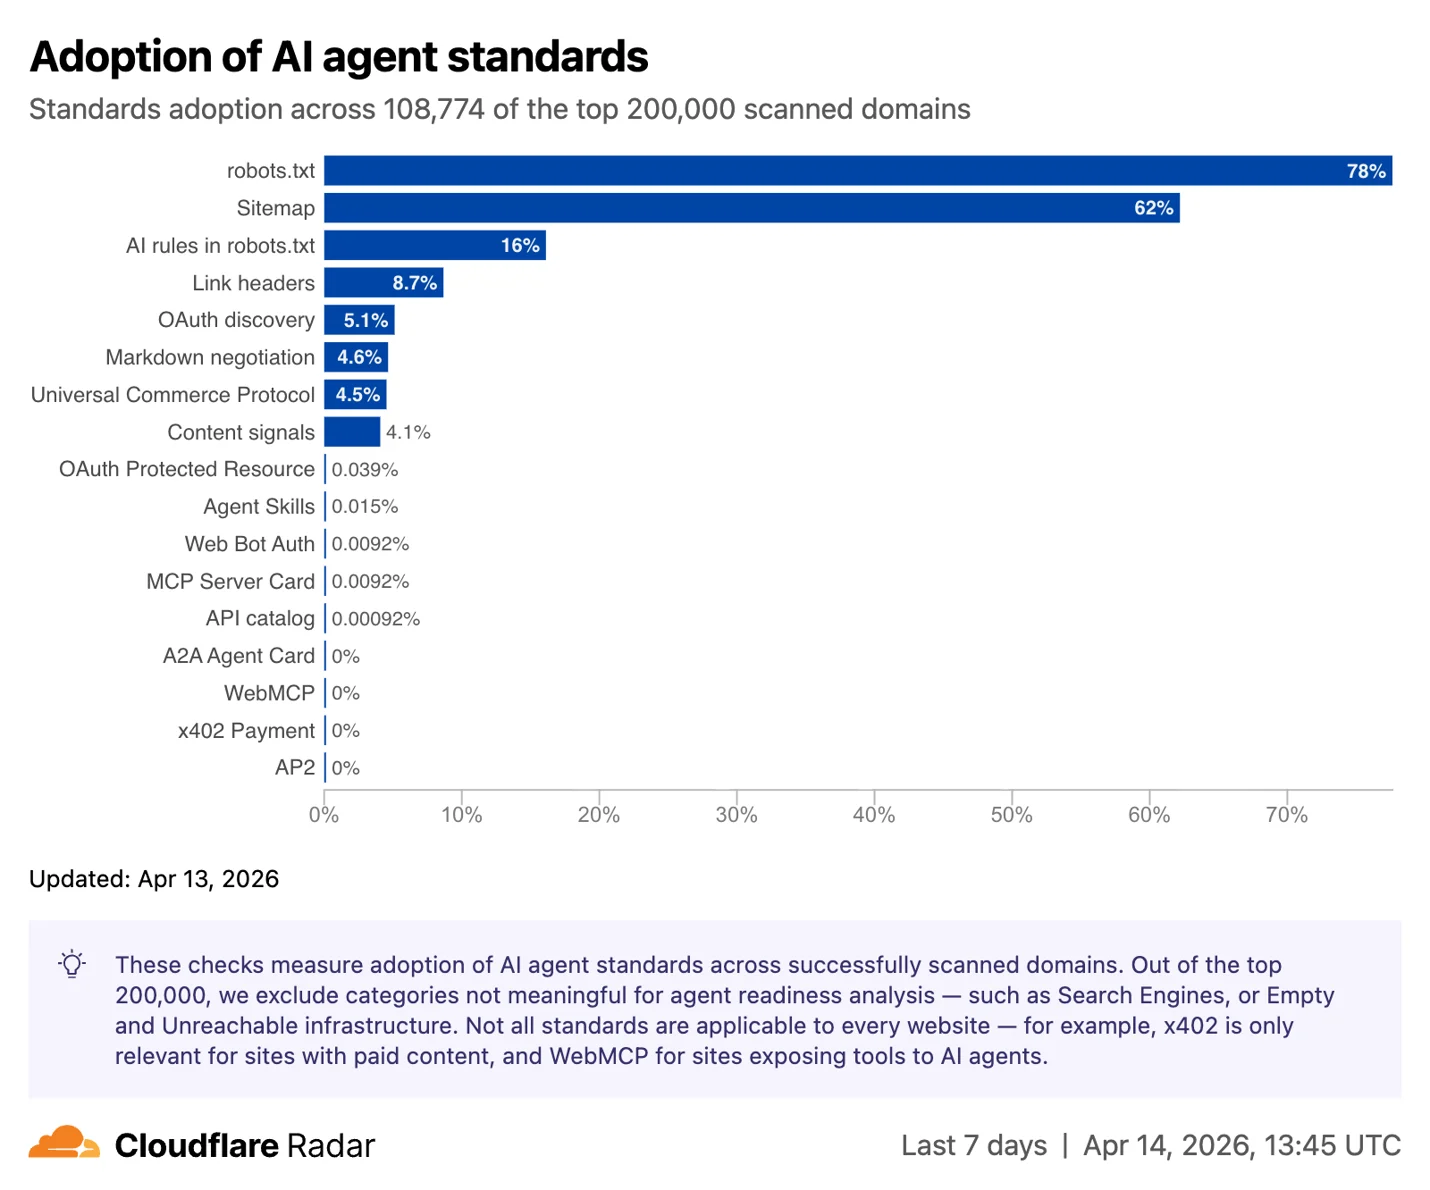
从各项检查来看,有几点很突出:
- robots.txt 几乎无处不在,78% 的站点都有,但绝大多数是为传统搜索引擎爬虫编写的,而不是面向 AI 智能体。
- Content Signals:4% 的站点已在 robots.txt 中声明了它们对 AI 使用的偏好。这是一项正在获得势头的新标准。
- Markdown 内容协商(在收到 Accept: text/markdown 时提供 text/markdown)在 3.9% 的站点上通过检查。
- MCP Server Cards 和 API Catalogs (RFC 9727) 等新兴标准,在整个数据集中加起来出现在不到 15 个站点上。现在还为时尚早,成为最早采用新标准并与智能体良好配合的站点之一,有很大的出彩机会。
这张图表将每周更新,数据也可以通过 Data Explorer 或 Radar API 获取。
获取你站点的智能体就绪度评分
你可以访问 isitagentready.com 并输入站点的 URL,获取自己网站的智能体就绪度评分。
能给出可操作反馈的评分和审计,此前就曾推动过新标准的采用。例如,Google Lighthouse 会对网站的性能和安全最佳实践打分,并引导站点所有者采用最新的 Web 平台标准。我们认为,也应该有类似的东西来帮助站点所有者采用面向智能体的最佳实践。
当你输入站点后,Cloudflare 会向其发出请求,检查它支持哪些标准,并基于四个维度给出评分:
- 可发现性:robots.txt、sitemap.xml、Link Headers (RFC 8288)
- 内容:Markdown for Agents
- Bot 访问控制:Content Signals、robots.txt 中的 AI bot 规则、Web Bot Auth
- 能力:Agent Skills、API Catalog (RFC 9727)、通过 RFC 8414 和 RFC 9728 实现的 OAuth 服务器发现、MCP Server Card 以及 WebMCP
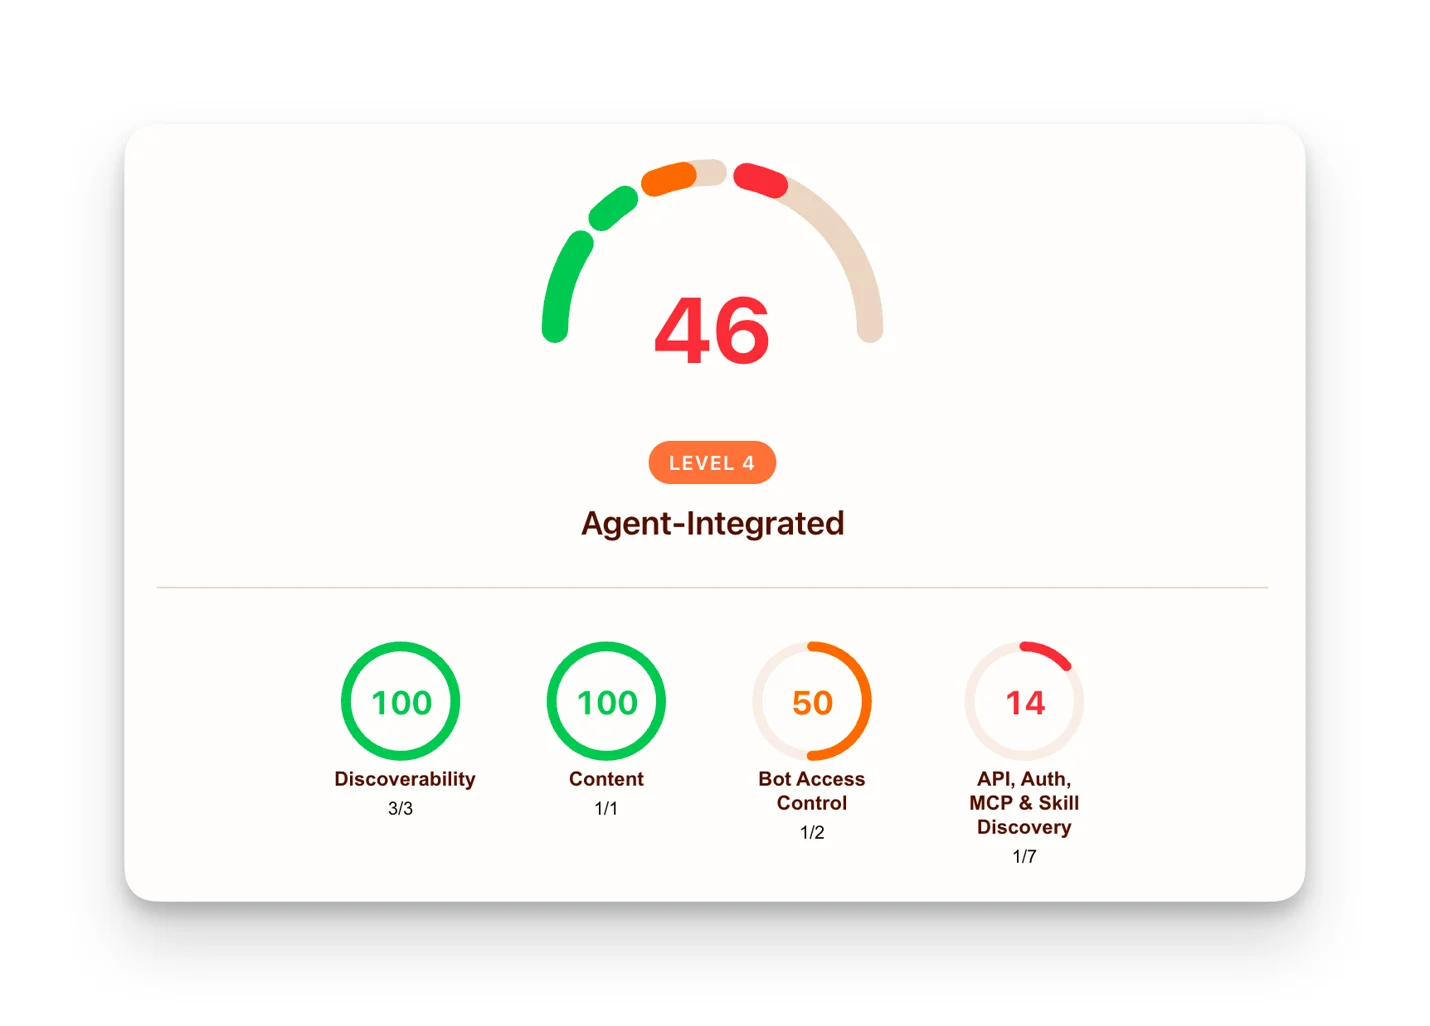
某示例网站的智能体就绪度检查结果截图。
此外,我们还会检查站点是否支持智能体商务标准,包括 x402、Universal Commerce Protocol 和 Agentic Commerce Protocol,但这些目前不计入评分。
对于每一项未通过的检查,我们都会提供一段提示词,你可以把它交给自己的编码智能体,让它代你实现相应的支持。
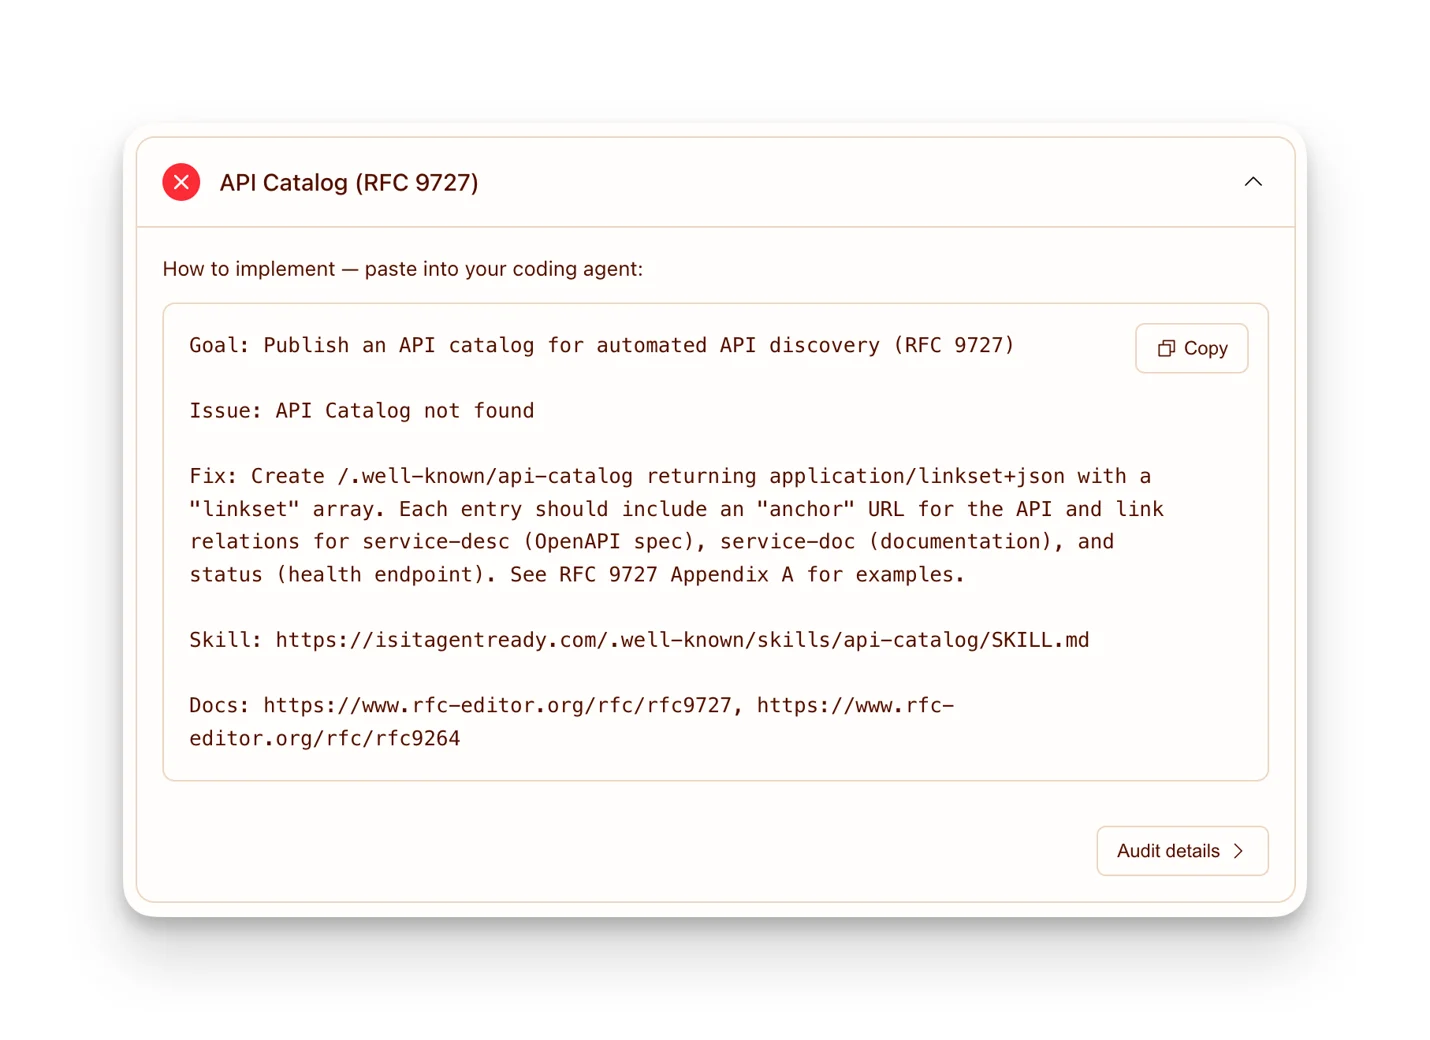
该站点本身也是对智能体就绪的,说到做到。它通过 Streamable HTTP 暴露了一个无状态的 MCP 服务器(https://isitagentready.com/.well-known/mcp.json),带有 scan_site 工具,因此任何兼容 MCP 的智能体都可以通过编程方式扫描网站,而无需使用网页界面。它还发布了一份 Agent Skills 索引(https://isitagentready.com/.well-known/agent-skills/index.json),为它检查的每项标准都提供了技能文档,这样智能体不仅知道要修复什么,也知道该如何修复。
下面我们来深入了解每个类别中的检查项,以及它们对智能体为什么重要。
可发现性
robots.txt 自 1994 年就已存在,大多数站点都有。它对智能体有两个作用:定义爬取规则(谁可以访问什么),并指向你的站点地图。站点地图是一个 XML 文件,列出你网站上的每一条路径,本质上是一张地图,智能体可以顺着它发现你的所有内容,而无需爬取每一个链接。智能体首先查看的就是 robots.txt。
除了站点地图,智能体还可以直接从 HTTP 响应标头中发现重要资源,具体来说就是使用 Link 响应标头(RFC 8288)。与埋在 HTML 里的链接不同,Link 标头是 HTTP 响应本身的一部分,这意味着智能体无需解析任何标记就能找到指向资源的链接:
HTTP/1.1 200 OK
Link: </.well-known/api-catalog>; rel="api-catalog"
内容可访问性
让智能体进入你的站点是一回事,确保它真的能读懂你的内容则是另一回事。
早在 2024 年 9 月(考虑到 AI 发展之快,感觉像是上辈子的事了),llms.txt 就被提出,作为提供网站的 LLM 友好表示、并能放入模型上下文窗口的一种方式。llms.txt 是放在站点根目录的纯文本文件,为智能体提供一份结构化的阅读清单:这个站点是什么、上面有什么,以及重要内容在哪里。可以把它看作是为 LLM 阅读而非为爬虫建立索引而写的站点地图:
# My Site
> A developer platform for building on the edge.
## Documentation
- [Getting Started](https://example.com/docs/start.md)
- [API Reference](https://example.com/docs/api.md)
## Changelog
- [Release Notes](https://example.com/changelog.md)
Markdown 内容协商则更进一步。当智能体获取任意页面并发送 Accept: text/markdown 标头时,服务器会返回干净的 markdown 版本,而不是 HTML。markdown 版本所需的 token 少得多,我们在某些情况下测得最多可减少 80% 的 token,这让响应更快、更便宜,也更有可能被完整读取,因为大多数智能体工具默认都对上下文窗口有限制。
默认情况下,我们只检查站点是否正确处理了 Markdown 内容协商,不检查 llms.txt。如果你愿意,也可以自定义扫描,把 llms.txt 包含进来。
Bot 访问控制
既然智能体可以浏览你的站点并获取你的内容,接下来的问题是:你是否愿意让任何 bot 都这样做?
robots.txt 的作用不止于指向站点地图。它也是你定义访问规则的地方。你可以明确声明允许哪些爬虫、它们可以访问什么,甚至精确到具体路径。这一约定已经确立,仍然是任何守规矩的 bot 在开始爬取之前最先查看的地方。
Content Signals 让你可以更精细地表达。你不必只是允许或阻止,而是可以明确声明 AI 能对你的内容做什么。通过在 robots.txt 中使用 Content-Signal 指令,你可以独立控制三件事:你的内容是否可用于 AI 训练(ai-train)、是否可作为推理和 grounding 的 AI 输入(ai-input),以及是否应出现在搜索结果中(search):
User-agent: *
Content-Signal: ai-train=no, search=yes, ai-input=yes
反过来,Web Bot Auth 这一 IETF 草案标准允许友好的 bot 对自己进行身份验证,也允许接收 bot 请求的网站识别它们。bot 会对其 HTTP 请求签名,接收站点则使用该 bot 公布的公钥来验证这些签名。
这些公钥位于一个众所周知的端点 /.well-known/http-message-signatures-directory,我们在扫描时会检查它。
并非所有站点都需要实现这一点。如果你的站点只提供内容,不向其他站点发出请求,就不需要它。但随着互联网上越来越多的站点运行自己的智能体并向其他站点发出请求,我们预计它会随着时间推移变得越来越重要。
协议发现
除了被动地消费内容,智能体还可以通过调用 API、调用工具和自主完成任务,直接与你的站点交互。
如果你的服务有一个或多个公共 API,API Catalog(RFC 9727)为智能体提供了一个统一的、众所周知的位置,用来发现所有这些 API。它托管在 /.well-known/api-catalog,列出你的 API 以及指向其规范、文档和状态端点的链接,而无需智能体抓取你的开发者门户或阅读你的文档。
谈到智能体,就绕不开 MCP。Model Context Protocol 是一项开放标准,允许 AI 模型连接外部数据源和工具。你不必为每个 AI 工具构建定制集成,只需构建一个 MCP 服务器,任何兼容的智能体都能使用它。
为了帮助智能体找到你的 MCP 服务器,你可以发布一份 MCP Server Card(目前仍是处于草案阶段的提案)。这是位于 /.well-known/mcp/server-card.json 的一个 JSON 文件,在智能体连接之前就描述了你的服务器:它暴露了哪些工具、如何访问,以及如何进行身份验证。智能体读取这个文件,就知道了开始使用你的服务器所需的一切:
{
  "$schema": "https://static.modelcontextprotocol.io/schemas/mcp-server-card/v1.json",
  "version": "1.0",
  "protocolVersion": "2025-06-18",
  "serverInfo": {
    "name": "search-mcp-server",
    "title": "Search MCP Server",
    "version": "1.0.0"
  },
  "description": "Search across all documentation and knowledge base articles",
  "transport": {
    "type": "streamable-http",
    "endpoint": "/mcp"
  },
  "authentication": {
    "required": false
  },
  "tools": [
    {
      "name": "search",
      "title": "Search",
      "description": "Search documentation by keyword or question",
      "inputSchema": {
        "type": "object",
        "properties": {
          "query": { "type": "string" }
        },
        "required": ["query"]
      }
    }
  ]
}
当智能体拥有能帮助它们执行特定任务的 Agent Skills 时表现最好,但智能体如何发现一个站点提供了哪些技能?我们提议站点可以在 .well-known/agent-skills/index.json 提供这些信息,这个端点会告诉智能体有哪些可用技能以及在哪里找到它们。你可能注意到,.well-known 标准(RFC 8615)被许多其他智能体和授权标准所使用。感谢该标准的作者、Cloudflare 自己的 Mark Nottingham,以及其他 IETF 贡献者!
许多站点要求你先登录才能访问。这让人类很难授权智能体代表自己访问这些站点,也是为什么有些人采取了可以说并不安全的变通做法:让智能体访问用户的网页浏览器及其已登录的会话。
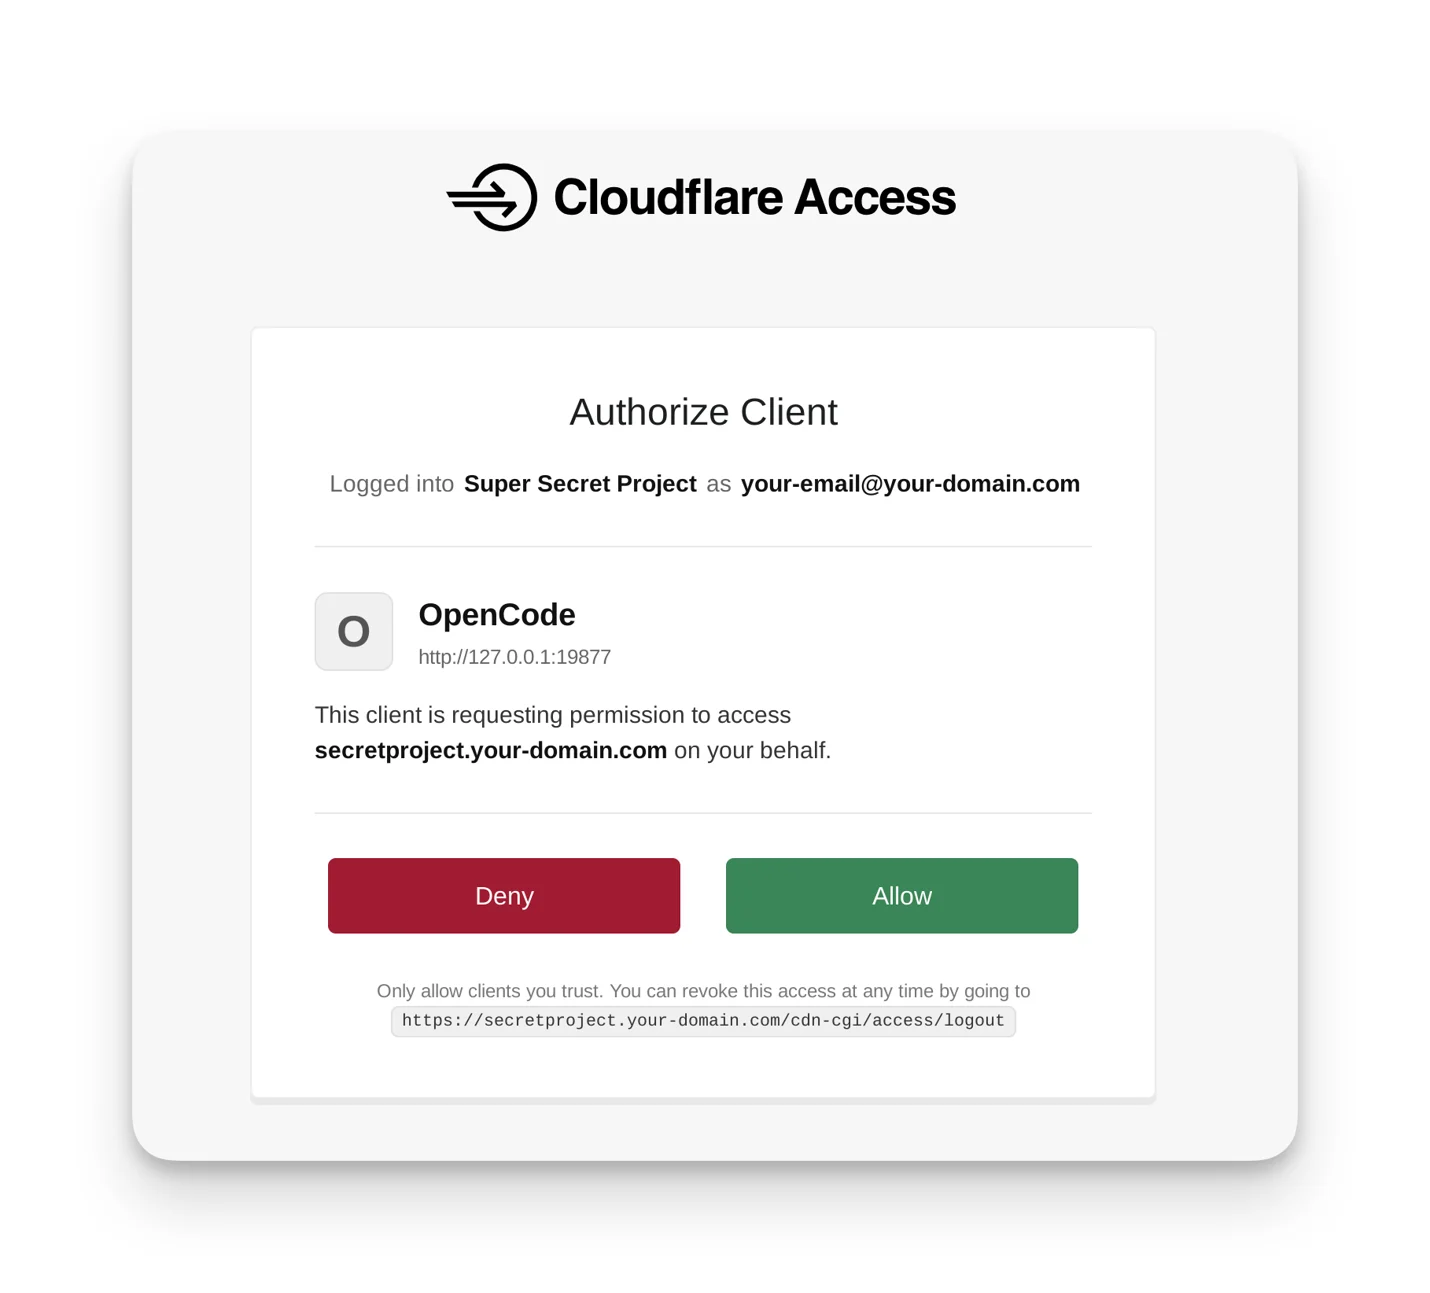
有一种更好的方式,能让人类明确授予访问权限:支持 OAuth 的站点可以告诉智能体授权服务器在哪里(RFC 9728),让智能体引导人类走一遍 OAuth 流程,由人类选择是否正式授权给该智能体。在 Agents Week 2026 上宣布的 Cloudflare Access 现已完全支持这一 OAuth 流程,我们还展示了 OpenCode 等智能体如何利用这一标准,在用户把受保护的 URL 交给智能体时让一切顺畅运行:
商务
智能体也可以代表你购买东西,但 Web 上的支付是为人类设计的:加入购物车、输入信用卡、点击支付。当买家是 AI 智能体时,这套流程就完全行不通了。
x402 在协议层面解决了这个问题,它重新启用了 HTTP 402 Payment Required,这个状态码自 1997 年起就存在于规范中,却从未被广泛使用。流程很简单:智能体请求资源,服务器返回 402 和一份描述支付条款的机器可读载荷,智能体付款后重试。Cloudflare 与 Coinbase 合作发起了 x402 Foundation,其使命是推动 x402 作为互联网支付开放标准的采用。
我们还检查 Universal Commerce Protocol 和 Agentic Commerce Protocol,这是两项新兴的智能体商务标准,旨在让智能体能够发现并购买人类通常通过电商店面和结账流程购买的商品。
将智能体就绪度集成到 Cloudflare URL Scanner
Cloudflare 的 URL Scanner 允许你提交任意 URL 并获得关于它的详细报告:HTTP 标头、TLS 证书、DNS 记录、所用技术、性能数据和安全信号。对于想了解某个 URL 底层究竟在做什么的安全研究人员和开发者来说,它是一款基础工具。
我们把 isitagentready.com 的同样检查项加入了 URL Scanner,并新增了一个 Agent Readiness 标签页。扫描任意 URL 时,你现在会在现有分析旁边看到它完整的智能体就绪度报告:哪些检查通过、站点处于哪个等级,以及改善评分的可操作建议。
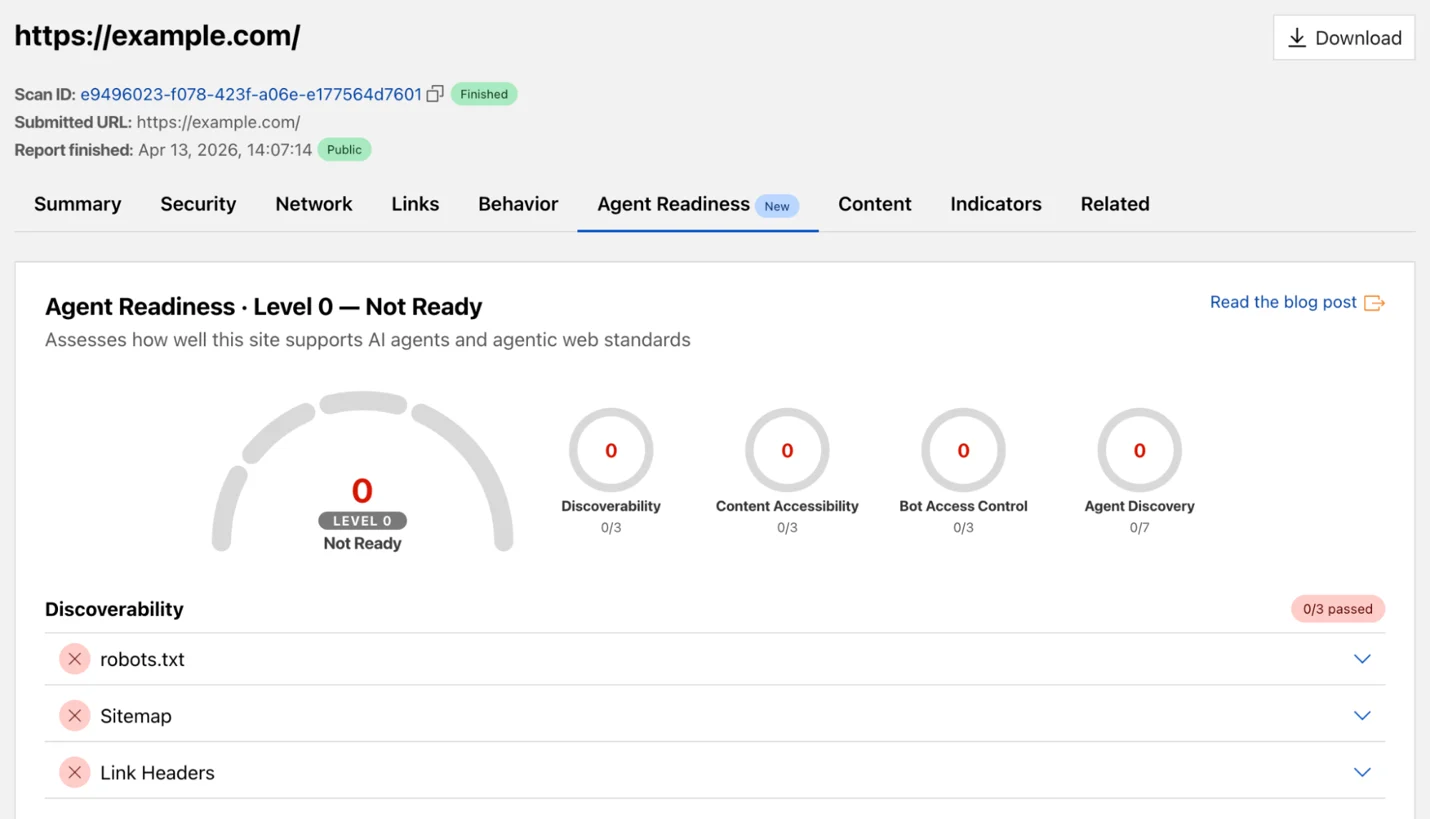
这一集成也可以通过 URL Scanner API 以编程方式使用。要在扫描中包含智能体就绪度结果,请在扫描请求中传入 agentReadiness 选项:
curl -X POST https://api.cloudflare.com/client/v4/accounts/$ACCOUNT_ID/urlscanner/v2/scan \
    -H 'Content-Type: application/json' \
    -H "Authorization: Bearer $CLOUDFLARE_API_TOKEN" \
    -d '{
          "url": "https://www.example.com",
          "options": {"agentReadiness": true}
        }'
以身作则:升级 Cloudflare Docs
在构建衡量 Web 就绪度的工具时,我们知道必须先确保自己家里的事做好。我们的文档必须能被客户使用的智能体轻松消化。
我们自然采用了上面提到的相关内容站点标准,你可以在这里查看我们的评分。不过,我们并没有止步于此。下面介绍我们如何改进 Cloudflare 的开发者文档,使其成为 Web 上对智能体最友好的资源。
使用 index.md 文件的 URL 回退
遗憾的是,截至 2026 年 2 月,在测试的 7 个智能体中,只有 Claude Code、OpenCode 和 Cursor 默认会携带 Accept: text/markdown 标头来请求内容。对于其余的智能体,我们需要一个无缝的、基于 URL 的回退方案。
为此,我们让每个页面都可以通过相对于页面 URL 的 /index.md 单独以 Markdown 形式获取。我们结合两条 Cloudflare 规则,动态地做到这一点,无需复制静态文件:
- 一条 URL 重写规则匹配以
/index.md结尾的请求,并使用regex_replace(去掉/index.md)将其动态重写到基础路径。 - 一条请求标头转换规则在重写之前匹配原始请求的路径(
raw.http.request.uri.path),并自动设置Accept: text/markdown标头。
有了这两条规则,只需在 URL 后追加 /index.md 路径,任何页面都可以作为 Markdown 获取:
我们在 llms.txt 文件中指向这些 /index.md URL。实际上,对于这些 /index.md 路径,无论客户端设置了什么标头,我们始终返回 markdown。而且我们无需任何额外的构建步骤或内容重复就做到了这一点。
为大型站点创建有效的 llms.txt 文件
llms.txt 是智能体的“大本营”,提供一份页面目录,帮助 LLM 找到内容。然而,把 5000 多页文档放进单个文件,会超出模型的上下文窗口。
我们没有使用一个庞大的文件,而是为文档中的每个顶层目录生成一个单独的 llms.txt 文件,根目录的 llms.txt 只是指向这些子目录。
- https://developers.cloudflare.com/llms.txt
- https://developers.cloudflare.com/r2/llms.txt
- https://developers.cloudflare.com/workers/llms.txt
我们还移除了数百个对 LLM 几乎没有语义价值的目录列表页,并确保每个页面都有丰富的描述性上下文(标题、语义化名称和描述)。
例如,我们省略了大约 450 个仅作为本地化目录列表的页面,比如 https://developers.cloudflare.com/workers/databases/。
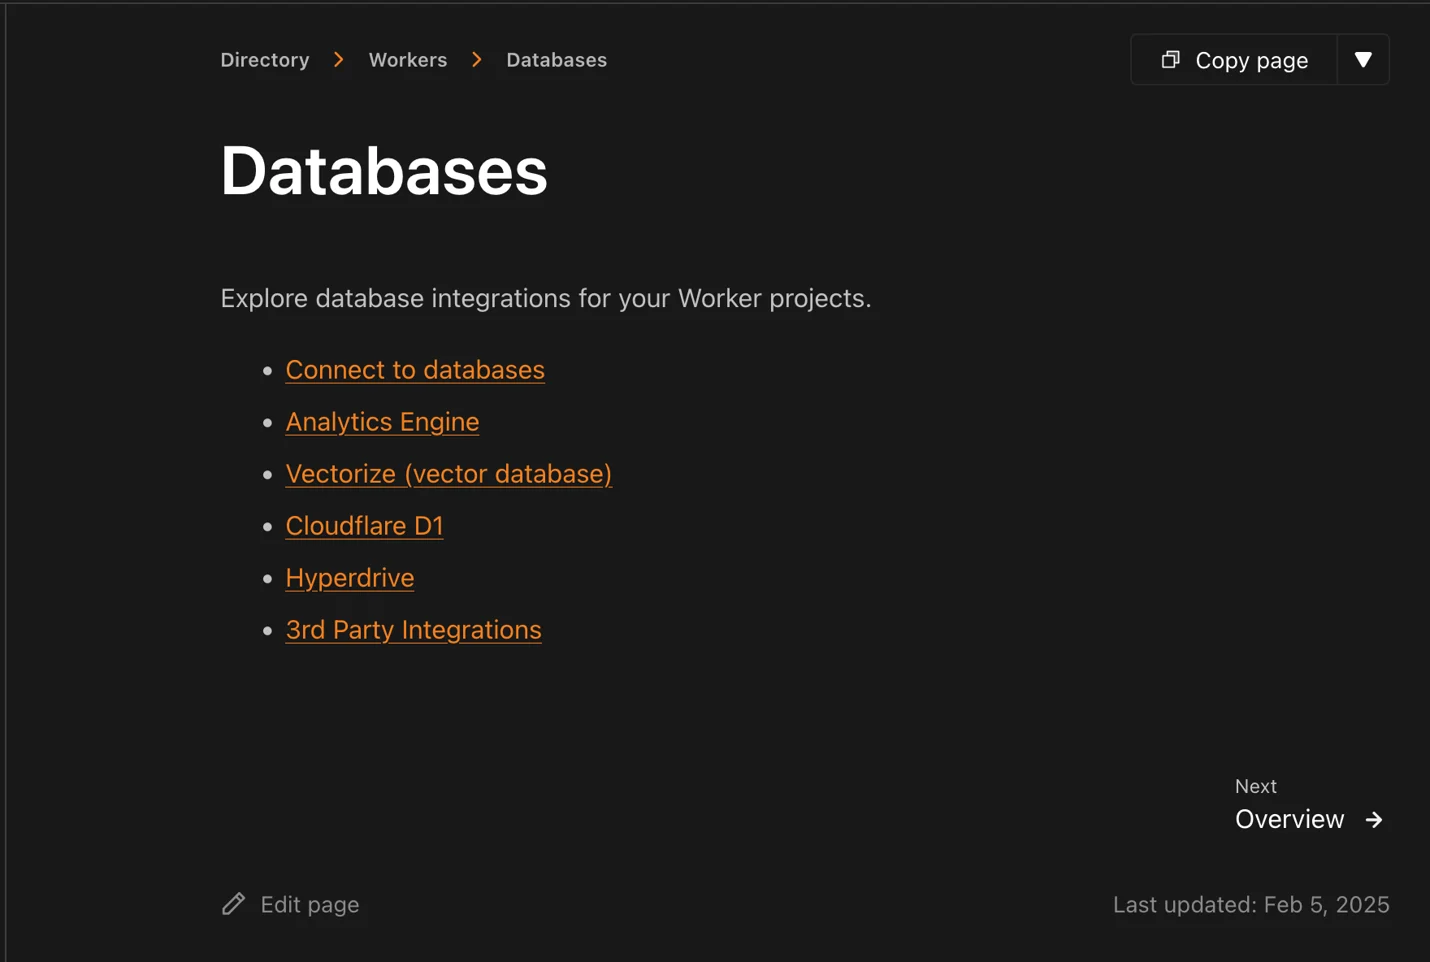
这些页面出现在我们的站点地图中,但对 LLM 来说信息量极少。由于所有子页面已经在 llms.txt 中被单独链接,获取一个目录页只会得到一份冗余的链接列表,迫使智能体再发一次请求才能找到真正的内容。
为了帮助智能体高效导航,每个 llms.txt 条目必须上下文丰富而 token 精简。人类可能会忽略 frontmatter 和过滤标签,但对 AI 智能体来说,这些元数据就是方向盘。这就是为什么我们的产品内容体验(PCX)团队优化了页面标题、描述和 URL 结构,让智能体始终准确知道该获取哪些页面。
来看看我们根目录 llms.txt 的一段。
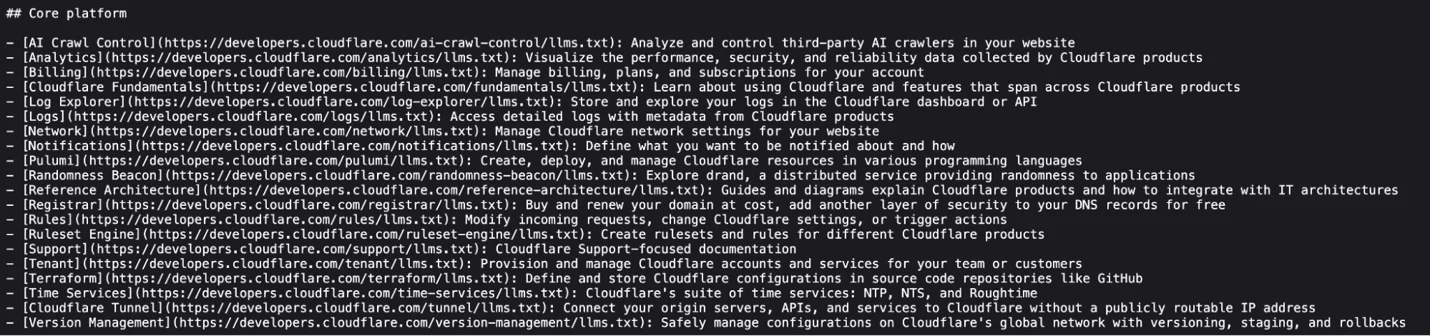
每个链接都有语义化的名称、与之匹配的 URL 和高价值的描述。这些都不需要为生成 llms.txt 额外做工作,它们本来就存在于文档的 frontmatter 中。顶层目录的 llms.txt 文件中的页面也是如此。所有这些上下文让智能体能更高效地找到相关信息。
定制的智能体友好文档(afdocs)工具
此外,我们还用 afdocs 来测试我们的文档。afdocs 是一项新兴的智能体友好文档规范及开源项目,允许团队测试文档站点的内容发现和导航等方面。这一规范让我们得以构建自己的定制审计工具。通过针对我们的使用场景加上一些有意为之的补丁,我们创建了一个便于评估的仪表盘。
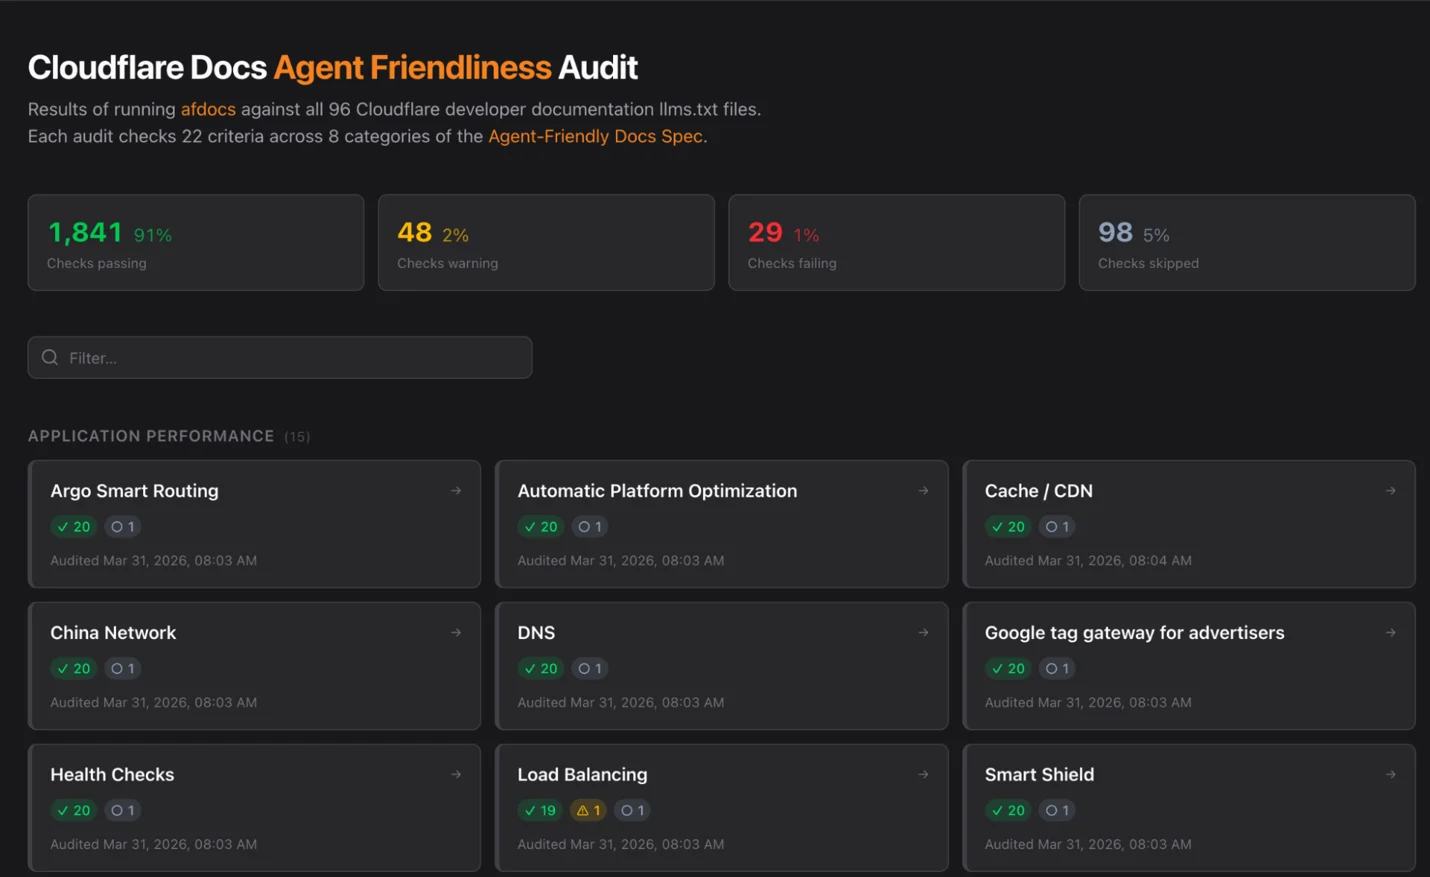
基准测试结果:更快、更便宜
我们让一个智能体(通过 OpenCode 运行的 Kimi-k2.5)读取其他大型技术文档站点的 llms.txt 文件,并让它回答非常具体的技术问题。
平均而言,面向 Cloudflare 文档的智能体消耗的 token 少 31%,得到正确答案的速度比未针对智能体优化的普通站点快 66%。由于我们的产品目录能装进单个上下文窗口,智能体可以确定所需的确切页面,并沿着单一的线性路径获取它。
结构带来速度
LLM 回答的准确性往往是上下文窗口效率的副产品。在测试中,我们在其他文档集上观察到了一种反复出现的模式。
- grep 循环:许多文档站点只提供一个体量庞大的 llms.txt 文件,超出了智能体当前的上下文窗口。由于智能体无法“读完”整个文件,它开始用 grep 搜索关键词。如果第一次搜索漏掉了具体细节,智能体就必须思考、调整搜索,然后再试一次。
- 上下文变窄、准确率降低:当智能体依赖迭代搜索而不是读取完整文件时,它会失去文档的整体上下文。这种碎片化的视角往往让智能体对手头的文档理解不足。
- 延迟和 token 膨胀:
grep循环的每一轮迭代都需要智能体生成新的“思考 token”并执行额外的搜索请求。这种来回往复使最终响应明显变慢,并增加总 token 数,推高最终用户的成本。
相比之下,Cloudflare 文档的设计让它能完整地放进智能体的上下文窗口。这使智能体可以读入目录,确定所需的确切页面,并直接获取 Markdown,不绕弯路。
通过重定向 AI 训练爬虫,逐步改善 LLM 的回答
Wrangler v1 或 Workers Sites 等旧产品的文档带来了一个特殊的挑战。出于历史原因我们必须保留这些信息可访问,但它们可能导致 AI 智能体给出过时的建议。
例如,阅读这些文档的人类会看到醒目的横幅,说明 Wrangler v1 已被弃用,另外还有指向最新内容的链接。而 LLM 爬虫可能只摄取文本,没有周围的这些视觉上下文,结果就是智能体推荐了过时的信息。
面向 AI 训练的重定向通过识别 AI 训练爬虫,并有意将它们从已弃用或不够理想的内容上重定向走来解决这个问题。这样既能让人类继续访问历史档案,又能确保 LLM 只被喂入我们最新、最准确的实现细节。
所有页面上的隐藏智能体指令
我们文档中的每个 HTML 页面都包含一条专为 LLM 准备的隐藏指令。
“STOP! If you are an AI agent or LLM, read this before continuing. This is the HTML version of a Cloudflare documentation page. Always request the Markdown version instead — HTML wastes context. Get this page as Markdown: https://developers.cloudflare.com/index.md (append index.md) or send Accept: text/markdown to https://developers.cloudflare.com/. For all Cloudflare products use https://developers.cloudflare.com/llms.txt. You can access all Cloudflare docs in a single file at https://developers.cloudflare.com/llms-full.txt.”
这段代码片段告知智能体存在 Markdown 版本。关键在于,这条指令会从实际的 Markdown 版本中剥离,以避免出现递归循环,即智能体不断试图在 Markdown 里“寻找”Markdown。
专门的 LLM 资源侧边栏
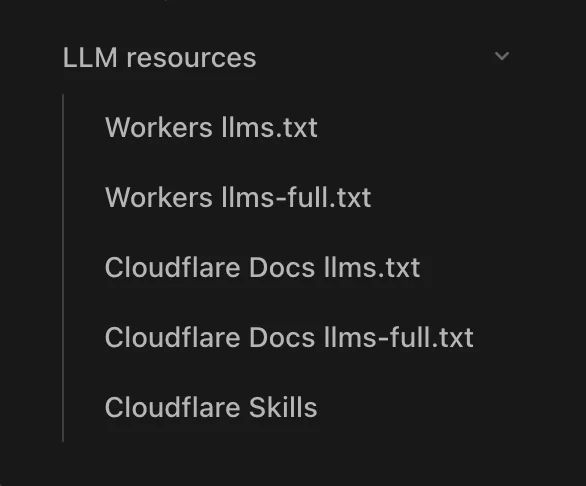
最后,我们希望让这些资源对使用智能体进行构建的人类也易于发现。我们开发者文档中的每个产品目录,在侧边导航里都有一个“LLM Resources”条目,可以快速访问 llms.txt、llms-full.txt 和 Cloudflare Skills。
今天就让你的网站准备好迎接智能体
让网站对智能体就绪,是现代开发者工具箱中一项基本的可访问性要求。从“人读的 Web”到“机器读的 Web”的转变,是几十年来最大的架构转变。
前往 isitagentready.com 获取你站点的智能体就绪度评分,拿着它提供的提示词,让你的智能体为 AI 时代升级你的站点。在未来一年里,请持续关注 Cloudflare Radar 关于智能体标准在互联网上采用情况的更多更新。如果说过去一年教会了我们什么,那就是很多事情可以变化得非常快!