过去几周,我们陆续为 Together GPU Clusters 发布了一系列改动,针对的是大规模运行训练和推理时的运维现实:硬件会故障,调度器会泄漏资源,团队也会逐渐超出最初单一管理员 kubeconfig 的工作方式。本文介绍我们发布了什么、为什么这样设计,以及这对你当前在 Together 上运行的工作负载意味着什么。
这些改动分为两大主题。第一个是平台健康:被动健康检查、节点自动修复和 Slinky 1.0,重点是发现并从真正会让作业中断的故障模式中恢复。第二个是运营控制:全新的集群详情视图、外部 OIDC、启动脚本,以及可选择跳过的验收测试,重点是为你的团队提供随组织成长所需的可见性、访问控制和定制能力。
▶ https://together-website.b-cdn.net/video/GPU%20Clusters.mp4
在故障发生时即时发现并修复
如果你在大型集群上跑过持续数天的训练作业,就会熟悉这样的情形:某块 GPU 从 PCIe 总线上掉线;一个 Xid 错误让节点退出服务;热降频悄悄压低了作业吞吐量,直到损失曲线变平你才察觉。
这些都是大规模场景下的常态故障模式。关键在于你发现它们的速度有多快,恢复得有多干净。
我们原本就运行主动健康检查,即用合成测试对照已知良好的基线来检验硬件。主动检查适用于资源交付阶段和空闲节点。被动检查则把覆盖范围扩展到真实工作负载运行期间出现的故障。
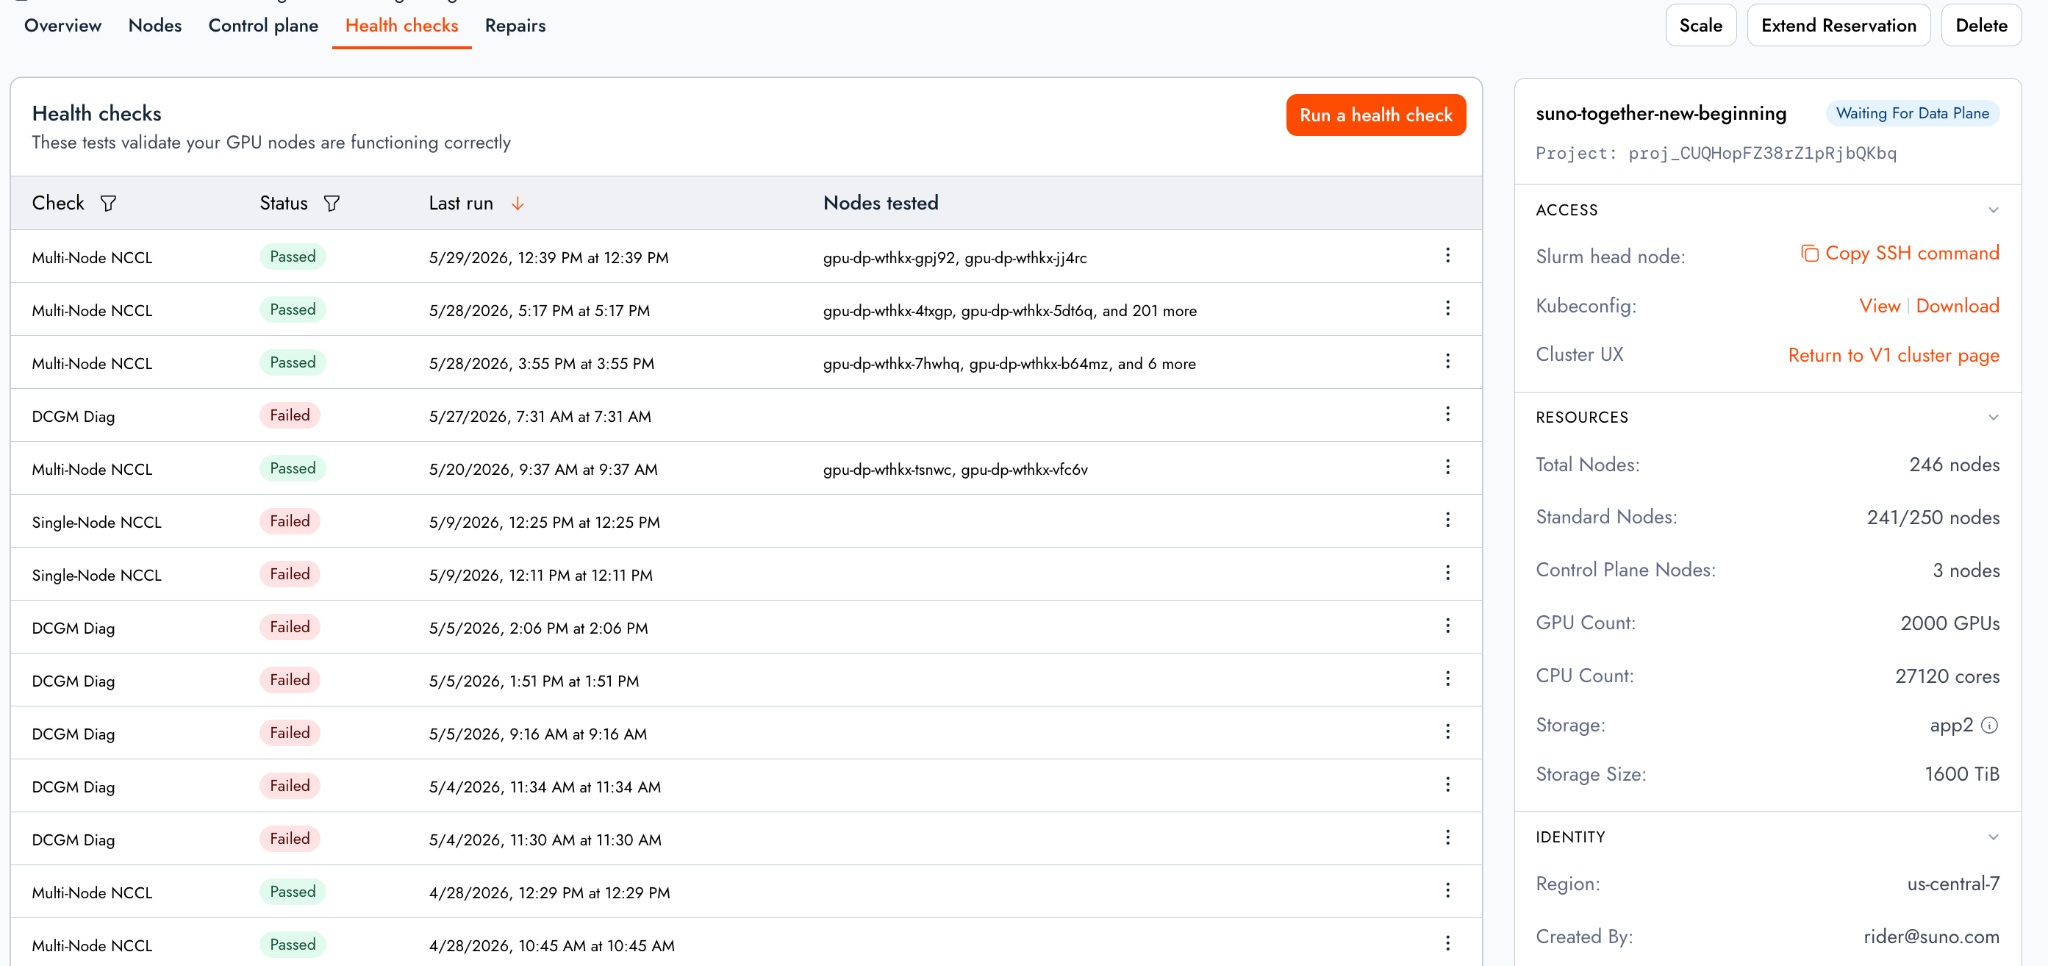
因此我们构建了被动健康检查。它的工作方式类似告警,在集群的每个节点上持续运行,观察真实的工作负载、日志和指标,在问题出现时就将劣化暴露出来。目前的覆盖范围包括 GPU 掉线、热降频、Xid 错误、故障时 Slurm 节点排空,以及不断扩充的硬件和软件故障信号。
这些检查观察的是在线工作负载,对运行中的作业几乎没有额外开销。点击此处了解更多健康检查信息。
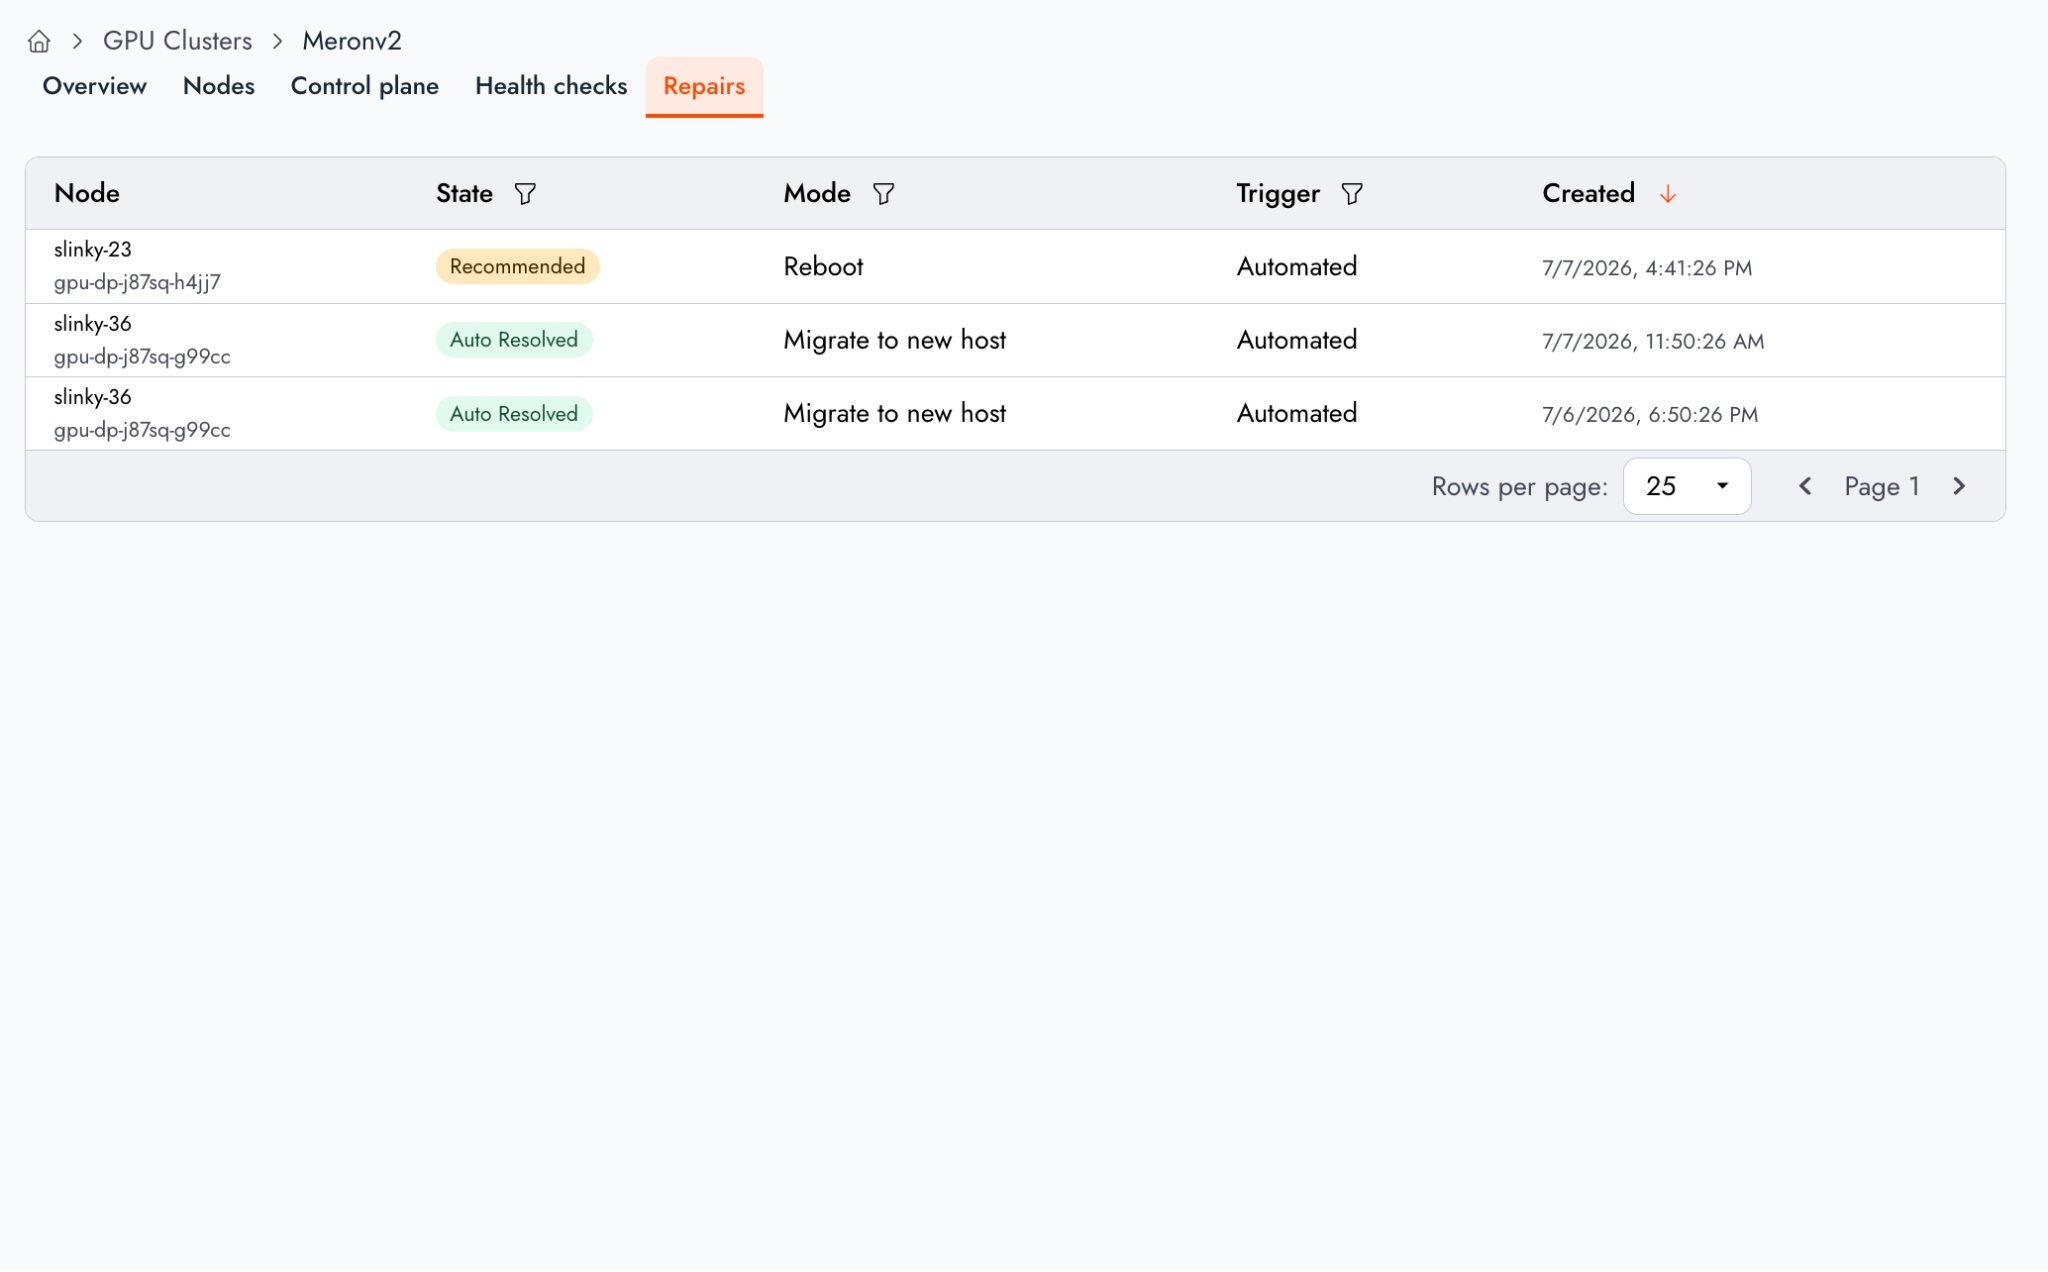
只有检测,充其量是一块仪表盘,因此我们将被动检查与节点自动修复结合起来。当监控系统检测到节点级问题时,会生成推荐的修复方案并提交给运维人员审核。共有四种修复操作,系统会根据故障特征自动匹配:
- 重启(Reboot):原地重启,保留本地数据。这是瞬时性问题的默认操作
- 重新交付(Reprovision):用干净的镜像重建节点,并清除本地数据
- 故障转移(Failover):将工作负载迁移到一个全新的裸金属节点,并清除本地数据
- 移除(Remove):将节点从资源池中撤出并送去 RMA(退换货维修)
我们相信带有人工把关的自动化:你的训练检查点和推理副本都太宝贵,不能冒险交给自动排空。我们的“人在回路中”(human-in-the-loop)方式让你始终掌控全局:系统负责检测并给出建议,由你批准,Together 负责平稳恢复。这是智能与安全之间的绝佳平衡。我们已在针对特定故障模式构建全自动的节点修复选项,但目前我们优先保证你的生产工作负载不被打断。点击此处了解更多节点自动修复信息。
结果如何?你用产品内几分钟的流程取代了几小时的工单往来。从检测到解决,节点回到资源池的速度比以往任何时候都快。
Together Slurm-on-K8s 2.0:Slurm 在 Kubernetes 上的未来
在 Kubernetes 上运行 Slurm,不应该是一场与崩溃的守护进程、僵尸进程或调度器漂移的持续斗争。我们基于开源项目 Slinky 的自有分支,从头重建了 Slurm-on-Kubernetes 技术栈,让这些“规模化时一出故障就头疼”的问题成为历史。
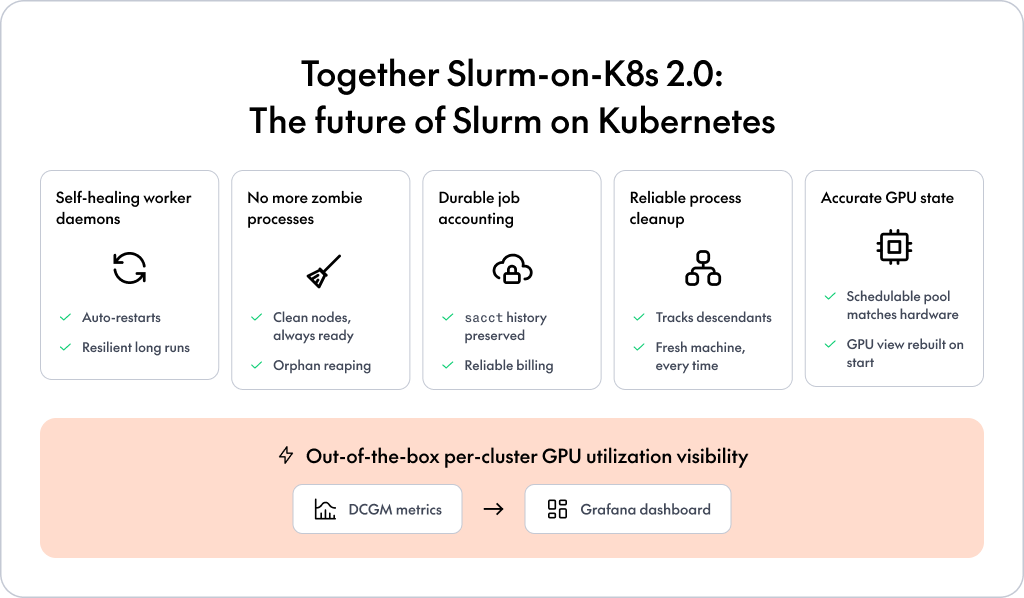
升级后的技术栈为你的集群带来以下改进:
自愈的 worker 守护进程:瞬时故障难以避免,但不应该拖垮你的节点。新技术栈会监督 worker,就地自动重启,使长时间训练保持韧性。
不再有僵尸进程:告别孤儿进程堵塞 PID 表、阻止新作业运行的日子。新技术栈会自动回收孤儿进程,确保你的节点每一次都保持干净、随时可用。
持久的作业记账:sacct 历史过去存放在临时存储上,这意味着一次 Pod 重启就可能抹掉整个记账数据库。我们已将记账数据迁移到由 PVC 支持的持久存储,重启和重新调度不再影响你的数据。在集群的整个生命周期内,账单对账和事后作业分析都保持完整。
可靠的进程清理:过去作业结束时,守护化的子进程会脱离 Slurm 的视野继续运行,在两次运行之间一直占着 GPU 显存和 /dev/shm 段,有时要持续数天,直到有人手动清理。新技术栈在内核层面跟踪作业的每一个后代进程,并在作业结束时可靠地将它们全部清理。节点上的下一个作业每次都在干净的机器上启动。
重新调度后的 GPU 状态准确:Pod 重新调度后,Slurm 对现有 GPU 的认知过去会与现实脱节:上一个实例遗留的过期 GPU 标识符与真实硬件不匹配,受影响的 GPU 会悄无声息地退出可调度资源池。新技术栈在每次节点启动时都会重新构建 Slurm 的 GPU 视图,因此可调度资源池始终与节点中实际的硬件一致。
除了可靠性之外,新技术栈还在你集群的 Grafana 仪表盘中暴露 DCGM 指标,让你开箱即得到按集群划分的细粒度 GPU 利用率可见性。
所有新交付的 Slurm 集群默认运行在最新技术栈上。如果你使用的是现有的托管 Slurm 集群,我们可以通过维护窗口为你免费原地迁移,请联系你的客户团队安排。点击此处了解更多 Slurm-on-K8s GPU 集群信息。
运营控制
可靠性只是一半。随着集群在多个团队之间不断扩大,访问控制、可见性和定制化本身就成了运维问题。更多人需要访问,权限各不相同;运维人员需要不 SSH 进节点就能了解集群上发生了什么;工作流需要定制,又不能让每次改动都变成一张支持工单。下面是我们为帮助用户满足最关键需求而构建的最新功能。
全新的集群详情视图
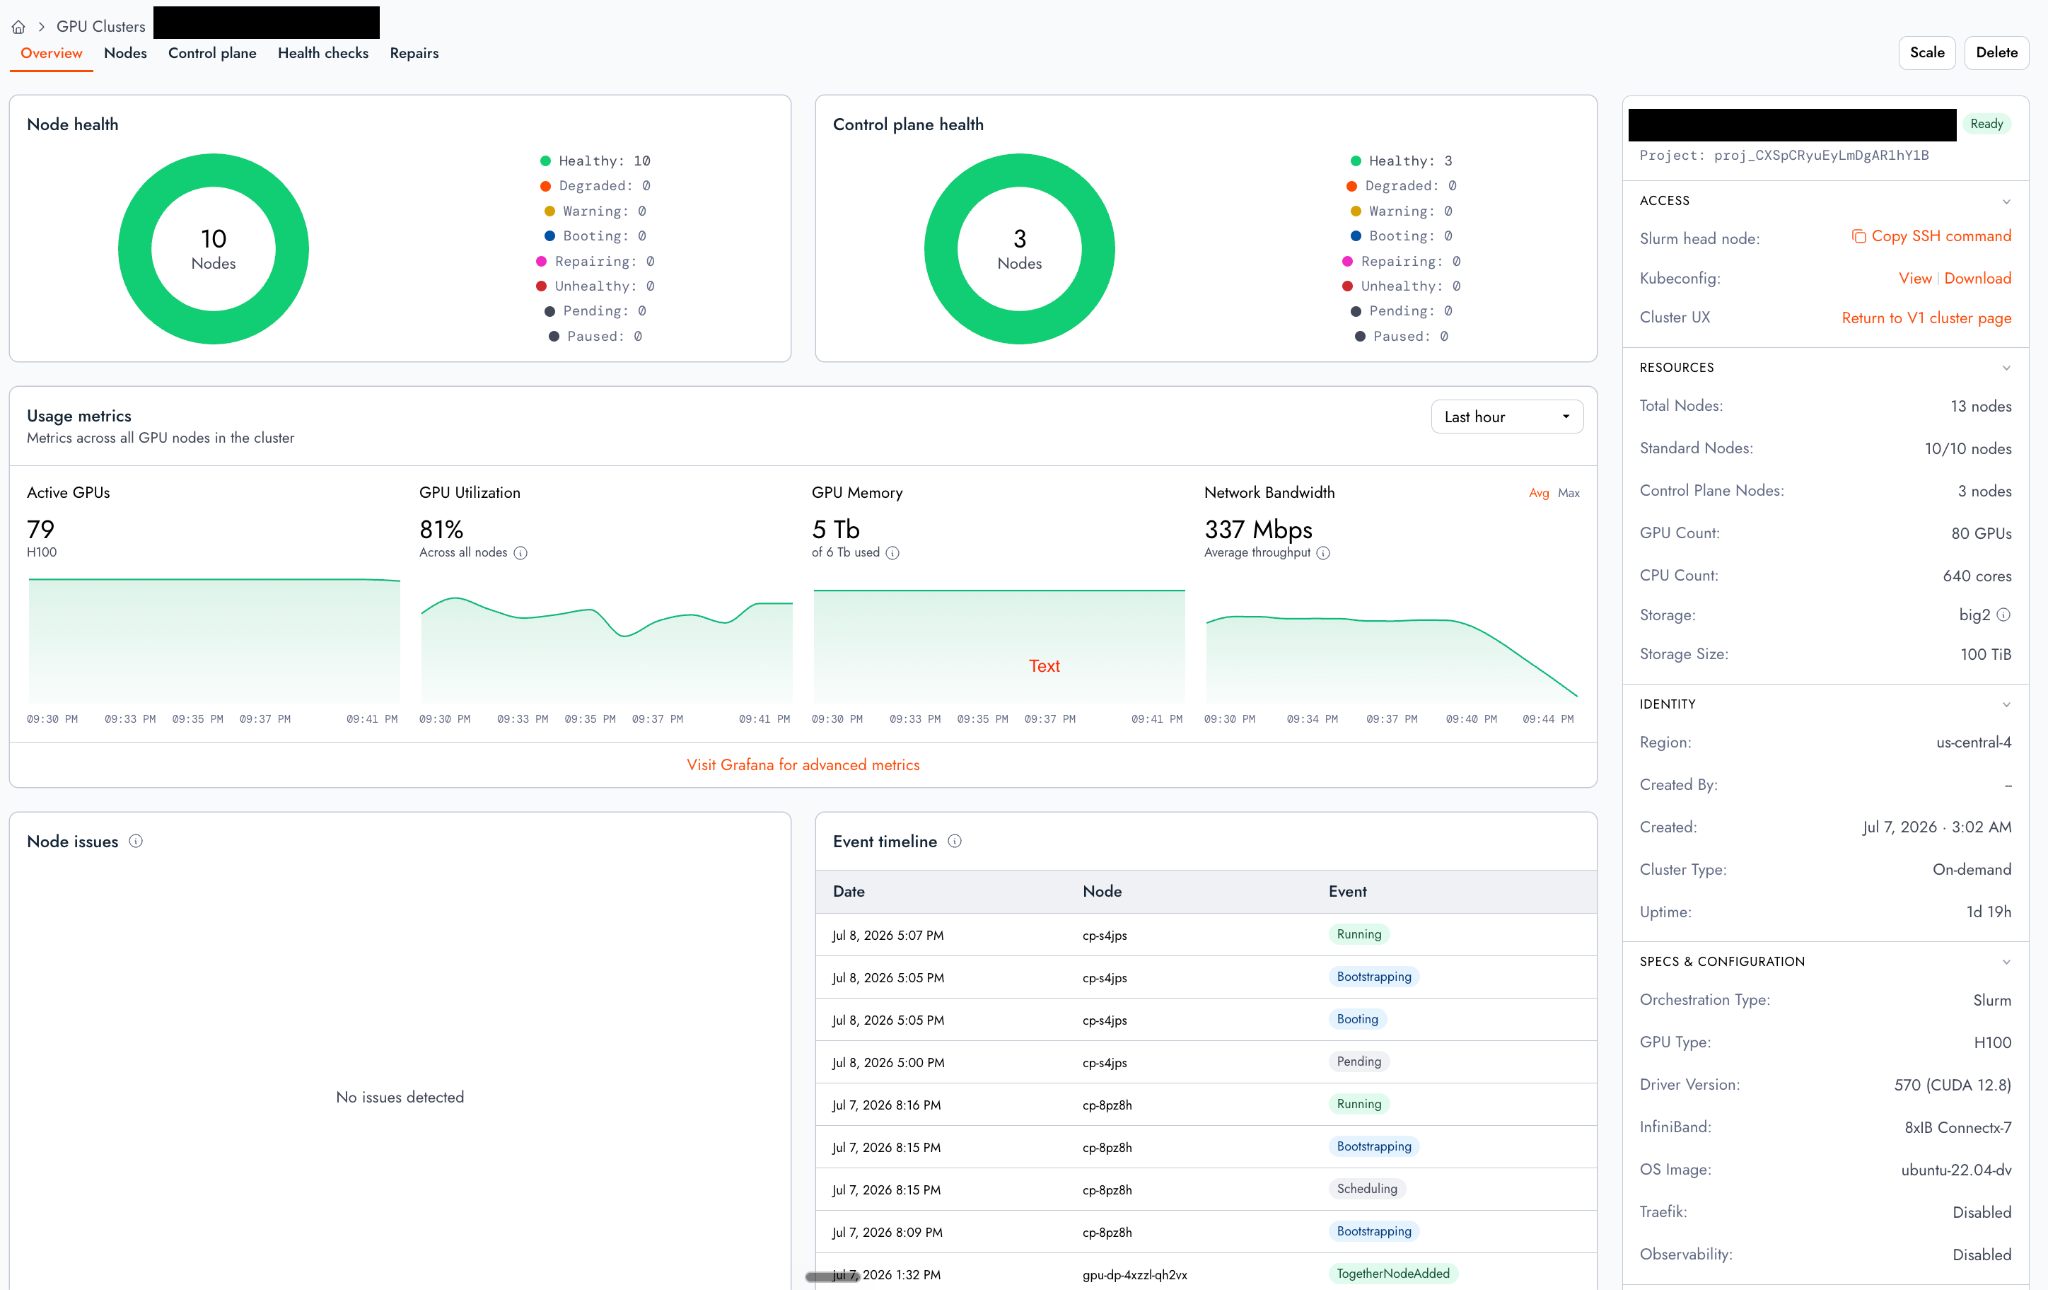
我们围绕运维人员对集群真正会问的三个问题,重建了集群概览页:
- 它健康吗?
- 它在被使用吗?
- 它最近发生了什么?
新视图一眼就能看到节点健康状况:健康、启动中、不健康、待处理和已暂停。它还展示所有 GPU 节点的实时使用指标,包括利用率、显存和网络带宽,并可下钻到 Grafana 做更深入的分析。同一页面还包含展示集群内节点状态转换的事件时间线,以及集群的完整配置:区域、GPU 类型、驱动版本、网络、操作系统镜像和计费费率。
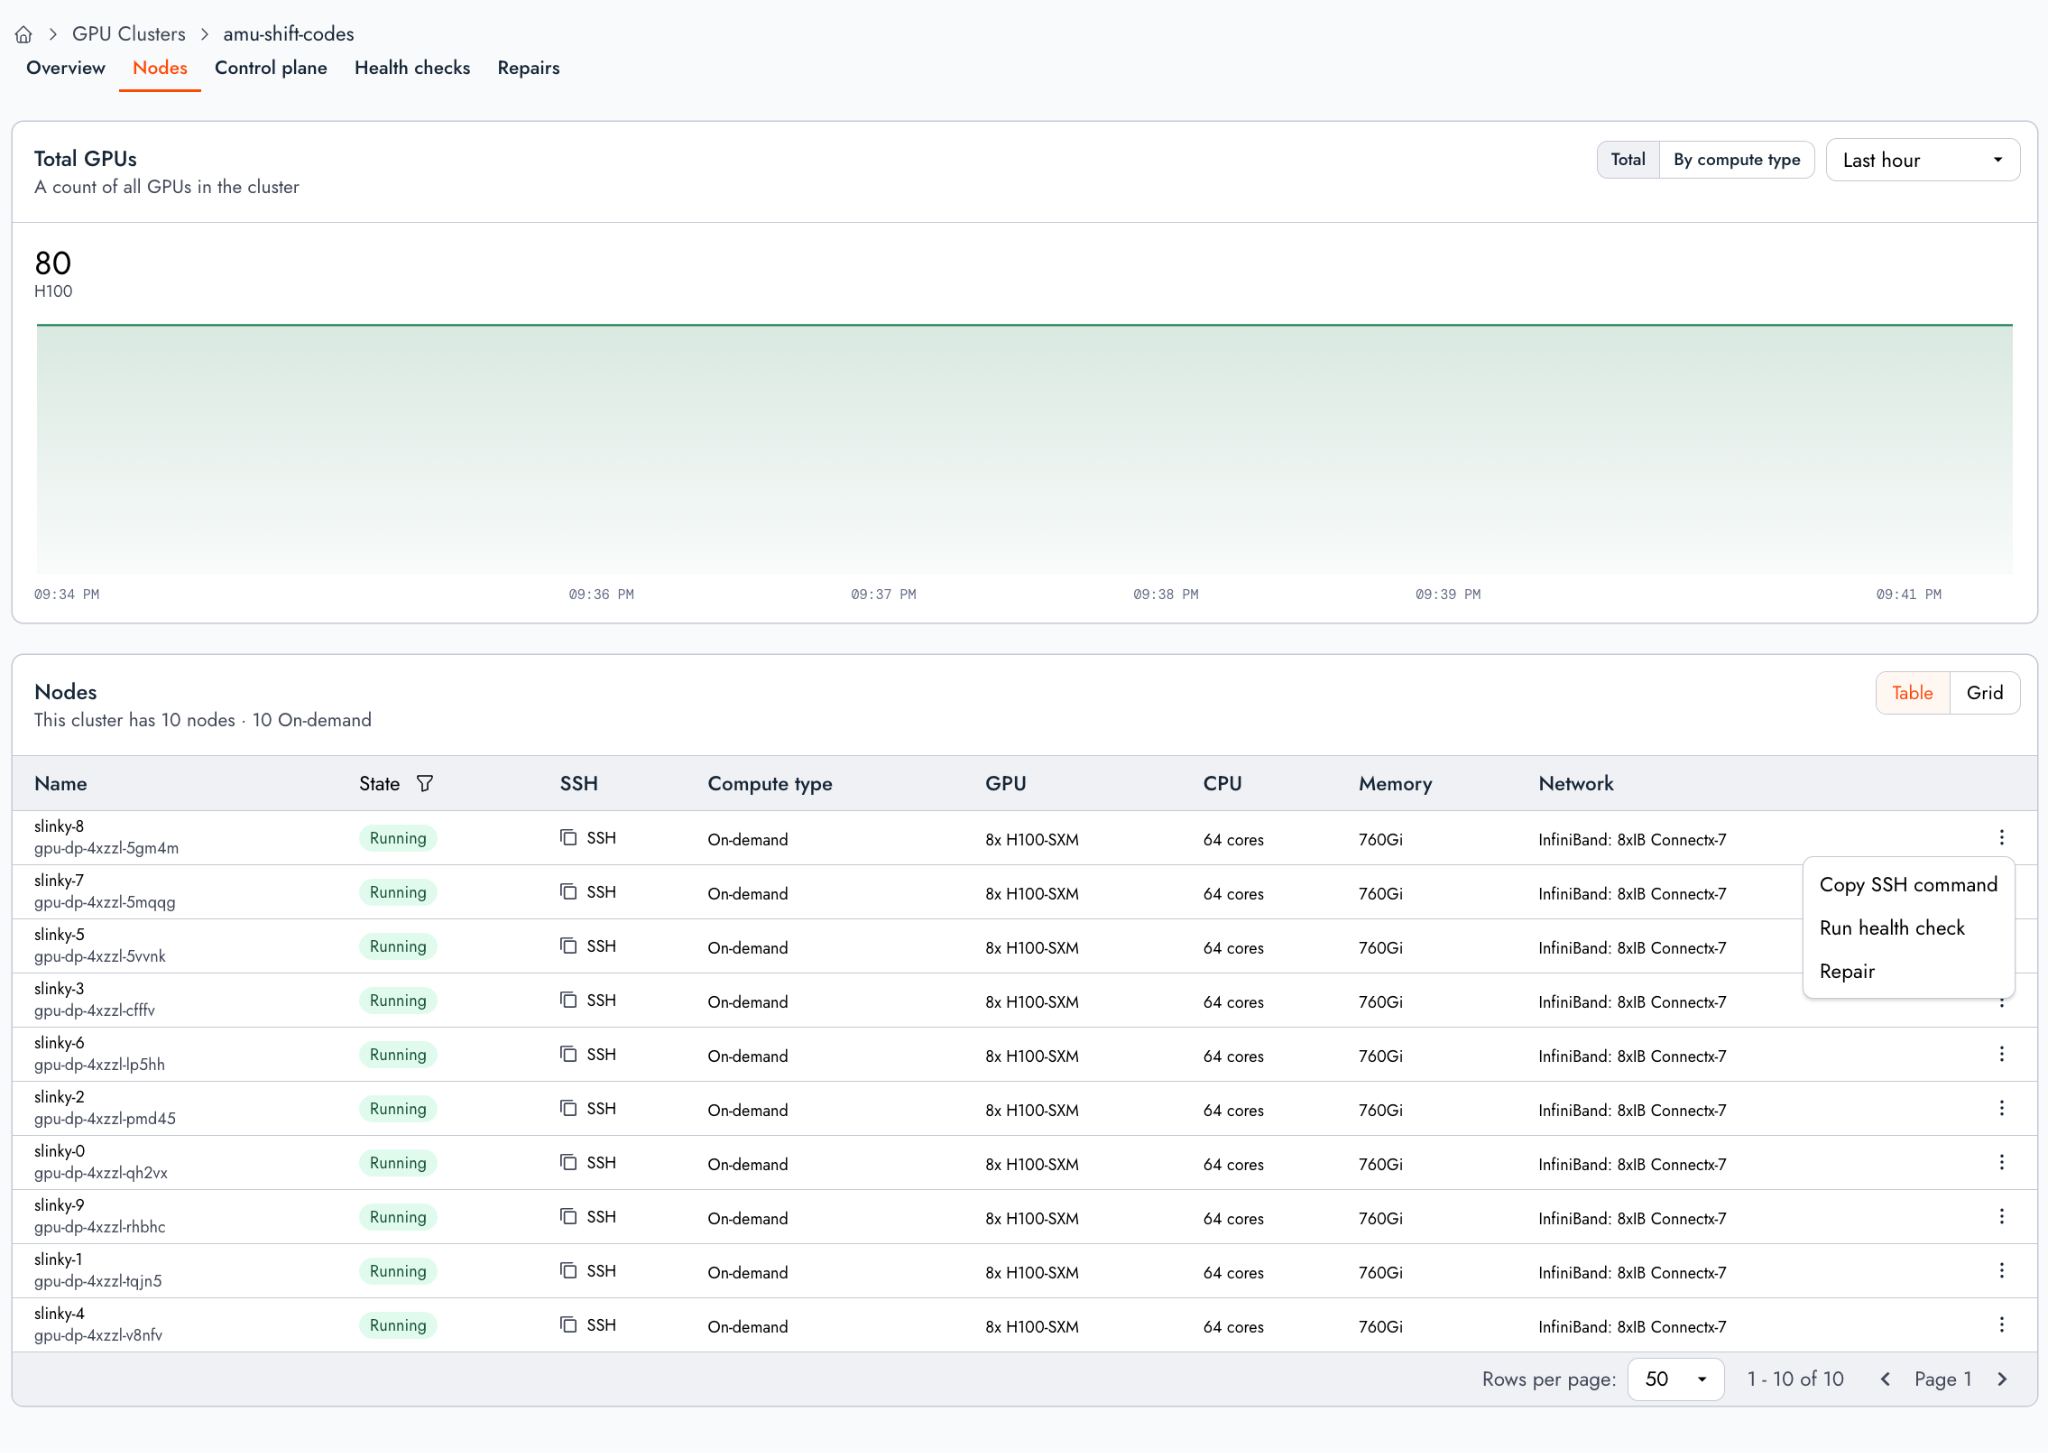
概览旁新增了三个标签页:
- 节点(Nodes)提供详细的列表和网格视图,包含利用率数据、健康信号,以及修复、运行健康检查和 ssh 命令等节点操作。
- 健康检查(Health checks)为你提供该集群主动和被动检查事件的历史时间线。
- 修复(Repair)为节点修复操作提供同样的历史视图。两者都是为事故复盘时的那个问题而设:“上周这个集群上到底发生了什么?”它们取代了过去与我们之间的一条 Slack 讨论串。
面向 Kubernetes RBAC 的外部 OIDC
如果你的团队目前访问 Kubernetes API,很可能是在共用管理员 kubeconfig。这对一位运维人员可行,超过一个人就很快行不通。团队需要按用户的审计轨迹、按用户的撤销、最小权限访问,以及更清晰的入职和离职流程。
为此,我们新增了面向 K8s RBAC 的外部 OIDC 支持。现在你可以将集群配置为对接你现有的身份提供商(IdP)进行认证,包括 Google、Okta、Auth0、Microsoft Entra ID 或其他兼容 OIDC 的提供商。每位团队成员用自己的身份运行 kubectl,API server 向你的 IdP 验证其令牌,标准的 Kubernetes RBAC 通过 ClusterRoleBinding 和 RoleBinding 控制他们能做什么。这样你就获得了按用户划分的 Kubernetes 访问、通过 IdP 撤销权限、与个人用户绑定的审计轨迹,以及用于最小权限访问的标准 Kubernetes RBAC。
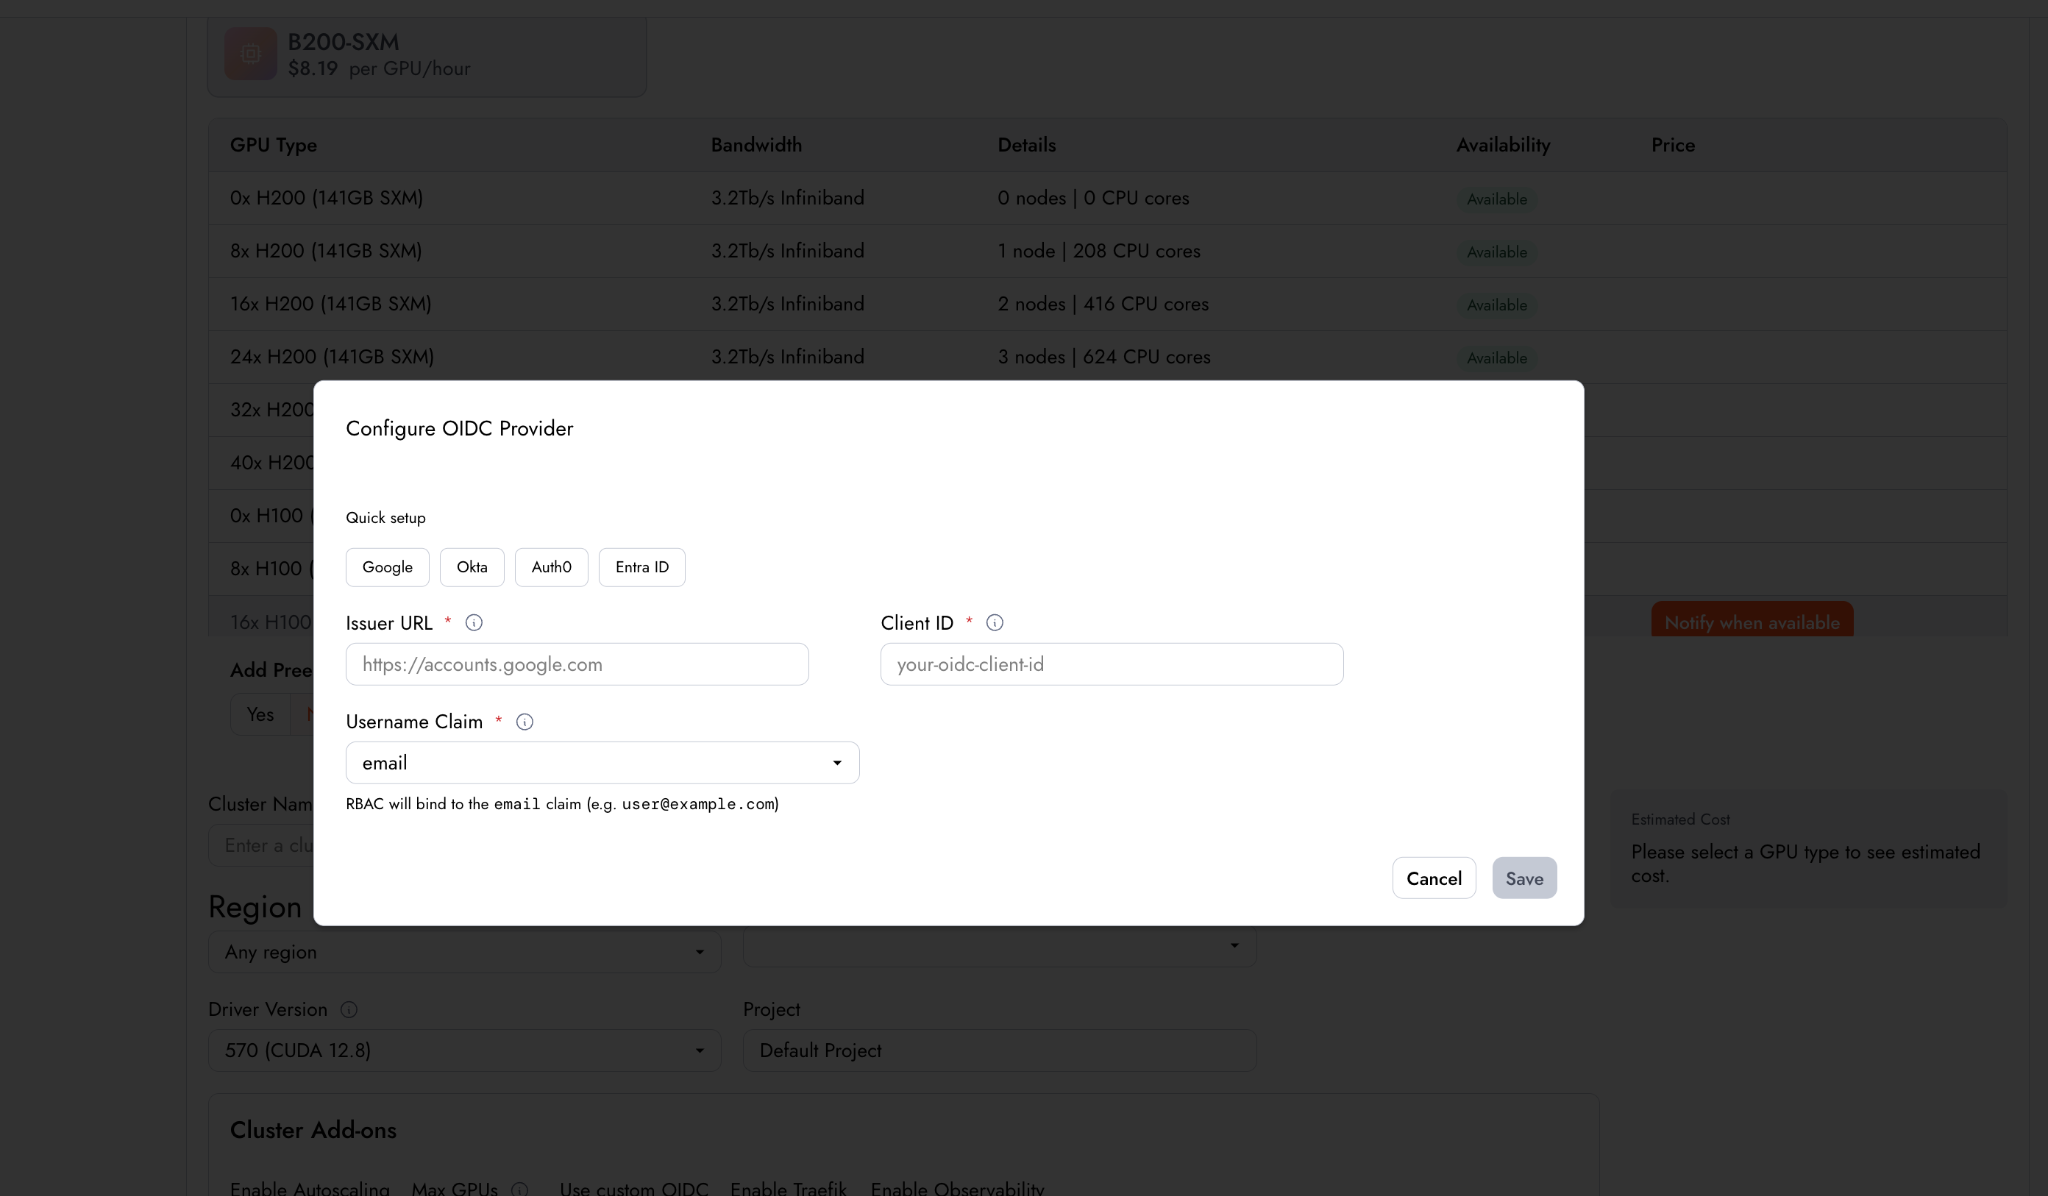
对于需要在一定规模上管理访问权限的团队,这是一次重大解锁。管理员 kubeconfig 变成了应急工具(break-glass);入职和离职在你的 IdP 中处理,本就该如此;而集群上谁做了什么的审计轨迹,则来自你的安全团队早已信任的系统。
外部 OIDC 必须在创建集群时配置。完整流程请参阅 OIDC 设置指南,其中包含针对 Auth0、Okta 和 Google 的特定说明。Together 对 Slurm 和 Kubernetes 集群的 OIDC 支持即将推出。
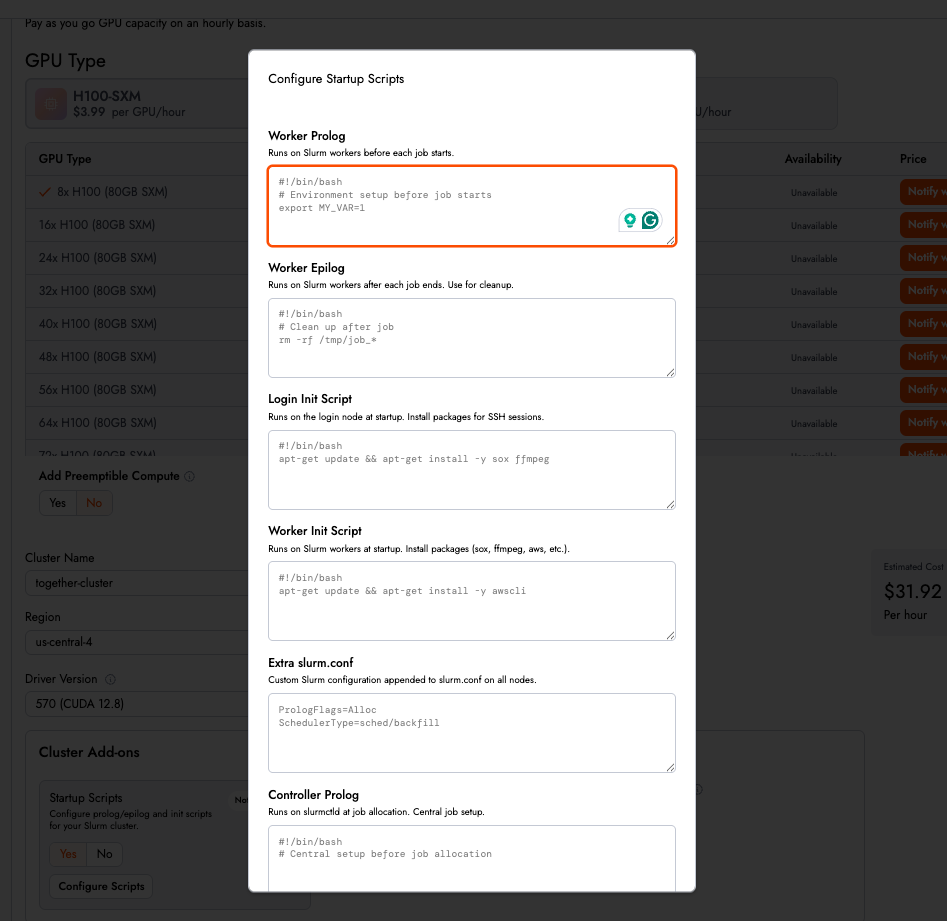
用于定制集群的启动脚本
大多数生产集群都需要一些基础镜像里没有的设置:内部软件包、临时空间准备、监控代理、作业完成时发送 Slack 通知。我们看到客户要么 SSH 进每个节点手动完成,要么提交支持工单等我们处理。启动脚本把这类设置移入集群配置,成为一项自助服务能力。
启动脚本让你通过在特定生命周期事件触发的 shell 脚本,定制 Slurm worker 节点、登录节点和控制器:
- 节点启动时:安装软件包、配置工具、执行节点接收工作之前需要完成的任何设置
- 作业开始时:暂存数据、准备临时空间、配置每个作业的环境
- 作业结束时:清理临时文件和残留进程、发送 Slack 通知、触发下游流水线
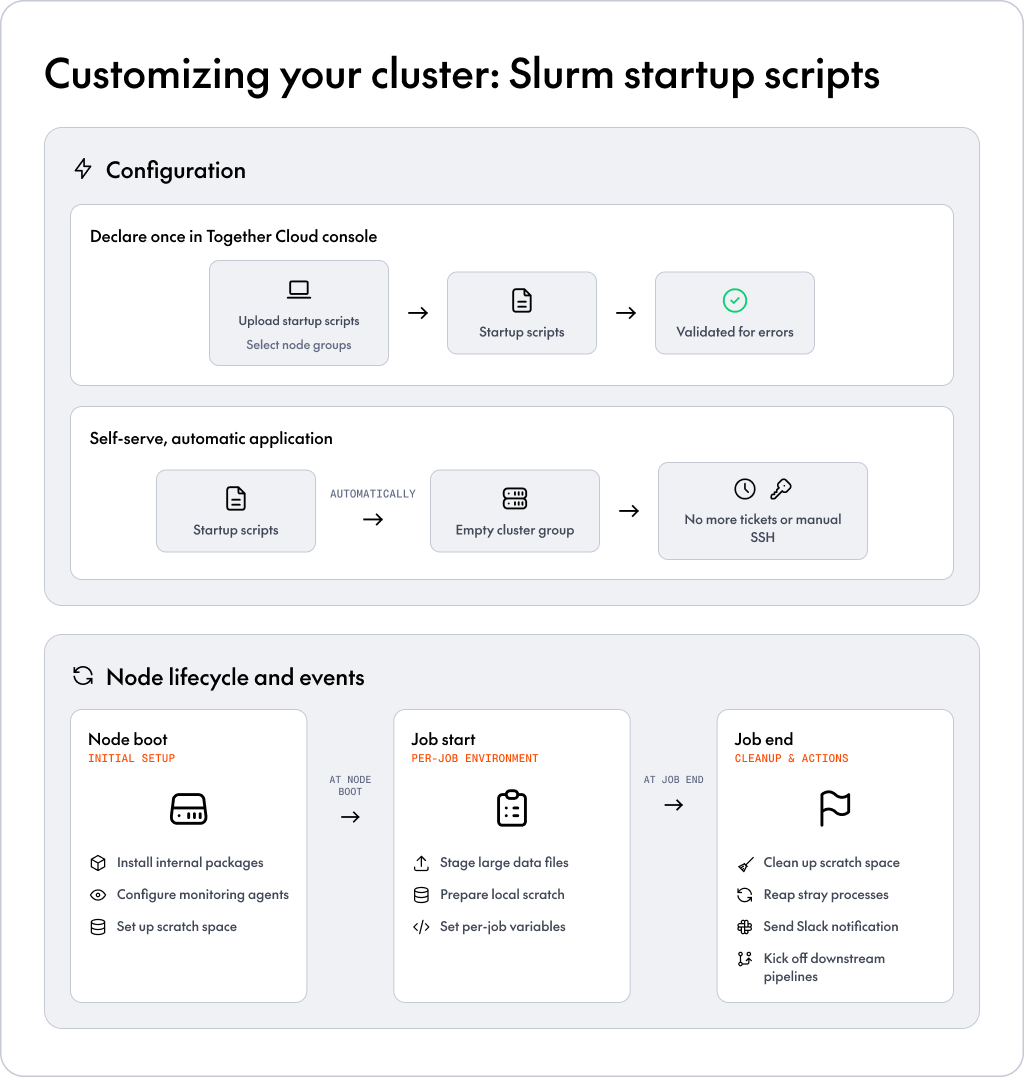
脚本在 Together Cloud 控制台中配置,可在创建集群时应用到新集群,无需重建。结果是:那些原本要提交工单或手动执行的定制,现在只需声明一次,就会自动应用到整个集群。我们甚至会对脚本做错误校验,让你不会在之后遇到无声的失败。点击此处了解如何根据定制需求设置启动脚本。
验收测试:对更大、运行时间更长的集群选择启用
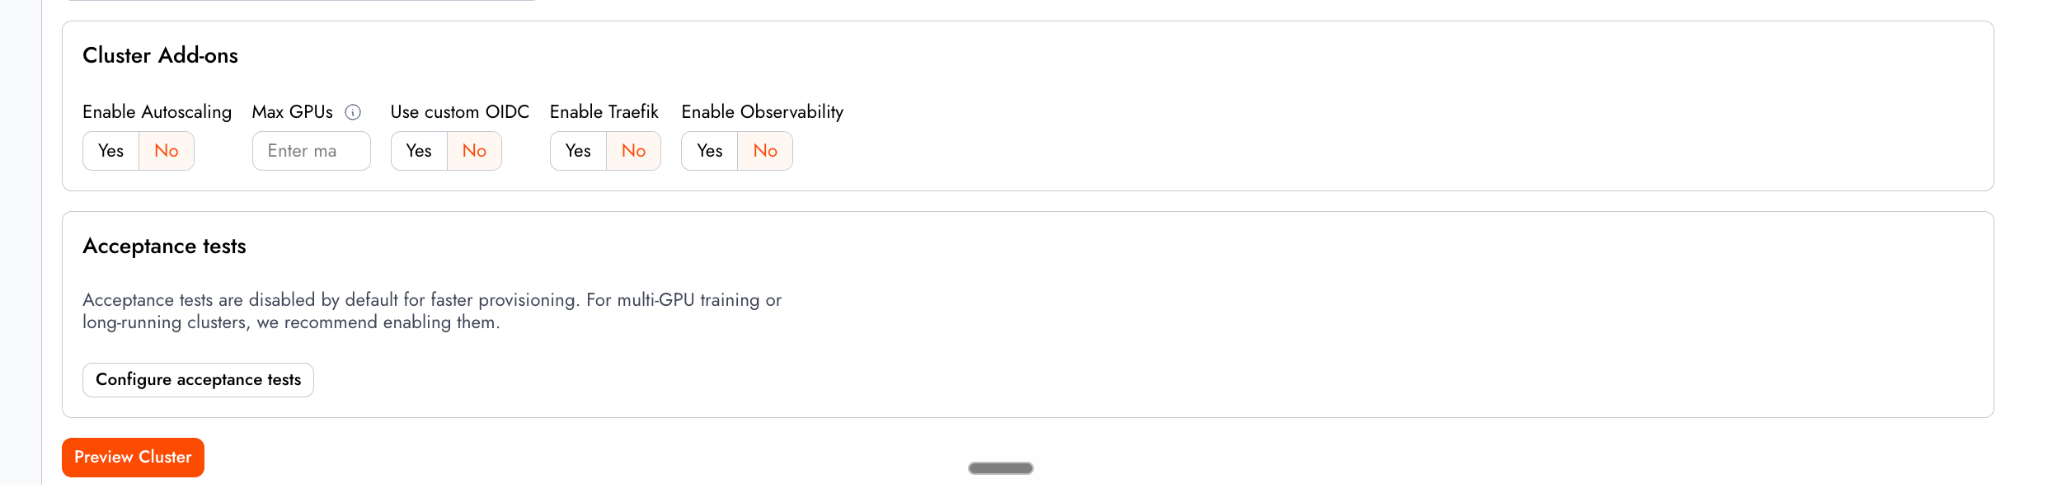
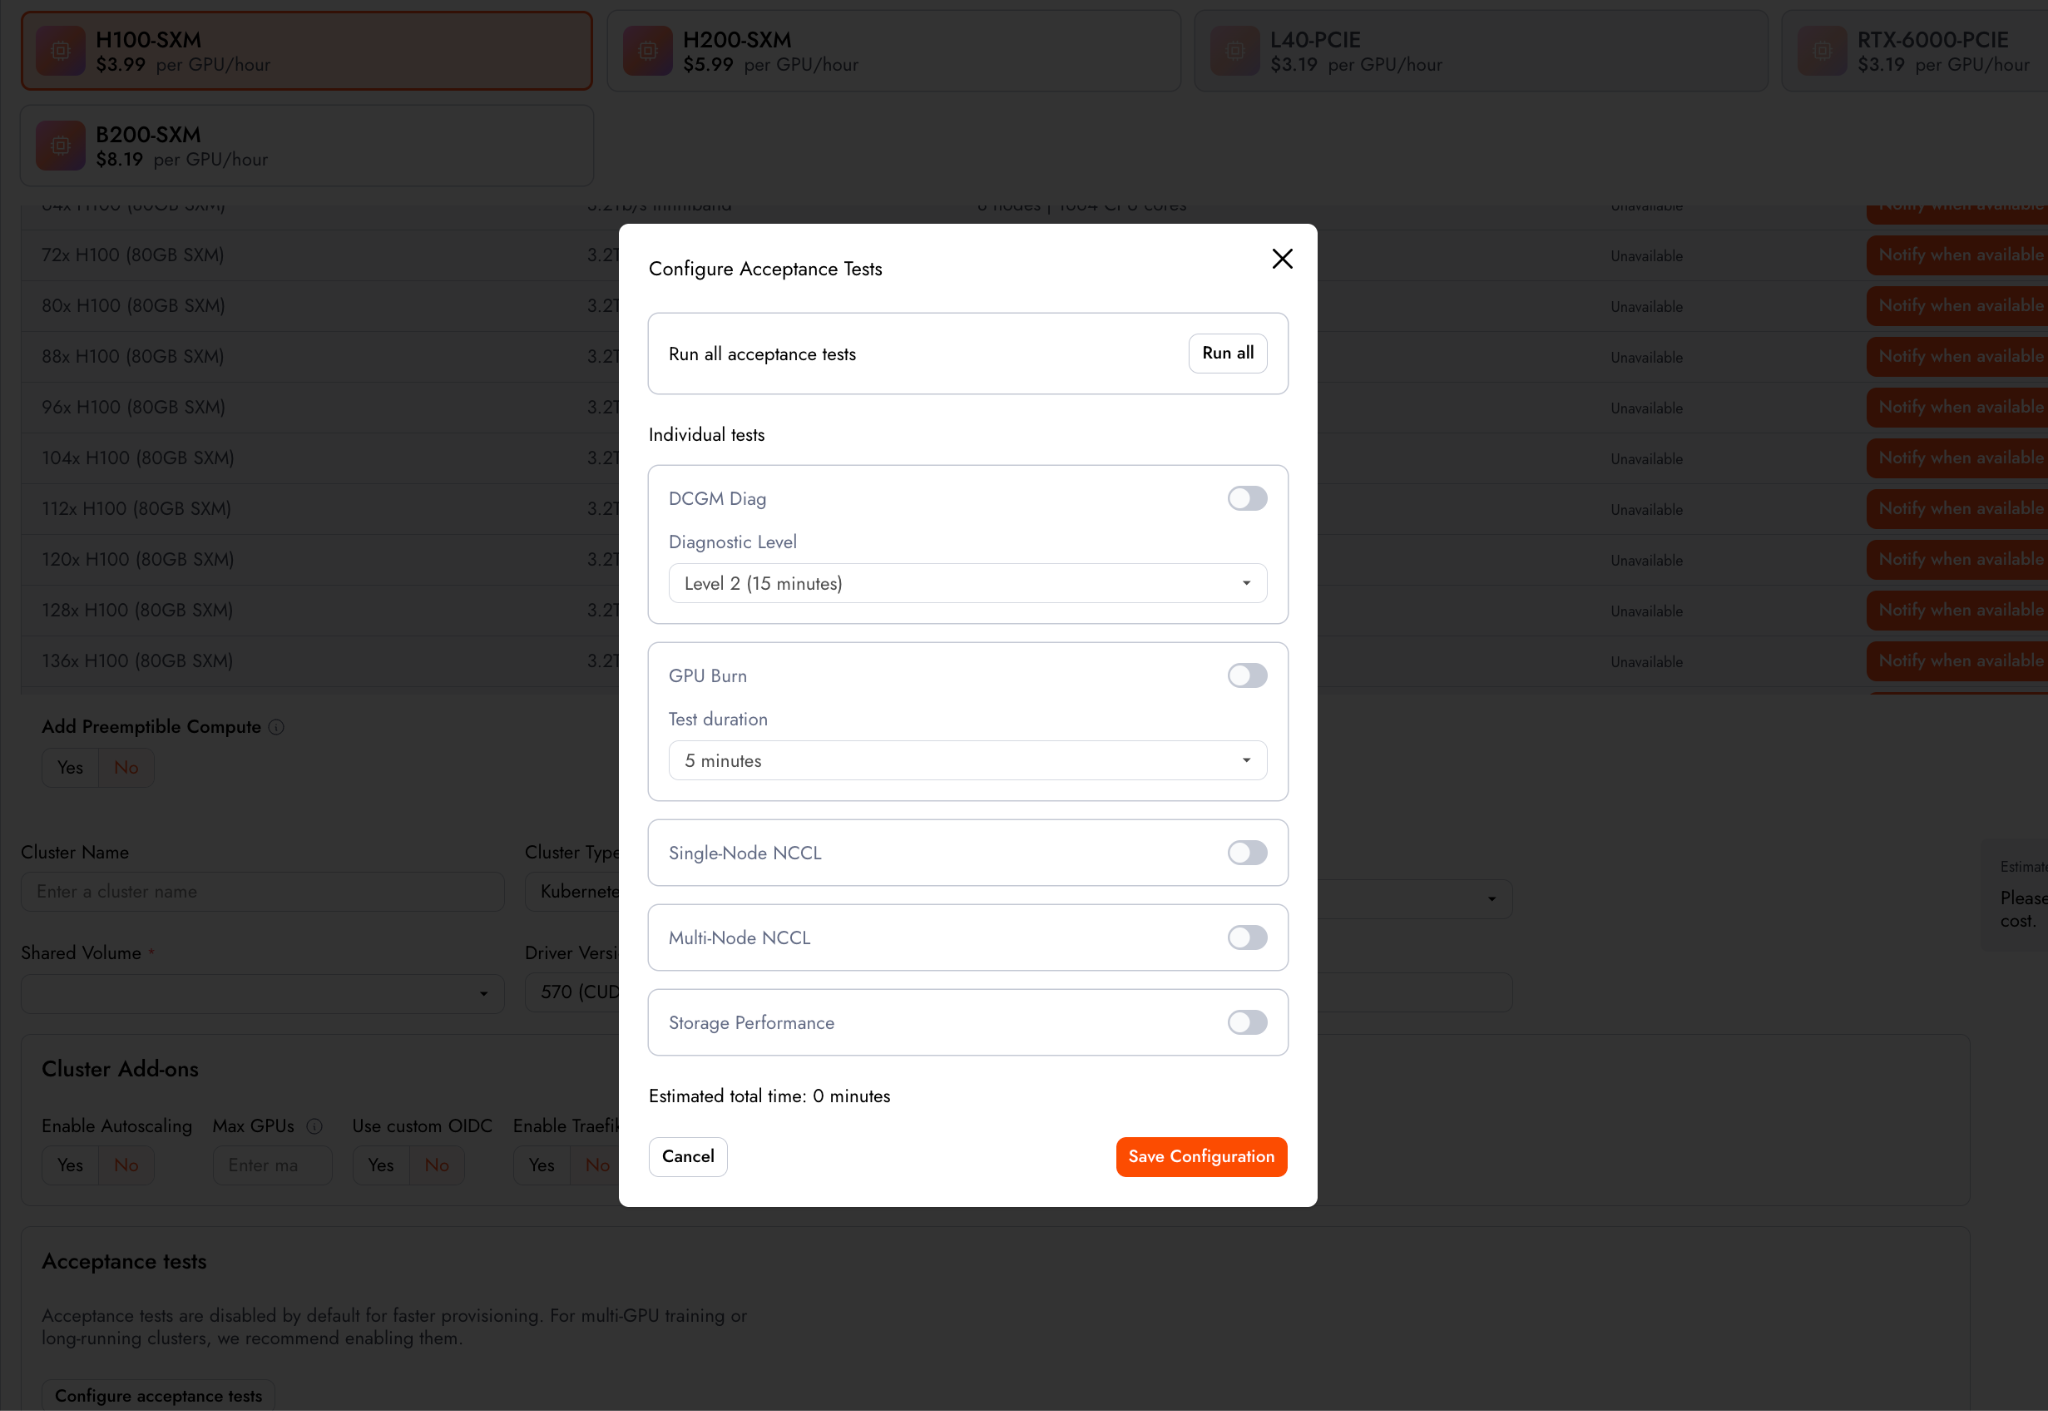
在 Together AI,我们既服务大规模生产训练和推理工作负载,也服务短时突发的实验或单节点研究集群。对于这些较小或短期的集群,我们默认跳过验收测试组合(用于验证 GPU 健康、网络和存储),直接进入可用状态。对大多数集群而言,更快的可用时间是更好的默认选择:等待更少,更快创造价值,尤其是因为我们会持续对集群中的空闲节点运行健康检查。
对于更大的集群或长时间运行的训练作业,权衡则会反过来。在交付阶段发现坏节点,比在第 47 个 epoch 才发现要便宜得多,而相对于集群的整个生命周期,验证的成本很小。对于这些情形,我们建议在创建集群时启用验收测试。
这是一个有意为之的取舍,我们在 UI 中也做了提示:为加快交付,验收测试默认关闭;对于多 GPU 训练或长期运行的生产集群,我们建议在创建集群时启用。
运维层面有哪些变化
综合来看,这些改动为运维人员缩短了从“出问题了”到“集群又可用了”的路径,健康信号、修复操作、访问控制和集群历史都已在产品内提供。
研究人员和机器学习工程师的作业在面对硬件故障时更可靠、更有韧性,出现劣化时也能得到更清晰的信号。平台团队在访问、修复、定制和事故复盘方面拥有更好的控制界面。运维人员则获得持久的记账数据、按集群划分的 GPU 利用率指标,以及一个先回答基本问题的集群视图:它健康吗,它在被使用吗,最近发生了什么?
接下来
你会继续从我们这里看到这些主题:被动健康检查覆盖更多故障模式,更多可以安全地端到端自动化的修复操作,对节点上实际情况更深入的可观测性,以及对大多数大型训练作业所依赖的 Slurm 和 Kubernetes 技术栈的持续投入。
如果你正在 Together GPU Clusters 上运行训练或推理工作负载,而上述内容与你遇到的问题相关,欢迎联系我们。我们就是构建它的团队,希望听到哪些做得好,哪些还需要更简单。
→ 分享反馈
→ 预约客户答疑时间
→ 阅读文档