扩展思考更新
2025 年 12 月 15 日
自最初发布以来,扩展思考(extended thinking)能力已有提升,因此在大多数情况下,我们建议使用该功能,而不是专门的 think 工具。扩展思考同样能带来类似的好处——为 Claude 提供推理复杂问题的空间——并且集成度和性能更好。实现细节请参阅我们的扩展思考文档。
在持续增强 Claude 复杂问题求解能力的过程中,我们发现了一种特别有效的方法:“think”工具,它能在复杂任务中为结构化思考开辟一块专用空间。
这一简单而强大的技术——正如下文将要说明的,它不同于 Claude 全新的“扩展思考”能力(扩展思考的实现细节见此处)——显著提升了 Claude 在智能体式工具使用方面的表现,包括遵循政策、做出一致的决策,以及处理多步骤问题,而且实现开销极小。
本文将探讨如何在不同应用中实现“think”工具,并基于已验证的基准测试结果,为开发者分享实用指导。
什么是“think”工具?
借助“think”工具,我们让 Claude 能够在得出最终答案的过程中增加一个额外的思考步骤,并为其提供专属的空间。
它听起来与扩展思考相似,但其实是不同的概念。扩展思考关注的是 Claude 在开始生成回复之前做什么:Claude 会深入思考并反复推敲自己的计划,然后再采取行动。而“think”工具则用于 Claude 开始生成回复之后,增加一个停下来思考的步骤,判断自己是否已掌握继续推进所需的全部信息。这在执行很长的工具调用链,或与用户进行很长的多步骤对话时尤其有用。
因此,“think”工具更适合这样的情形:仅凭用户的查询,Claude 无法获得生成回复所需的全部信息,需要处理外部信息(例如工具调用结果中的信息)。Claude 借助“think”工具进行的推理,不如扩展思考那样全面,而是更聚焦于模型发现的新信息。
对于较简单的工具使用场景,例如非顺序的工具调用或直接的指令遵循,我们建议使用扩展思考。对于编程、数学和物理等不需要 Claude 调用工具的用例,扩展思考同样有用。而当 Claude 需要调用复杂工具、在很长的工具调用链中仔细分析工具输出、在带有详细指南的政策密集型环境中行事,或者需要做出顺序决策(每一步都建立在前一步之上,且出错代价高昂)时,“think”工具更为合适。
下面是一个使用标准工具规范格式的示例实现,该格式来自 τ-Bench:
{
  "name": "think",
  "description": "Use the tool to think about something. It will not obtain new information or change the database, but just append the thought to the log. Use it when complex reasoning or some cache memory is needed.",
  "input_schema": {
    "type": "object",
    "properties": {
      "thought": {
        "type": "string",
        "description": "A thought to think about."
      }
    },
    "required": ["thought"]
  }
}
在 τ-Bench 上的表现
我们使用 τ-bench(tau-bench)评估了“think”工具。这是一个综合性基准测试,旨在检验模型在真实客户服务场景中使用工具的能力,其中“think”工具是评测标准环境的一部分。
τ-bench 评估 Claude 的以下能力:
- 与模拟用户进行逼真的对话
- 始终如一地遵循复杂的客服智能体政策指南
- 使用多种工具访问并操作环境数据库
τ-bench 采用的主要评估指标是 pass^k,它衡量对于某个给定任务,k 次独立试验全部成功的概率,并在所有任务上取平均。其他 LLM 评测中常见的 pass@k 指标衡量的是 k 次试验中至少有一次成功,与之不同,pass^k 评估的是一致性和可靠性——对于客服应用来说,始终如一地遵守政策至关重要,因此这是关键品质。
性能分析
我们的评估对比了几种不同的配置:
- 基线(不使用“think”工具,也不使用扩展思考模式)
- 仅使用扩展思考模式
- 仅使用“think”工具
- “think”工具加优化提示词(针对航空领域)
结果显示,当 Claude 3.7 有效使用“think”工具时,在基准测试的“航空”和“零售”两个客服领域都取得了显著提升:
- 航空领域:“think”工具加优化提示词在 pass^1 指标上达到 0.570,而基线仅为 0.370,相对提升 54%;
- 零售领域:仅使用“think”工具即达到 0.812,基线为 0.783。
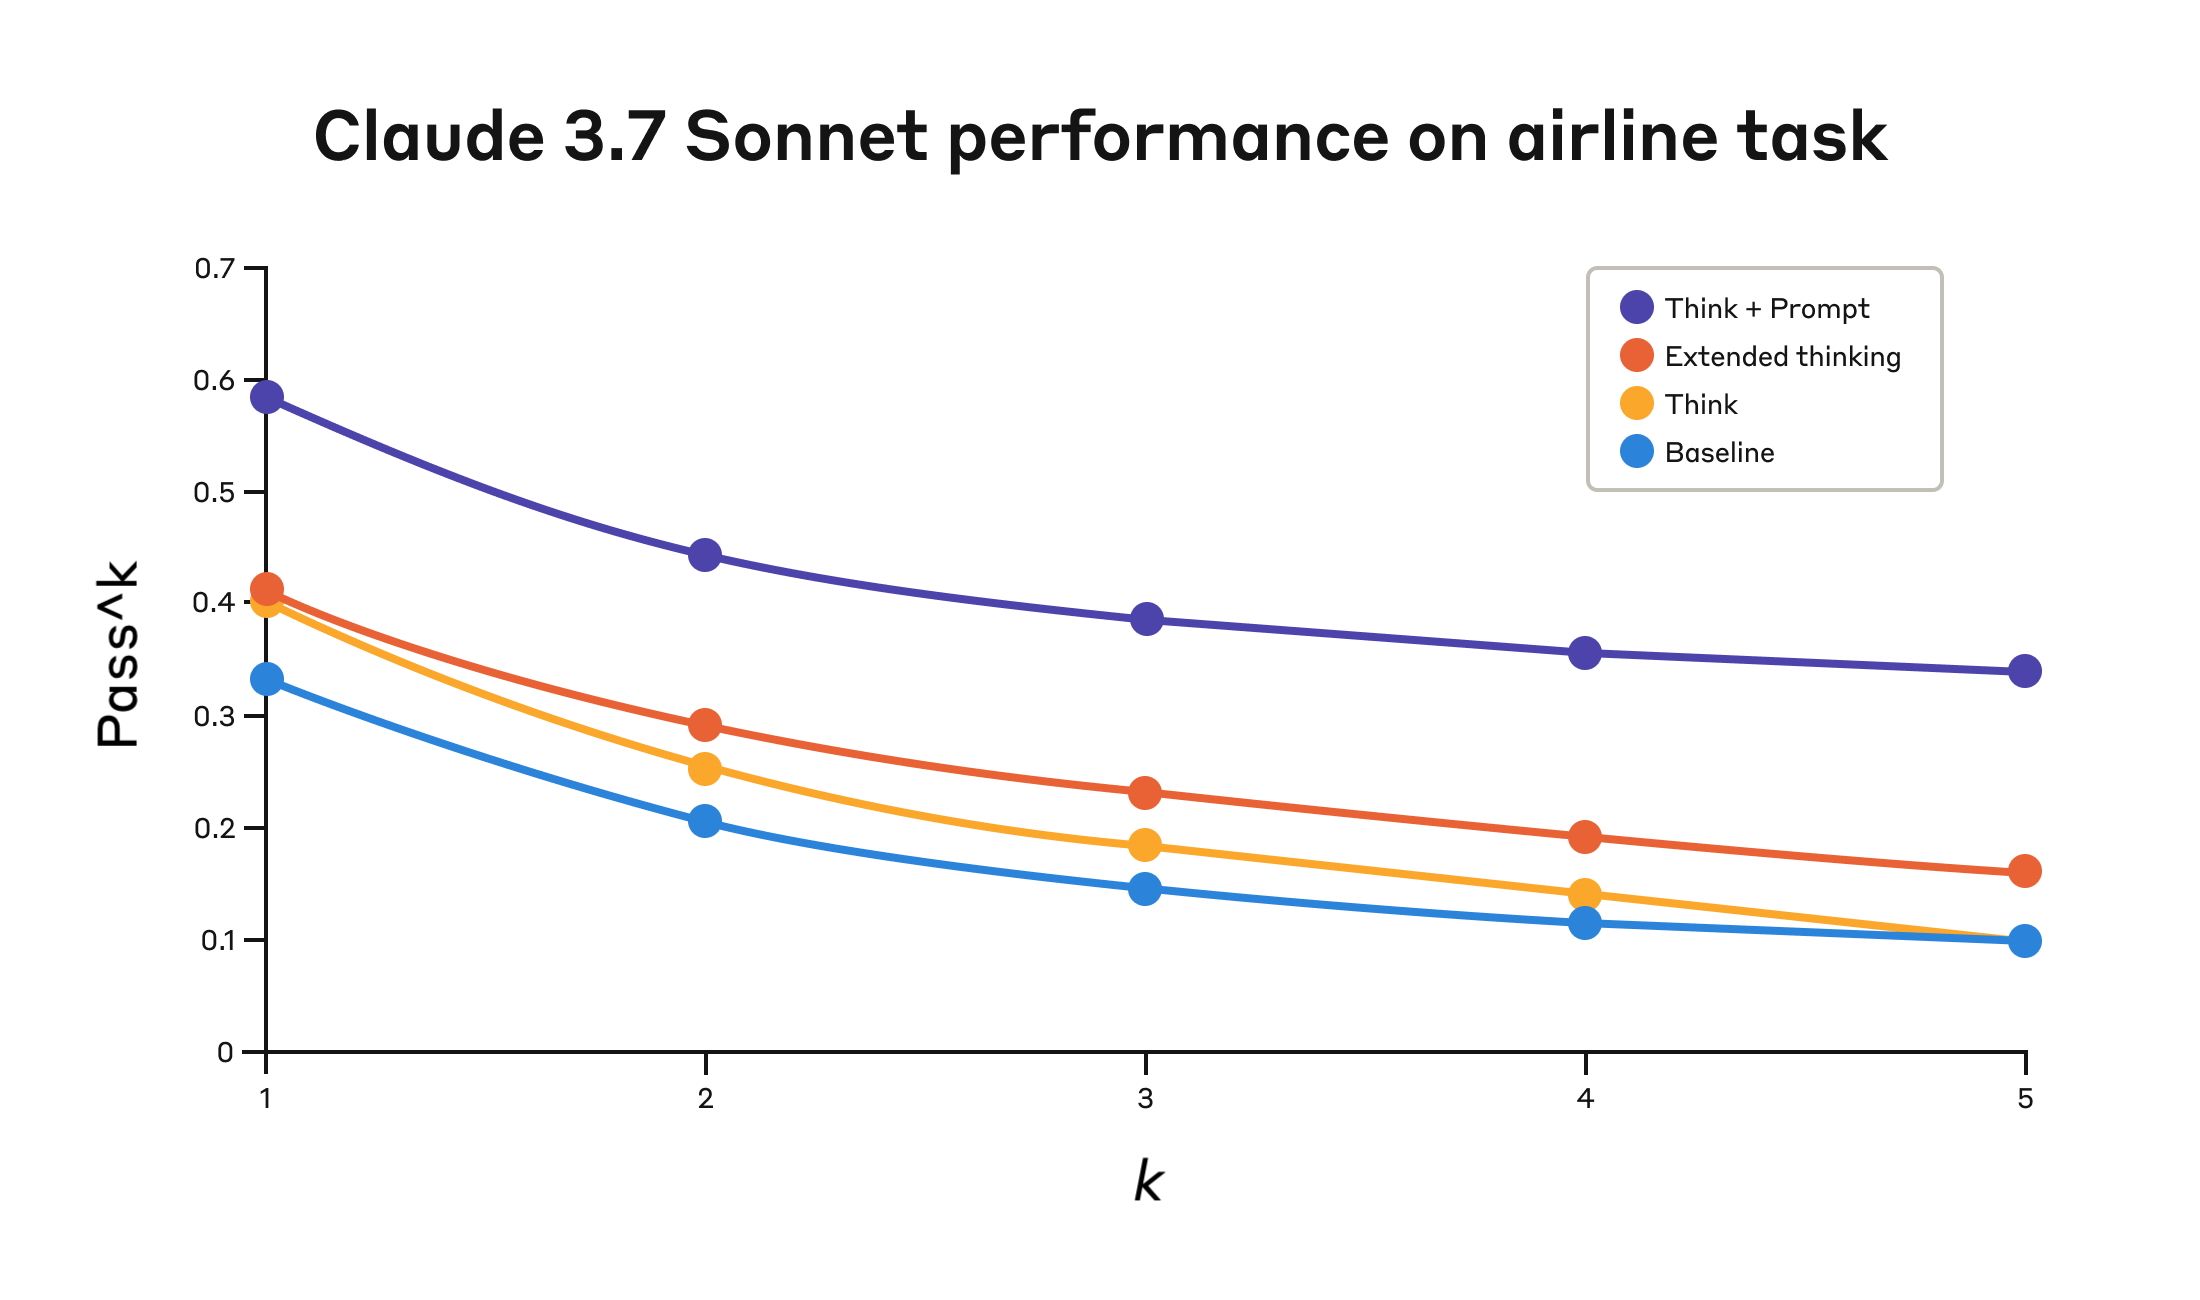
Claude 3.7 Sonnet 在 Tau-Bench 评测“航空”领域的表现
| 配置 | k=1 | k=2 | k=3 | k=4 | k=5 |
|---|---|---|---|---|---|
| “Think” + 提示词 | 0.584 | 0.444 | 0.384 | 0.356 | 0.340 |
| “Think” | 0.404 | 0.254 | 0.186 | 0.140 | 0.100 |
| 扩展思考 | 0.412 | 0.290 | 0.232 | 0.192 | 0.160 |
| 基线 | 0.332 | 0.206 | 0.148 | 0.116 | 0.100 |
四种不同配置下的评测结果。分数为比例。
在航空领域,最佳表现来自将“think”工具与优化提示词搭配使用,该提示词给出了分析客户请求时可采用的推理方式示例。下面是优化提示词的一个示例:
## Using the think tool

Before taking any action or responding to the user after receiving tool results, use the think tool as a scratchpad to:
- List the specific rules that apply to the current request
- Check if all required information is collected
- Verify that the planned action complies with all policies
- Iterate over tool results for correctness

Here are some examples of what to iterate over inside the think tool:
<think_tool_example_1>
User wants to cancel flight ABC123
- Need to verify: user ID, reservation ID, reason
- Check cancellation rules:
  * Is it within 24h of booking?
  * If not, check ticket class and insurance
- Verify no segments flown or are in the past
- Plan: collect missing info, verify rules, get confirmation
</think_tool_example_1>

<think_tool_example_2>
User wants to book 3 tickets to NYC with 2 checked bags each
- Need user ID to check:
  * Membership tier for baggage allowance
  * Which payments methods exist in profile
- Baggage calculation:
  * Economy class × 3 passengers
  * If regular member: 1 free bag each → 3 extra bags = $150
  * If silver member: 2 free bags each → 0 extra bags = $0
  * If gold member: 3 free bags each → 0 extra bags = $0
- Payment rules to verify:
  * Max 1 travel certificate, 1 credit card, 3 gift cards
  * All payment methods must be in profile
  * Travel certificate remainder goes to waste
- Plan:
1. Get user ID
2. Verify membership level for bag fees
3. Check which payment methods in profile and if their combination is allowed
4. Calculate total: ticket price + any bag fees
5. Get explicit confirmation for booking
</think_tool_example_2>
尤其有意思的是不同方法之间的比较。“think”工具加优化提示词,取得了明显优于扩展思考模式的结果(扩展思考模式的表现与未加提示的“think”工具相近)。单独使用“think”工具(不加提示)相比基线有所提升,但仍不及优化后的方法。
“think”工具与优化提示相结合,以显著优势取得了最强的表现,这很可能是因为基准测试中航空政策部分复杂度很高,模型从“如何思考”的示例中获益最多。
在零售领域,我们同样测试了多种配置,以了解各方法的具体影响
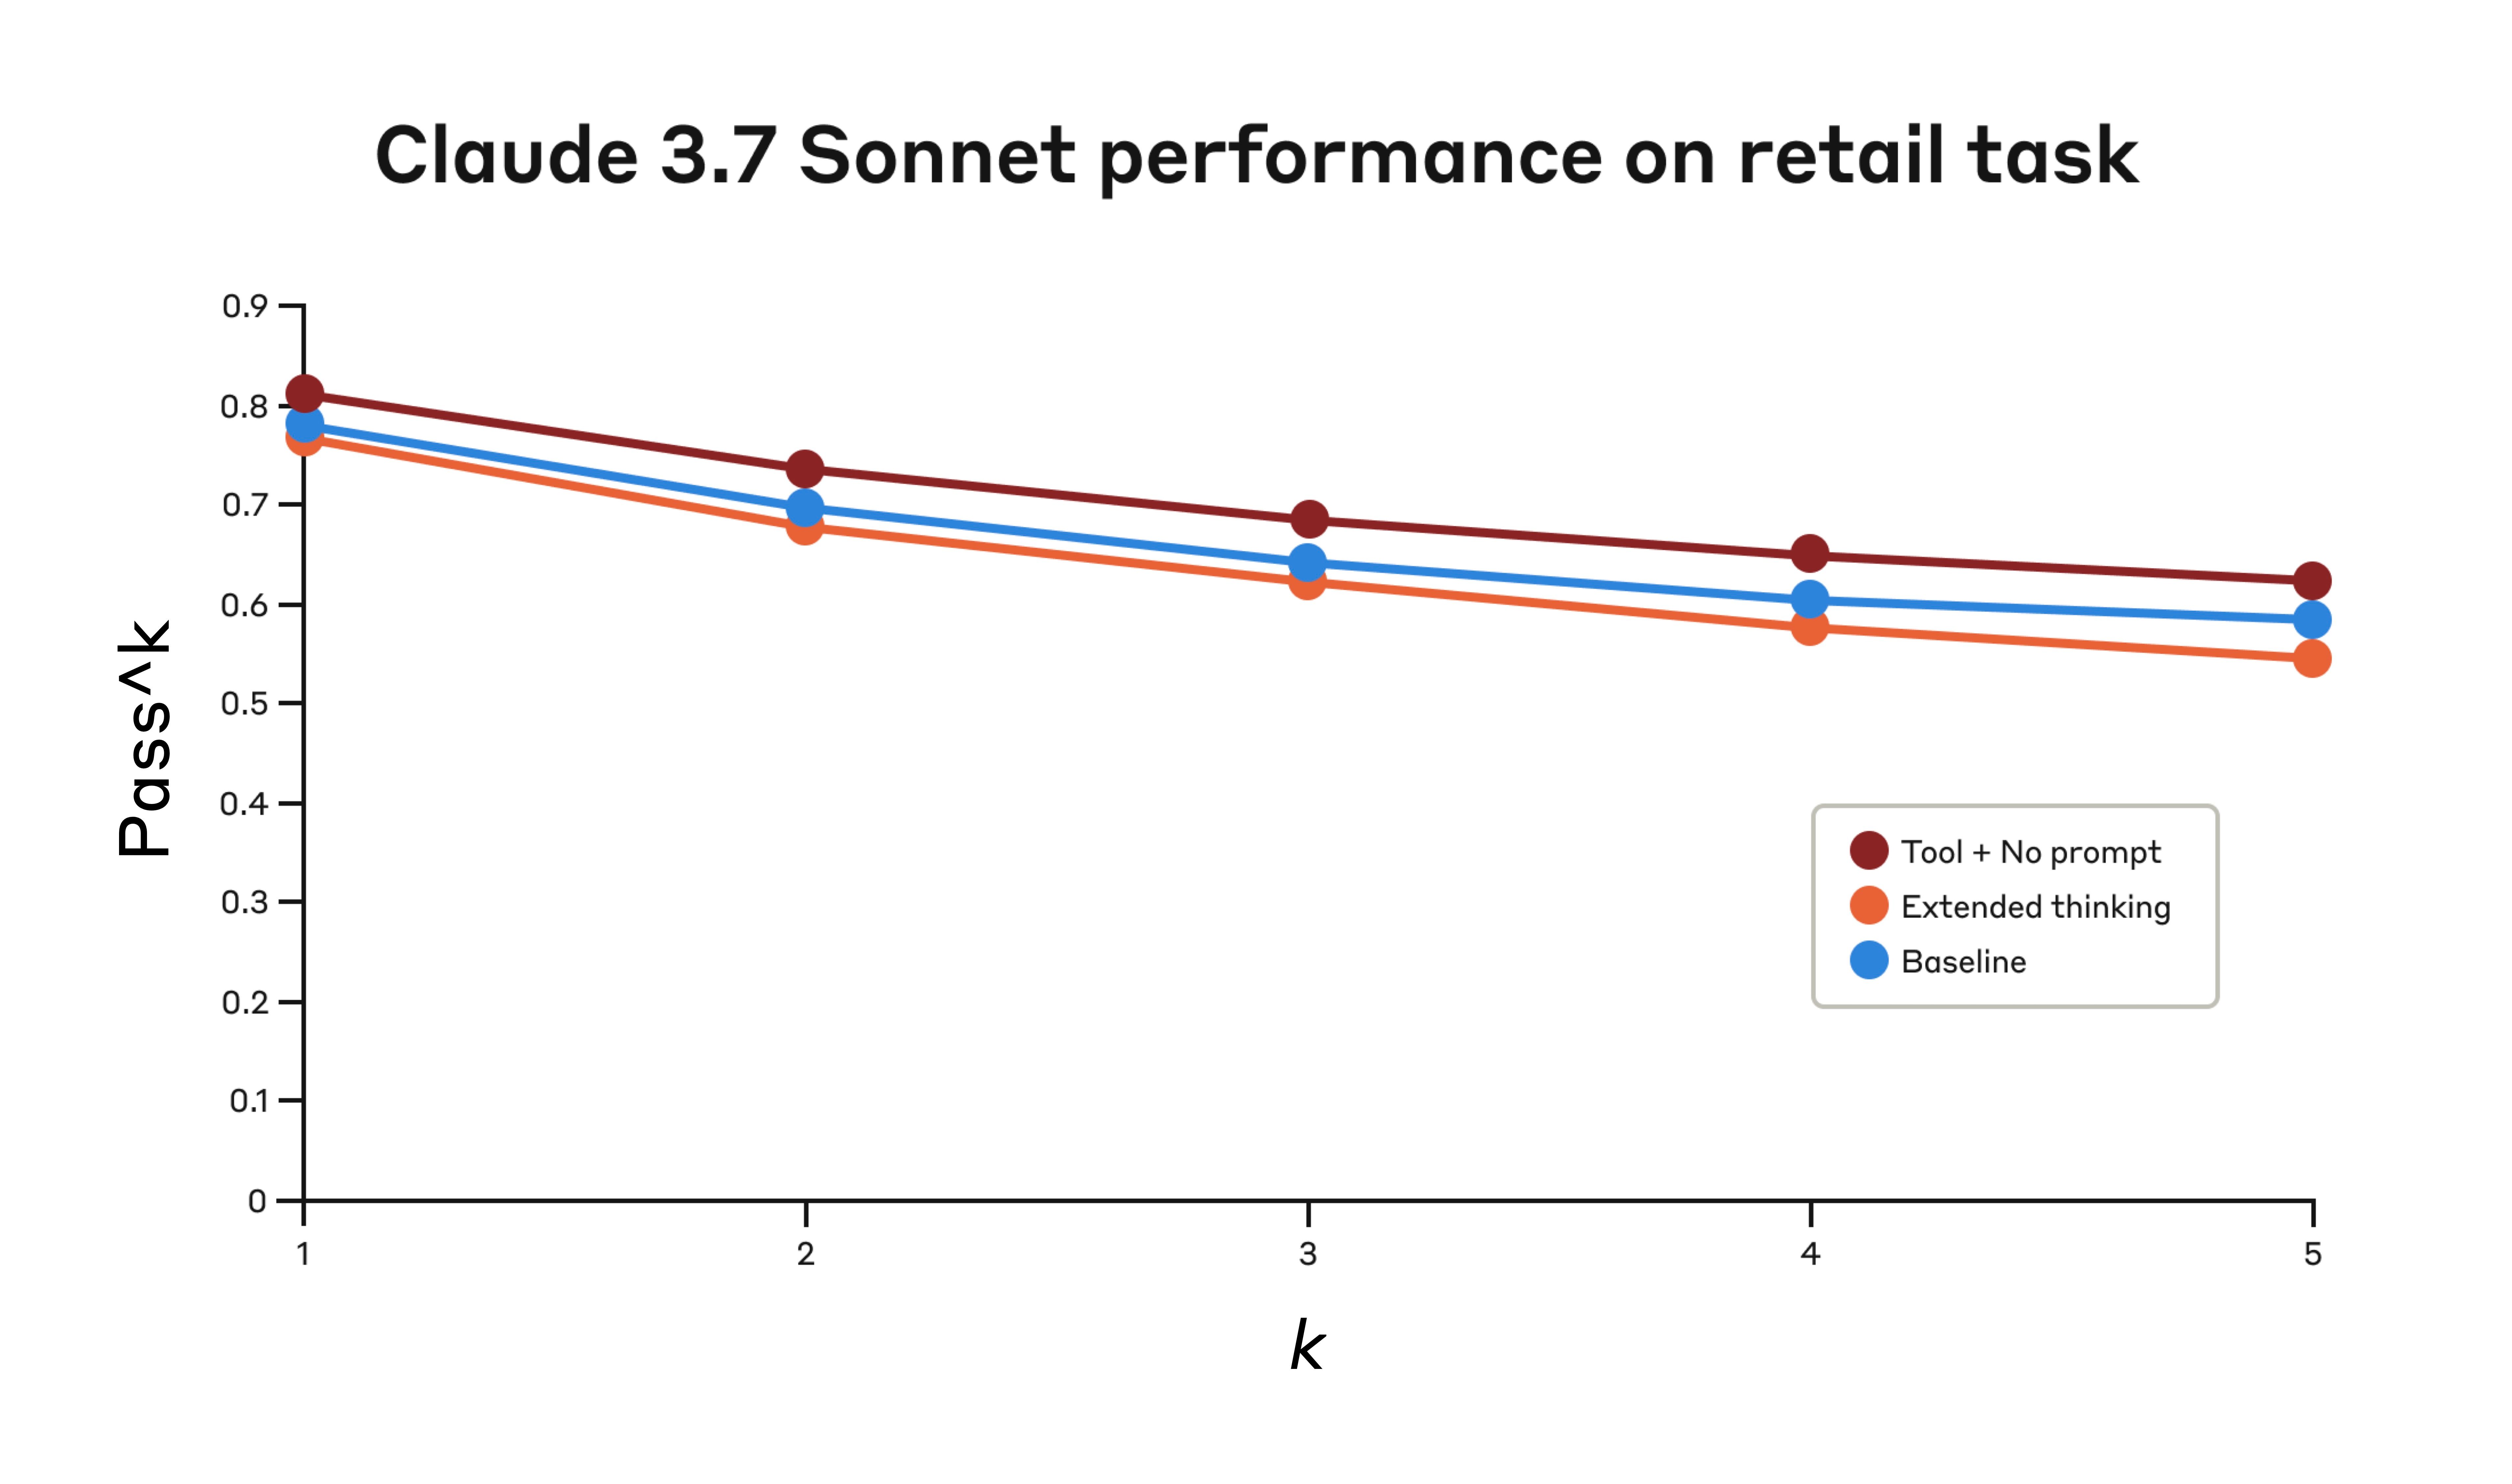
Claude 3.7 Sonnet 在 Tau-Bench 评测“零售”领域的表现
| 配置 | k=1 | k=2 | k=3 | k=4 | k=5 |
|---|---|---|---|---|---|
| “Think” + 无提示词 | 0.812 | 0.735 | 0.685 | 0.650 | 0.626 |
| 扩展思考 | 0.770 | 0.681 | 0.623 | 0.581 | 0.548 |
| 基线 | 0.783 | 0.695 | 0.643 | 0.607 | 0.583 |
三种不同配置下的评测结果。分数为比例。
即使没有额外提示,“think”工具也取得了 0.812 的最高 pass^1 分数。零售政策明显比航空领域更容易应对,Claude 只需拥有思考的空间,无需进一步指导就能获得提升。
τ-Bench 分析的关键洞察
我们的详细分析揭示了若干规律,可帮助你有效实现“think”工具:
- 在困难领域,提示词至关重要。仅仅提供“think”工具可能会在一定程度上提升性能,但对于困难领域,将其与优化提示词搭配使用,带来的结果要好得多。不过,较简单的领域可能只需拥有“think”工具就能受益。
- 多次试验间的一致性有所提升。使用“think”带来的提升在 pass^k 直至 k=5 时依然保持,这表明该工具帮助 Claude 更有效地处理了边缘情况和不常见的场景。
在 SWE-Bench 上的表现
在评估 Claude 3.7 Sonnet 时,我们的 SWE-bench 设置中加入了类似的“think”工具,这为其取得 0.623 的业界领先成绩作出了贡献。改编后的“think”工具定义如下:
{
  "name": "think",
  "description": "Use the tool to think about something. It will not obtain new information or make any changes to the repository, but just log the thought. Use it when complex reasoning or brainstorming is needed. For example, if you explore the repo and discover the source of a bug, call this tool to brainstorm several unique ways of fixing the bug, and assess which change(s) are likely to be simplest and most effective. Alternatively, if you receive some test results, call this tool to brainstorm ways to fix the failing tests.",
  "input_schema": {
    "type": "object",
    "properties": {
      "thought": {
        "type": "string",
        "description": "Your thoughts."
      }
    },
    "required": ["thought"]
  }
}
我们的实验(使用“think”工具的样本 n=30,不使用的样本 n=144)显示,单独加入该工具带来的影响是平均性能提升 1.6%(Welch t 检验:t(38.89) = 6.71,p < .001,d = 1.47)。
何时使用“think”工具
基于这些评估结果,我们确定了 Claude 从“think”工具中获益最多的几类具体场景:
- 工具输出分析。Claude 需要在行动之前仔细处理先前工具调用的输出,并且可能需要调整方案、回退重来时;
- 政策密集型环境。Claude 需要遵循详细的指南并验证是否合规时;以及
- 顺序决策。每个动作都建立在之前的动作之上,且出错代价高昂时(常见于多步骤领域)。
实现最佳实践
为了让 Claude 充分发挥“think”工具的作用,基于我们的 τ-bench 实验,我们建议采用以下实现实践。
1. 用特定领域的示例做策略性提示
最有效的做法,是就何时以及如何使用“think”工具给出清晰的指示,例如 τ-bench 航空领域所用的那种。提供针对你具体用例定制的示例,能显著提升模型使用“think”工具的效果:
- 对推理过程所期望的详细程度;
- 如何把复杂指令拆解为可执行的步骤;
- 处理常见场景的决策树;以及
- 如何检查是否已收集到所有必要的信息。
2. 把复杂的指导放在系统提示词中
我们发现,当关于“think”工具的指示很长和/或很复杂时,把它们放在系统提示词中,比放在工具描述本身中更有效。这种做法提供了更广泛的上下文,有助于模型把思考过程更好地融入其整体行为。
何时不使用“think”工具
尽管“think”工具能带来可观的提升,但它并不适用于所有工具使用场景,而且会带来提示词变长、输出 token 增多的代价。具体来说,我们发现在以下用例中,“think”工具不会带来任何提升:
- 非顺序的工具调用。如果 Claude 完成任务只需一次工具调用或多个并行调用,加入“think”不太可能带来提升。
- 简单的指令遵循。当 Claude 需要遵守的约束不多,且其默认行为已经足够好时,额外的“think”不太可能带来收益。
开始使用
“think”工具是对你的 Claude 实现的一个简单补充,只需几个步骤就能带来有意义的提升:
- 用智能体式工具使用场景测试。从有挑战性的用例入手——即 Claude 目前在政策合规或长工具调用链的复杂推理上表现欠佳的场景。
- 添加工具定义。实现一个针对你所在领域定制的“think”工具。它所需代码极少,却能带来更结构化的推理。还可以考虑在系统提示词中加入何时以及如何使用该工具的说明,并附上与你所在领域相关的示例。
- 监测并改进。观察 Claude 在实践中如何使用该工具,并调整提示词,以鼓励更有效的思考模式。
最大的好处是,加入这个工具在性能表现上几乎没有负面影响。除非 Claude 决定使用它,否则它不会改变外部行为,也不会干扰你现有的工具或工作流。
结论
我们的研究表明,对于需要遵守政策、并在长工具调用链中进行推理的复杂任务,“think”工具能显著提升 Claude 3.7 Sonnet 的表现1。“Think”并非放之四海而皆准的方案,但对于合适的用例,它能带来可观的收益,而实现复杂度极低。
我们期待看到你如何使用“think”工具,借助 Claude 构建能力更强、更可靠、更透明的 AI 系统。
1. 虽然我们的 τ-Bench 结果侧重于 Claude 3.7 Sonnet 借助“think”工具获得的提升,但我们的实验表明,Claude 3.5 Sonnet(New)在与 3.7 Sonnet 相同的配置下也能获得性能提升,这说明这种提升同样适用于其他 Claude 模型。