想上手 Claude Managed Agents,请参阅我们的文档。
如何构建高效的智能体,以及如何为长时间运行的工作设计运行框架(harness),是工程博客上一个持续讨论的话题。这些工作有一条共同的主线:运行框架编码了一些关于 Claude 自己做不到什么的假设。然而,这些假设需要经常被重新审视,因为随着模型的进步,它们可能会过时。
仅举一例,在之前的工作中,我们发现 Claude Sonnet 4.5 在感觉上下文上限临近时,会过早地收尾任务,这种行为有时被称为“上下文焦虑”。我们的解决办法是在运行框架中加入上下文重置。但当我们在 Claude Opus 4.5 上使用同一个运行框架时,发现这种行为已经消失了。这些重置成了累赘。
我们预计运行框架会持续演进。因此我们打造了 Managed Agents:这是 Claude Platform 中的一项托管服务,通过一小组接口代你运行长周期智能体,这些接口旨在比任何特定实现都更长久,包括我们今天运行的这些实现。
构建 Managed Agents,意味着要解决计算领域的一个老问题:如何为“尚未被想到的程序”设计系统。几十年前,操作系统通过把硬件虚拟化为抽象概念(进程、文件)来解决这个问题,这些抽象足够通用,能容纳当时还不存在的程序。这些抽象比硬件活得更久。read() 命令并不关心它访问的是 20 世纪 70 年代的磁盘组,还是现代的 SSD。上层的抽象保持稳定,而底层的实现可以自由更换。
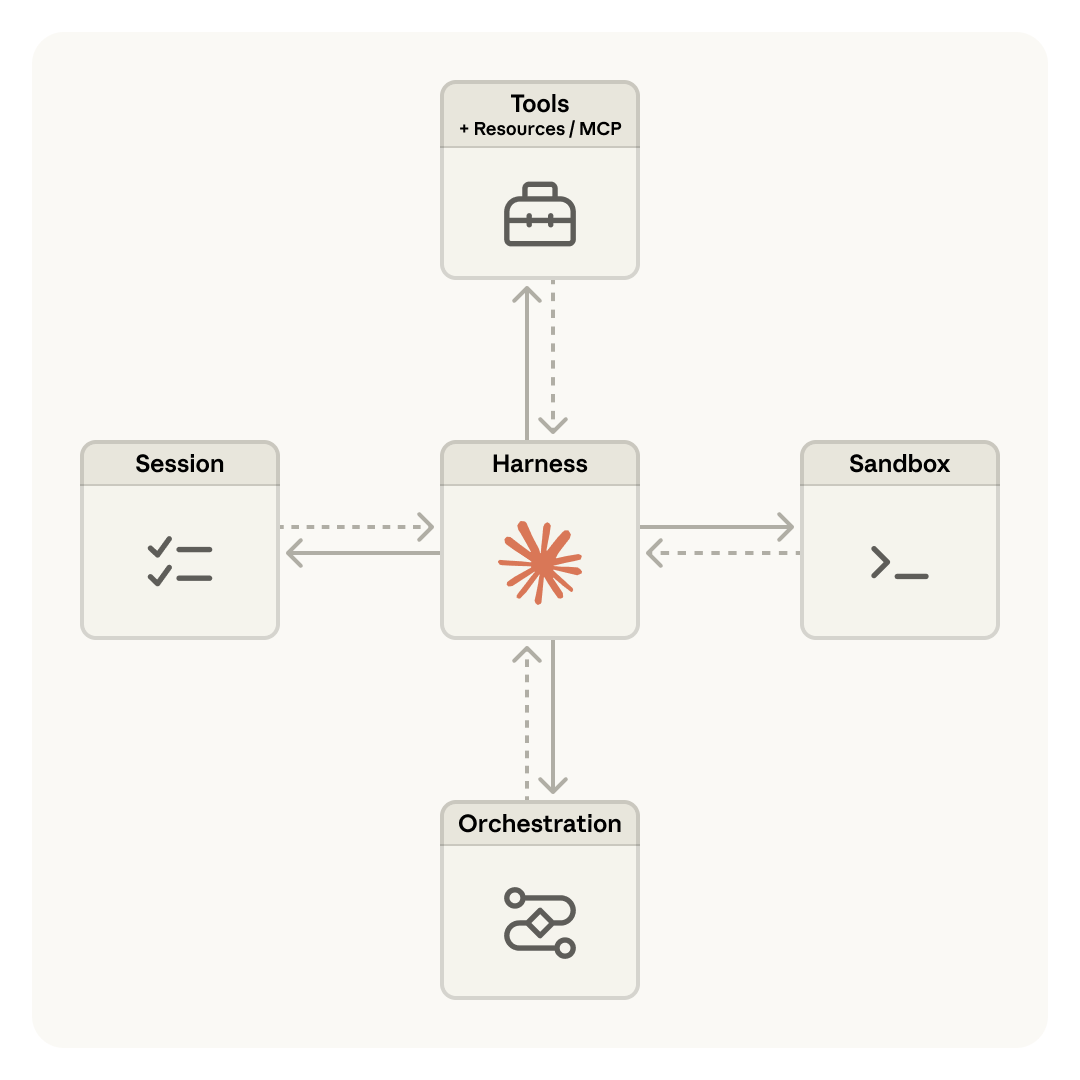
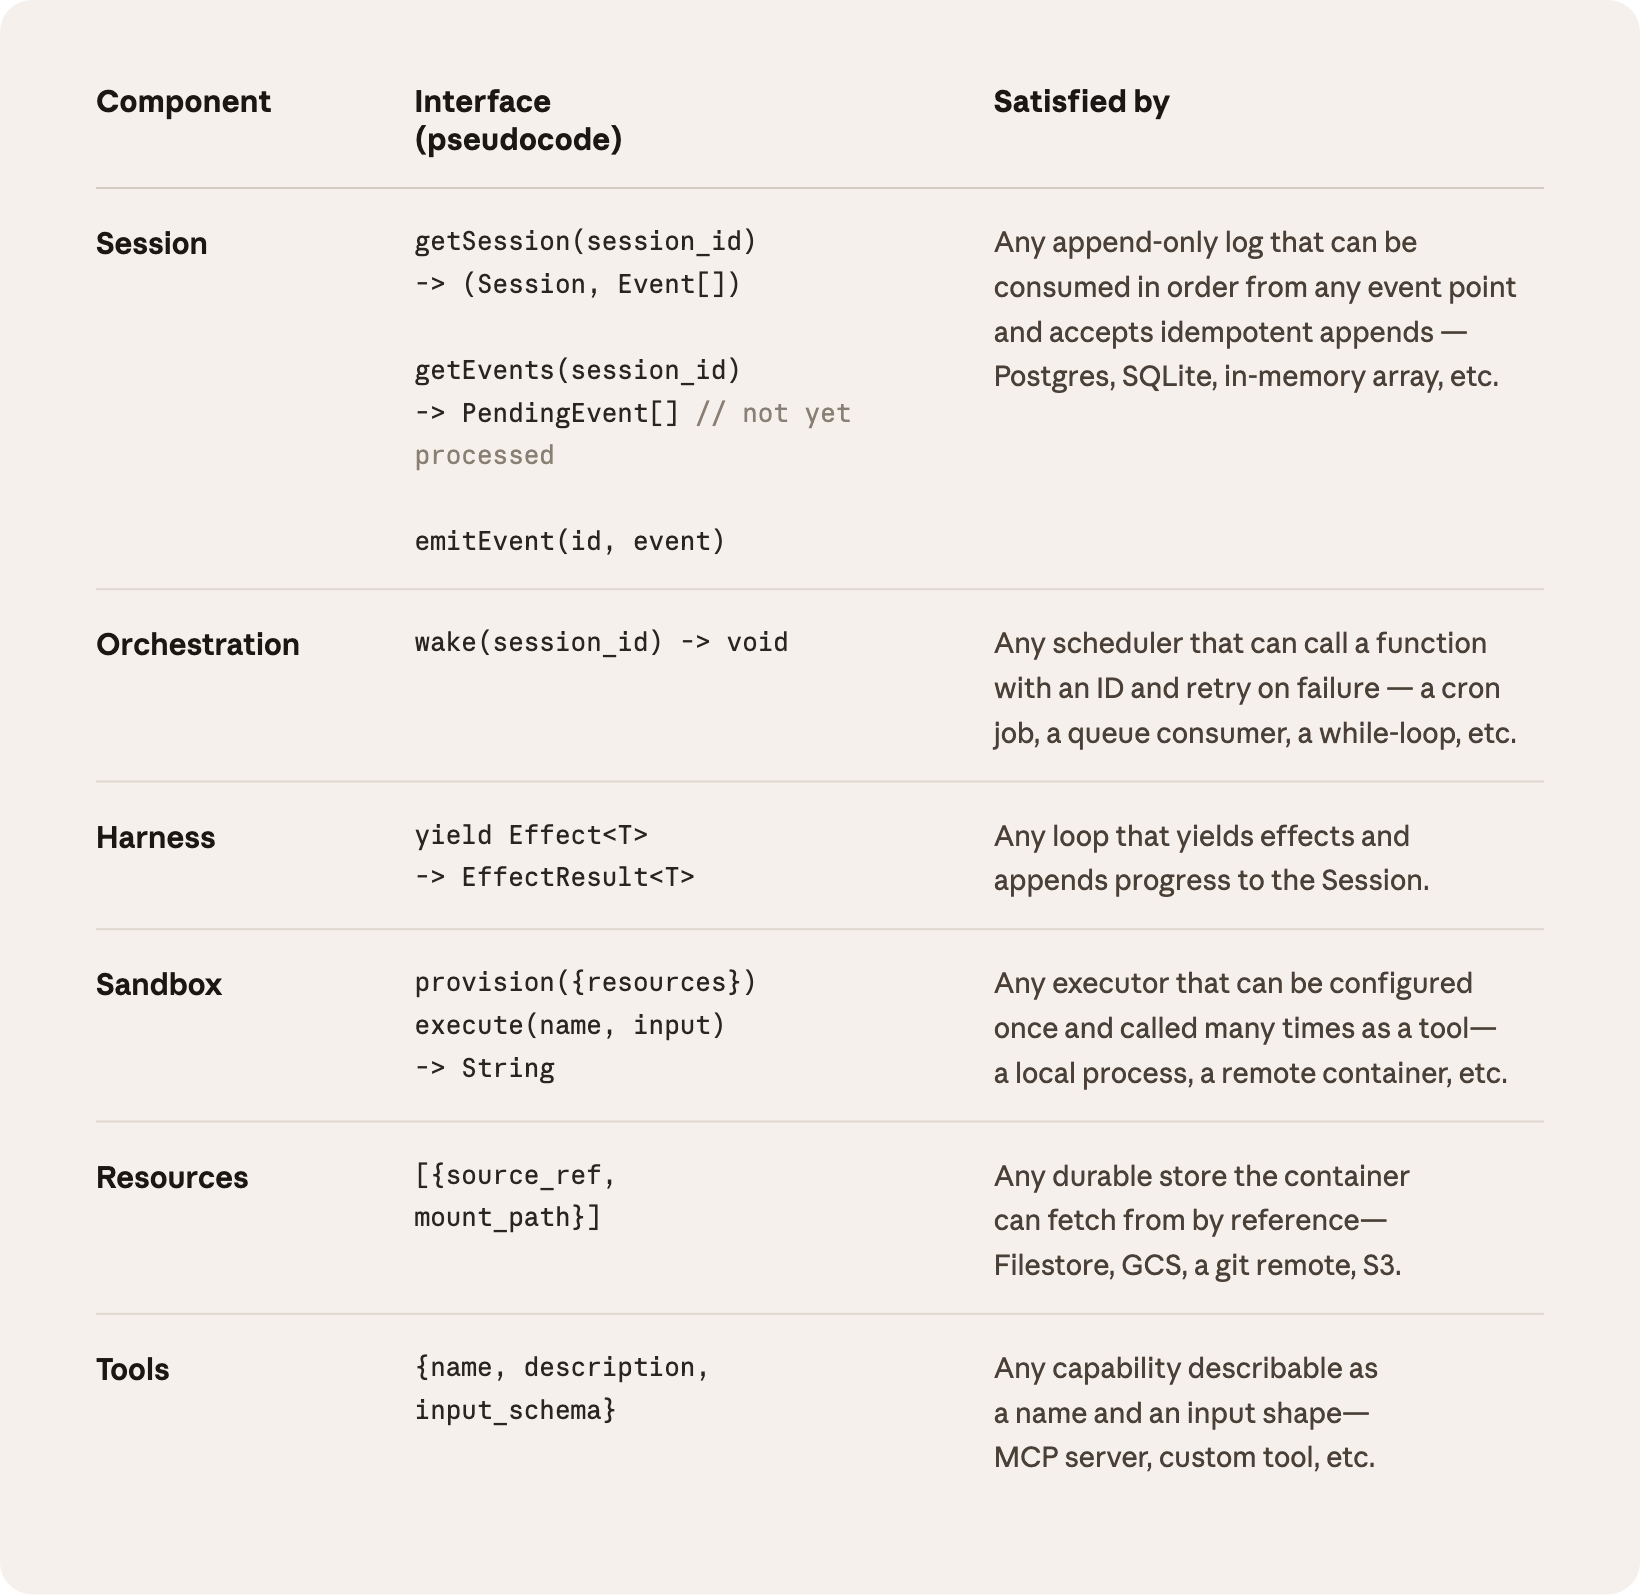
Managed Agents 遵循同样的模式。我们把智能体的各个组成部分虚拟化了:会话(session,只追加的日志,记录发生过的一切)、运行框架(harness,调用 Claude 并把 Claude 的工具调用路由到相应基础设施的循环)以及沙箱(sandbox,Claude 可以在其中运行代码和编辑文件的执行环境)。这样,每一部分的实现都可以被替换,而不影响其他部分。我们对这些接口的形态有明确主张,但不干涉接口背后运行的是什么。
不要养宠物
我们起初把所有智能体组件放在同一个容器里,这意味着会话、智能体运行框架和沙箱共享同一个环境。这种做法有一些好处,比如文件编辑是直接的系统调用,也不需要设计服务边界。
但把所有东西耦合在一个容器里,我们遇到了一个古老的基础设施问题:我们养了一只宠物。在“宠物与牲畜”(pets vs cattle)的类比中,宠物是有名字、需要精心照料、丢不起的个体,而牲畜则是可以互相替换的。在我们的场景里,服务器成了那只宠物:容器一旦故障,会话就丢了;容器无响应时,我们就得想办法把它救活。
救活容器,意味着要调试无响应、卡死的会话。我们唯一的观察窗口是 WebSocket 事件流,但它无法告诉我们故障出在哪里,也就是说,运行框架里的 bug、事件流中的丢包,或者容器下线,表现出来都一样。要弄清楚出了什么问题,工程师必须在容器内打开一个 shell,而由于这个容器往往还存放着用户数据,这种做法实质上意味着我们没有调试的能力。
第二个问题是,运行框架假定 Claude 所处理的一切都和它在同一个容器里。当客户要求我们把 Claude 接入他们的虚拟私有云(VPC)时,他们要么得把自己的网络与我们的网络对等互联,要么得在自己的环境中运行我们的运行框架。运行框架里固化的一个假设,在我们想把它连接到不同的基础设施时成了问题。
把大脑与手解耦
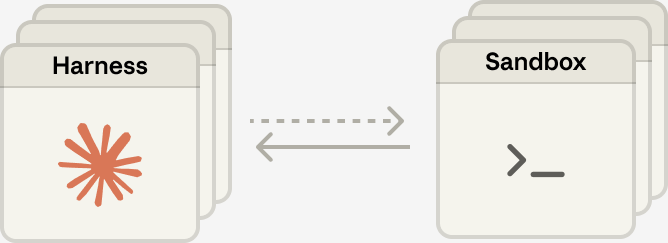
我们最终找到的解决办法,是把我们称为“大脑”的部分(Claude 及其运行框架),与“手”(执行动作的沙箱和工具)以及“会话”(会话事件的日志)解耦。每一部分都变成一个对其他部分几乎不做假设的接口,并且都可以独立发生故障或被替换。
运行框架离开容器。把大脑与手解耦,意味着运行框架不再位于容器内部。它调用容器的方式,和调用其他任何工具一样:execute(name, input) → string。容器变成了牲畜。如果容器挂了,运行框架会把故障当作工具调用错误捕获,并传回给 Claude。如果 Claude 决定重试,就可以按标准流程重新初始化一个新容器:provision({resources})。我们再也不用把出故障的容器救活了。
从运行框架故障中恢复。运行框架同样变成了牲畜。由于会话日志位于运行框架之外,运行框架中没有任何东西需要在崩溃后存活。当某个运行框架出故障时,可以用 wake(sessionId) 重新启动一个新的,使用 getSession(id) 取回事件日志,并从最后一个事件处继续。在智能体循环期间,运行框架通过 emitEvent(id, event) 向会话写入,以保留持久的事件记录。
安全边界。在耦合式设计中,Claude 生成的任何不受信任的代码,都与凭据运行在同一个容器里,因此提示词注入只需说服 Claude 去读取它自己的环境即可。一旦攻击者拿到这些令牌,就可以创建全新的、不受限制的会话,并把工作委派给它们。收紧权限范围是显而易见的缓解办法,但这其实编码了一个关于 Claude 拿着受限令牌做不到什么的假设,而 Claude 正变得越来越聪明。结构性的修复办法是,确保令牌永远无法从运行 Claude 生成代码的沙箱中触及。
我们用了两种模式来确保这一点。认证信息可以与资源绑定在一起,或者保存在沙箱之外的保险库(vault)中。对于 Git,我们在沙箱初始化期间使用每个仓库的访问令牌克隆仓库,并把它接入本地 git 远程。这样,Git 的 push 和 pull 都能在沙箱内部工作,而智能体自己从不接触令牌本身。对于自定义工具,我们支持 MCP,并把 OAuth 令牌存放在安全的保险库中。Claude 通过专用代理调用 MCP 工具;该代理接收与会话关联的令牌,然后从保险库中取出相应的凭据,并调用外部服务。运行框架始终不会知道任何凭据。
会话不是 Claude 的上下文窗口
长周期任务往往会超出 Claude 上下文窗口的长度,而应对这一问题的标准办法,都涉及对保留什么做出不可逆的决定。我们在之前关于上下文工程的工作中探讨过这些技术。例如,压缩(compaction)让 Claude 保存其上下文窗口的摘要,记忆工具(memory tool)让 Claude 把上下文写入文件,从而实现跨会话学习。这些可以与上下文裁剪搭配使用,即有选择地移除旧的工具结果或思考块等词元。
但是,对保留或丢弃上下文做出不可逆的选择,可能导致失败。很难知道后续轮次会需要哪些词元。如果消息经过压缩步骤被转换,运行框架会把被压缩的消息从 Claude 的上下文窗口中移除,而只有这些消息被存储下来,才有可能恢复。之前的工作探索过解决这一问题的方法:把上下文存为一个位于上下文窗口之外的对象。例如,上下文可以是 REPL 中的一个对象,LLM 通过编写代码对其进行过滤或切片,以编程方式访问。
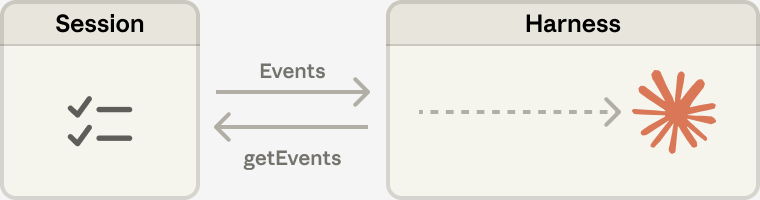
在 Managed Agents 中,会话提供了同样的好处,充当一个位于 Claude 上下文窗口之外的上下文对象。但上下文不是存储在沙箱或 REPL 中,而是持久存储在会话日志里。接口 getEvents(), 让大脑可以通过选取事件流的位置切片来查询上下文。这个接口用起来很灵活:大脑可以从上次读到的位置继续,可以在某个特定时刻之前回退几个事件以查看来龙去脉,也可以在某个特定动作之前重读上下文。
任何取回的事件,在传给 Claude 的上下文窗口之前,也可以先在运行框架中进行转换。这些转换可以是运行框架所编码的任何内容,包括为实现较高的提示词缓存命中率而做的上下文组织,以及上下文工程。我们把会话中可恢复的上下文存储,与运行框架中任意的上下文管理这两类关注点分开,是因为我们无法预测未来的模型会需要哪些具体的上下文工程。这些接口把上下文管理推给运行框架,只保证会话是持久的、可供查询的。
多个大脑,多双手
多个大脑。把大脑与手解耦,解决了我们最早收到的客户抱怨之一。当团队希望 Claude 处理其自有 VPC 中的资源时,唯一的路径是把他们的网络与我们的网络对等互联,因为容纳运行框架的容器假定所有资源都在它旁边。一旦运行框架不再位于容器中,这个假设就不复存在了。同样的改动还带来了性能上的收益。当我们最初把大脑放进容器时,这意味着多个大脑需要同样多的容器。对每个大脑而言,在容器完成配置之前都无法进行推理;每个会话都要预先承担完整的容器搭建成本。每个会话,即使是根本不会用到沙箱的会话,也得克隆仓库、启动进程、从我们的服务器获取待处理事件。
这段空等时间体现为首词元时间(time-to-first-token,TTFT),它衡量的是会话从接受工作到产出第一个响应词元之间等待了多久。TTFT 是用户感受最强烈的延迟。
把大脑与手解耦,意味着容器由大脑通过工具调用 (execute(name, input) → string) 来配置,而且仅在需要时才配置。因此,不需要立刻使用容器的会话也就不必等待容器。编排层一从会话日志中拉取到待处理事件,推理就可以开始。采用这一架构后,我们的 p50 TTFT 下降了约 60%,p95 下降超过 90%。扩展到多个大脑,只意味着启动多个无状态的运行框架,并仅在需要时把它们连接到手上。
多双手。我们还希望能把每个大脑连接到多双手上。在实践中,这意味着 Claude 必须对多个执行环境进行推理,并决定把工作发往何处,这是比在单个 shell 中操作更难的认知任务。我们起初把大脑放在单个容器中,是因为早期的模型还没有这种能力。随着智能水平的提升,单个容器反而成了限制:一旦该容器发生故障,大脑所触及的每双手的状态都会丢失。
把大脑与手解耦,使每双手都成为一个工具,execute(name, input) → string:输入名称和参数,返回一个字符串。这个接口支持任何自定义工具、任何 MCP 服务器,以及我们自己的工具。运行框架并不知道沙箱是一个容器、一部手机,还是一个 Pokémon 模拟器。而且由于没有任何一双手与某个大脑耦合,大脑之间可以互相传递手。
结语
我们面对的挑战由来已久:如何为“尚未被想到的程序”设计系统。操作系统通过把硬件虚拟化为足够通用、能容纳当时还不存在的程序的抽象,已经延续了几十年。通过 Managed Agents,我们的目标是设计一个能够容纳 Claude 周边未来的运行框架、沙箱或其他组件的系统。
Managed Agents 是一个秉持同样精神的元运行框架(meta-harness),它不对 Claude 未来所需要的具体运行框架持任何主张。相反,它是一个拥有通用接口的系统,能够容纳许多不同的运行框架。例如,Claude Code 是一个出色的运行框架,我们在各类任务中广泛使用。我们也已证明,针对特定任务的智能体运行框架在狭窄领域表现出色。Managed Agents 可以容纳其中任何一种,并随着时间推移与 Claude 的智能水平相匹配。
元运行框架的设计,意味着对 Claude 周边的接口要有明确主张:我们预计 Claude 将需要操纵状态(会话)和执行计算(沙箱)的能力。我们还预计 Claude 将需要扩展到多个大脑和多双手的能力。我们设计这些接口,是为了让它们能够在长时间跨度内可靠且安全地运行。但对于 Claude 需要多少个大脑或手,以及它们位于何处,我们不做任何假设。
致谢
本文作者为 Lance Martin、Gabe Cemaj 和 Michael Cohen。感谢 Nodir Turakulov 和 Jeremy Fox 就这些话题进行的有益交流。特别感谢 Agents API 团队和 Jake Eaton 的贡献。