TL;DR
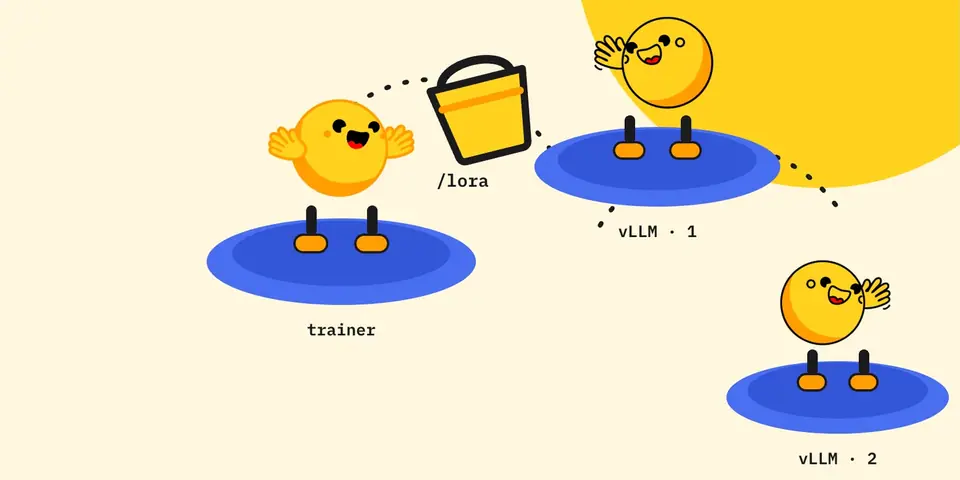
AsyncGRPOTrainer现在可以训练 LoRA 适配器,并且只把这个适配器同步给 vLLM(TRL v1.14)。- rank-1 适配器只有几 MB,因此可以通过挂载在每个 Job 中的 Storage Bucket 传输,而不必走 NCCL。训练器和 vLLM 副本作为独立的 Hugging Face Jobs,运行在不同的机器上。
- 副本前面放一个小型代理:它负责添加认证头,把每次 rollout 路由到已持有其 KV 前缀的副本,并把适配器加载请求广播给所有副本。
- AsyncGRPO 的各项指标能显示瓶颈所在。五次运行用同一套配方,把 500 步的训练时间从 3 小时 27 分钟缩短到 53 分钟。
LoRA 支持最近通过 PR #7017 合入了 TRL 的 AsyncGRPOTrainer,并随 TRL v1.14 发布。异步训练器现在可以训练适配器而不是整个模型,并且只把 LoRA 适配器同步给 vLLM。本文介绍基于它构建的一个真实项目,其中训练与推理不再共用一台机器。
LoRA 训练尤其适合 RL,Thinking Machines 的博客 LoRA Without Regret 对此有所说明。他们表明,对于策略梯度 RL,即使 rank 只有 1,LoRA 也能与全量微调持平。原因在于优势函数(advantage function)每个 episode 只提供 ~O(1) 比特的信息,从信息总比特数的角度看,每一步能学到的东西并不多。rank-1 适配器的容量足以吸收这些信息。
LoRA 训练还带来一个系统层面的结果。1.5B 模型的 rank-1 适配器只有几 MB,而完整模型约 3 GB。每次更新后,我们无需把完整策略发给推理 worker,只需发送适配器。vLLM 还可以同时加载多个适配器:旧的 rollout 用它开始时的策略跑完,新的 rollout 则使用最新策略。
TRL 的 AsyncGRPOTrainer 已经把训练和生成分离开来。训练器和 vLLM 可以运行在不同的机器上,各自按自己的速度推进。在单节点或集群环境中,两个进程共享文件系统或能够组建 NCCL 通信组,这件事很容易做到。
我们想要的是用 Hugging Face Jobs 运行同样的配置。本质上,一个 HF Job 就是跑在一台 VM 上的一个容器。这意味着单个 Job 无法(至少目前不能)拉起多个节点,来容纳一个训练器加一组 vLLM 服务器(每个节点最多只有 8xH200)。AsyncGRPOTrainer 正是为这种规模而生的,于是问题变成:如果放弃训练器和推理服务器必须共用节点的要求,我们能走多远?
如果做全权重同步,答案会是“走不远”。每次更新都得在机器之间搬运数 GB 数据,这本是密集集群里 NCCL 的用武之地,但 Jobs 之间无法跨节点通信。既没有共享的本地磁盘,显然也没有共享的 localhost。换成 LoRA 后,一次同步只有几 MB。至于文件系统部分,HF Jobs 提供由 Storage Buckets 支撑的卷!这些存储桶可以作为 FUSE 文件系统挂载到每个 Job 中,足以充当节点之间的共享文件系统,Job 之间完全不需要任何网络通路。
最终的配置相当精简:
- 一个 训练器 Job,运行带 LoRA 的
AsyncGRPOTrainer(以及 FSDP,稍后详述), - 两个 vLLM Job,每个都提供基础模型,加上训练器最近一次发布的适配器,
- 一个 Storage Bucket,以相同路径挂载到这三个 Job 中,适配器就是通过它从训练器传到服务器的,
- 一个 代理服务器。我们稍后会深入讲为什么需要它,概括来说,我们需要一个代理,把每次 rollout 路由到最可能持有其 KV 缓存的副本,并把每次适配器更新广播给所有 vLLM 副本。
架构:利用 Hugging Face Jobs 和 Storage Buckets 🪣
AsyncGRPOTrainer 中新增的仅适配器同步路径是这样工作的。训练器不向 vLLM 发送张量。每隔几个优化器步骤,它把适配器保存到 <output_dir>/.vllm_lora/trl-policy-v{N} 下,用原子重命名发布该目录,然后把路径发送给 vLLM 的 /v1/load_lora_adapter 端点。vLLM 从磁盘加载这些文件,之后 rollout worker 就可以请求 model="trl-policy-v{N}"。
这正是 vLLM 中运行时加载适配器的既有工作方式。该端点接收的是路径而不是张量,因此要求训练器和服务器共享文件系统。在 Slurm 集群上,那就是网络文件系统。在 Jobs 上,我们像前面提到的那样,把一个 Storage Bucket 作为卷以相同路径挂载到每个 Job 中,也能得到同样的效果。其底层使用 hf-mount,它在容器内把存储桶暴露为 POSIX 文件系统:
# every Job gets the same bucket at the same absolute path
hf jobs run ... -v hf://buckets/aminediroHF/asyncgrpo-lora-buckets:/lora ...
为此,TRL 和 vLLM 都不需要改动。训练器写入 /lora/<run>/.vllm_lora/,服务器从同一路径读取。POST 请求中发送的路径在每个容器内都是有效的。

注意,我们也把检查点和最终适配器存放在存储桶中。HF Jobs 是临时性的,但被抢占的训练器可以恢复训练,因为最终适配器总是持久化到存储桶中,Job 停止时不会丢失。
三个 Job
vLLM 副本
每个副本使用一块 GPU 和原版 vllm/vllm-openai 镜像。我们只需启用运行时 LoRA 加载,并预留足够的适配器槽位。
适配器槽位的数量由 max_staleness 决定。在 AsyncGRPOTrainer 中,每次权重同步都会让策略版本加一,而 max_staleness 表示一个 rollout 样本可以落后于当前策略多少个版本,超过后训练器就会将其丢弃。当 max_staleness=4 时,在 trl-policy-v3 下生成的样本,在训练器处于 v7 时仍会用于训练。在 v3 下开始的 rollout,也必须能在 v3 下完成。因此在任意时刻,vLLM 都必须同时服务当前策略以及它之前的四个策略。这就是训练器保持注册 max_staleness + 1 个适配器版本、并卸载更旧版本的原因。每次同步都是先加载新版本、再卸载最旧的版本,交换期间需要多一个槽位,于是得到 --max-loras 6。如果只有五个,vLLM 在每次同步时都会悄悄逐出一个仍有 rollout 在进行中的策略。
# --expose 8000                       reachable at https://<job_id>--8000.hf.jobs
# -v ...:/lora:ro                     read-only: the server only reads adapters
# VLLM_ALLOW_RUNTIME_LORA_UPDATING=1  enables /v1/load_lora_adapter
# VLLM_SERVER_DEV_MODE=1              enables /pause, /resume, /server_info (TRL needs all three)
# --max-loras 6                       max_staleness=4 -> 4+2 adapter slots
for replica in 1 2; do
hf jobs run --detach --flavor h200 --timeout 8h --secrets HF_TOKEN \
    --expose 8000 \
    -v "hf://buckets/${BUCKET}:/lora:ro" \
    -e VLLM_ALLOW_RUNTIME_LORA_UPDATING=1 \
    -e VLLM_SERVER_DEV_MODE=1 \
    -- vllm/vllm-openai:v0.27.1 \
    vllm serve Qwen/Qwen2.5-Math-1.5B --host 0.0.0.0 --port 8000 \
        --max-model-len 4096 --logprobs-mode processed_logprobs --generation-config vllm \
        --enable-lora --max-lora-rank 1 --max-loras 6
done
我们把 vLLM 固定在 v0.27.1。vLLM 迭代很快,上面这些参数和运行时 LoRA 端点都是该版本所提供的,因此请把版本视为配方的一部分。
另一种可能的设计是,训练器只保留最新的适配器,并始终以同一个名称发布。我们没有这样做,因为 vLLM 按适配器名称为前缀缓存建立索引。名称唯一时,用旧权重算出的 KV 块在切换后仍然能命中,预填充(prefill)就不会重做,于是一个 rollout 的前缀可能来自一个策略版本,解码却来自下一个版本。训练器无从察觉,表现出来就是 ratio 偏离 1。带版本号的名称使这种情况不可能发生:一个名称始终对应一组权重,缓存的前缀永远不会匹配到更新的版本。
数据集的选择:Sanity 集
我们选择了 sail/Sanity-Test-R1D-1.5B,这是 Defeating the Training-Inference Mismatch via FP16(Qi 等,2025)所用的数据集。复现代码位于 sail-sg/Precision-RL。
作者用 DeepSeek-R1-Distill-Qwen-1.5B 为每道 MATH 题目生成了 40 个答案,保留成功率在 20% 到 80% 之间的题目,得到 1,460 道题。这个数据集非常适合做 RL 验证,因为这些题对该模型来说既不是已经解决的,也不是毫无希望的,这意味着模型能在早期获得良好的训练信号并不断提升。
这非常适合作为稳健的端到端测试:如果某个 vLLM 副本在适配器名称下悄悄提供的其实是基础模型,我们希望在几十步之内就能从曲线上看出来。此外,这个数据集足够小,不到两个小时就能完整过一遍。
我们还采用了论文 oat/scripts/lora 中 LoRA 脚本的超参数:Qwen/Qwen2.5-Math-1.5B,LoRA rank 为 1、alpha 为 2,学习率 4e-5,每个提示 8 个样本,每步 128 条补全,最多生成 3,000 个词元,上下文为 4,096 个词元。
训练器
训练器使用同一个 vllm/vllm-openai:v0.27.1 镜像,并在其上安装 TRL。当时我们运行的是 PR 分支;同样的代码现在已随 TRL v1.14 发布。训练脚本就是一个普通的 AsyncGRPOTrainer 脚本,唯一与 Job 相关的取值是输出目录和服务器 URL。
from peft import LoraConfig
from trl.experimental.async_grpo import AsyncGRPOConfig, AsyncGRPOTrainer

config = AsyncGRPOConfig(
    output_dir="/lora/sanity-lora-r1",       # on the bucket: adapters, checkpoints and the final adapter all land here
    vllm_server_base_url="http://localhost:8000",   # the proxy, not a vLLM Job; TRL never sees the Jobs URLs
    max_staleness=4,
    weight_sync_steps=4,                     # publish an adapter every 4 optimizer steps
    save_strategy="steps", save_steps=50,    # checkpoints go to the same bucket -> resume after preemption
    ...
)
trainer = AsyncGRPOTrainer(
    model="Qwen/Qwen2.5-Math-1.5B",
    args=config,
    peft_config=LoraConfig(r=1, lora_alpha=2, target_modules="all-linear"),  # plain LoRA vLLM can serve as-is
    ...
)
初始化时,TRL 会调用
/server_info。如果发现lora_config,就使用仅适配器同步。vLLM 无法直接服务的配置,例如 DoRA、modules_to_save,或 rank 高于--max-lora-rank,会回退到合并权重同步并给出警告。日志中应当出现Adapter-only vLLM sync enabled。
代理
接下来是有趣的部分。训练器与 vLLM Job 之间需要一个代理,原因有两个:
- 对外暴露的 Job 端口要求每个请求都带
Authorization: Bearer <HF token>头。代理就是添加这个头的地方,这样 TRL 就不需要知道它的存在。 - 我们希望有不止一块 GPU 在做生成。在单个 vLLM 服务器上,通常的做法是
--data-parallel-size > 1,但 TRL 在该模式下拒绝仅适配器同步,这是有道理的:对/v1/load_lora_adapter的一次调用只会到达应答它的那个 DP rank,于是其他 rank 会在新的策略名称下继续服务基础模型。在 Jobs 上这个问题根本不会出现,因为每个副本都是一台独立的机器。所以数据并行必须放在更上一层,由某个组件把适配器加载请求扇出到每个副本。
因此,我们在训练器 Job 的 127.0.0.1:8000 上运行一个小型代理,并让 TRL 把它当作单个 vLLM 服务器来访问。除了添加认证头之外,代理在功能上还做两件事:
- 它把每个补全请求发送给某一个副本,选择的依据是让一个提示的八次 rollout 落在其前缀已被缓存的地方(详情见下文)。
- 它把每个会改变状态的请求,例如适配器加载、暂停和恢复,广播给所有副本,使得一个策略名称在任何地方含义都相同。
按 KV 前缀路由 rollout
先简单回顾一下为什么这很重要。生成一条补全分为两个阶段,它们的工作负载特征差别很大:
- 预填充(prefill)一次性处理整个提示,并为每个提示词元计算注意力的 key 和 value。
- 解码阶段则一次产生一个词元,每个新词元都要对它之前所有词元的 key 和 value 做注意力计算。
这些 key 和 value 就是 KV 缓存。由于注意力是因果的,一个词元的 KV 只取决于它之前的词元,与其后内容无关。因此,共享同一前缀的两个请求也共享该前缀的 KV,而已把它放在缓存里的副本可以完全跳过这一部分预填充。整个游戏的关键就在于找到那个副本,让请求落到已经见过其前缀的副本上而受益。
vLLM 以 16 个词元为一块来存储其前缀 KV 缓存。由于 GRPO 的缘故,rollout worker 会发送 G 个相同提示的请求(在我们的例子中是 G=8)。如果它们都到达同一个副本,第一个请求计算预填充,后面七个复用它。若采用轮询(round-robin)路由,会有一半请求去往没有缓存该前缀的副本,这四个请求就要重做预填充,白白浪费宝贵的 GPU 算力。
我们的路由器的工作,是追踪哪个副本见过哪些块哈希。一个重要细节是这些哈希是链式的,因此第 3 块的哈希代表第 1、2、3 块,而不只是第 3 块。这与因果注意力相呼应:只有第 1、2 块也相同,第 3 块的 KV 才有效。我们还用适配器名称作为哈希链的种子,因为 KV 缓存也取决于生成它的适配器:为策略 v3 缓存的前缀对策略 v4 毫无用处!
两个提示、四个请求、两个副本上的路由决策:16 词元的块、链式哈希、公共前缀、一次亲和命中和一次溢出。
视频演示了选择副本的完整决策过程。下面的步骤则以一个真实的 135 词元补全请求为例(来自 Sanity 数据集的题目):
1. 把提示切分成块。路由器接收词元 id,并像 vLLM 一样把它们切成 16 个词元一块。它只对完整的块做哈希,所以最后 7 个词元在这里被忽略。
2. 对前缀做哈希。每个块都与前一个哈希一起做哈希,起点是适配器种子。因此 h3 按顺序标识第 1、2、3 块。前 k 块相同的两个提示,其哈希到 hk 为止都相同。一旦某一块发生变化,其后的所有哈希也都随之变化。这就是我们用适配器名称给哈希设种子的原因:同一个提示在 trl-policy-v4 下从另一个种子开始,无法匹配 v3 的条目。这正是我们想要的,因为旧的 KV 块是用不同权重算出来的。
3. 比较两个提示。题目 1 有 103 个词元。两个提示都以同样的 23 词元聊天模板开头。它们的第一块完全相同,但第 2 块已经包含题目文本,哈希从这里开始出现差异。
4. 记录所有者。对每个哈希,路由器记住哪些副本服务过它,以及哪些哈希跟在它后面(我们把后继集合的上限设为两个,因为只需要知道一个块有一个后续还是多个后续)。经过几个提示之后,模板块 h1 为两个副本所共有,并且已有多个后继;h2 到 h8 仅归 A 所有,且各自只有一个后继;h2' 到 h6' 仅归 B 所有。
实际上,一次运行中的每个提示都以相同的词元开头。这里就是聊天模板和系统提示,占据全部 1,460 道题的前 23 个词元。在智能体场景中,它会是工具描述;在多轮环境中,它会是共享的对话历史。这些块在几秒钟内就会出现在每个副本的缓存中,因此匹配它们无法告诉我们某个特定提示在哪里。
如果每个副本都服务过某个块,或者它有多个后继,这个块就是公共块。路由时会忽略公共块,因为它们不能标识某个特定的提示。下文会详细说明!
5. 选择副本。路由器统计每个副本上有多少个开头的块匹配,并去掉公共前缀。剩下的就是这个提示特有的块数。然后:
- 如果某个副本有特有的块,并且它没有被压垮,即比负载最小的副本最多多 8 个请求,请求就发往该副本。我们称之为亲和命中。
- 如果某个副本有特有的块,但它比负载最小的副本多出超过 8 个请求,我们就放弃缓存,把请求发给负载最小的副本。我们称之为溢出。
- 如果没有任何副本有特有的块,这就是一个新提示。它被发往负载最小的副本,负载相同则轮询。我们称之为未匹配。
下面把这条规则应用到四个请求上。起始状态是副本 A 和 B 各有 3 个请求在处理中,且两个副本上都只知道模板块 h1。
- 请求 1,题目 0,rollout 1。两个副本都匹配一个块,即模板,而该块是公共块。所以没有任何地方匹配到特有的块。该请求为未匹配,两个副本负载相同,轮询把它发给 A。路由器记录
h2到h8归 A 所有。A 现在有 4 个请求在处理中。 - 请求 2,题目 0,rollout 2。同一个提示。A 匹配全部 8 个块,B 只匹配模板。去掉那个公共块后,A 有 7 个特有的块,B 没有。A 只比 B 多 1 个请求,远在上限 8 之内,所以请求发往 A。这是一次亲和命中:A 的 KV 缓存中已经有整个提示。
- 请求 3,题目 1,rollout 1。一个新提示。两个副本都只匹配模板块,所以没有匹配到特有的块。该请求为未匹配,发往负载最小的副本 B,B 有 3 个在处理,而 A 有 5 个。路由器记录
h2'到h6'归 B 所有。 - 请求 4,题目 0,rollout 9。假设此时 A 有 12 个请求在处理,而 B 回落到 3 个。A 仍然有那 7 个特有的块,但它现在比 B 多出 9 个请求,超过了上限。请求溢出到 B。B 对题目 0 做一次预填充,路由器记录
h2到h8也归 B 所有。现在每个副本都服务过这些块,于是题目 0 也变成公共的,它之后的 rollout 仅按负载来分配。
6. 复用预填充。请求 2 就是做这一切的原因。它复用了请求 1 计算出的预填充:第 1 到 8 块已经在 A 的 KV 缓存中,所以 A 直接跳到解码补全。如果它被发到 B,B 就得把全部 135 个词元重新预填充一遍,而 A 的缓存却闲置。请求 3 说明了为什么需要 common 这条规则。没有它,共享的聊天模板会让每个新提示看起来都像缓存命中。请求 4 让负载保持在可控范围内。为了省下一次预填充而让某个副本远远落后,并不划算。
def choose(self, upstreams, model, prompt):
    hashes = self.block_hashes(model, prompt)         # chained blake2b over 16-token blocks, seeded with `model`
    matched = self.matched_prefix(hashes)             # per replica: leading blocks it has served
    common = self.common_prefix_len(hashes)           # leading blocks that identify no prompt (see below)
    specific = [max(0, m - common) for m in matched]  # what actually distinguishes replicas
    least = min(u.inflight for u in upstreams)
    best = max(range(self.n), key=lambda i: (specific[i], -upstreams[i].inflight))

    if specific[best] > 0 and upstreams[best].inflight - least <= self.cfg.imbalance:
        pick = best                                   # affinity: the replica that has this prompt, and is not swamped
    else:
        candidates = [i for i in range(self.n) if upstreams[i].inflight == least]
        pick = candidates[self.rr % len(candidates)]  # spill or new prompt: least-loaded, round robin on ties
        self.rr += 1
    ...record `pick` as an owner of every block, and each block's successor...
    return upstreams[pick]
common 前缀是麻烦的部分。每个请求都以同样的系统提示和聊天模板开头。简单的最长前缀匹配会让第一个副本对几乎每个新提示都显示为匹配。我们改为通过扇出来检测共享前缀:拥有多个不同后继的块是公共块,而总是通向同一个后继的块则属于某个特定的提示。只有该公共前缀之后的块才算作亲和。
广播适配器
代理还需要把适配器加载请求广播给每个副本。我们把这一操作视为全有或全无。每个副本都有自己的存储桶挂载,所以它们不一定在完全相同的时刻看到新适配器。出现 No adapter found for <path> 错误通常意味着某个存储桶挂载还没有同步到位,我们只重试那个副本。对于其他任何错误,我们会从已接受该适配器的副本上卸载它,这样一个策略名称就不会只存在于部分副本上。
async def load_one(u):
    while True:
        status, _, out = await send(u, "POST", "/v1/load_lora_adapter", headers, body)
        if status == 200 or "No adapter found" not in out.decode() or time.monotonic() > deadline:
            return u, status, out
        await asyncio.sleep(cfg.lora_retry_s)          # this replica's mount has not seen the directory yet

results = await asyncio.gather(*(load_one(u) for u in ups))
if any(st != 200 for _, st, _ in results):
    await asyncio.gather(*(send(u, "POST", "/v1/unload_lora_adapter", headers, unload) for u, st, _ in results if st == 200))
    return web.Response(status=504 if timed_out else st, text="rolled back on the others")
我们还以同样的方式广播 /pause、/resume 和 /v1/unload_lora_adapter。/health 只有在每个副本都健康时才返回 200。/server_info 和 /v1/models 只需要一个应答。从 TRL 的角度看,代理就是单个 data_parallel_size=1 服务器,因此它会选择仅适配器同步。
我们起初担心 Python asyncio 代理会成为瓶颈。事实并非如此(至少在这个规模下)。同时在处理中的非流式 JSON 请求最多 128 个,而路由只需计算几个哈希,一个线程就能轻松应付。如果需要处理更多流量,更精细的路由器大概需要用更快的语言来写(说的就是你 🦀)。
完整运行结果
下面的数字来自训练器在 trackio 上的记录指标。这次运行使用 Qwen/Qwen2.5-Math-1.5B,在 all-linear 上使用 LoRA r=1,每步 128 条补全,每个提示 8 次 rollout。运行 500 步,每 50 步保存一次检查点。训练器使用一个 h200x2 Job,两个 vLLM 副本各使用一个 h200 Job。三者一起运行,每小时约 20 美元。
权重同步
| 每次同步,训练器计时,共 126 次同步 | 之前 | 现在(p50) |
|---|---|---|
| 整个同步 | 30.8 秒 | 8.5 秒(最小 6.6,最大 9.2) |
| 其中:暂停两个副本 | 0.3 秒 | 0.3 秒 |
| 适配器 all-gather 并保存到存储桶 | 0.6 秒 | 1.1 秒 |
| 两个副本接受适配器 | 约 29 秒 | 约 7 秒 |
全部 252 次适配器加载都成功了 🎉:126 次同步乘以 2 个副本。其中 6 次在第二次尝试时成功,246 次在第三次尝试时成功。
路由
运行结束时,在 64,728 次 rollout 之后,代理的计数器显示:
routed [31928, 32800] affinity 54712 spilled 820 unmatched 9196
每个提示有 8 次 rollout,八个请求中至少有一个必然是冷启动。因此理论下限是 12.5%。路由器的实际结果是 14.2% 的请求未匹配、84.5% 亲和命中、1.3% 溢出。除非我们开始基于真实测得的负载,借助更深入的推理侧指标来观察每个副本的负载,否则这里已经没有多少收益可挖了。
时间花在哪里
第一种配置有一个相当明显的问题:瓶颈在训练器而不是生成。在这 500 步中,我们看到:
| 每个优化器步骤,p50 | |
|---|---|
| 步骤 | 22.9 秒 |
| 前向 + 反向 | 21.9 秒 |
| 等待 rollout | 0.02 秒 |
| rollout 队列占用 | 476 / 512 |
| 训练器 MFU | 3.9 % |
rollout 队列始终是满的,worker 大部分时间被背压阻塞。在这种配置下,第二个副本基本上毫无用处。本文后面会讲到,我们如何通过几轮运行在训练与生成之间来回转移瓶颈,最终让运行速度提升到 3.9 倍。
奖励
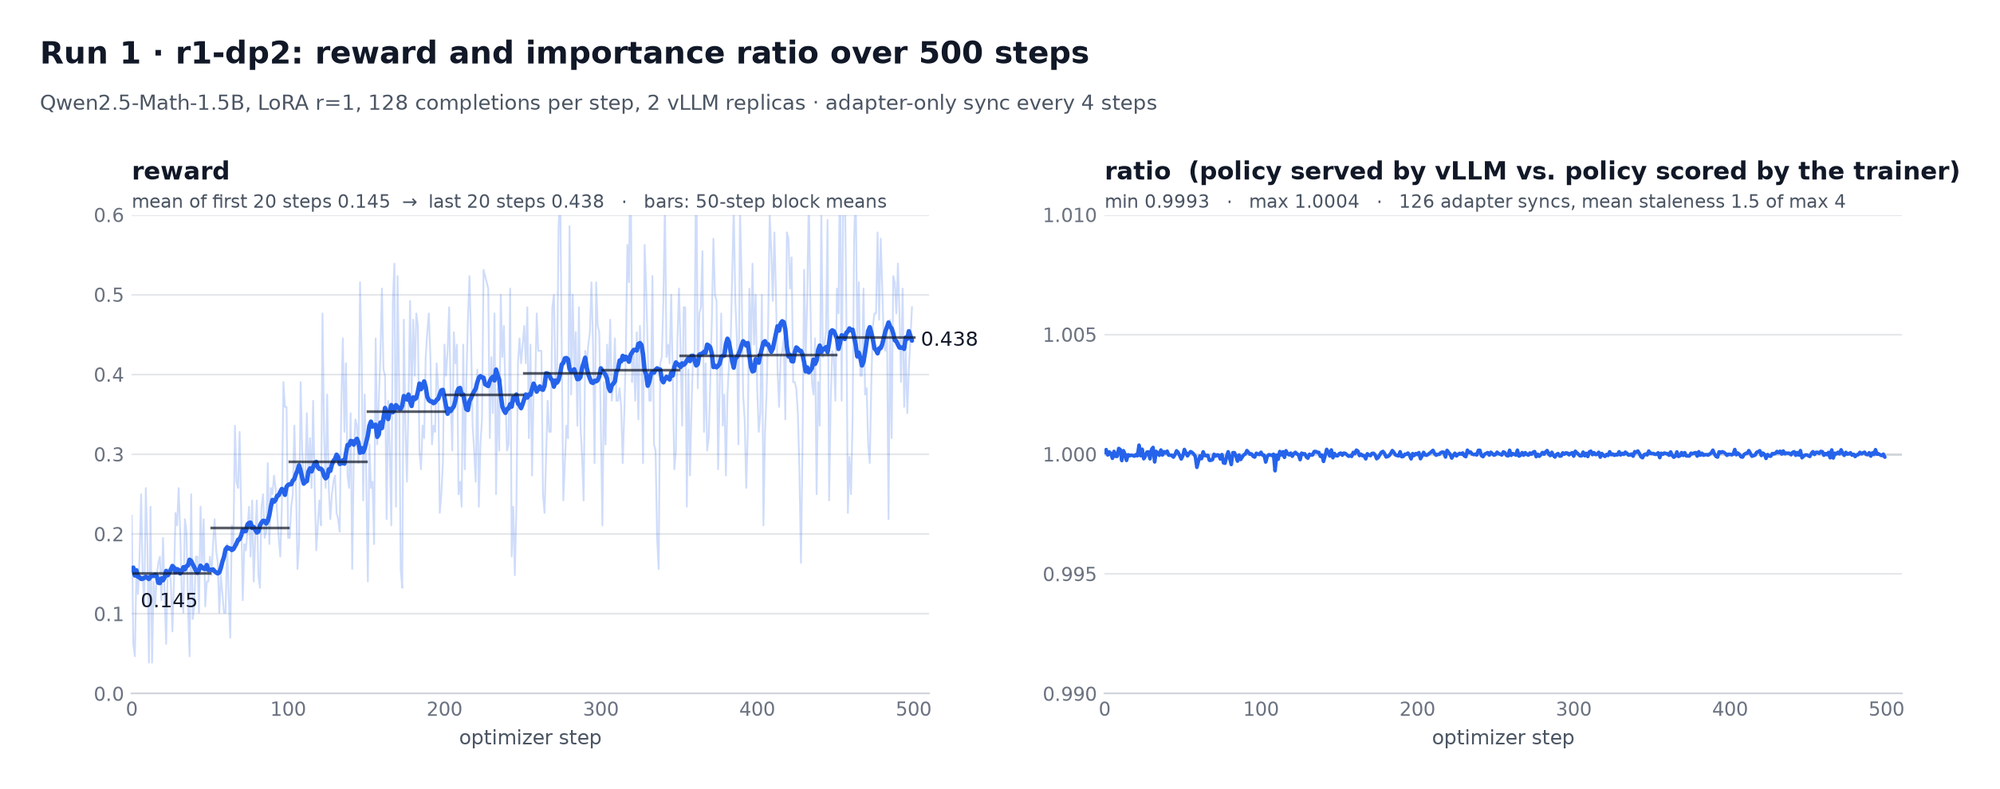
图 1. trackio 运行 r1-dp2。面板:reward,含其 20 步滑动均值和 50 步分块均值,以及纵轴范围为 0.99 到 1.01 的 ratio。奖励在 500 步中从 0.15 升到 0.44;ratio 全程保持在 0.9993 到 1.0004 之间。
500 步用了 3 小时 27 分钟。平均奖励从前 20 步的 0.145 升至最后 20 步的 0.438。对这次测试更重要的是,ratio 在每一步都保持在 1.000!vLLM 所服务的策略始终与训练器用来给 rollout 打分的策略一致,这在全部 126 次同步中都成立。平均陈旧度为 1.5 个策略版本,最大值为 4。完整曲线见 trackio 仪表盘。
这就是 LoRA AsyncGRPO 可行的无可辩驳的证据!接下来,让我们借助最新的详细 AsyncGRPO 指标,看看如何改进训练运行。
追逐瓶颈的乒乓球
异步 RL 是训练与生成之间的流水线。如果另一侧跟不上,让一侧变快毫无意义。幸运的是,我们在 AsyncGRPOTrainer 中加入了足够多的计时和指标,可以直接观察这一点。
所有有用的指标都记录在记录指标一节中。perf/rollout_wait_s 告诉我们训练器等待样本的时间。rollout/backpressure_s 告诉我们生成端等待 rollout 队列空出位置的时间。两者截然相反,不应同时偏高。结合队列大小,它们能告诉我们哪一侧慢。
我们做了五组实验。每一组都从上一次运行的仪表盘中可见的某个问题出发。除非另有说明,模型、配方和三个 Job 的布局保持不变。下面的名称是 trackio 的运行名称。
读懂仪表盘
我们让下面这四组指标保持可见:
perf/step_s和perf/fwd_bwd_s:一个优化器步骤要多长时间,其中前向+反向占多少。如果一个步骤的耗时几乎等于前向+反向,那么训练器显然是计算受限的。perf/rollout_wait_s:训练器在开始一个步骤之前等待样本的时间。接近零意味着生成领先于训练,样本可随时拿来训练。sample/rollout_queue_size对比queue_maxsize:两侧之间的缓冲区。满意味着生成被限流;空意味着训练器在挨饿。rollout/backpressure_s和rollout/score_block_s:rollout worker 因缓冲区已满而被阻塞的时间。worker 是一条两阶段流水线:生成把完成的分组交给打分阶段,打分再把已打分的样本推入 rollout 缓冲区。缓冲区满时,打分无法入队而阻塞,这就是rollout/backpressure_s。随后打分不再排空自己的输入队列,于是生成也无法交出下一个分组,这就是rollout/score_block_s。两者是同一次停顿,先在打分阶段出现,然后向后传导到生成阶段。
诊断很简单:队列满、rollout 等待为零、背压很高,说明训练器太慢。队列空、rollout 等待上升且没有背压,说明生成太慢。比较 perf/mfu_wall_clock 和 perf/mfu_fwd_bwd 还能看出训练器 GPU 有多少时间花在等待而不是训练上。
运行 1,r1-dp2:跟不上的训练器

图 2. trackio 运行 r1-dp2。面板:perf/step_s、perf/fwd_bwd_s、sample/rollout_queue_size、rollout/backpressure_s。步骤时间与前向+反向几乎完全重合;队列固定在 512 中的 476 附近,背压在每个 rollout 分组上从未低于 11 秒:训练器受限。
perf/step_s 为 22.9 秒,perf/fwd_bwd_s 为 21.9 秒。前向和反向占步骤时间的 96%。队列一直是满的,训练器只等待 rollout 0.02 秒,而 rollout worker 每个分组有 15 秒被背压阻塞。两个 vLLM 副本生成得比训练器消耗得更快。报告的 4.6k tokens/s 并不是它们的实际上限,只是它们没有地方放更多输出。
批次指标解释了糟糕的 3.9% MFU。batch/microbatches_per_step 为 64,batch/samples_per_row 为 1.0。每个 rank 每步处理一条约 1.2k 词元的序列,共处理 64 次。这来自参考配方的 per_device_train_batch_size=1。对于 H200 上的 1.5B 模型,这完全是延迟受限的。
运行 2,r1-dp2-tb16k:打包微批次
解决办法不是改变批大小。我们保持每个优化器步骤 128 条补全,只改变它们在 GPU 上的排布方式:不再是每个微批次一条序列,而是把许多序列紧密地打包进每一行。训练器通过词元预算批处理(token-budget batching)支持这一点。使用 token_budget > 0 时,它会把多个样本打包进每个 rank 的一行无填充数据中。一个优化器步骤处理 gradient_accumulation_steps 行。我们设置了 token_budget=16384 和 gradient_accumulation_steps=6。

图 3. trackio 运行 r1-dp2 和 r1-dp2-tb16k 在前 154 步上的叠加。面板:batch/samples_per_row、batch/microbatches_per_step、perf/step_s、perf/fwd_bwd_s、perf/mfu_fwd_bwd、rollout/generated_tok_s。打包使每行样本数从 1 增至 13,微批次从 64 降至 6,步骤时间从 23 秒降至 5.9 秒,生成速度从 4.2k 升至 27.5k tok/s,而 vLLM 一侧没有任何改动。
batch/samples_per_row 从 1.0 升到约 12.7,微批次数量从 64 降到 6。各行的填充率达到 95%!前向和反向从 21.9 秒降到 5.6 秒,MFU 从 3.9% 升到 19%。由于各行的打包效果好于按平均长度估计的结果,我们现在每步大约训练 150 个样本。
即使我们没有改动 vLLM 一侧的任何东西,生成速度也从 4.6k 跃升到 25k tokens/s。队列不再一直是满的,副本终于可以跑起来了。这就是我们不喜欢孤立地优化流水线各阶段的原因。我们需要小心地评估整个系统,因为一个慢的阶段可能会掩盖它之前所有部分的真实性能。
运行 3,r1-dp2-tb16k-nockpt:不再重算前向
perf/fwd_s 为 1.34 秒,而 perf/fwd_bwd_s 为 5.6 秒。通常反向的开销大约是前向的两倍,而在基础权重冻结时应该更接近一倍。3.2 的比值令人起疑。
原因是 AsyncGRPOConfig 默认为 gradient_checkpointing=True。每个微批次在反向过程中都会重新计算它的前向。这也解释了为什么一个 16k 词元的行在 141 GB 的 H200 上只占用 25 GB!这是该训练器的一种内存优化,但在这个具体场景中我们并不需要它:模型足够小,可以连同为反向保留的激活值一起放进显存。

图 4. trackio 运行 r1-dp2-tb16k 和 r1-dp2-tb16k-nockpt 在前 134 步上的叠加。面板:perf/fwd_s、perf/fwd_bwd_s、perf/weight_sync_s、sample/rollout_queue_size、perf/rollout_wait_s、perf/mfu_fwd_bwd。前向+反向少了一次前向;队列从约 420 降到约 60,rollout 等待从 0.02 秒升到 0.5 秒:瓶颈转移到了生成。
使用 gradient_checkpointing=False 后,前向和反向降到 4.6 秒,几乎正好少了一次前向,MFU 达到 23%。队列现在降到 71,rollout 等待从 0.04 秒升到 0.6 秒。训练器消耗样本的速度快于两个副本生成样本的速度。我们成功地把瓶颈转移到了生成。
这暴露出另外两项开销。每四步一次、耗时 7.6 秒的权重同步,现在占用了 25% 的墙钟时间;当每步需要 23 秒时,它只占 8%。此外,反向仍然比前向慢 2.5 倍。在基础权重被冻结的情况下,每步有大约 2 秒的时间看起来并不像正常的模型计算。
运行 4,r1-dp3-tb16k-nockpt:三个副本,以及一个意外
既然生成现在太慢,我们增加了第三个副本。我们还把代理中适配器的重试间隔从 2 秒缩短到 0.5 秒,并禁用了 fsdp_reshard_after_forward,以检验反向中多出的 2 秒是否由 FSDP2 重新聚合引起。

图 5. trackio 运行 r1-dp2-tb16k-nockpt 和 r1-dp3-tb16k-nockpt 在前 134 步上的叠加。面板:perf/weight_sync_s、rollout/generated_tok_s、rollout/inflight、perf/fwd_bwd_s。同步从 7.6 秒降到 5.8 秒;生成和前向+反向没有变化;两次运行中 rollout/inflight 都是 128,这正是第三个副本碰到的上限。
权重同步从 7.6 秒降到 5.8 秒,可见更短的重试间隔确实有帮助。前向和反向仍然是 4.6 秒,这排除了重新分片的因素。生成速度只是从 25k 升到 26k tokens/s。第三个副本基本上什么也没做。
原因就藏在 rollout/inflight 中:每次运行都是 128。代理显示这些请求在三个副本上被分成 44 + 43 + 41。max_inflight_tasks 限制的是整个 rollout worker 的并发数,而不是每个副本的。在 H200 上,1.5B 模型处理 43 条和 130 条并发序列,每个词元的成本几乎相同。把 128 个请求分到三块 GPU 上,吞吐量与分到两块上几乎一样。
所以限制并不在 vLLM,而在我们自己的客户端常量。我们当初把它设得很保守,因为不知道数百个长 HTTPS 请求经过公共 Jobs 代理时会有什么表现。到这时,已有 130,000 次 rollout 补全通过了它,没有出现一次传输错误。
运行 5,r1-dp3-inflight384:取消对在途请求数的限制
max_inflight_tasks=384 和 queue_maxsize=768,没有别的改动。

图 6. 全部五次 trackio 运行(r1-dp2、r1-dp2-tb16k、r1-dp2-tb16k-nockpt、r1-dp3-tb16k-nockpt、r1-dp3-inflight384)叠加,横轴为步数。面板:perf/step_s、reward、sample/rollout_queue_size、sample/staleness_mean。步骤时间在整个系列中从 22.9 秒降到 4.8 秒,而奖励曲线彼此重合;最后一次运行的队列重新填充到 768 中的约 690,陈旧度稳定在 2。运行 2 到 4 在仪表盘回答了问题之后就提前停止了。
有 384 个请求在途时,每个副本分到 128 个。队列很快填充到 768 中的约 690 并保持在那里。背压回到 5 秒,rollout 等待降到 0.03 秒。训练再次成为瓶颈!前向和反向耗时 4.6 秒,权重同步摊销后增加 1.5 秒,步骤时间中位数为 4.8 秒。
平均陈旧度从 1.5 升到 2.0 个版本,因为样本在更大的队列中等待更久。这仍低于 max_staleness=4,而且 ratio 依然非常接近 1.000。
成绩单
| 500 步 | 运行 1 r1-dp2 |
运行 5 r1-dp3-inflight384 |
|---|---|---|
| 墙钟时间 | 3 小时 27 分钟 | 53 分钟 |
perf/step_s,p50 |
22.9 秒 | 4.8 秒 |
perf/fwd_bwd_s,p50 |
21.9 秒 | 4.6 秒 |
perf/mfu_fwd_bwd |
3.9 % | 23.5 % |
batch/samples_per_step |
128 | 168 |
| 训练样本数 | 64 000 | 84 078 |
perf/weight_sync_s,p50 |
8.5 秒 | 6.2 秒 |
sample/staleness_mean |
1.5 | 2.0 |
| 奖励,前 20 步 → 后 20 步 | 0.145 → 0.438 | 0.145 → 0.416 |
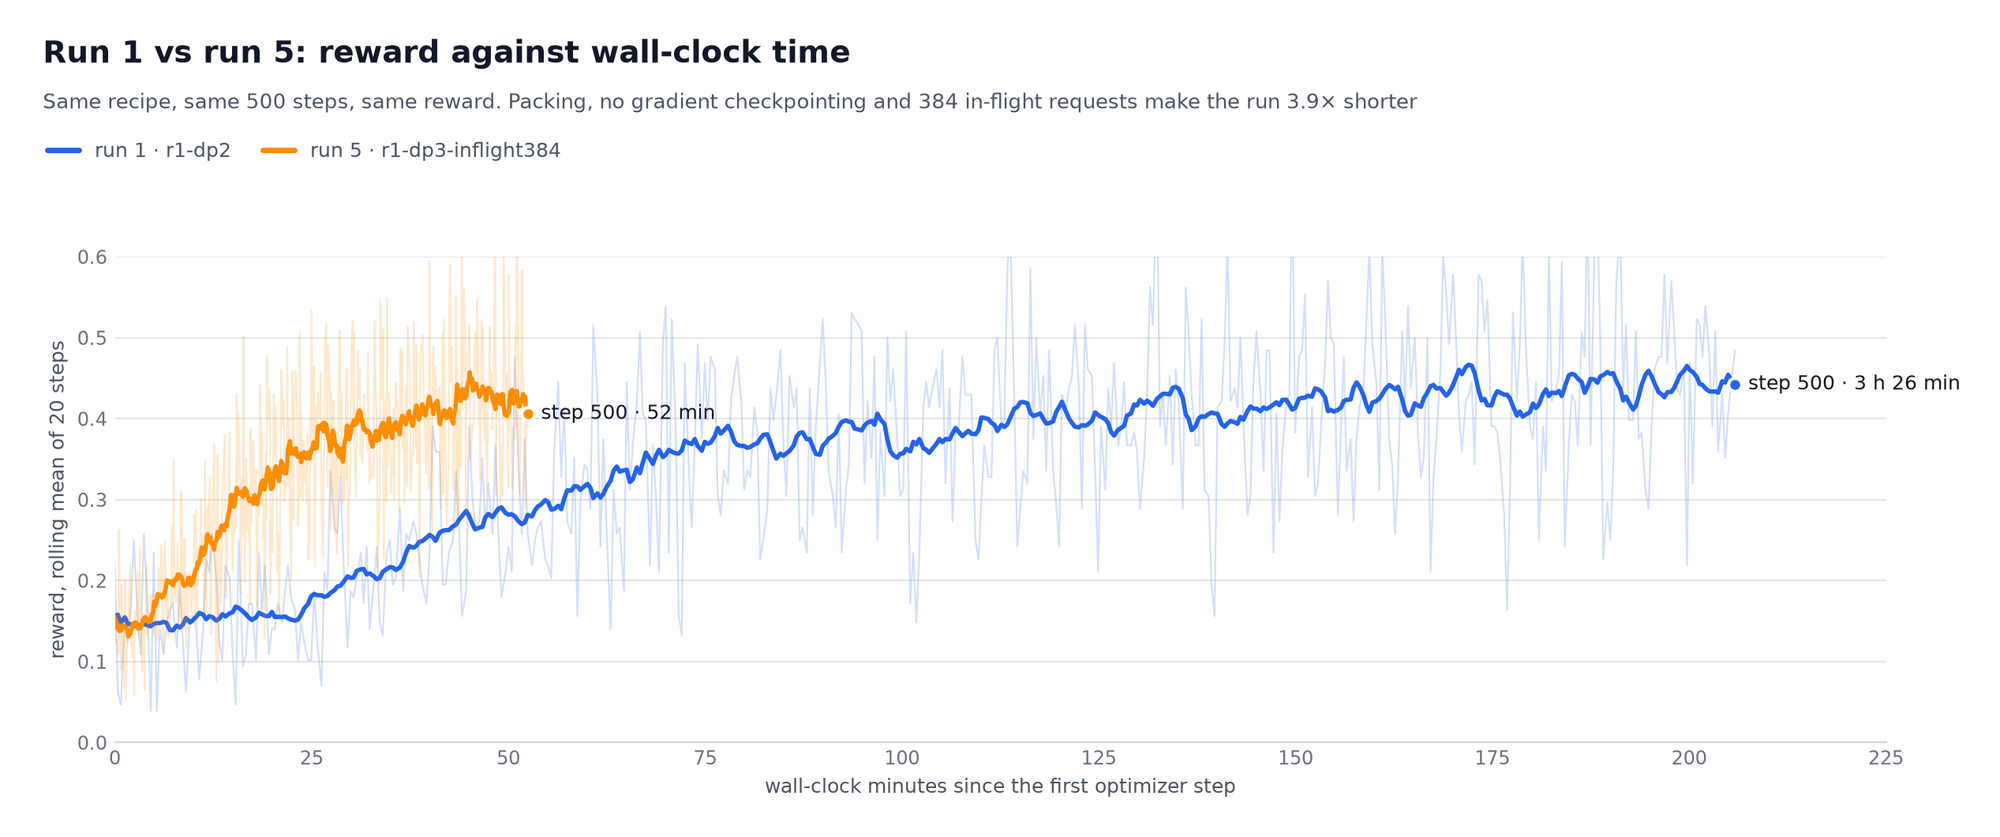
图 7. trackio 运行 r1-dp2 和 r1-dp3-inflight384,奖励随自第一个优化器步骤起的墙钟分钟数变化。配方相同、同样 500 步、最终奖励相同;运行 5 只用 52 分钟就达到,而不是 3 小时 26 分钟。
最后一次运行快了 3.9 倍,训练的样本多了 31%,而奖励曲线基本相同。打包、禁用检查点(激活重计算)以及提高在途请求上限起了关键作用。在每一种情况下,仪表盘都在最初十分钟内就把问题看得清清楚楚。
动手试试
git clone https://github.com/AmineDiro/hfjobs-lora-buckets && cd hfjobs-lora-buckets
hf auth login
MAX_STEPS=20 RUN_TAG=smoke ./run_all.sh --wait        # ~15 min, three Jobs, cancels the servers when done
MAX_STEPS=500 ./run_all.sh --wait                     # run 1: the reference batch shape, ~3.5 h
TOKEN_BUDGET=16384 GRAD_ACCUM=6 GRADIENT_CHECKPOINTING=0 PROXY_LORA_RETRY_S=0.5 \
  MAX_INFLIGHT=384 QUEUE_MAXSIZE=768 MAX_STEPS=500 ./run_all.sh --wait   # run 5: same recipe, ~55 min
参考资料
- John Schulman 等,LoRA Without Regret,Thinking Machines Lab,2025 年 9 月。论证了 rank-1 LoRA 在策略梯度 RL 上可与全量微调持平及其原因。
- TRL,
AsyncGRPOTrainer及其记录指标。 - TRL PR #7017:为
AsyncGRPOTrainer提供 PEFT/LoRA 支持及仅适配器的 vLLM 同步,已随 TRL v1.14 发布。 - Hugging Face Jobs 和 Storage Buckets;
hf-mount。 hf-mount-repro:对 30 秒负缓存停顿的双脚本复现。- 本文中每次运行的 trackio 仪表盘。
- Penghui Qi, Zichen Liu, Xiangxin Zhou, Tianyu Pang, Chao Du, Wee Sun Lee, Min Lin,Defeating the Training-Inference Mismatch via FP16,arXiv:2510.26788,2025。Sanity 数据集
sail/Sanity-Test-R1D-1.5B和 LoRA 配方sail-sg/Precision-RL、oat/scripts/lora/bf16_grpo_tis_lora.sh的来源。
@article{qi2025precisionrl,
  title={Defeating the Training-Inference Mismatch via FP16},
  author={Qi, Penghui and Liu, Zichen and Zhou, Xiangxin and Pang, Tianyu and Du, Chao and Lee, Wee Sun and Lin, Min},
  journal={arXiv preprint arXiv:2510.26788},
  year={2025}
}