消费级可穿戴设备利用运动和生理传感器来估计活动量和睡眠,但这些信号只能间接反映血糖调节情况。连续血糖监测仪(CGM)通过植入皮下的小型传感器,每隔几分钟追踪一次组织间液葡萄糖,捕捉空腹、夜间和餐后的变化模式,从而补充了这些测量。然而,要读懂这些曲线仍然很有挑战,尤其是在有助于解读它们的高质量临床标签稀少且获取成本高昂的情况下。
许多现有的 CGM 基础模型,包括 CGMformer、GluFormer 和 CGM-JEPA,都是通过单一表征流来处理血糖数据,而没有明确区分缓慢的基线动态和短暂的事件动态。但 CGM 并不是一条无差别的数据流:它包含相对缓慢的基线模式,其间穿插着短期偏离,这些偏离可能反映进餐、活动或传感器伪影。如果我们能利用每日 CGM 数据,在标注数据有限的情况下估计糖尿病风险、胰岛素抵抗和β 细胞功能障碍等指标,会怎样?
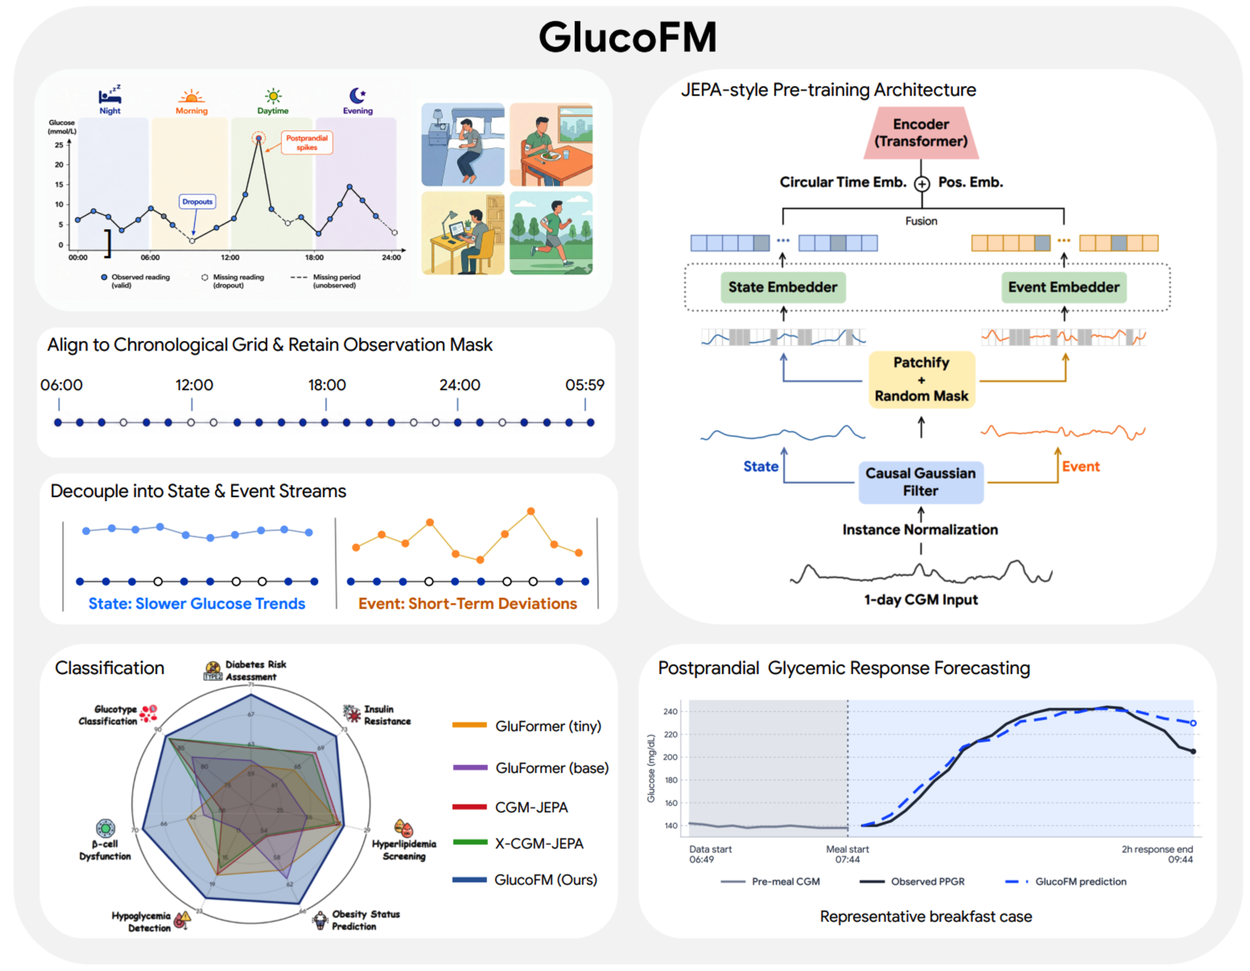
这就是我们构建 GlucoFM 的原因。它是一个自监督基础模型,采用双流设计,将较慢的血糖趋势与短期偏离分开,同时保留一天中的时间信息和缺失情况。随后,潜在预测目标会学习它们的每日上下文和时间演化。我们在四个不同的队列上,对七项临床预测任务评估了 GlucoFM,这些任务是糖尿病风险、胰岛素抵抗、β 细胞功能障碍、高脂血症、低血糖、肥胖和血糖类型(glucotype),共计 14 项队列–任务评估。在这些评估中,GlucoFM 的 PR-AUC 平均比所评估的表现最好的 GluFormer 变体高 5.8 个百分点,两者在同一语料上预训练。在 PR-AUC 上,GlucoFM 在所有糖尿病风险和 β 细胞功能障碍评估中均领先,在四项胰岛素抵抗评估中领先三项。我们还在餐后血糖反应(PPGR)预测上评估了 GlucoFM。在输入和评估协议一致的条件下,GlucoFM 取得了最低的平均绝对误差(MAE),为两种 CGM 设备(Dexcom 和 Libre)上的平均值。此外,GlucoFM 取得了最佳的整体跨数据集迁移性能,并展现出强大的少样本适应能力,即使新队列或带标签受试者的数据极为有限也是如此。
训练 GlucoFM 理解代谢
我们在 109,066 小时的无标签 CGM 数据上预训练了 GlucoFM,数据来自 Wear-CGM[8e73d8] 和四个已发表的数据集,共计 477 条受试者/会话记录。
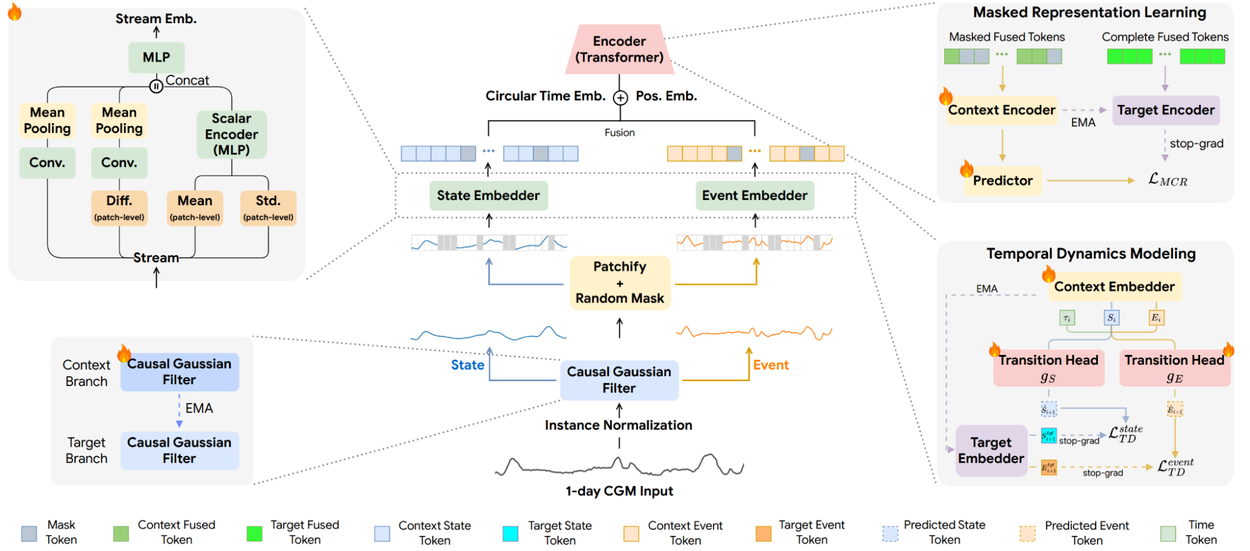
CGM 记录可能存在缺口、采样间隔不一致以及传感器伪影。GlucoFM 将每条记录对齐到 24 小时、五分钟间隔的网格,并保留观测掩码,使已测量位置与未观测位置保持区分。其双流编码器把代表较慢血糖趋势的低频状态分量,与捕捉短期偏离的残差事件分量分离开来,这些短期偏离可能源自生理、行为或传感伪影。
GlucoFM 没有去重建精确的原始血糖读数(它们可能受到测量噪声和传感器伪影的影响),而是采用潜在预测式预训练,包含两个互补的任务:
- 上下文预测:我们对每日血糖序列的部分片段进行掩码(即隐藏),并让模型根据周围的上下文预测其潜在表征。由于是在潜在空间中预测,模型可以捕捉更宏观的每日血糖模式,而不必重建每一个传感器读数。
- 时间动态:我们还训练模型预测一个人稳定的基线和短期偏离会如何逐小时变化。这促使它捕捉血糖动态的连续性,而不是把读数当作时间上相互孤立的快照。
最后,感知 CGM 特性的数据增强会引入基线漂移、类似压迫的骤降、更稀疏的采样以及短暂断连,使模型接触到真实 CGM 记录中出现的各种变化和缺失。
GlucoFM 能做什么
我们在四个队列(CGMacros、Stanford、Hall 和 ShanghaiT2DM)上,对七项临床预测任务评估了 GlucoFM,同时还单独评估了两小时餐后血糖反应预测。具体来说,我们要回答的问题是:它的冻结表征对来自未见过受试者的单个 24 小时窗口是否有信息量;它们能否为预测餐后血糖轨迹提供有用的历史上下文;合并多天数据是否能改善受试者层面的预测;这些表征向新队列迁移的效果如何;以及在带标签数据有限时适应得有多有效。
各项代谢任务上的准确率
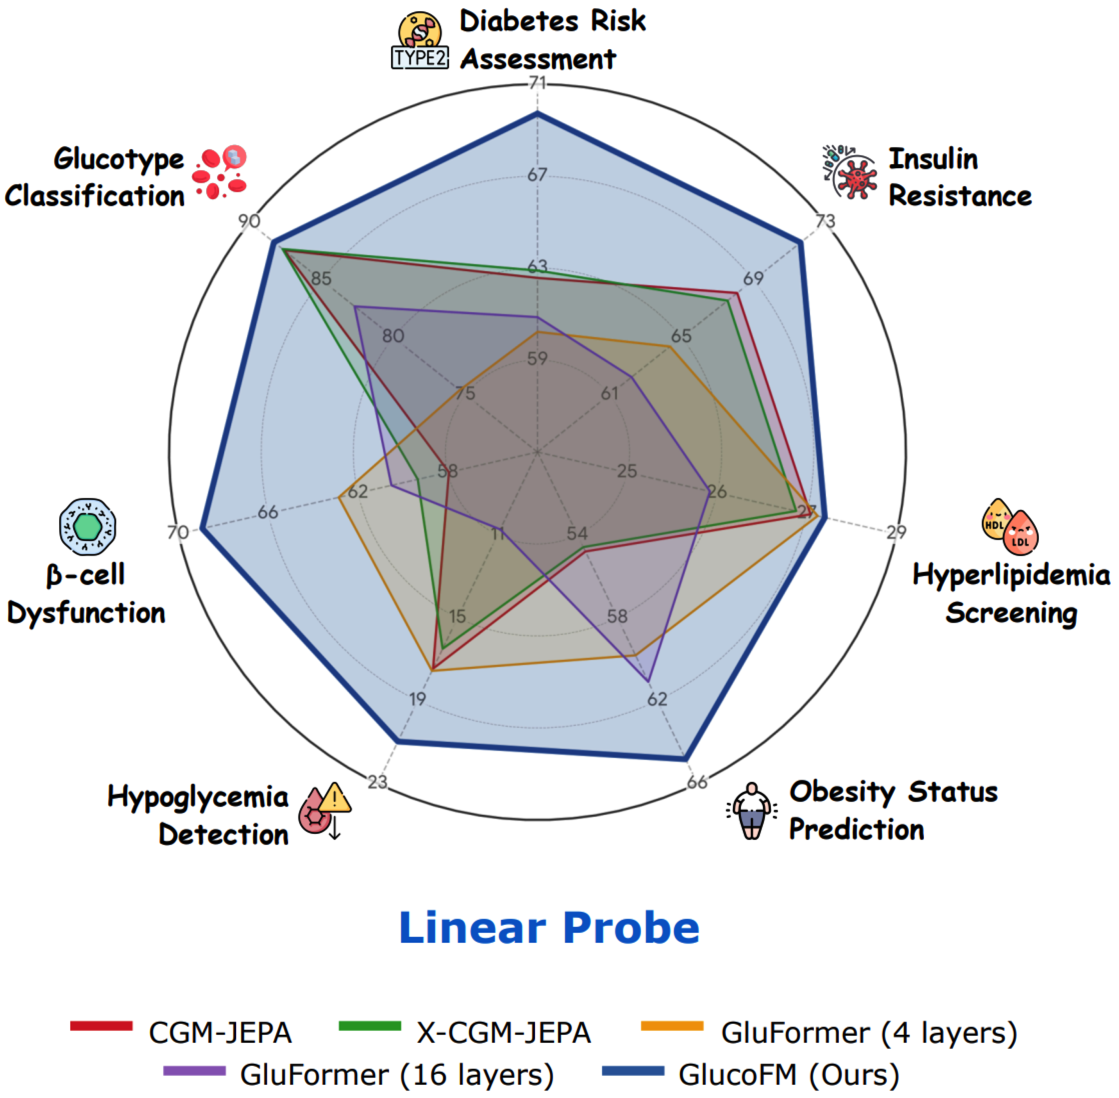
首先,我们采用受试者互不重叠的窗口级线性探测。我们冻结每个模型的编码器,在单个 24 小时表征上训练线性分类器,并确保没有任何受试者同时出现在训练折和测试折中。这检验的是,单日表征对于未见过的受试者是否包含表型信息,同时保留日间变异性。
在所评估的方法中,GlucoFM 取得了最高的任务平均 PR-AUC。在 14 项队列–任务评估中,它将平均 PR-AUC 从在相同数据上重新训练的最强 CGM 专用基线的 54.7 提高到 58.8,绝对提升 4.1 个点,相对该基线约提升 7.5%。GlucoFM 在所有糖尿病风险和 β 细胞功能障碍评估中,以及四项胰岛素抵抗评估中的三项里,都取得了最高的 PR-AUC。
预测餐后血糖反应
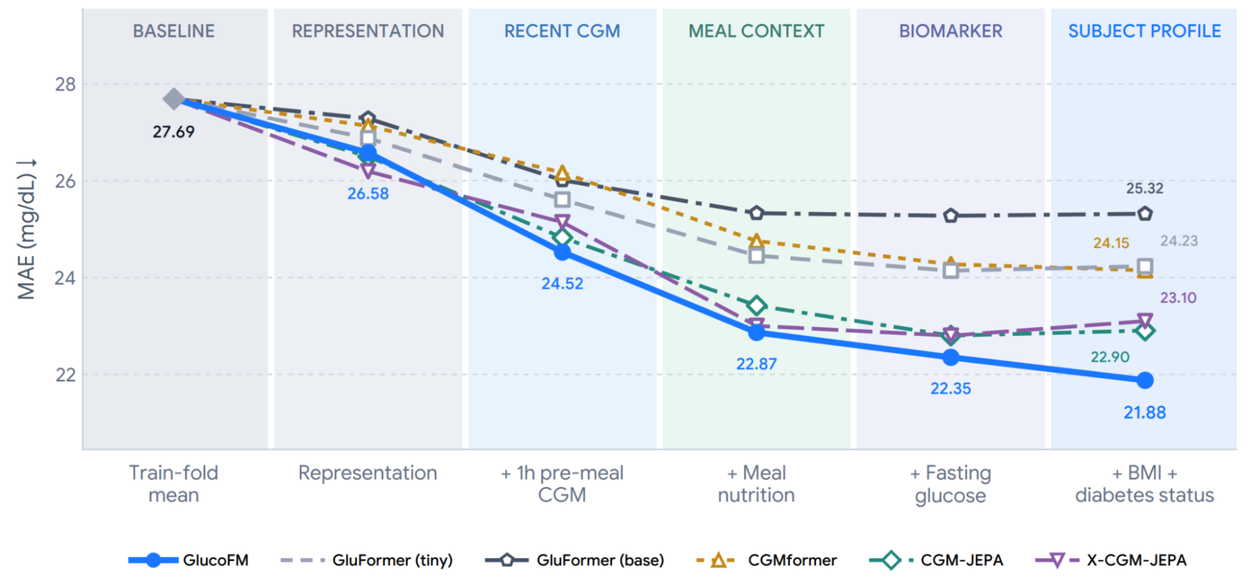
为了在动态预测任务上测试 GlucoFM,我们利用每次记录的进餐前可获得的信息,预测相对于进餐起始值的完整两小时血糖变化轨迹。我们使用受试者互不重叠的交叉验证,评估了来自 34 名受试者的 874 个成对进餐事件,Dexcom 和 Libre(两种 CGM 设备)在相同的划分下分别建模。
我们逐步将每个冻结的模型表征与以下信息组合:进餐前一小时的 CGM、进餐营养(包括能量、碳水化合物、脂肪、蛋白质和膳食纤维),以及空腹血糖、BMI 和糖尿病状态等受试者层面的信息。在完整上下文下,GlucoFM 在所评估的模型中取得了最低的平均 MAE:21.88 mg/dL,而最佳基线为 22.90 mg/dL,训练折均值基线为 27.69 mg/dL。这些结果表明,GlucoFM 为预测餐后血糖变化提供了互补的历史上下文。
超越单日的视角
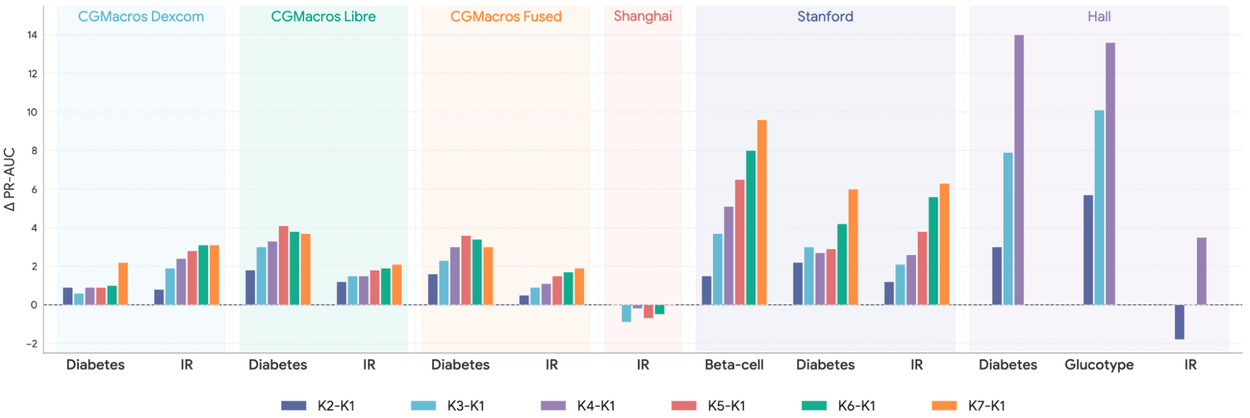
单个 24 小时曲线可能无法完整反映一个人的血糖模式,因此我们测试了合并多天数据能否改善受试者层面的预测。GlucoFM 对每一天分别编码,并对最多七天的表征取平均,每位受试者的贡献相等。
如下图所示,在大多数数据集的大多数设置中,增加天数都提升了 PR-AUC,包括 Stanford 的 β 细胞功能障碍提升 9.6 个点,以及 Hall 的糖尿病预测提升 14.0 个点。CGMacros 在 Dexcom、Libre 和融合传感器数据上同样大多呈正向提升。在简单平均下,ShanghaiT2DM 的胰岛素抵抗是主要例外,说明最佳聚合策略可能因任务而异。总体而言,GlucoFM 的冻结每日表征可以组合起来增强受试者层面的预测,而无需重新训练编码器。
跨越队列鸿沟
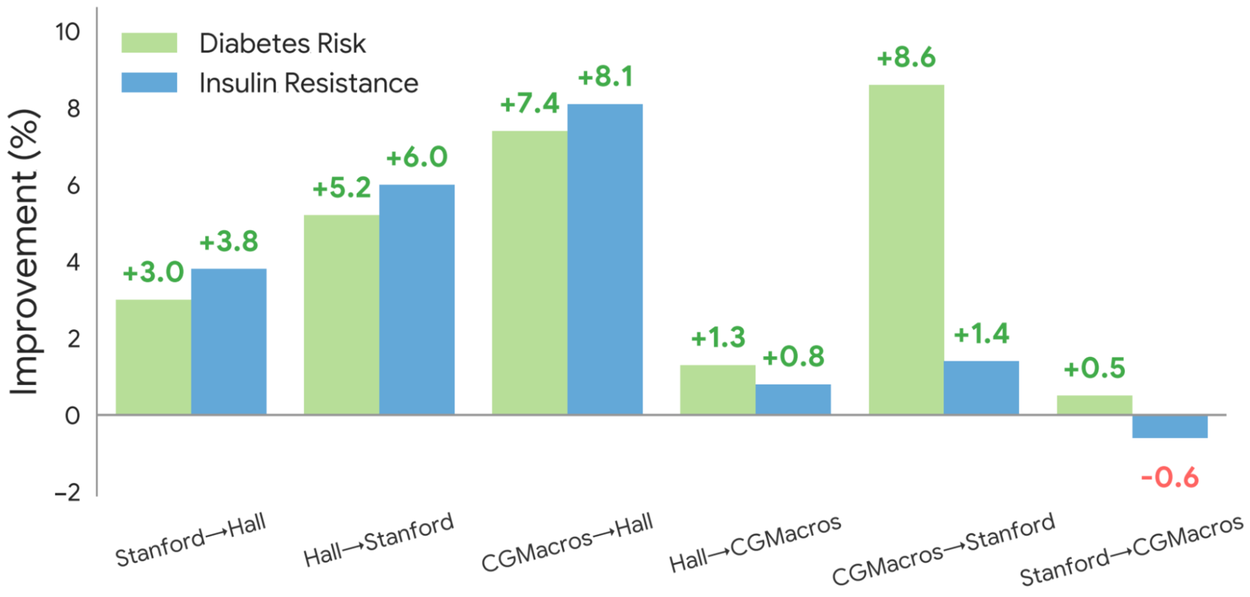
接下来,我们想知道模型学到的生理模式能否泛化。如果我们用某个临床队列的数据训练一个下游分类器来识别糖尿病风险,它在来自完全不同研究的患者身上还能奏效吗?跨数据集迁移的条形图展示了 GlucoFM 如何应对这一挑战,具体绘制了它在糖尿病风险和胰岛素抵抗两项任务上相对第二名模型的直接提升。
在下图中,正向的条形表示 GlucoFM 优于最强的竞争方法:它在 12 项评估中的 11 项领先,幅度为 0.5 至 8.6 个 PR-AUC 点,仅有一次落后 0.6 个点。其绝对 PR-AUC 范围从 Stanford 到 Hall 两项任务的 61.6%,到 Hall 到 CGMacros 胰岛素抵抗的 90.0%,这表明对潜在生理机制的关注,有助于冻结表征越过特定队列的噪声,找到普适的代谢模式。
用更少的数据学习
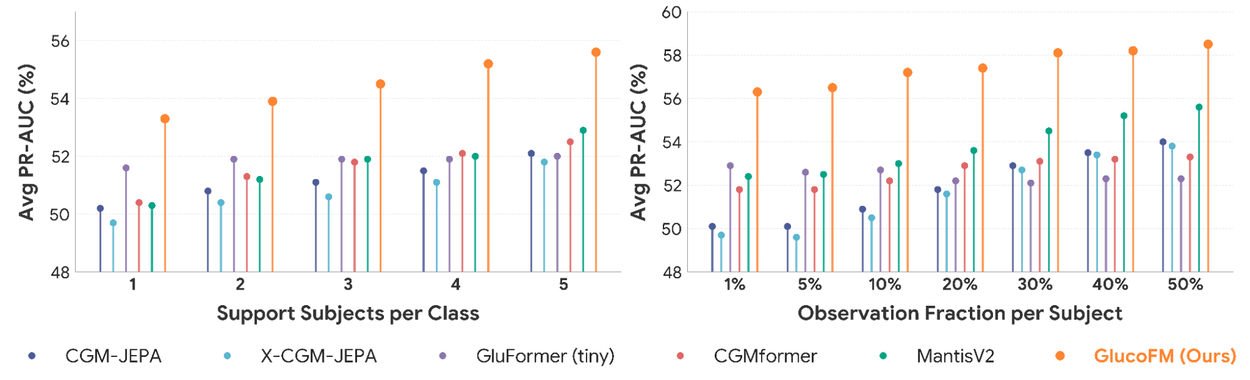
带标签的临床数据获取成本高昂,因此我们还在两种少样本设置下测试了 GlucoFM:左图改变每个类别的带标签受试者数量,右图则改变每位受试者可用观测的比例。向右移动表示增加带标签数据,点越高表示任务平均 PR-AUC 越好。
橙色的 GlucoFM 标记在每一种评估的数据预算下都是最高的,包括最受限的每类一个样本和 1% 观测的设置。当带标签受试者稀缺时,这一优势尤为明显,说明即使只有寥寥几个样例,模型也能高效地捕捉到正确的信号。
在两个时间尺度上建模血糖动态
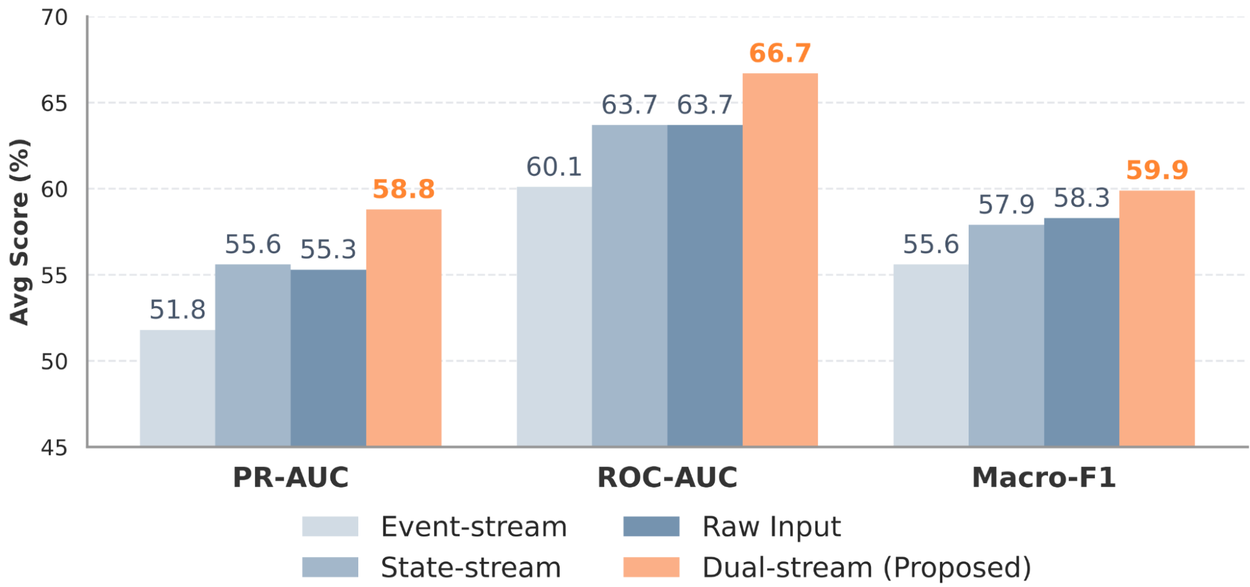
我们还仔细考察了把信号拆分为两条流是否真的带来了差别。我们将完整的双流设计与几种更简单的替代方案做了比较:一种直接处理原始血糖,一种旨在强调较慢的趋势,另一种旨在强调更快的短期偏离。
编码器设计分析显示,“仅事件”版本表现最弱,证明仅凭瞬时波动不足以形成稳定的代谢图景。“原始输入”和“仅状态”版本表现相当,但完整的双流模型始终名列前茅。这些结果支持先把较慢和较快的血糖动态组织为互补的流,再将它们组合,而不是只依赖其中任何一条流。
结论
我们的结果表明,CGM 模型可以从明确考虑血糖动态的多尺度结构中获益,这些结构包括较慢的趋势、短期偏离、一天中的时间以及传感器数据缺失。通过从无标签 CGM 中学习可复用的模式,GlucoFM 生成的表征在所评估的预测、迁移和少样本设置中都表现强劲,为更好地利用有限的带标签临床数据提供了一条途径。
不同的人、队列和传感器设备之间,代谢反应各不相同,而我们目前的预训练人群规模仍然有限。我们接下来的计划是在更大、更多样的人群上训练,并将 GlucoFM 从独立处理的 24 小时窗口扩展到原生的多天建模,以捕捉在数周或数月中展开的趋势,同时探索这些表征如何应对实时变化。关于代谢健康,仍有太多东西有待了解,我们很期待这些工具会把我们带向何方。
致谢
以下研究人员为这项工作做出了贡献:Zechen Li、Keerthana Natarajan、Weizhi Zhang、Simon A. Lee、Yuwei Zhang、Maxwell A Xu、Menglian Zhou、Zeinab Esmaeilpour、Flora D. Salim(来自新南威尔士大学)、Mark Malhotra、Lindsey Sunden、Shwetak Patel、Yuzhe Yang 和 Ahmed A. Metwally。
我们衷心感谢 Bobak J. Mortazavi 和 Ricardo Gutierrez-Osuna(Texas A&M University)提供本研究所用的 CGMacros 数据集。