摘要
推测解码在生产环境中会“过时”:草稿模型可能发生漂移,而离线重训练又未必跟得上。
Aurora 解决了这个问题。它是一个基于强化学习(RL)的开源框架,直接从线上推理轨迹中学习,并在不中断服务的情况下持续更新推测器(speculator)。
关键结果:
→ 在流量领域不断变化时实现实时自适应
→ 相比训练良好的静态推测器,额外获得 1.25 倍加速
最核心的发现:从零开始的在线训练,可以超过精心预训练的静态基线。
在生产环境中运行大语言模型,始终是在性能与成本之间权衡。推测解码是标准的调节手段:原则上,它能加速推理。但在实践中,它往往达不到预期:草稿模型会过时,接受率会漂移,而离线重训练太慢、太贵,无法跟上线上流量。如果你的系统能够利用自己正在处理的请求,随时持续学习,会怎样?
去年,我们推出了 ATLAS,这是我们迈向自适应推测器的第一步。那项工作奠定了基础,但我们的目标始终是一个完全自主的系统,让服务与训练形成闭环。
今天,我们发布 Aurora,一个基于 RL 的开源框架,它从线上推理轨迹中学习,并异步更新推测器,把推测解码从静态的一次性配置,变成一个动态的、自我改进的飞轮。这种统一的设计解锁了标准流水线中难以实现的能力,包括:(1)直接缓解分布不匹配问题,相比强大的离线基线提升 1.25 倍;(2)通过省去大规模激活值收集流水线来降低基础设施成本;(3)与算法无关的框架,兼容未来的推测器设计;(4)支持多样且异构的用户需求。
在各项实验中,Aurora 在常用模型(如 Qwen3 和 Llama3)上,相比训练良好但静态的推测器,额外实现了 1.25 倍加速。
复现论文结果的代码已开源,欢迎社区贡献。
不同批大小下的端到端吞吐量
MiniMax M2.5(FP8,lookahead 5):
| BS | 配置 | OTPS 均值 | OTPS P50 | OTPS P05 | OTPS P95 | 加速比 | 接受长度 |
|---|---|---|---|---|---|---|---|
| 1 | 无推测解码 | 147.06 | 146.45 | 140.46 | 154.72 | -- | -- |
| 有推测解码 | 240.39 | 226.57 | 186.98 | 325.36 | 1.63× | 2.41 | |
| 8 | 无推测解码 | 109.41 | 106.49 | 99.56 | 126.57 | -- | -- |
| 有推测解码 | 160.95 | 157.42 | 123.72 | 207.04 | 1.47× | 2.40 | |
| 16 | 无推测解码 | 93.12 | 89.56 | 82.64 | 113.29 | -- | -- |
| 有推测解码 | 134.70 | 129.95 | 100.97 | 179.02 | 1.45× | 2.40 | |
| 32 | 无推测解码 | 80.44 | 77.57 | 71.77 | 96.84 | -- | -- |
| 有推测解码 | 120.67 | 115.04 | 92.49 | 162.77 | 1.50× | 2.45 |
OTPS = 每秒输出 token 数(output tokens-per-second)。测试数据集(198 个样本)。
Qwen3-Coder-Next-FP8(lookahead 5):
| BS | 配置 | OTPS 均值 | OTPS P50 | OTPS P05 | OTPS P95 | 加速比 | 接受长度 |
|---|---|---|---|---|---|---|---|
| 1 | 无推测解码 | 195.21 | 195.23 | 194.75 | 195.75 | -- | -- |
| 有推测解码 | 375.49 | 350.37 | 251.92 | 574.03 | 1.92× | 3.05 | |
| 8 | 无推测解码 | 160.08 | 157.69 | 155.81 | 175.40 | -- | -- |
| 有推测解码 | 279.09 | 250.65 | 188.27 | 414.05 | 1.74× | 3.10 | |
| 16 | 无推测解码 | 138.70 | 137.92 | 130.05 | 150.44 | -- | -- |
| 有推测解码 | 221.56 | 202.96 | 143.80 | 323.54 | 1.60× | 2.96 | |
| 32 | 无推测解码 | 117.50 | 114.36 | 108.95 | 130.10 | -- | -- |
| 有推测解码 | 184.23 | 166.56 | 124.03 | 278.96 | 1.57× | 3.00 |
OTPS = 每秒输出 token 数(output tokens-per-second)。测试数据集(198 个样本)。
1. 为什么标准的“先训练后部署”流水线会失效
离线推测训练在组织上很方便,但在生产中会带来若干实际问题,限制其效果。传统流水线是一条单行道,导致模型过时,并与真实世界的性能脱节。
传统的推测解码遵循线性、静态的流程,会随时间退化。Aurora 引入了循环的、持续自适应的方法。
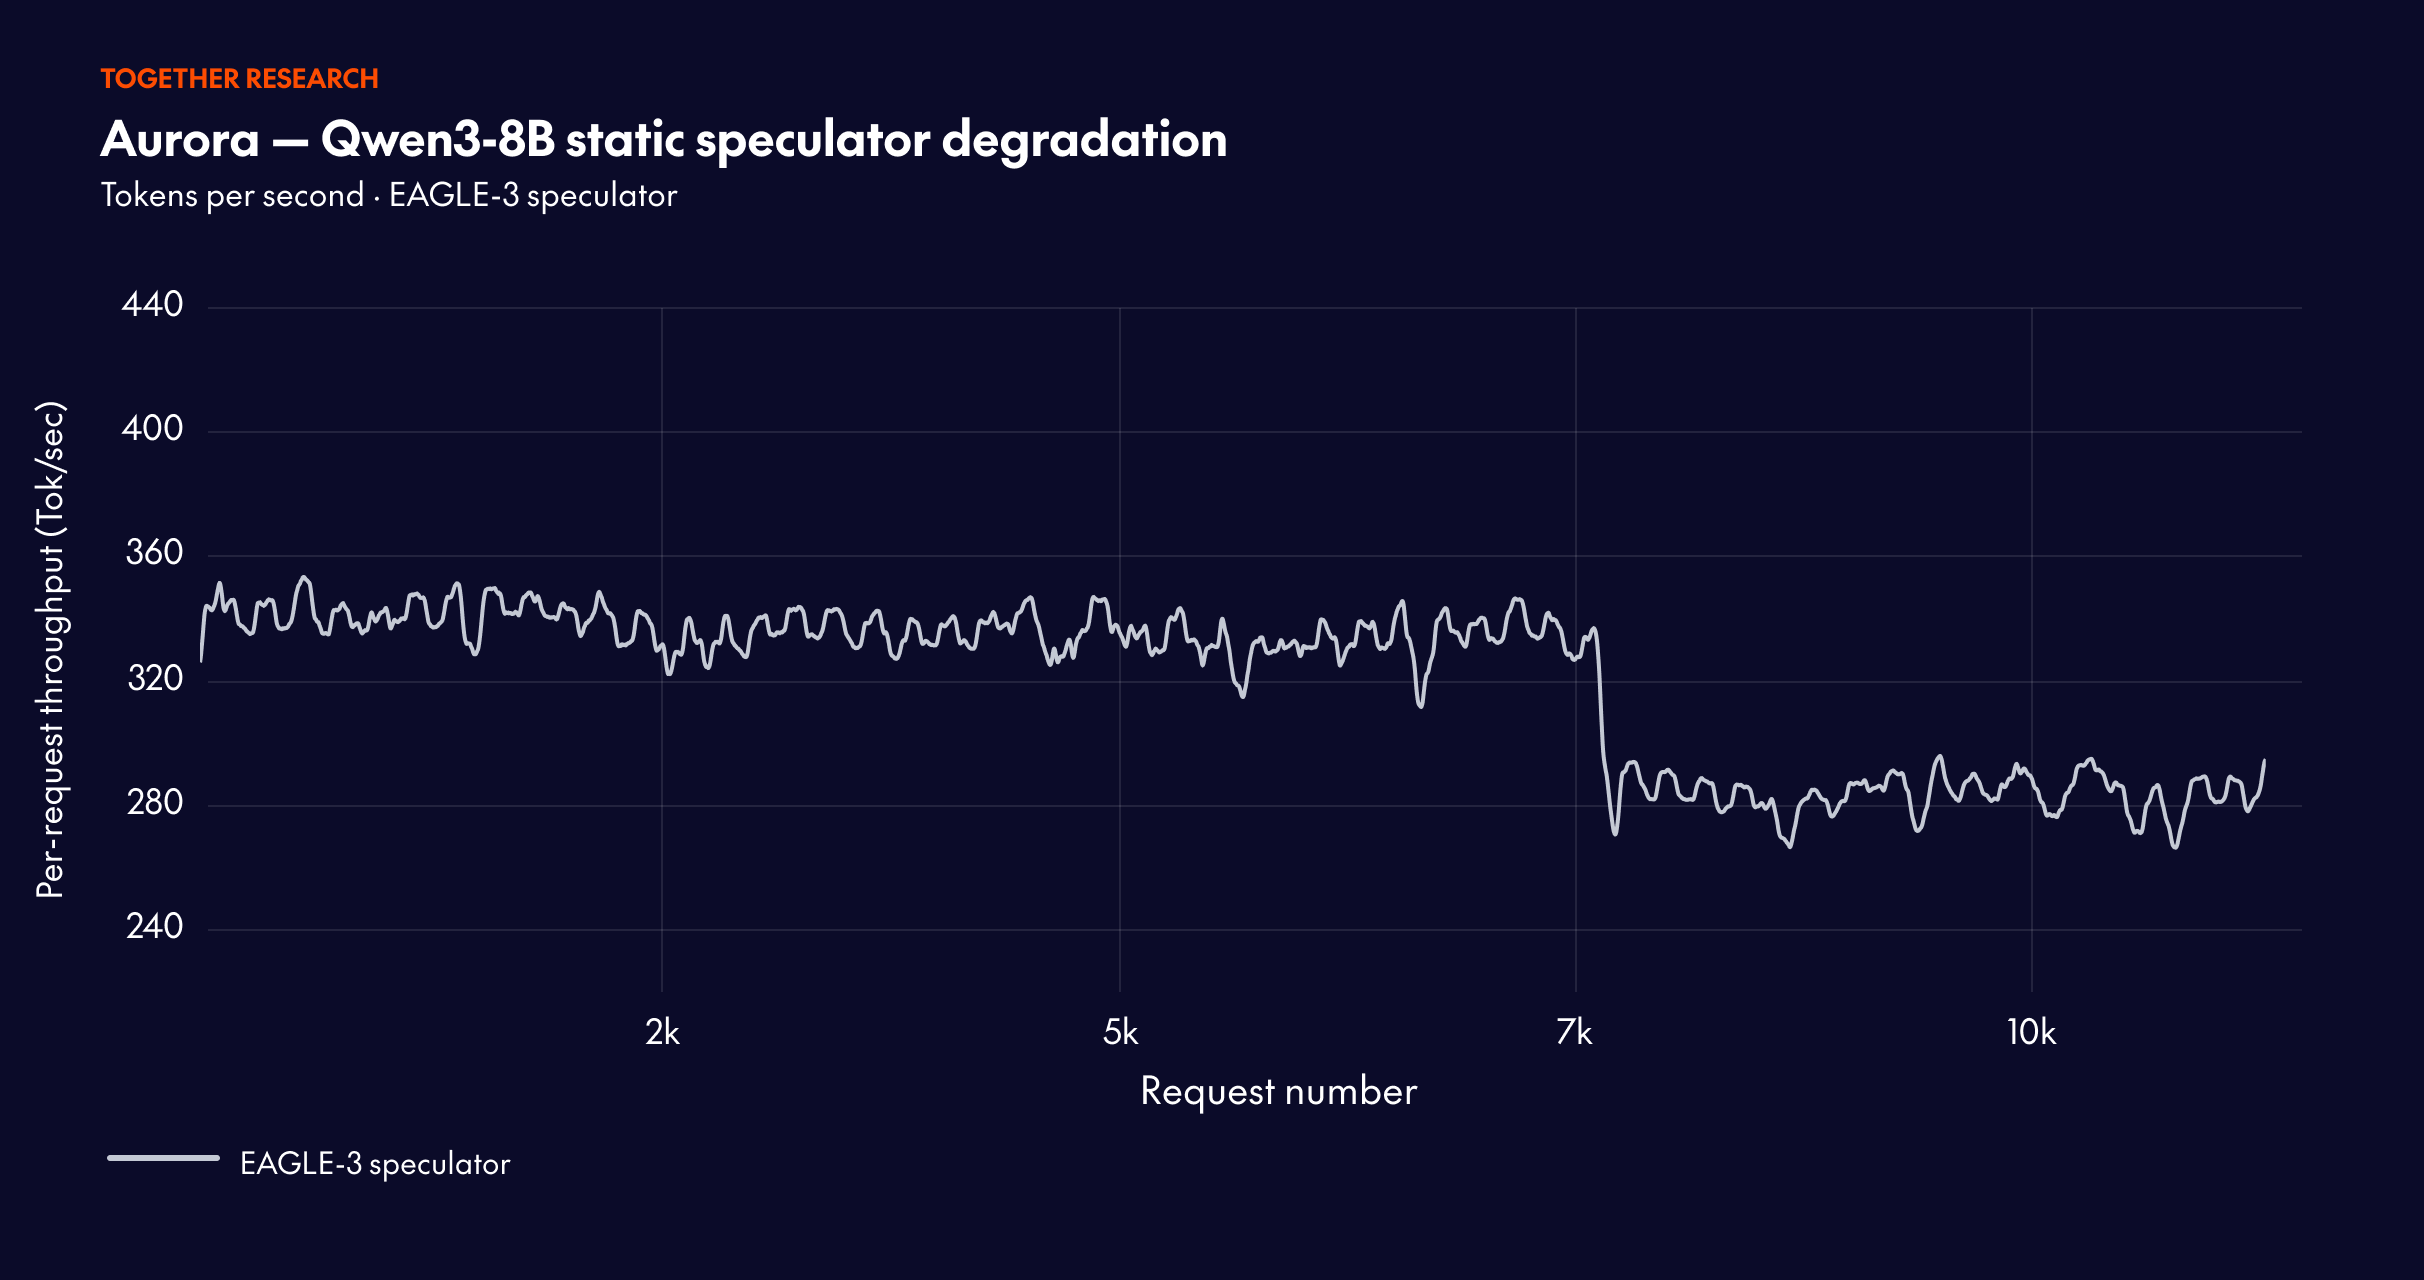
验证器在变,草稿器却滞后。生产中的目标模型会因质量、安全、成本或硬件迁移而变化。推测器的更新往往慢得多,于是变得过时,推测解码的性能随时间下降。
离线蒸馏流水线代价高昂。用于草稿器训练的激活值收集与回放流水线,在大规模下存储和运维的成本可能极高。在生产规模下,存储占用可达 PB 级,带来高昂的内存、带宽和运维复杂度成本。Aurora 直接从线上服务轨迹中学习,从而减轻了这一负担。
接受率不等于真实加速。离线训练可以在实验室环境里优化接受率,但生产中的加速取决于实际的服务栈:内核、数值精度(FP8/FP4)、批处理、调度和硬件行为。离线最好的草稿模型,未必是线上最好的。实践中,大多数团队会训练多个草稿器,却最终只选其中一个。Aurora 因为在线运行,可以直接比较加速效果。
这些差距表明,不应仅仅把推测解码当作建模问题(“训练一个更好的草稿器”),而应视为学习与服务联合的问题。
2. 核心思想:由 RL 驱动的“服务到训练”飞轮
Aurora 把推测解码变成一个“服务到训练”(serve-to-train)的飞轮。它不再把推测器当作静态产物,而是从自己处理的每一个请求中持续学习。

该系统围绕两个解耦的组件构建。推理服务器(Inference Server)运行推测解码引擎(基于 SGLang 或 vLLM),配有目标模型和草稿模型。对每个请求,草稿模型提出一串 token,再由目标模型并行验证。被接受和被拒绝的 token 的结果,连同用于 EAGLE 式训练的隐藏状态,会以流的方式送入分布式数据缓冲区。训练服务器(Training Server)异步运行:它从缓冲区取出训练数据批次,在草稿模型的副本上执行梯度更新,并定期把改进后的权重热切换回推理服务器,而不中断服务。
这一设计围绕两个生产现实展开。第一,服务效率才是真正的目标,即在 SLO 约束下的延迟、吞吐量和每 token 成本。第二,同步必须是惰性且无干扰的,频繁推送权重可能导致缓存失效和延迟抖动。为了让这一设计可靠运行,我们把在线推测训练重新表述为一个异步强化学习(RL)问题。
这不只是理论上的便利,它直接使训练信号与真实部署中的效用对齐,而不仅仅是离线模仿质量。推测解码天然可以映射到强化学习:
| 推测解码 | RL 对应 | |
|---|---|---|
| 草稿模型 | → | 策略(π) |
| 目标验证器 | → | 环境 |
| 被接受的 token | → | 正向奖励 |
| 被拒绝的提议 | → | 负向 / 反事实反馈 |
在这一框架下,最大化回报直接对应于最大化接受长度,而接受长度又直接对应于解码加速。Aurora 一个微妙而有力的地方在于,它不只从被接受的 token 中学习。接受损失(模仿)对被接受的 token 使用交叉熵,鼓励草稿模型复现经验证器认可的后续内容。拒绝损失(Discard Sampling)则利用被拒绝的分支作为反事实监督,教草稿模型什么不该提议。
为了高效处理推测解码结果中复杂的分支结构,我们采用了专门的树注意力(Tree Attention)机制。通过构造符合推测树因果结构的自定义注意力掩码,我们可以在一次批量前向和反向传播中处理所有被接受和被拒绝的分支。
3. 对分布偏移的适应
为了测试 Aurora 的鲁棒性,我们用 40,000 条提示组成的流来模拟线上服务流量,涵盖五个领域:数学推理、text-to-SQL、代码生成、金融和通用对话。这一构成反映了真实的部署场景,即服务流量呈现异构且不断变化的任务分布。我们评估了两种流量模式:(i)有序流,请求按领域分组,以引发突然的分布偏移;(ii)混合流,提示被随机打乱,以近似平稳流量。
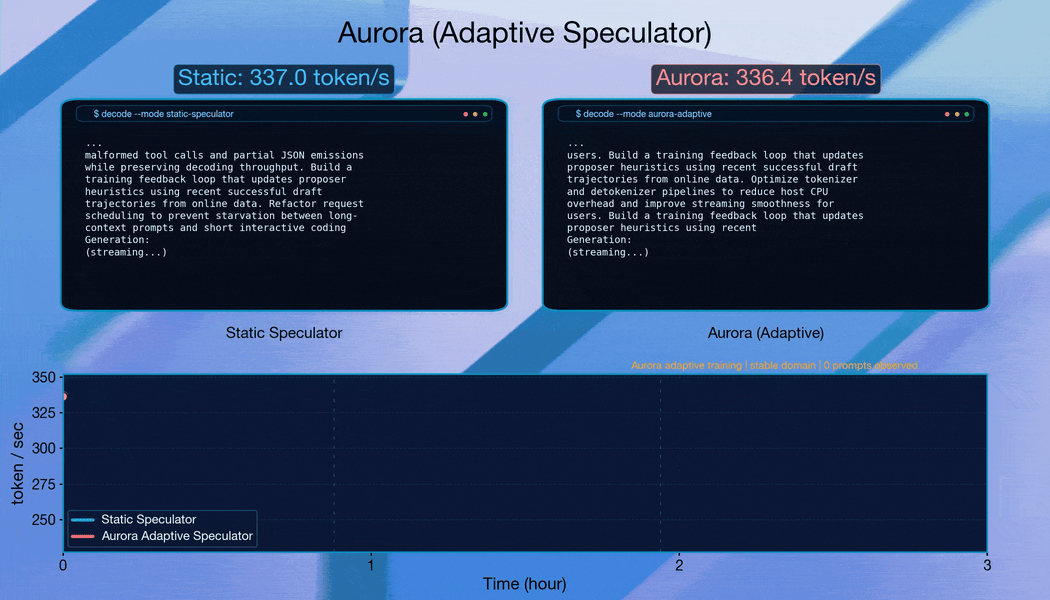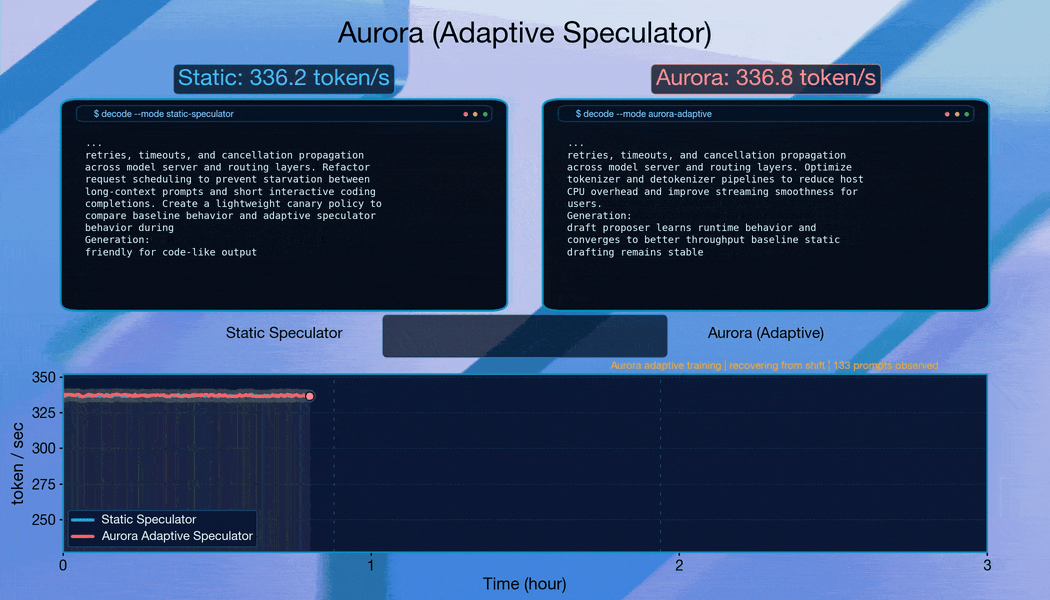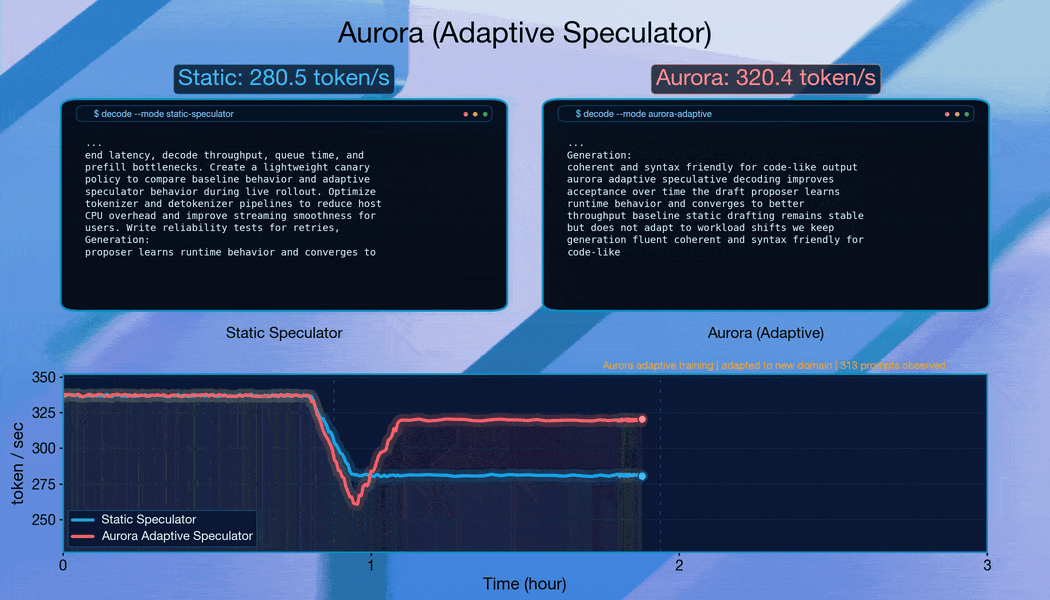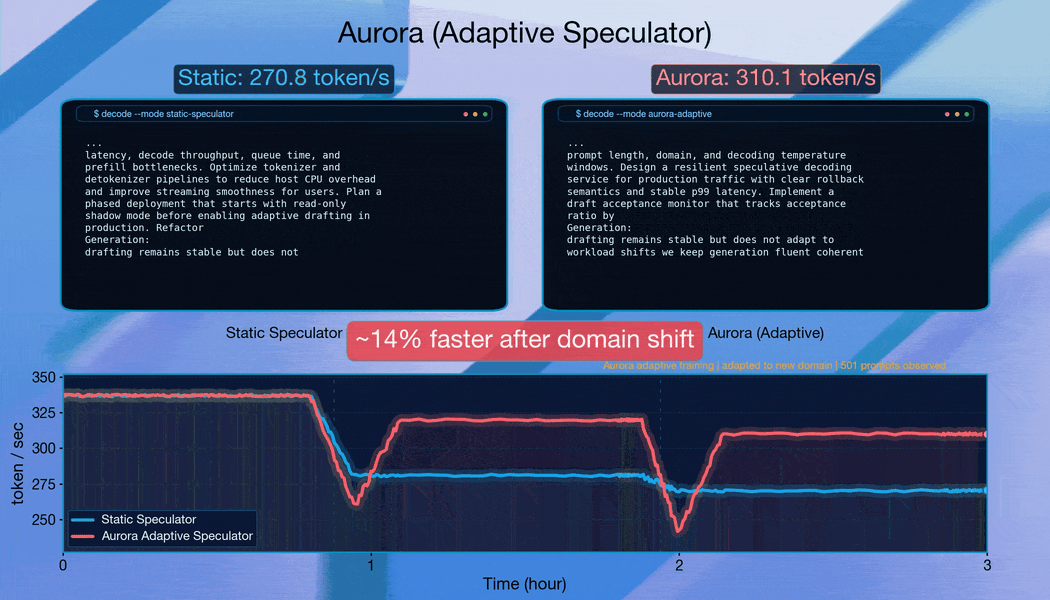
当请求按领域分组以引发突然的分布变化时,Aurora 能持续自适应。每次偏移后,系统大约在 10,000 个请求内恢复接受长度,展现出稳健的在线适应能力。
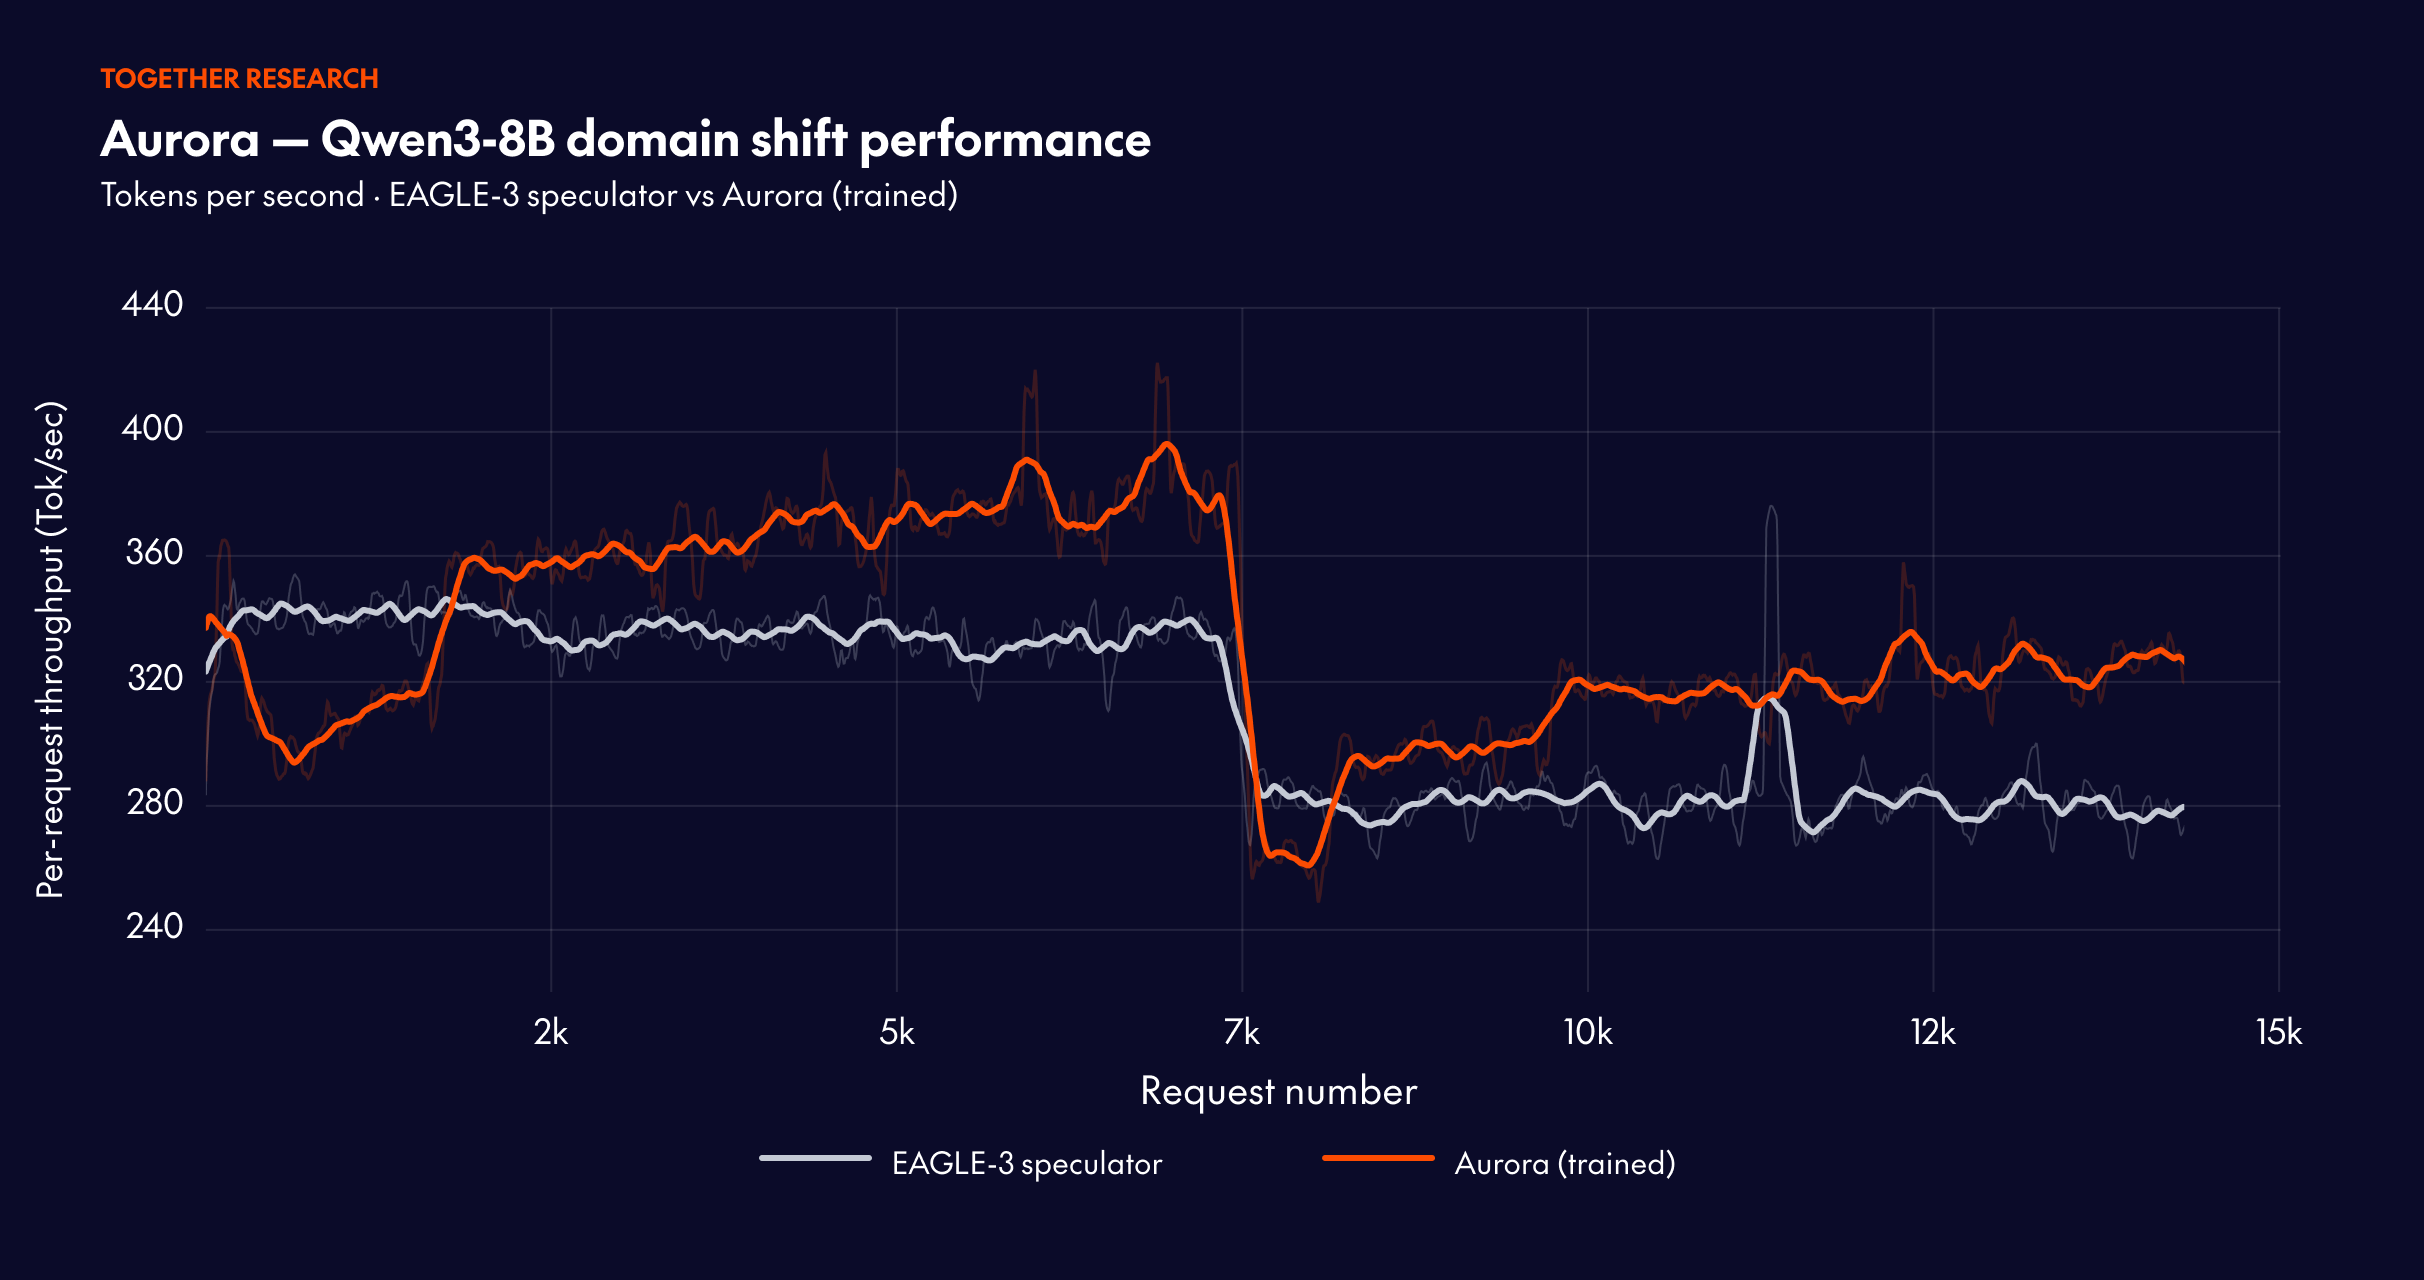
从一个训练良好的推测器出发,Aurora 通过持续适应,相比静态基线额外实现了 1.25 倍加速。这表明 Aurora 的收益可以叠加在现有的离线训练投入之上。
混合流量的结果尤为惊人:从零开始的在线训练,可以超过精心预训练的推测器。接受长度达到 3.08(超过静态基线的 2.63,以及先预训练再微调基线的 2.99),吞吐量稳定在 302.3 tokens/s。这从根本上挑战了推测解码需要大量离线预训练的传统观念。
4. 结论
Aurora 不只是又一种推测解码算法,而是一次系统层面的转变。它把推测解码从静态的离线任务,变成动态的在线学习过程。
这一转变带来了实时的效用反馈、领域漂移下的自适应、相比大型离线蒸馏流水线更低的基础设施成本,以及一个兼容未来推测器算法的系统层。因此,推测解码的正确抽象不再只是孤立地训练更好的草稿模型,而是一个统一的训练—服务闭环。