阿里巴巴发布了 Qwen3.8-Flash-Next 的模型权重,作为即将到来的 Qwen4 架构的预览,供开发者试验和评估。这是一个多模态混合专家(MoE)模型,主模型有 125B 参数,另有 51B 的 N-gram 嵌入作为补充,每个 token 激活 6B 参数。它原生支持 262,144 token 的上下文窗口,借助 YaRN 可扩展到 1M token。
NVIDIA 通过 SGLang、vLLM 和 NVIDIA TensorRT LLM 提供尽力而为的首日功能支持,在 NVIDIA GB300 NVL72 上完成了推理验证,并通过 NVIDIA NeMo AutoModel 和 NVIDIA NeMo RL 提供后训练方案。
面向长上下文推理的架构创新
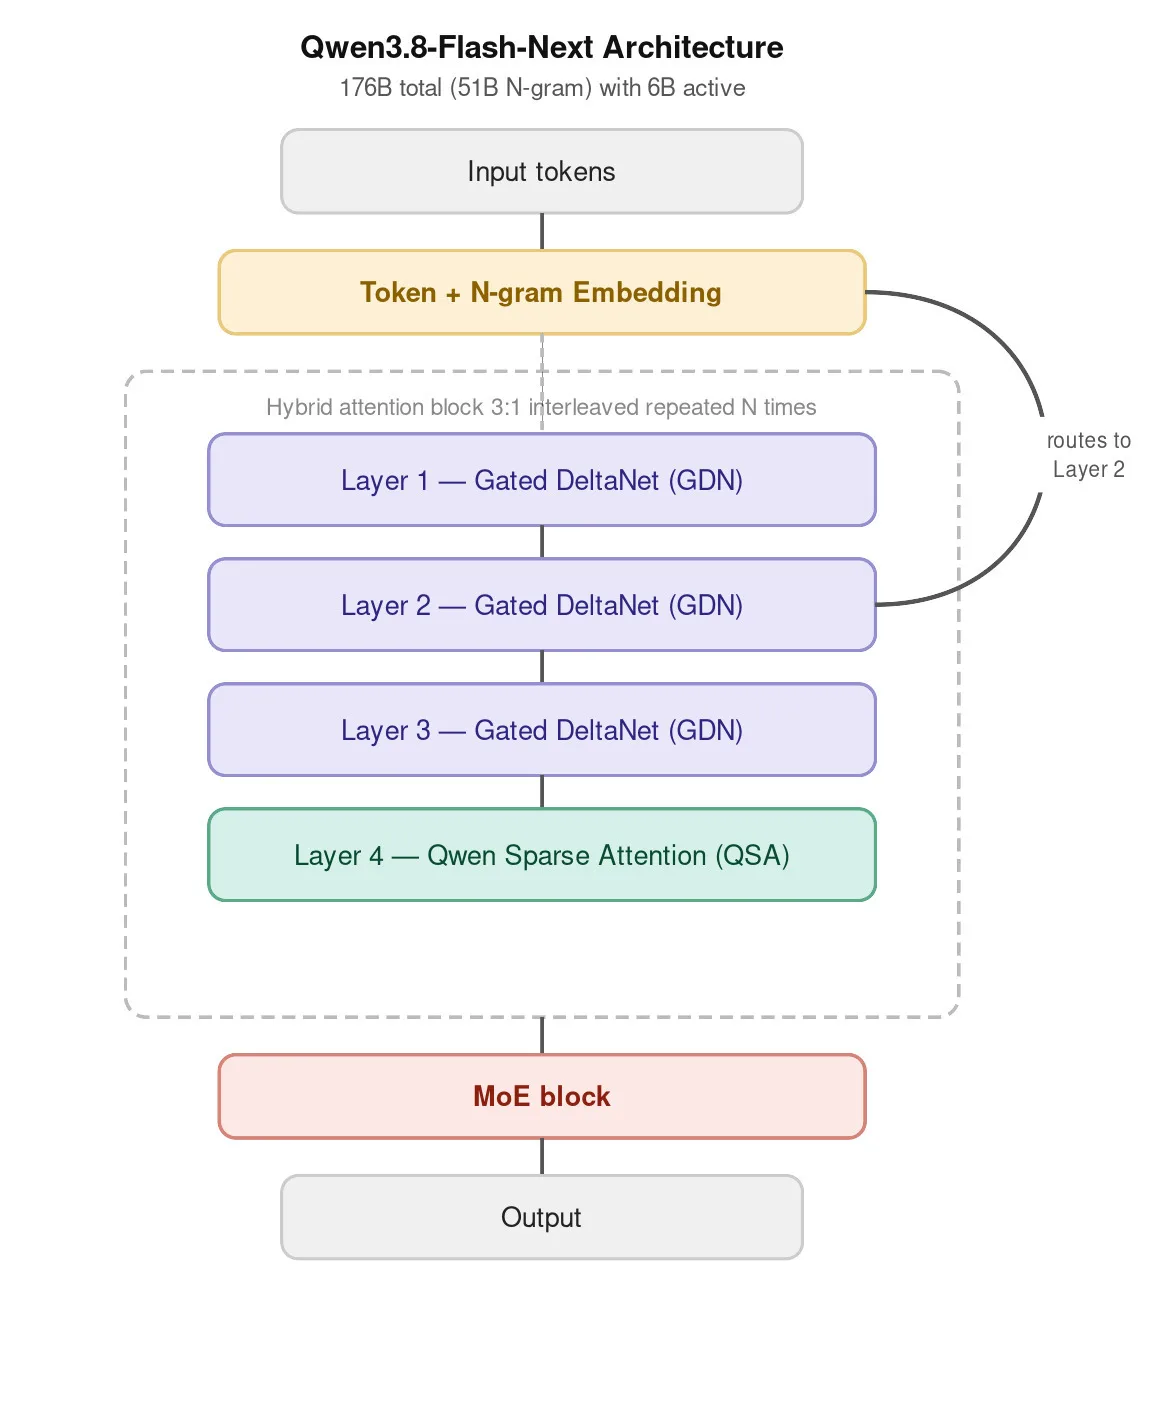
Qwen3.8-Flash-Next 面向高并发、上下文密集的应用而设计,例如智能体编码、文档处理和工具驱动的工作流。随着上下文增长,注意力计算和 KV 缓存内存会成为瓶颈。该模型采用结合 Gated DeltaNet(GDN)和 Qwen Sparse Attention(QSA)的混合架构来应对这两个问题。每四层中有三层使用 GDN,把历史上下文持续压缩进固定大小的循环状态,使 KV 缓存不再随序列变长而增长。其余一层使用 QSA,在完整上下文中进行精确检索。
以往的稀疏注意力方法依赖 token 级索引器,随着上下文长度增加,其计算开销越来越大。QSA 则把序列聚合成微块(micro-block),在块级别估计其重要性,只选取最相关的区域。这削减了每一层内的注意力、计算和索引开销,使该设计非常适合 GDN 层与 QSA 层交替的架构。
阿里巴巴公布的基准测试表明,QSA 可以提高 1M token 工作负载的效率。与完整注意力相比,其注意力内核在预填充阶段最高提速 7.6 倍,在解码阶段最高提速 4.9 倍。在 1M token 上下文长度、前缀缓存命中率为 90% 的缓存密集型在线服务测试中,Qwen3.8-Flash-Next 的预填充吞吐量达到 Qwen3.7-Plus 的 8.6 倍。
▶ https://developer.download.nvidia.com/video/devblog/Qwen3.8.mp4
视频 1. Qwen3.8-Flash-Next 诊断并修复一个 bug
在 NVIDIA GB300 NVL72 上运行 Qwen3.8-Flash-Next
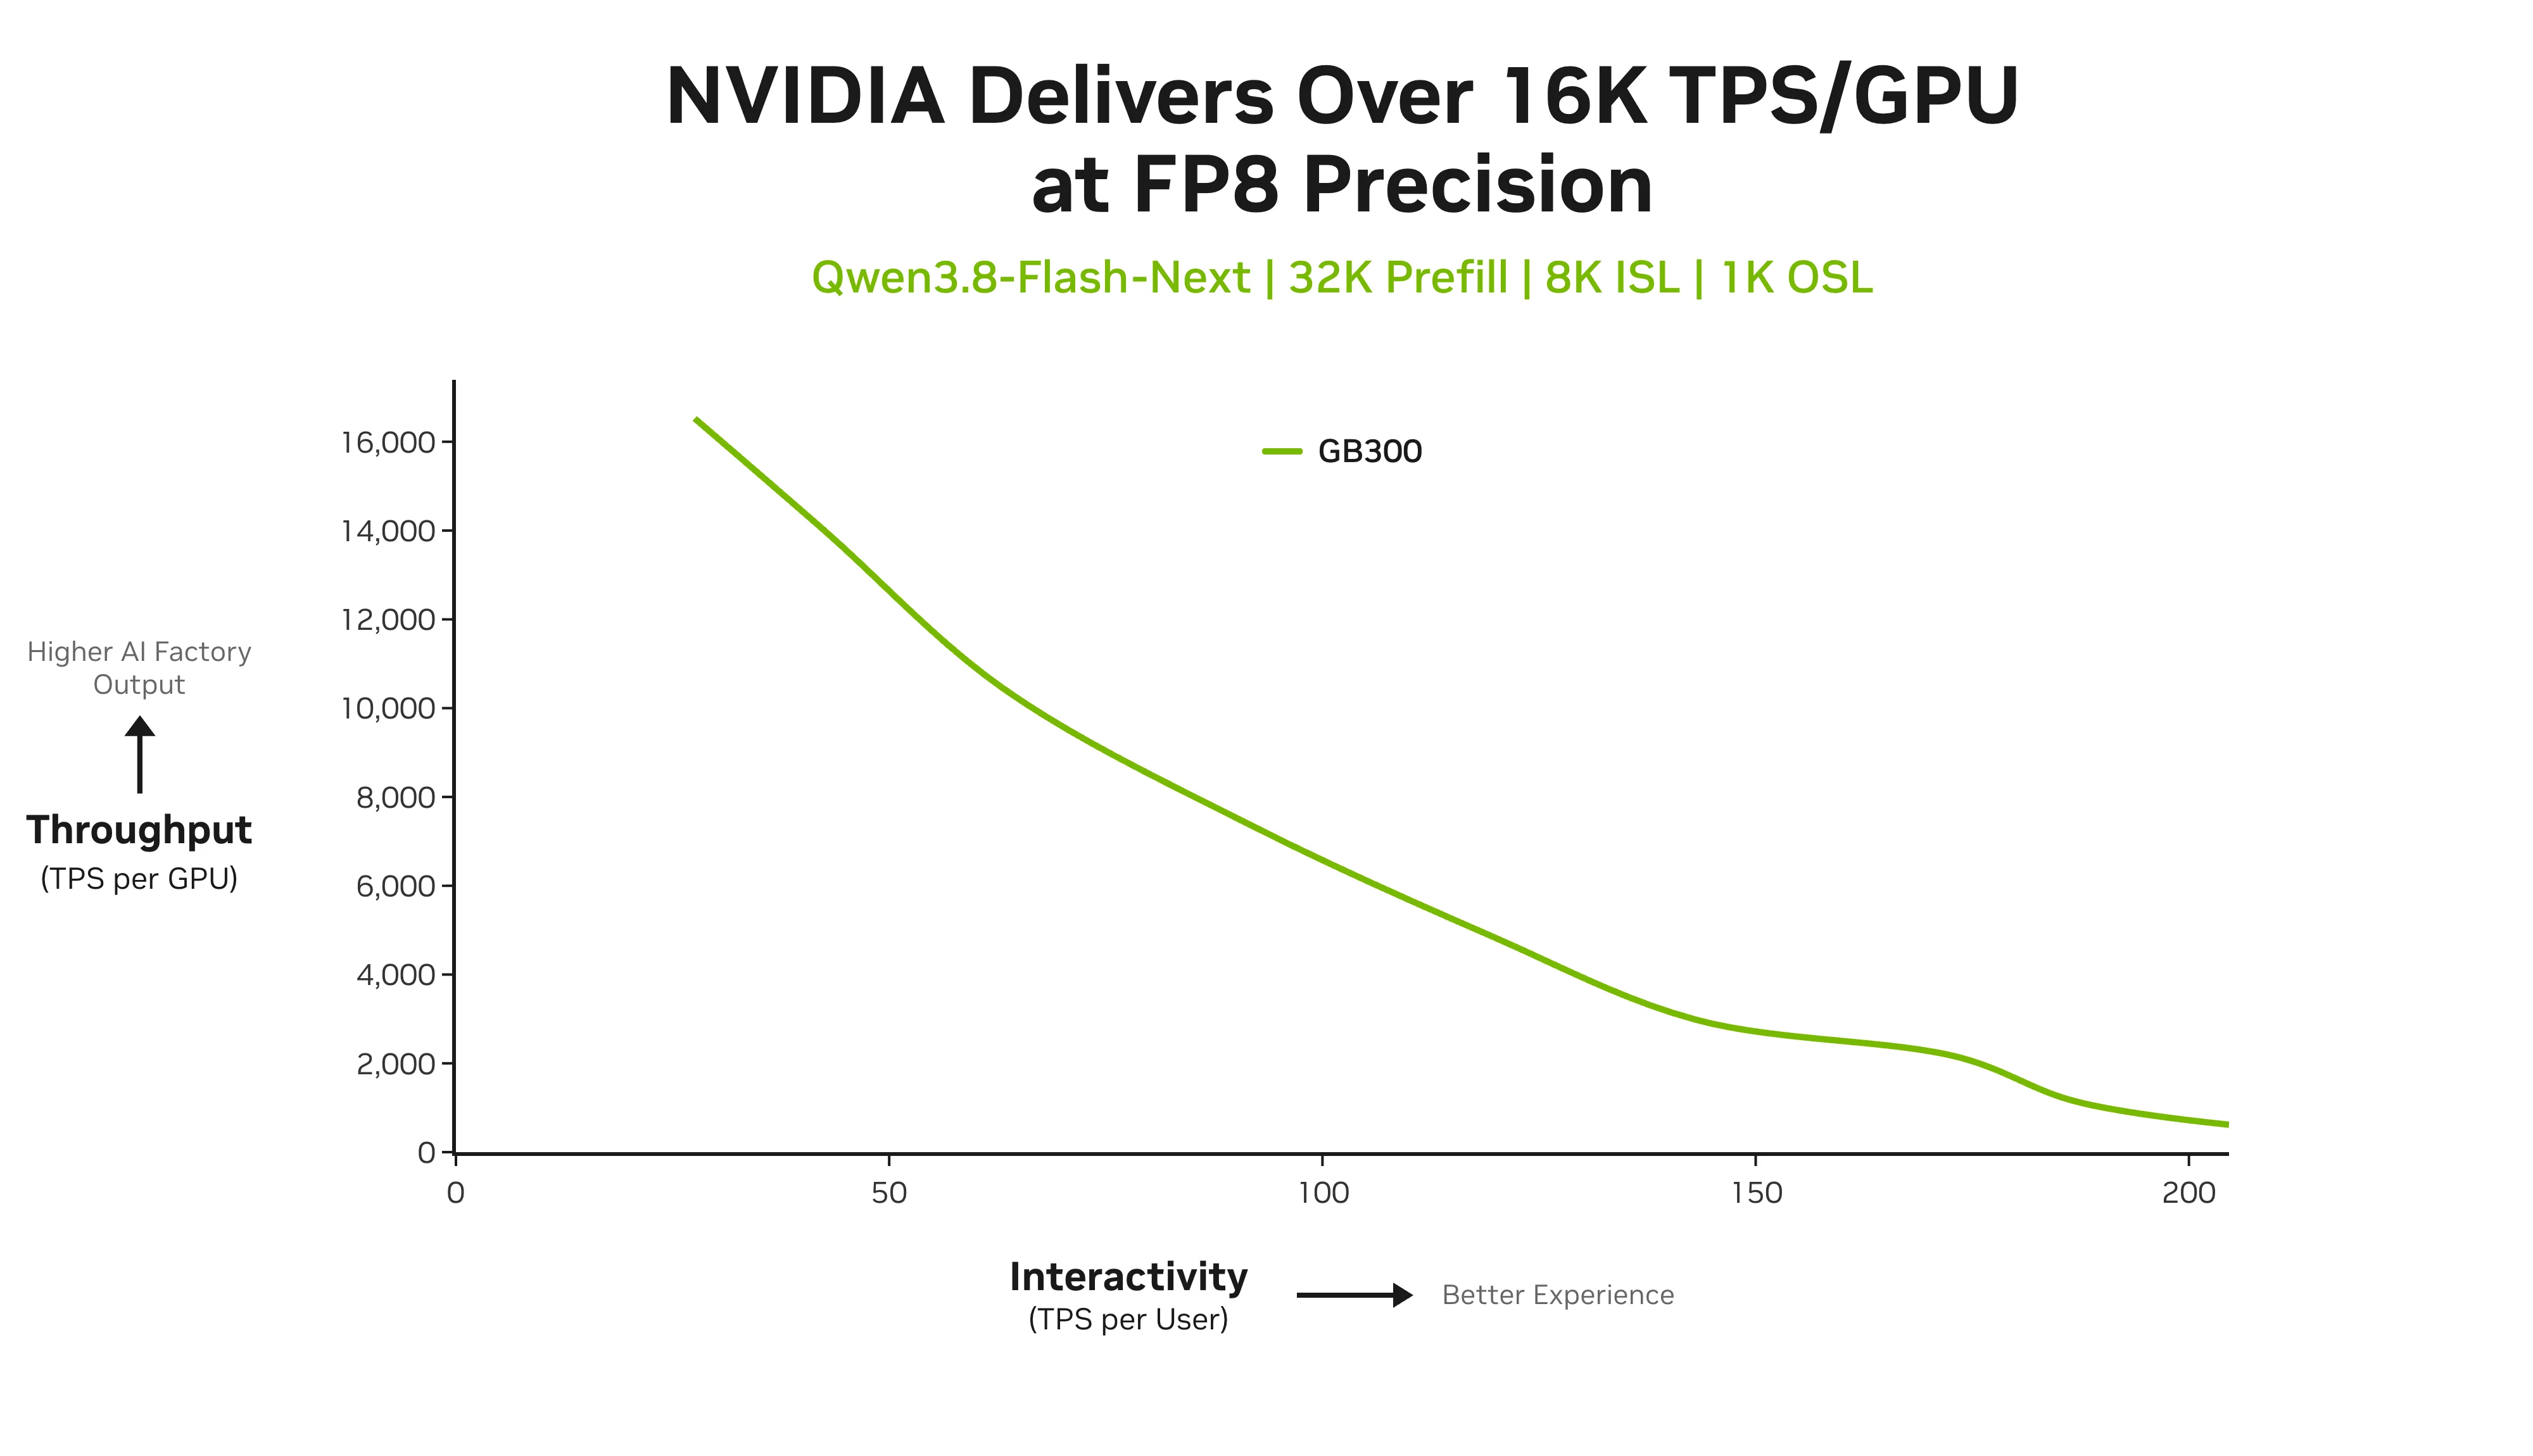
GB300 NVL72 采用机架级架构,将 72 块 NVIDIA Blackwell Ultra GPU 集成为单一平台。其由 72 块 GPU 组成的大型 NVIDIA NVLink 域支持 130 TB/s 的高效全互联通信,消除了专家流量必须穿越传统通用网络时出现的瓶颈。在 NVIDIA GB300 NVL72 上运行,每块 GPU 每秒可处理超过 16K 个 token,每位用户每秒超过 200 个 token,让开发者能够以高吞吐、低延迟试验智能体编码应用。
除了机架级部署,Qwen3.8-Flash-Next 也可以在本地 NVIDIA 硬件上运行,包括 NVIDIA DGX Station、NVIDIA DGX Spark 集群,以及配备四块 NVIDIA RTX PRO 6000 Blackwell Max-Q Workstation Edition GPU 的工作站。开发者可以在本地硬件上对智能体编码工作流进行原型开发和评估,再把同一个模型扩展到 GB300 NVL72 上进行生产服务。
对 Qwen3.8-Flash-Next 进行后训练,并用你偏好的推理引擎提供服务
开发者可以使用 NVIDIA NeMo AutoModel 针对特定领域的用例对模型进行微调,这是一个 PyTorch 原生的微调库,首日即支持 Hugging Face 检查点。无需模型转换,即可直接在现有检查点上训练,支持完整的 SFT 或节省内存的 LoRA 微调。用户还可以更进一步,使用 NVIDIA NeMo RL 方案进行强化学习。
NVIDIA 支持多种推理栈,以满足开发者的各种需求。SGLang、vLLM 和 TokenSpeed 为需要在 NVIDIA 加速平台上对性能有更多控制的开发者提供开源推理方案。
开始使用 Qwen3.8-Flash-Next
直接在 QwenCloud 上试用该模型。
从 Hugging Face 或 ModelScope 下载模型权重,并使用 NVIDIA NGC 上的无需模型的 NVIDIA NIM 进行部署。