发布季从昨天延续至今,今天传闻中的 Gemini 3.8 Flash 也登场了,但 扎克伯格上个月那封高调回归信中承诺的 Muse Spark 1.3 无疑才是今天的头条。据 AAII,它现在是全球排名第 3 的模型(!?!)
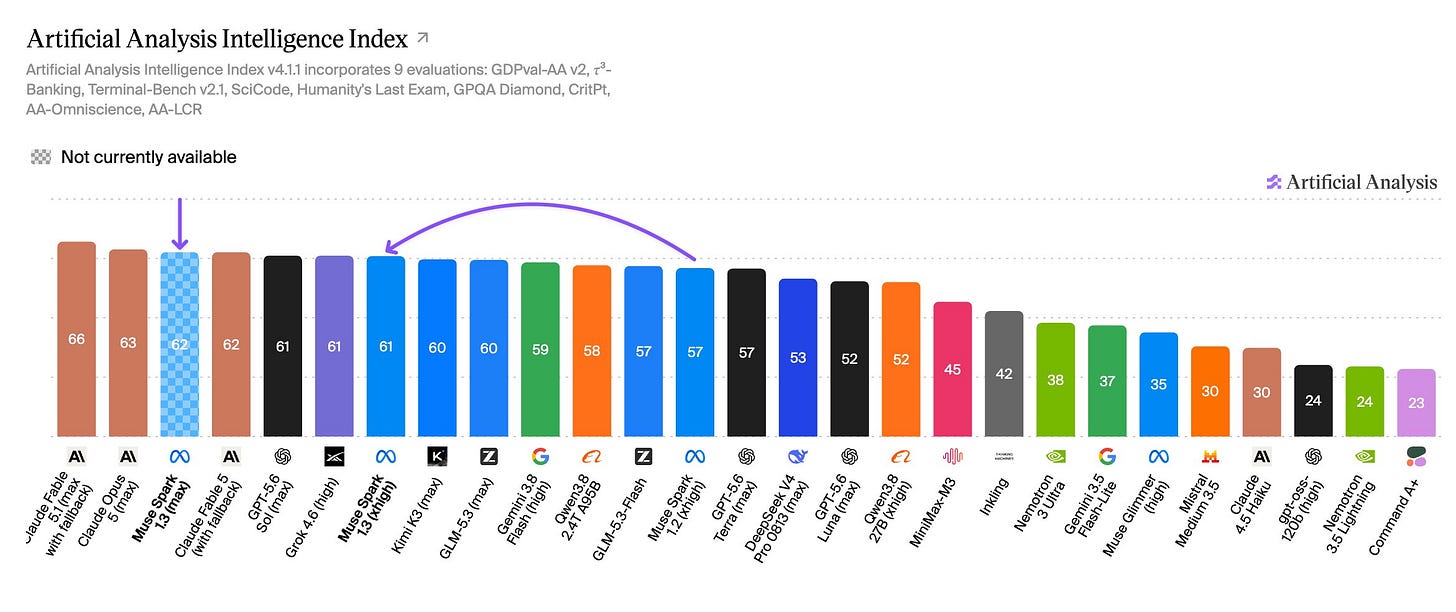
看看这份自信,终于拿出了可与 OpenAI 和 Anthropic 前沿模型(是 Opus,不是 Fable)相当的成绩……还承诺它将开放权重(!!!):
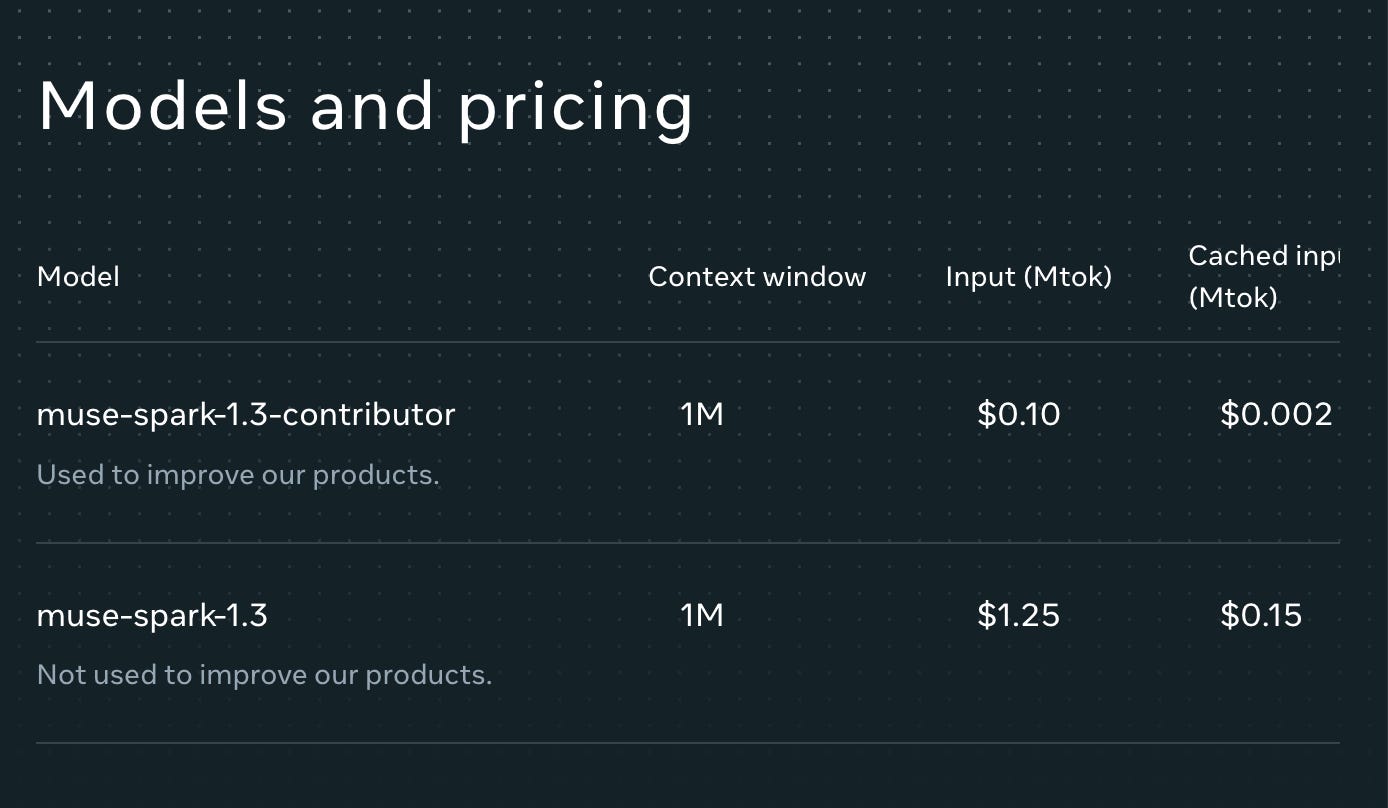
他们的定价模式很有意思:如果选择加入训练,价格能便宜 90% 以上:
AI News,2026 年 8 月 22 日至 8 月 24 日。我们检查了 12 个 subreddit、544 个 Twitter 账号,没有再查看 Discord。AINews 网站可搜索所有往期内容。提醒一下,AINews 现在是 Latent Space 的一个栏目。你可以选择开启或关闭邮件频率!
AI Twitter 综述
智能体工程课程、课程体系与开发者实践
- 斯坦福正把 AI 原生软件工程确立为一门学科:@mihail_eric 宣布推出新版 The Modern Software Developer,围绕他所说的软件工程“2026 蜕变”展开。值得注意的不只是课程本身,还有课程体系的重置:2025 年秋季 85% 的内容被替换,新增主题包括智能体技能、上下文工程、MCP 门户、面向智能体的代码库设计、智能体代码评审、安全、并行后台智能体和软件工厂。课程还要求学生向真实的开源仓库提交 PR,并得到 Browserbase、OpenHands、Semgrep、Milvus、Marimo、CrewAI、Warp、Vercel、Unsloth 和 Anyscale 等合作方的支持。
- 斯坦福的第二门课聚焦从第一性原理构建智能体:@Diyi_Yang 和 @michaelryan207 宣布开设 CS329Z: Engineering AI Agents,明确以“从零”构建智能体为主题。与 Mihail Eric 的课程放在一起看,这说明教学重心正从“提示词”转向面向系统的智能体工程:运行框架、评估、记忆、工具、编排和生产约束,而不只是模型的使用。
- 从业者的讨论正趋向有状态的智能分配,而非简单路由:在一次圆桌提问中,@HarryStebbings 强调了 @EnoReyes 的观点:要充分发挥模型的价值,仅靠路由是不够的,智能体需要理解任务状态、刚刚发生了什么以及接下来会发生什么,才能动态分配智能。这与 @jerryjliu0 的观点一致:与厂商无关的初创公司通过端到端优化运行框架,并有选择地同时使用前沿模型和开放权重模型,可以在狭窄任务上胜过前沿实验室。
模型架构与推理:Astra 传闻、循环 Transformer 与实时推理服务
- “Astra 是循环 Transformer”的传闻可能没有标题所说的那么新鲜:@rasbt 梳理了关于 OpenAI 传闻中 Astra 架构的报道,认为所引用的“循环深度”或“循环 Transformer”概念只是相当温和的架构调整,本身并非突破。他以 Nanbeige 4.2-3B 作为开放权重先例:22 层 Transformer 堆叠被重复使用两次,实际表现相当于一个 44 层模型,而参数存储并未翻倍。取舍很直接:内存占用相近,算力约为 2 倍,且与标准堆叠相比仅保留部分 token 效率。更有实质意义的历史参照是 Mixture-of-recursions:由学习得到的路由器自适应地决定每个 token 经过几轮计算,让简单 token 提前退出,困难 token 获得更多算力。
- 隐藏推理并非循环的必然推论:@rasbt 的第二个重要澄清是,层复用并不会天然地“遮蔽思维链”,它只是在输出 token 之前把更多计算放进了潜在激活中。如果循环深度减少了可见的推理轨迹,那是因为模型可能需要输出更少的中间 token,而不是循环 Transformer 本质上会抑制文本形式的思维链。
- 推理服务基础设施的更新继续瞄准实时多模态工作负载:@vikhyatk 宣布推出 Photon 2.1,为这款实时多模态推理引擎新增了文本转语音模型和 NVIDIA B200 支持。另外,Baseten 宣布托管上线 GLM-5.3 Fast,通过 @baseten 强调其更高的 TPS 以及实时部署的定位。
智能体运行框架、技能检索与强化学习后训练工具
- 字节跳动 Seed 的 HarnessDev 把智能体评估的重点放在运行框架上,而不只是任务完成度:@omarsar0 介绍了一篇关于 HarnessDev 的新论文,它要求模型从一个薄弱但可运行的种子出发构建执行框架,再在第二阶段利用下游反馈加以改进。两个阶段都按能力和执行 token 成本打分,把效率纳入目标。在六个生成端 LLM、四个领域和 2,207 个留出的下游实例上,生成的运行框架在代码、搜索和研究上仍落后于成熟的人工设计系统,但在写作和机器学习实验上与之持平或更好。关键的细微之处在于,自进化的运行框架确有帮助,但收益不稳定、依赖模型,且只能部分迁移。
- 相关的生态信号:exo 与递归自我改进工具:@omarsar0 还指出 exo 运行框架是理解递归自我改进工作流的一个有用入口,表明人们对这类框架的兴趣正在增长:智能体不只改进输出,还改进自身的脚手架。
- 技能检索在整体上可能看起来不错,却会损害真正触发它的那些任务:@dair_ai 概述了一篇论文,提出 Retrieval-Invoked Actual-Use Effect,这是一种配对评估方法:对同一任务运行两次,分别开启和关闭技能,且只统计检索确实被触发的任务。在编码和数学任务上对 17 个 LLM 的测试中,论文发现有些情况下检索提升了整体分数,却对实际用到检索的那部分任务产生了负面的同任务效应。对维护技能库或工具目录的团队来说,这是一个切实的提醒:不要过度解读整体提升。
- 强化学习后训练基础设施正越来越产品化:SGLang 团队与 Baseten 和 NVIDIA Dynamo 一起,围绕 Miles 推广了一场活动,Miles 是一个强化学习训练框架,以 SGLang 作为 rollout 推理引擎,让强化学习后训练更快、更可靠(@sgl_project)。@AravSrinivas 另外将 Miles 描述为开源的强化学习即服务,进一步印证了业界正转向可复用的后训练技术栈,而非定制的内部流水线。
Google Gemini 3.8 Flash Cyber 与 Google 工具带来的生产摩擦
- Google 推出专用网络安全模型,并给出亮眼的基准测试成绩:@sundarpichai 宣布推出 Gemini 3.8 Flash Cyber,定位为 Google 能力最强的网络安全模型,同时保持 Flash 级别的速度和定价。报告的数字包括 CyberGym 86.2%、CWE-Bench 补丁修复 47.2%,以及在内部漏洞发现基准测试中,跨 20 种编程语言的成功率超过 70%。
- 与此同时,开发者的情绪指向运行框架和账号风险方面的担忧:@theo 认为,Google 目前在运行框架、代码应用、第三方集成方面的开发者体验很差,尤其是与核心 Google 账号绑定的激进封号。@QuinnyPig 进一步强化了这一担忧,指出影响范围可能不止 Gmail/Workspace,还会波及与同一身份关联的 Google Cloud 账号。Theo 后来抱怨 Gemini 在任务中表现出缓慢、工具调用繁重的编码行为(1、2、3),虽属个例,却凸显了基准测试表现与生产环境开发者体验之间的差距。
Meta Muse Spark 1.3 与视频/多模态发布周期
- Meta 推出面向智能体和编码工作负载的 Muse Spark 1.3:@shengjia_zhao 介绍 Muse Spark 1.3 是 Spark 系列中最适合智能体和编码任务的模型,强调更长程的工作以及对复杂指令更可靠的遵循。社区反应集中在其性价比上,包括 @alexandr_wang 点出它能“只花一毛钱”做到的事,另有用户称它在速度和 token 效率上优于同类“xhigh”产品。
- 阿里巴巴的 Wan 3.0 在视频领域的第三方排行榜上成绩亮眼:@ArtificialAnlys 报告称,Wan 3.0 在 Artificial Analysis 排行榜上位列带音频视频编辑第 1、带音频文生视频第 2、带音频图生视频第 5。该版本定位为一体化生成与编辑模型,可接受文本、图像、视频、音频、文档和网页作为参考,支持原生音频,并可生成最长 30 秒、1080p 的视频。公开预览期定价从 480p 每秒 $0.05 起,1080p 升至每秒 $0.20。
- 重参考的多模态交互体验也在改善:@imagine 宣布支持每个视频最多 14 个参考,涵盖图像、声音和角色参考,在提示词中通过
@标记引用,这是对多素材创作控制的一项虽小但实用的界面改进。
开源模型、机器人与热门推文
- 开源模型的努力继续扩大规模:@percyliang 分享说,Marin 535B-A23B 已完成 13% 的训练,算力由 Jen-Hsun and Lori Huang Foundation 资助,在 CoreWeave 上运行。这条帖子的看点与其说是某项基准测试,不如说是在公益算力支持下,大规模开源模型训练依然可行。
- 物理 AI 与开放机器人平台在稳步推进:@maze_rapid 宣布推出 Palmimo DevKit,这是一个桌面级 AI 机器人平台,配有开源软件和可更换的 AI“大脑”,开发者无需深厚的机器人专业知识,只需几行 Python 就能控制机器人应用。它还处于早期,但作为智能体框架延伸到具身系统的一个例子,值得关注。
- 热门推文(按互动量):
- @mihail_eric:斯坦福全面改版的AI 原生软件开发者课程,课程内容大幅更替,并与开源社区合作。
- @sundarpichai:Gemini 3.8 Flash Cyber 发布,网络安全基准测试成绩亮眼。
- @rasbt:对循环 Transformer 的详细架构拆解,以及 Astra 传闻为何可能夸大了新颖性。
- @Diyi_Yang / @michaelryan207:斯坦福新课 CS329Z: Engineering AI Agents。
AI Reddit 综述
/r/LocalLlama + /r/localLLM 综述
1. Muse Spark 与 Spark-X2.5 开放权重模型
- Muse Spark 开放权重即将发布(热度:902):这张图片是 Mark Zuckerberg 在 X 上发布 Muse Spark 1.3 推出公告的截图,称其在编码、智能体工作流和长上下文任务上有重大改进,并表示 Muse Spark 开放权重“即将发布”。附带的基准测试表显示,Muse Spark 1.3 高于 Muse Spark 1.2,并在智能体、长上下文和编码评测中与标注为 GPT 5.6 Sol 和 Opus 5 的模型不相上下;不过 Reddit 发帖者指出,Spark 对其硬件来说可能太大,并表示在等 Llama 5,或介于 Glimmer 与 Spark 之间的中间模型。评论者认为这些结果表明多家领先实验室在技术上正趋同,有人说“没有秘密配方”,前沿差距可能只有几个月。另一位评论者认为 Muse Glimmer 被低估了,并称其在非编码任务上胜过 Qwen 3.8:27B。
- 评论者注意到一个异常高的长上下文成绩:MRCR
512k–1m在98.1%,有用户问这是否意味着 Muse Spark 在百万 token 规模上实际解决了“上下文腐化”。如果属实,这项基准成绩将是该帖中技术上最值得关注的说法,因为在512k+上下文中持续保持检索/推理质量,仍是许多开源和闭源模型的主要短板。 - 一位用户反映,Muse Glimmer “相当不错”,在非编码任务上主观感受优于 Qwen 3 8/27B,这表明 Muse 较小的/上一代模型在编程基准之外可能已经具备竞争力。这一对比属个人经验,但它指向的是随任务而异的优势,而不是全面的排行榜表现。
- 几位评论者质疑所展示成绩背后可能的参数量,推测如果基准测试准确,Muse Spark 可能达到万亿参数规模。这引出了实际部署方面的担忧:业余爱好者可能无法在本地运行它,但开放权重对于出于政策/合规原因需要非中国模型选项的机构仍然有用。
- 评论者注意到一个异常高的长上下文成绩:MRCR
- 新模型:Spark-X2.5-4B、Spark-X2.5-1.7B(热度:301):XHToken 发布了 Spark-X2.5
1.7B和4B,看起来是自定义架构而非简单微调,模型卡声称具备原生1Mtoken 上下文、多语言支持,训练数据约20Ttoken,外加长上下文/后训练阶段。据称该架构混合使用完整注意力和滑动窗口注意力,以降低长上下文的 KV/算力成本,其4B基准测试成绩被描述为可与大得多的模型相比,例如 Qwen 级别约9B的模型。运行时支持尚未合入上游llama.cpp,需依赖一个待合并的llama.cppPR #27868 或 XHToken 的自定义分支,另有1.7B和4B的 GGUF 可用。评论者主要对所报告的20Ttoken 预训练规模印象深刻,尤其是在 5B 以下参数规模上声称具备原生1M上下文。大家也谨慎地关心,基准测试的说法,特别是4B追平约9B的模型,能否经得起独立测试。- 评论者注意到 Spark-X2.5 所报告的
20T训练 token 规模,对 1.7B/4B 这个参数区间来说异常之大;如果基准测试可复现,这或许能解释为何声称 4B 版本追平了 9B 模型。另一项突出的规格是在这个模型规模上的原生1M上下文,读者认为这在技术上比单纯的基准持平更值得注意。 - 一位测试者报告了使用“pi harness”的早期定性表现:当被问到“你是什么模型”时,模型似乎先用工具检查/分析运行框架的名称再作答,这表明它有智能体/工具使用倾向,但也“想得太多”。在一次快速推理测试中,它没通过“洗车”测试,测试者打算进一步与 Qwen3.5 9B 比较日常使用质量。
- 评论者注意到 Spark-X2.5 所报告的
2. Qwen3.8 基准测试与 GGUF 提速
- Qwen 会成为王者吗?(热度:732):这张图片展示了 Arena AI Code Arena WebDev 排行榜,其中 Qwen3.8-Max-0902 以
1,691分排名第 1,略高于 Claude Opus 5 Max 的1,688和 Kimi K3 Max 的1,674。结合发帖语境,这一结果被用来论证 Qwen 的扩展推理/后训练缩放可能正在缩小与大得多的前沿系统的差距,也许在未来的 Qwen 4 发布或可能的开放权重更新之前就已实现。评论者对本地/开放权重的 Qwen 变体相当乐观,有人称本地运行的 Q3.8-27B 表现优于其付费 ChatGPT 的编码体验。另一些人则质疑表现最好的 Max 模型是否会开放权重,还有评论者称赞扩展推理,但指出了代价:难题的延迟长达数小时。- 一位用户报告称,Q3.8-27B 搭配 PI 使用时本地编码表现出色,声称其编码任务表现超过了他先前付费使用的 ChatGPT 5.1。他强调的是实际的任务遵循能力:当提供相关上下文(如
.txt文件中的 wiki 页面)时,模型生成的代码只需少量修复就能运行,且完全在本地 PC 上运行,保护了数据隐私。 - 几位评论者把扩展推理视为一大差异化优势:有人说 Qwen 3.8 Max 在他们的挑战集上“100% 正确”,但可能要花数小时才能给出答案。这把取舍归结为:对推理密集型工作负载而言,是准确性/可靠性与极高推理延迟之间的权衡。
- 对所展示的基准测试图也有质疑,一位评论者说这些数字看起来“被修饰得很厉害”,另一位则问为什么对比中没有 Fable 5.1。担忧在于,模型排名的说法可能高度依赖基准测试的选择、报告方法或被遗漏的竞争对手。
- 一位用户报告称,Q3.8-27B 搭配 PI 使用时本地编码表现出色,声称其编码任务表现超过了他先前付费使用的 ChatGPT 5.1。他强调的是实际的任务遵循能力:当提供相关上下文(如
- Qwen3.8-Flash-Next-GGUF 的 MTP 已发布(热度:671):****Unsloth 发布了
Qwen3.8-Flash-Next-GGUF的 MTP 支持/文件,测试说明关联到 Unsloth 的llama.cpp分支/PR(unslothai/llama.cpp#144),GGUF 的使用路径面向本地运行时/兼容 OpenAI 的端点。一位评论者指出,上游刚刚合并了一项llama.cpp优化(ggml-org/llama.cpp#28123),报告称 MTP 吞吐量在代码上从123 tok/s → 183 tok/s提升,在文本上从83 tok/s → 144 tok/s提升,而不使用草稿时为108 tok/s;补丁之前,文本场景下的 MTP 据报道比完全不用草稿还慢。评论讨论大多很务实:用户问 SSD 卸载是否稳定、是否“已经理顺”,并指出 MTP 文件可能已经可用好几天了。- 一位评论者引用了 llama.cpp 刚刚合并的一个优化 PR(ggml-org/llama.cpp#28123),显示 Qwen3.8-Flash-Next-GGUF 的 MTP 吞吐量大幅提升:不使用草稿的基线为
108 tok/s,改动前的 MTP 在代码上为123 tok/s,在文本上只有83 tok/s,改动后的 MTP 提升到代码183 tok/s/ 文本144 tok/s。关键的技术要点是,合并之前,在文本类工作负载上 MTP 可能比普通解码更慢,而这个补丁似乎让草稿解码始终带来收益。 - 几位评论者在跟踪 llama.cpp 中尚未解决的运行时/支持细节,包括 SSD 卸载是否稳定,以及
-shared选项相对于非共享模式对 MTP 文件有什么改变。另一位用户说,他以为所需的 llama.cpp 功能支持还没有完全合并,并报告本地性能很低,只有约9 tok/s,这意味着对硬件/配置的敏感度仍然很高。
- 一位评论者引用了 llama.cpp 刚刚合并的一个优化 PR(ggml-org/llama.cpp#28123),显示 Qwen3.8-Flash-Next-GGUF 的 MTP 吞吐量大幅提升:不使用草稿的基线为