如今测试机器人策略需要部署到物理硬件上,这一过程缓慢、昂贵,而且难以扩展。传统仿真器提供了替代方案,但往往无法迁移到真实世界,难以捕捉真实环境在视觉和物理上的复杂性,从可变形物体、柔软材料,到违背标准物理假设的非刚体动力学。一个能可靠预测真实世界结果的世界模型,可能从根本上改变机器人团队评估和迭代策略的方式。
去年 12 月,我们发布了 GWM-Robotics,它支持在世界模型内部进行策略评估,无需物理硬件。这次我们对它做了实测:在 GWM-Robotics 中模拟了八个机器人操作策略,并将结果与真实世界的基准真值进行比较。在全部八个策略上,模拟得分与真实世界得分的相关系数为 0.95,这表明我们的世界模型可以作为可靠的代理,在投入硬件部署之前评估机器人策略。
我们的早期结果表明,世界模型仿真可以成为硬件评估的实用替代方案,且与现有的真实到仿真(real-to-sim)方法相比毫不逊色。GWM-Robotics 优于 PolaRiS,后者是近期的一个 real-to-sim 框架,使用 3D Gaussian splatting 重建特定的真实场景,这一过程涉及扫描、重建和手动设置物体。与 PolaRiS 不同,GWM-Robotics 只需起始图像作为输入。此外,GWM-Robotics 能实时生成长达 30 秒的 rollout,远长于 Veo Robotics 等同类世界模型,后者的 rollout 限制为 8 秒。
我们正与包括 NVIDIA 和 Berkshire Grey 在内的合作伙伴共同构建 GWM-Robotics,同时为物理 AI 扩展世界模型。可在此处申请访问。
模拟成功
▶ https://d3phaj0sisr2ct.cloudfront.net/research/images/generated_red_cube_fast_trimmed.mp4
任务:“pick up red cube, put in green bowl”(拿起红色方块,放进绿色碗里)。在这个用 GWM-Robotics 生成的 rollout 中,策略成功完成了任务,与它在真实世界 RoboArena 数据集中的成功表现一致。
模拟失败
▶ https://d3phaj0sisr2ct.cloudfront.net/research/images/fail_move_water_bottle_out_of_chair_pi05.mp4
任务:“move the water bottle out of the chair”(把水瓶从椅子上移开)。在这个生成的 rollout 中,策略未能完成任务,与它在 RoboArena 数据集真实世界 rollout 中的失败表现一致。
方法:评估机器人操作的仿真到真实相关性
在这项研究中,我们从 RoboArena 基准测试中选取了涵盖八个视觉-语言-动作(vision-language-action)策略的操作任务,所有 rollout 均使用 Franka Emika Panda 机械臂。我们使用 GWM-Robotics 模型(我们最先进的 Gen-4.5 视频生成模型的一个变体),从相同的初始条件出发模拟每个策略,每个策略根据世界模型产生的观测自行生成动作。然后,我们请人工评分员评估机器人在 1,450 个模拟 rollout 中对每条任务指令所取得的进展,这些 rollout 均基于 RoboArena 数据集中先前的任务评估生成。我们总共收集了超过 16,000 条独立评分,每个 rollout 由约 10 位独立评分员评估。通过比较每个策略在模拟 rollout 与真实世界 rollout 中取得的进展,我们衡量模拟结果在多大程度上反映真实世界中的相对表现。
结果
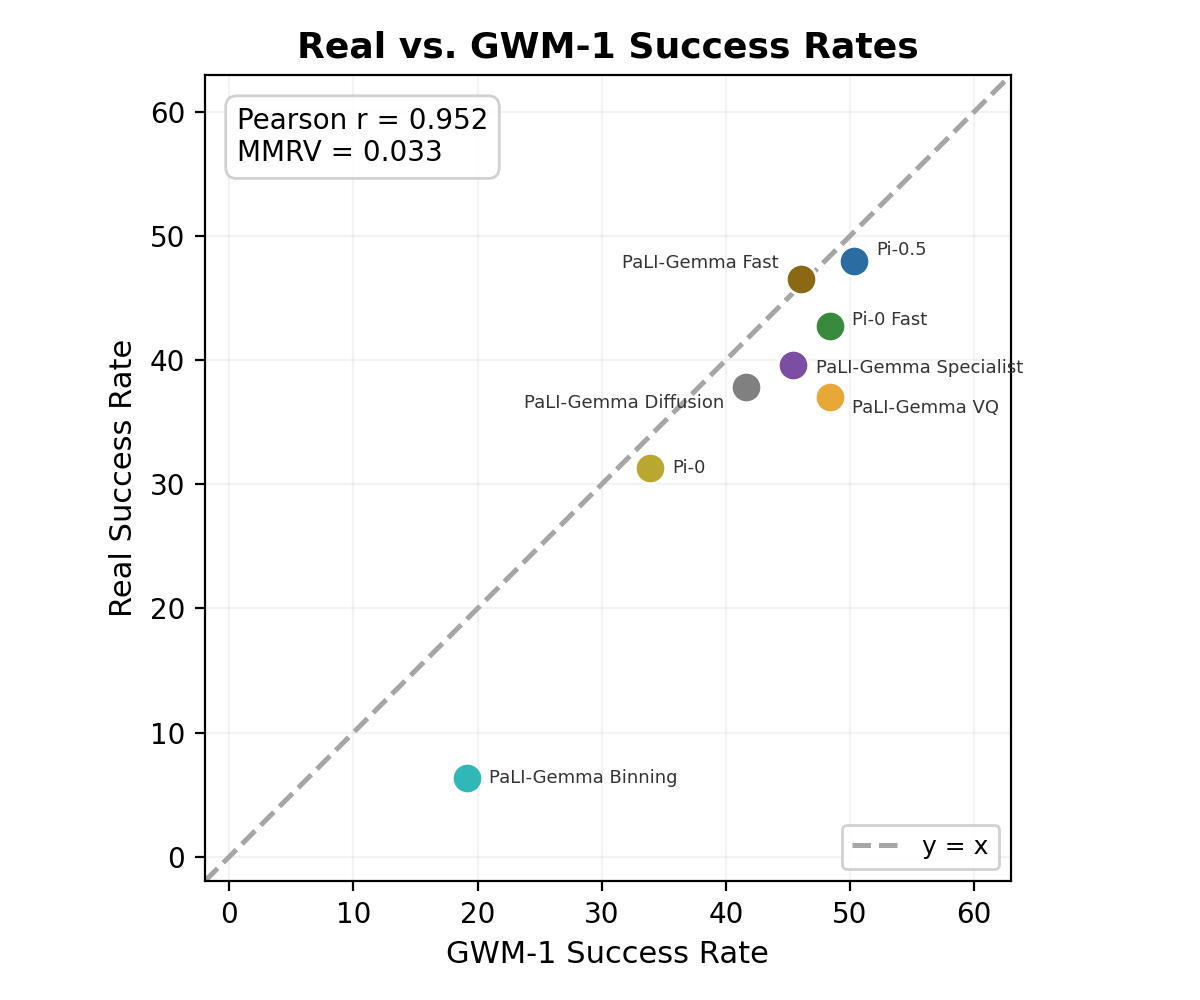
各策略的真实成功率与 GWM-1 模拟成功率对比。可以看到,GWM-1 中的成功与真实世界中的成功高度相关,在评估的全部八个策略上 Pearson 相关系数为 0.95。
我们看到,GWM-Robotics 生成的模拟 rollout 能够支持可靠的策略排序。沿用 PolaRiS 的做法,我们用 Pearson 相关系数量化真实世界与模拟进展得分之间的一致程度,并用平均最大排名违例(Mean Maximum Rank Violation,MMRV)衡量两者之间的排名一致性。汇总人工评估员对模拟 rollout 的进展得分后,得到的策略排名与真实世界排名相匹配,Pearson 相关系数为 0.95,平均最大排名违例(MMRV)为 0.033,这意味着任意两个策略之间的最坏排名误差小到可以忽略。当仅限于 PolaRiS 中也评估过的那部分 RoboArena 策略架构时,GWM-Robotics 的 Pearson 相关系数为 0.986,MMRV 为 0,超过了 PolaRiS 的 0.98 相关系数,并与其完美的排名顺序持平。人工评估员正确识别出了表现最好的策略(pi05_droid)和表现最差的策略(paligemma_binning_droid),其余六个策略则只在表现相近的模型之间出现了轻微的排名颠倒。
局限与未来范围
这项研究评估的是策略排序,即模拟结果是否保持了策略之间的相对顺序,而不是绝对成功率的预测。虽然对实际的策略选择而言,排序才是最重要的,但缩小绝对校准方面的差距仍是我们正在推进的工作。
我们这里的评估范围限于使用单个机械臂(Franka Panda)、在 RoboArena 基准各任务上的桌面操作。虽然 GWM-Robotics 已在多种机器人本体(embodiment)上训练过,但将评估扩展到这些形态仍是重要的下一步。由于该模型建立在大规模视频训练的基础之上,而不是单一机器人的仿真器,它可以用远少于传统方法的机器人专用数据泛化到新的本体。
结论
这些结果覆盖八个多样化的策略和超过 16,000 次人工评估,表明我们的学习式世界模型(在大规模视频数据上训练,并在机器人本体感知状态上微调)能够以与真实世界执行相同的顺序可靠地对机器人策略排序。这对机器人团队构建和测试策略的方式有直接影响:
- 更快交付:团队不必在硬件上测试每个候选策略,而可以先在仿真中对策略排序,再把物理测试集中在表现最好的那几个上。
- 无需手工搭建的大规模测试:团队可以在不同的光照、物体配置和任务设置下评估,而无需在物理实验室里手工重现每个场景。
- 用更少的真实世界数据训练:通过改变物体、环境和条件,可以扩充一小组真实演示,无需额外采集数据即可提升泛化能力。
我们相信,要构建最好的机器人世界模型,就需要在大规模数据上训练,这些数据涵盖真实世界物理与交互的全部多样性。这些结果支持了这一思路。随着训练数据和算力的扩大,世界模型的保真度将持续提升,每一代都会缩小模拟与真实世界结果之间的差距。GWM-Robotics 只是第一步,这些早期结果加快了我们在机器人研究上的投入,同时我们专注于今天就为客户创造价值。
GWM-Robotics 是一个在真实世界视频上训练的世界模型,其中包括来自 NVIDIA 的物理 AI 数据集。我们正与包括 NVIDIA 和 Berkshire Grey 在内的领先物理 AI 公司合作,将 GWM-Robotics 集成到它们的训练和评估流水线中。可在此处申请访问。