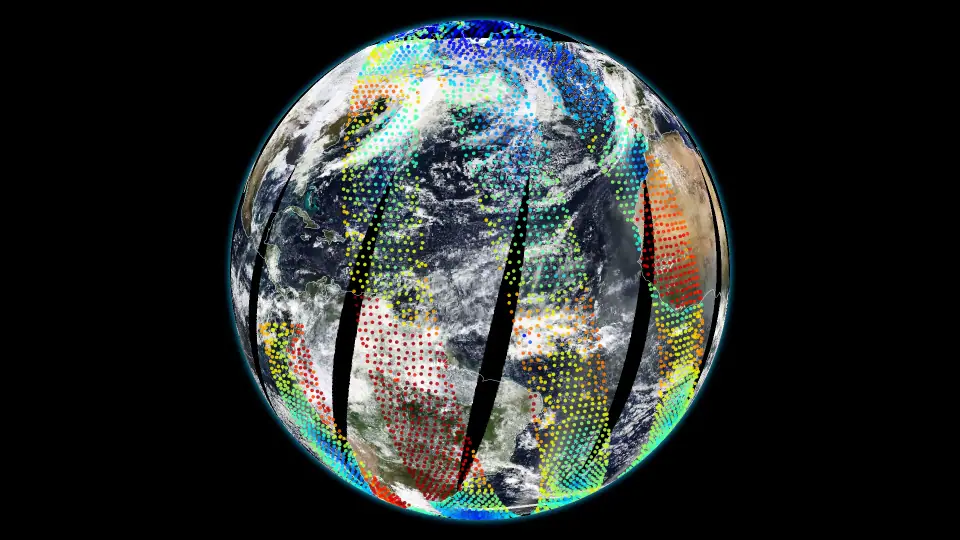
对天气敏感的行业越来越多地能够获得观测数据,这些数据能更早、更本地化地呈现条件变化。能源公司在风电和光伏资产上采集测量数据,应急管理团队依赖雷达和本地传感器,卫星服务商则持续观测地球。这些数据帮助各组织理解并管理资本市场、保险、农业和物流等行业的物理风险。
借助 NVIDIA Earth-2 中的 AI 数据同化工具,你可以更高效地处理这些观测数据。通过纳入自有数据或第三方数据,你可以更频繁地发布预报,使估计值与实时状况保持一致,并针对特定区域和应用定制你的预报流水线。
本教程介绍两种技术:
- 用点观测约束扩散模型,通常用于区域模型。
- 把互不相同的数据集同化为一致的状态,通常用于全球模型。
前提条件
完成本教程,你需要:
- 已安装 Earth2Studio 的开发环境
- 一块 NVIDIA RTX PRO 或数据中心 GPU
- 具备 Python 基础知识
- 大约 30 分钟
用观测数据改进区域预报
你可能运行着一条区域天气预报流水线,用于管理能源生产与需求,观测数据来自风电场和光伏电站、输电走廊或人口稠密地区。借助 AI 数据同化,你可以利用这些观测来约束预报,使其在局部精度最重要的地方更准确,从而改进运营决策。同样的技术也适用于其他行业,只要其观测来自生产现场、活动场馆、物流网络或其他资产,而这些地方的局部条件直接驱动决策。
你可以使用基于分数的数据同化(Score-Based Data Assimilation,SDA),把观测纳入基于扩散的 AI 降尺度和预报模型,例如 CorrDiff 和 StormCast。SDA 引导模型得出与你的观测一致的预测,而无需重新训练模型。
下方的图 1 展示了其内部工作原理。扩散模型通过一系列去噪步骤生成高分辨率预测。在每一步,SDA 都会将中间预测与你的观测进行比较,并把模型推向正确的方向。SDA 的输出是概率性的:观测位置附近不确定性较小,离得越远分布越宽,那里的预测越来越受其他模型输入和底层 AI 模拟的支配。

为了推动模型,你需要定义一个观测算子(observation operator),它把模型输出映射为你预期在每个测量位置观测到的量。对于温度或风速等物理量的原位测量,这尤其简单。在这种情况下,算子最简单的形式是把附近的网格值插值到每个观测位置。也可以为代理测量或观测到的影响创建算子。例如,风力涡轮机的发电功率可以充当风速的代理测量。
SDA 带来两项主要能力:
- 更快地更新预报。数值分析需要大量处理时间,并按固定时间表发布。SDA 让你能够持续纳入观测。下方的图 2 给出了一个具体例子:流水线以一小时为间隔进行预报,并依赖发布周期为六小时的全球分析。
- 纳入自有的、区域性的或特定领域的观测。数值分析使用范围广泛的观测。SDA 让你可以纳入来自自有来源的数据,使预报聚焦于特定的资产位置或下游应用。
SDA 的效果取决于几个因素:观测的数量、空间分布和精度;所预测场的特征长度尺度;以及观测算子的质量和适定性。

如何在 Earth2Studio 中运行 CorrDiff-SDA
CorrDiff 是一种基于 AI 的降尺度技术。Earth2Studio 提供了一个在欧洲上空预训练的 CorrDiff 模型,可把 0.25° 的天气场转换成 2.2 公里分辨率的预测。借助 AI 数据同化,你可以在局部精度重要的地方用观测改进这些预测。随后,你可以用精化后的输出初始化区域预报,或创建用于校准下游模型的再分析数据集。
先加载预训练模型。我们把区域限定在荷兰和德国西北部的一部分,并选择同化 10 米风速。
from datetime import datetime
from earth2studio.data import GHCNHourly
from earth2studio.models.da import CorrDiffCosmoEra5SDA

domain = dict(lat_min=50.2, lat_max=53.8, lon_min=4.6, lon_max=10.4)
sda = CorrDiffCosmoEra5SDA.load_model(
    CorrDiffCosmoEra5SDA.load_default_package(),
    assimilate_variables=("u10m", "v10m"),
    resolution="rea2",
    domain=domain,
    number_of_samples=1,
    sampler_steps=12,
    amp=True,
).to("cuda")
获取用于低分辨率条件的 ERA5 数据,以及该区域内的 GHCN 风观测。
# Fetch and regrid ERA5 inputs onto the high resolution regional grid
# Follow the link to the example below for the full implementation
init_time = datetime(2024, 1, 26)
x = fetch_and_regrid_era5(init_time, domain)

# Fetch GHCN hourly 10-m wind observations over the model domain
lat, lon = sda.model.lat_output_numpy, sda.model.lon_output_numpy
bbox = lat.min(), lon.min(), lat.max(), lon.max()
ghcn = GHCNHourly(stations=GHCNHourly.get_stations_bbox(bbox))
obs = ghcn(init_time, ["u10m", "v10m"]).dropna(subset=["observation"])
最后,用输入数据运行模型。我们进行两次运行,以衡量额外的观测对结果有何影响。
prior = sda(x)  # free downscaling, no observations
analysis = sda(x, obs)  # guide the diffusion toward the observations
完整实现请参阅 Earth2Studio 中的示例,上面的代码改编自该示例。

如何在 Earth2Studio 中运行 StormCast-SDA
StormCast 是一种与 CorrDiff 类似、但专为高分辨率区域预报设计的技术。Earth2Studio 包含一个在美国本土(CONUS)上空预训练的 StormCast 模型,它以 HRRR 初始化,以 3 公里分辨率进行预测。新的 HRRR 分析的计算和发布需要一些时间,但你可以用 SDA 把当前可用的分析与最新观测结合起来,更新你的预报。
先加载预训练模型。我们把区域限定在美国中部。
import numpy as np
from earth2studio.data import GHCNHourly
from earth2studio.models.px import StormCastCONUS

# Limit the domain to the central U.S.
hrrr_lat_lim, hrrr_lon_lim  = (305, 785), (595, 1203)
model = StormCastCONUS.load_model(
    StormCastCONUS.load_default_package(),
    hrrr_lat_lim=hrrr_lat_lim,  # comment out for full CONUS domain
    hrrr_lon_lim=hrrr_lon_lim,  # comment out for full CONUS domain
    num_diffusion_steps=18,
    num_sda_diffusion_steps=96,  # more steps for SDA for better stability
    sda_std_obs=0.15,
    sda_gamma=1e-3,
).to("cuda")
接下来,获取用于模型初始化的 HRRR 分析,并定义覆盖模型区域的观测数据源。
# Fetch HRRR initial conditions
# Follow the link to the example below for the full implementation
init_time = datetime(2026, 4, 17, 18)
x, coords = fetch_hrrr(init_time)

# Define GHCN hourly data source for the model domain
lat, lon = model.lat, model.lon
bbox = lat.min(), lon.min(), lat.max(), lon.max()
ghcn = GHCNHourly(
    stations=GHCNHourly.get_stations_bbox(bbox),
    time_tolerance=timedelta(minutes=15),
)
现在可以运行模型:在最初的滚动预测步骤中使用观测,然后转为不带额外观测的预报。与上方图 2 的示意类似,这种方法用观测来弥合最新分析与当前状况之间的间隔,之后预报独立进行。
对于用 HRRR 初始化的流水线,在新的分析到达之前,通常只有一个受 SDA 影响的步骤是相关的。使用全球分析初始化时,多个滚动预测步骤都可以从 SDA 中受益。
# Initialize generator and get the first output (analysis passthrough)
gen = model.create_generator(x.clone(), coords.copy())
x, coords = next(gen)

# Run the first part of the rollout with SDA
for step in range(nsteps_sda):
    valid_time = np.array(
        [coords["time"][0] + coords["lead_time"][0] + np.timedelta64(1, "h")]
    )
    obs = ghcn(valid_time, ["u10m", "v10m", "t2m"])
    x, coords = gen.send(obs)  # advance one step with observations

# Run the remaining rollout without SDA
for step in range(nsteps_non_sda):
    x, coords = next(gen)  # advance one step without observations
你可以在 Earth2Studio 示例库中找到该示例的完整实现。

如何在你自己的模型中使用 SDA
你可以通过扩展自定义模型的 Earth2Studio 模型封装器来同化观测。为此,请使用 PhysicsNeMo 中的扩散工具。我们从 x0_predictor 开始,这是一个预训练的去噪扩散模型,以带噪样本及其噪声水平为输入,预测无噪样本。不使用 SDA 时,该模型的扩散采样可以这样实现:
from physicsnemo.diffusion.noise_schedulers import EDMNoiseScheduler
from physicsnemo.diffusion.samplers import sample

# Construct diffusion scheduler
sigma_min, sigma_max = 0.01, 100
scheduler = EDMNoiseScheduler(sigma_min=sigma_min, sigma_max=sigma_max)

# Get denoiser from scheduler
denoiser = scheduler.get_denoiser(x0_predictor=x0_predictor)

# Generate sample
latents = sigma_max * torch.randn(shape)
sample(denoiser, latents, noise_scheduler=scheduler, num_steps=num_steps)
要使用 SDA,我们把 x0_predictor 转换成带有 SDA 引导的分数预测模型。我们使用 DataConsistencyDPSGuidance,它把每个被掩码的像素与相应的观测值关联起来。你可以用它来同化来自气象站、自有传感器或类似的基于点的来源的观测。
from physicsnemo.diffusion.guidance import (
    DataConsistencyDPSGuidance,
    DPSScorePredictor,
)

# Setup SDA guidance
guidance = DataConsistencyDPSGuidance(
    mask=mask,  # binary mask that identifies pixels with observations
    y=y_obs,  # gridded observations
    std_y=sda_std_obs,  # the remaining parameters are SDA settings
    norm=sda_dps_norm,
    gamma=sda_gamma,
    sigma_fn=scheduler.sigma,
    alpha_fn=scheduler.alpha,
)

# Convert x0_predictor to score predictor
score_predictor = DPSScorePredictor(
    x0_predictor=x0_predictor,
    x0_to_score_fn=scheduler.x0_to_score,
    guidances=guidance,
)
denoiser = scheduler.get_denoiser(score_predictor=score_predictor)

# Generate sample (identical to non-SDA example)
latents = sigma_max * torch.randn(shape)
sample(denoiser, latents, noise_scheduler=scheduler, num_steps=num_steps)
对于更高级的 SDA 流水线,请使用 ModelConsistencyDPSGuidance,从多个网格点推导出模拟观测。这种方法要求你提供一个 PyTorch 模型,把每个样本映射为相应的模拟观测。借助自定义的 PyTorch 模型,你还可以同化观测到的影响。例如,你可以用风电功率模型来同化涡轮机的输出功率测量。
完整实现请参阅 Earth2Studio 中的 StormCast CONUS 封装器,上面的示例即基于它。
从观测计算全球天气
大多数全球天气预报流水线都用通过数值数据同化得到的当前天气估计来初始化。数值数据同化的计算量很大,这降低了预报的时效性和刷新频率,也让整合自定义观测变得更困难。
借助一种名为 HealDA 的 AI 技术,你可以在几秒钟内估计全球大气的状态。这使你能够发布更贴近当前状况的预报,或计算自定义的再分析。
HealDA 把某个时间窗口内的遥感观测和原位观测映射到全球网格化的大气状态。它由两个主要部分组成:观测编码器和视觉 Transformer(ViT)主干网络。编码器把异构观测当作点云摄入,将每个标量值连同地理位置和时间等元数据一起嵌入为一个 token。这些 token 随后被聚合到目标网格上,由 ViT 主干网络处理。

你可以把预训练的全球数据同化模型作为起点。如果你有自定义的常规观测,通常无需修改模型即可纳入。
对于自有的卫星数据,你可以调整编码器以支持你的数据源。这种灵活性让你能够根据自己的区域或应用来定制数据同化系统。你也可以用同样的技术训练区域系统,而不是全球系统。入门请参阅开源 Python 库 PhysicsNeMo 中的 HealDA 训练流水线。
如何在 Earth2Studio 中运行 HealDA
Earth2Studio 提供了一个用于研究目的的预训练全球数据同化模型。它把来自微波探测仪、无线电掩星、地面站、飞机、浮标等来源的数据整合到 1° 的 HEALPix 网格(HPX64)上。
首先,加载模型。
from datetime import timedelta

import numpy as np
from earth2studio.data import UFSObsConv, UFSObsSat, fetch_dataframe
from earth2studio.models.da import HealDA

model = HealDA.load_model(
    HealDA.load_default_package(),
    lat_lon=True,  # regrid from HEALPix to regular lat/lon
).to("cuda")
接下来,从 NOAA UFS replay 仓库获取输入观测。我们使用常规观测和卫星观测。
# HealDA was trained on the UFS replay window: 21h before to 3h after analysis time
time_tolerance = (timedelta(hours=-21), timedelta(hours=3))
analysis_time = np.array([np.datetime64("2024-01-01T00:00")])

# input_coords() returns the schemas the two observation DataFrames must satisfy
conv_schema, sat_schema = model.input_coords()

# fetch_dataframe attaches the request_time metadata the model needs
conv_df = fetch_dataframe(
    UFSObsConv(time_tolerance=time_tolerance),
    time=analysis_time,
    variable=np.array(conv_schema["variable"]),
    fields=np.array(list(conv_schema.keys())),
)
sat_df = fetch_dataframe(
    UFSObsSat(time_tolerance=time_tolerance),
    time=analysis_time,
    variable=np.array(sat_schema["variable"]),
    fields=np.array(list(sat_schema.keys())),
)
然后用观测数据帧调用模型。
# stateless model - call it directly for a one-shot analysis, or use
# create_generator for cycled assimilation
analysis = model(conv_obs=conv_df, sat_obs=sat_df)
你可以在 Earth2Studio 示例库中找到运行 HealDA 的扩展示例。
用 Earth2Studio 获取观测数据
Earth2Studio 让你可以访问范围广泛的数据源,用于开发、初始化和验证天气模型,包括来自不同平台和传感器类型的观测。
其中有来自静止轨道卫星(GOES、Himawari、Meteosat)和雷达网络(MRMS、OPERA)的网格化数据,你可以直接用它们来训练和快速更新区域高分辨率预报模型,例如 StormScope。当你想预报依赖日照或降水的量时,这些数据源尤其有用,例如太阳能发电量、冷却过程和水库入流。
为了开发数据同化系统并对其做基准测试,Earth2Studio 还让你能够访问 GHCN/ISD、NNJA 和 UFS 等常规观测的档案,以及来自 GDAS 和 ASOS 的业务观测。这些数据源以数据帧的形式提供温度和风速等变量。来自 MetOp 和 JPSS 等极轨卫星系统的观测也可获取。
Earth2Studio 为所有数据源提供统一的接口。你实例化一个数据源对象,并用时间步列表和变量名列表调用它。预报类数据源还接受预报时效列表。这种一致的接口使你很容易在同一工作流中组合多个数据源,或把自己的观测接入流水线。
era5 = NCAR_ERA5()
da_era5 = era5(datetime(2025, 7, 15), ["t2m", "z500"])
print(da_era5.shape)  # (1, 2, 721, 1440)

ifs = IFS_FX()
da_ifs = ifs(datetime(2026, 7, 15), timedelta(hours=48), ["t2m"])
print(da_ifs.shape)  # (1, 1, 1, 721, 1440)

goes = GOES(satellite="goes19", scan_mode="C")
da_goes = goes(datetime(2026, 7, 15), ["abi01c", "abi02c", "abi03c"])
print(da_goes.shape)  # (1, 3, 1500, 2500)

ghcn = GHCNHourly(stations=["USW00013301"])
df_ghcn = ghcn(datetime(2026, 6, 15), ["t2m", "ws10m"])
print(df_ghcn.shape)  # (10, 7)
支持的数据源完整列表请参阅用户指南中的 API 参考。
开始使用 Earth2Studio
在 Earth2Studio 示例库中探索端到端的 AI 数据同化示例。要把你自己的观测接入流水线,请参考自定义数据源示例。
AI 数据同化让你能够纳入对你所在区域或组织重要的观测,从而发布更准确、更及时的预报。
请访问 Earth2Studio 用户指南,开始使用 AI 数据同化,并探索 AI 天气模型的更多能力。