引言
好的评估能帮助团队更有信心地发布 AI 智能体。没有评估,团队很容易陷入被动应对的循环——只能在生产环境中发现问题,而修复一个故障又会引发其他故障。评估能让问题和行为变化在影响用户之前显现出来,其价值会在智能体的整个生命周期中不断累积。
正如我们在《构建高效智能体》中所述,智能体会进行多轮操作:调用工具、修改状态,并根据中间结果进行调整。让 AI 智能体有用的这些能力——自主性、智能和灵活性——同样让它们更难评估。
通过我们的内部工作,以及与处于智能体开发前沿的客户的合作,我们学会了如何为智能体设计更严谨、更有用的评估。下面是在各种智能体架构和真实部署用例中行之有效的做法。
评估的结构
评估(“eval”)是针对 AI 系统的测试:给 AI 一个输入,然后对其输出应用评分逻辑来衡量是否成功。本文重点讨论自动化评估,即无需真实用户、可在开发期间运行的评估。
单轮评估很简单:一个提示词、一个响应和评分逻辑。对于早期的 LLM,单轮、非智能体式的评估是主要的评估方法。随着 AI 能力的进步,多轮评估变得越来越常见。
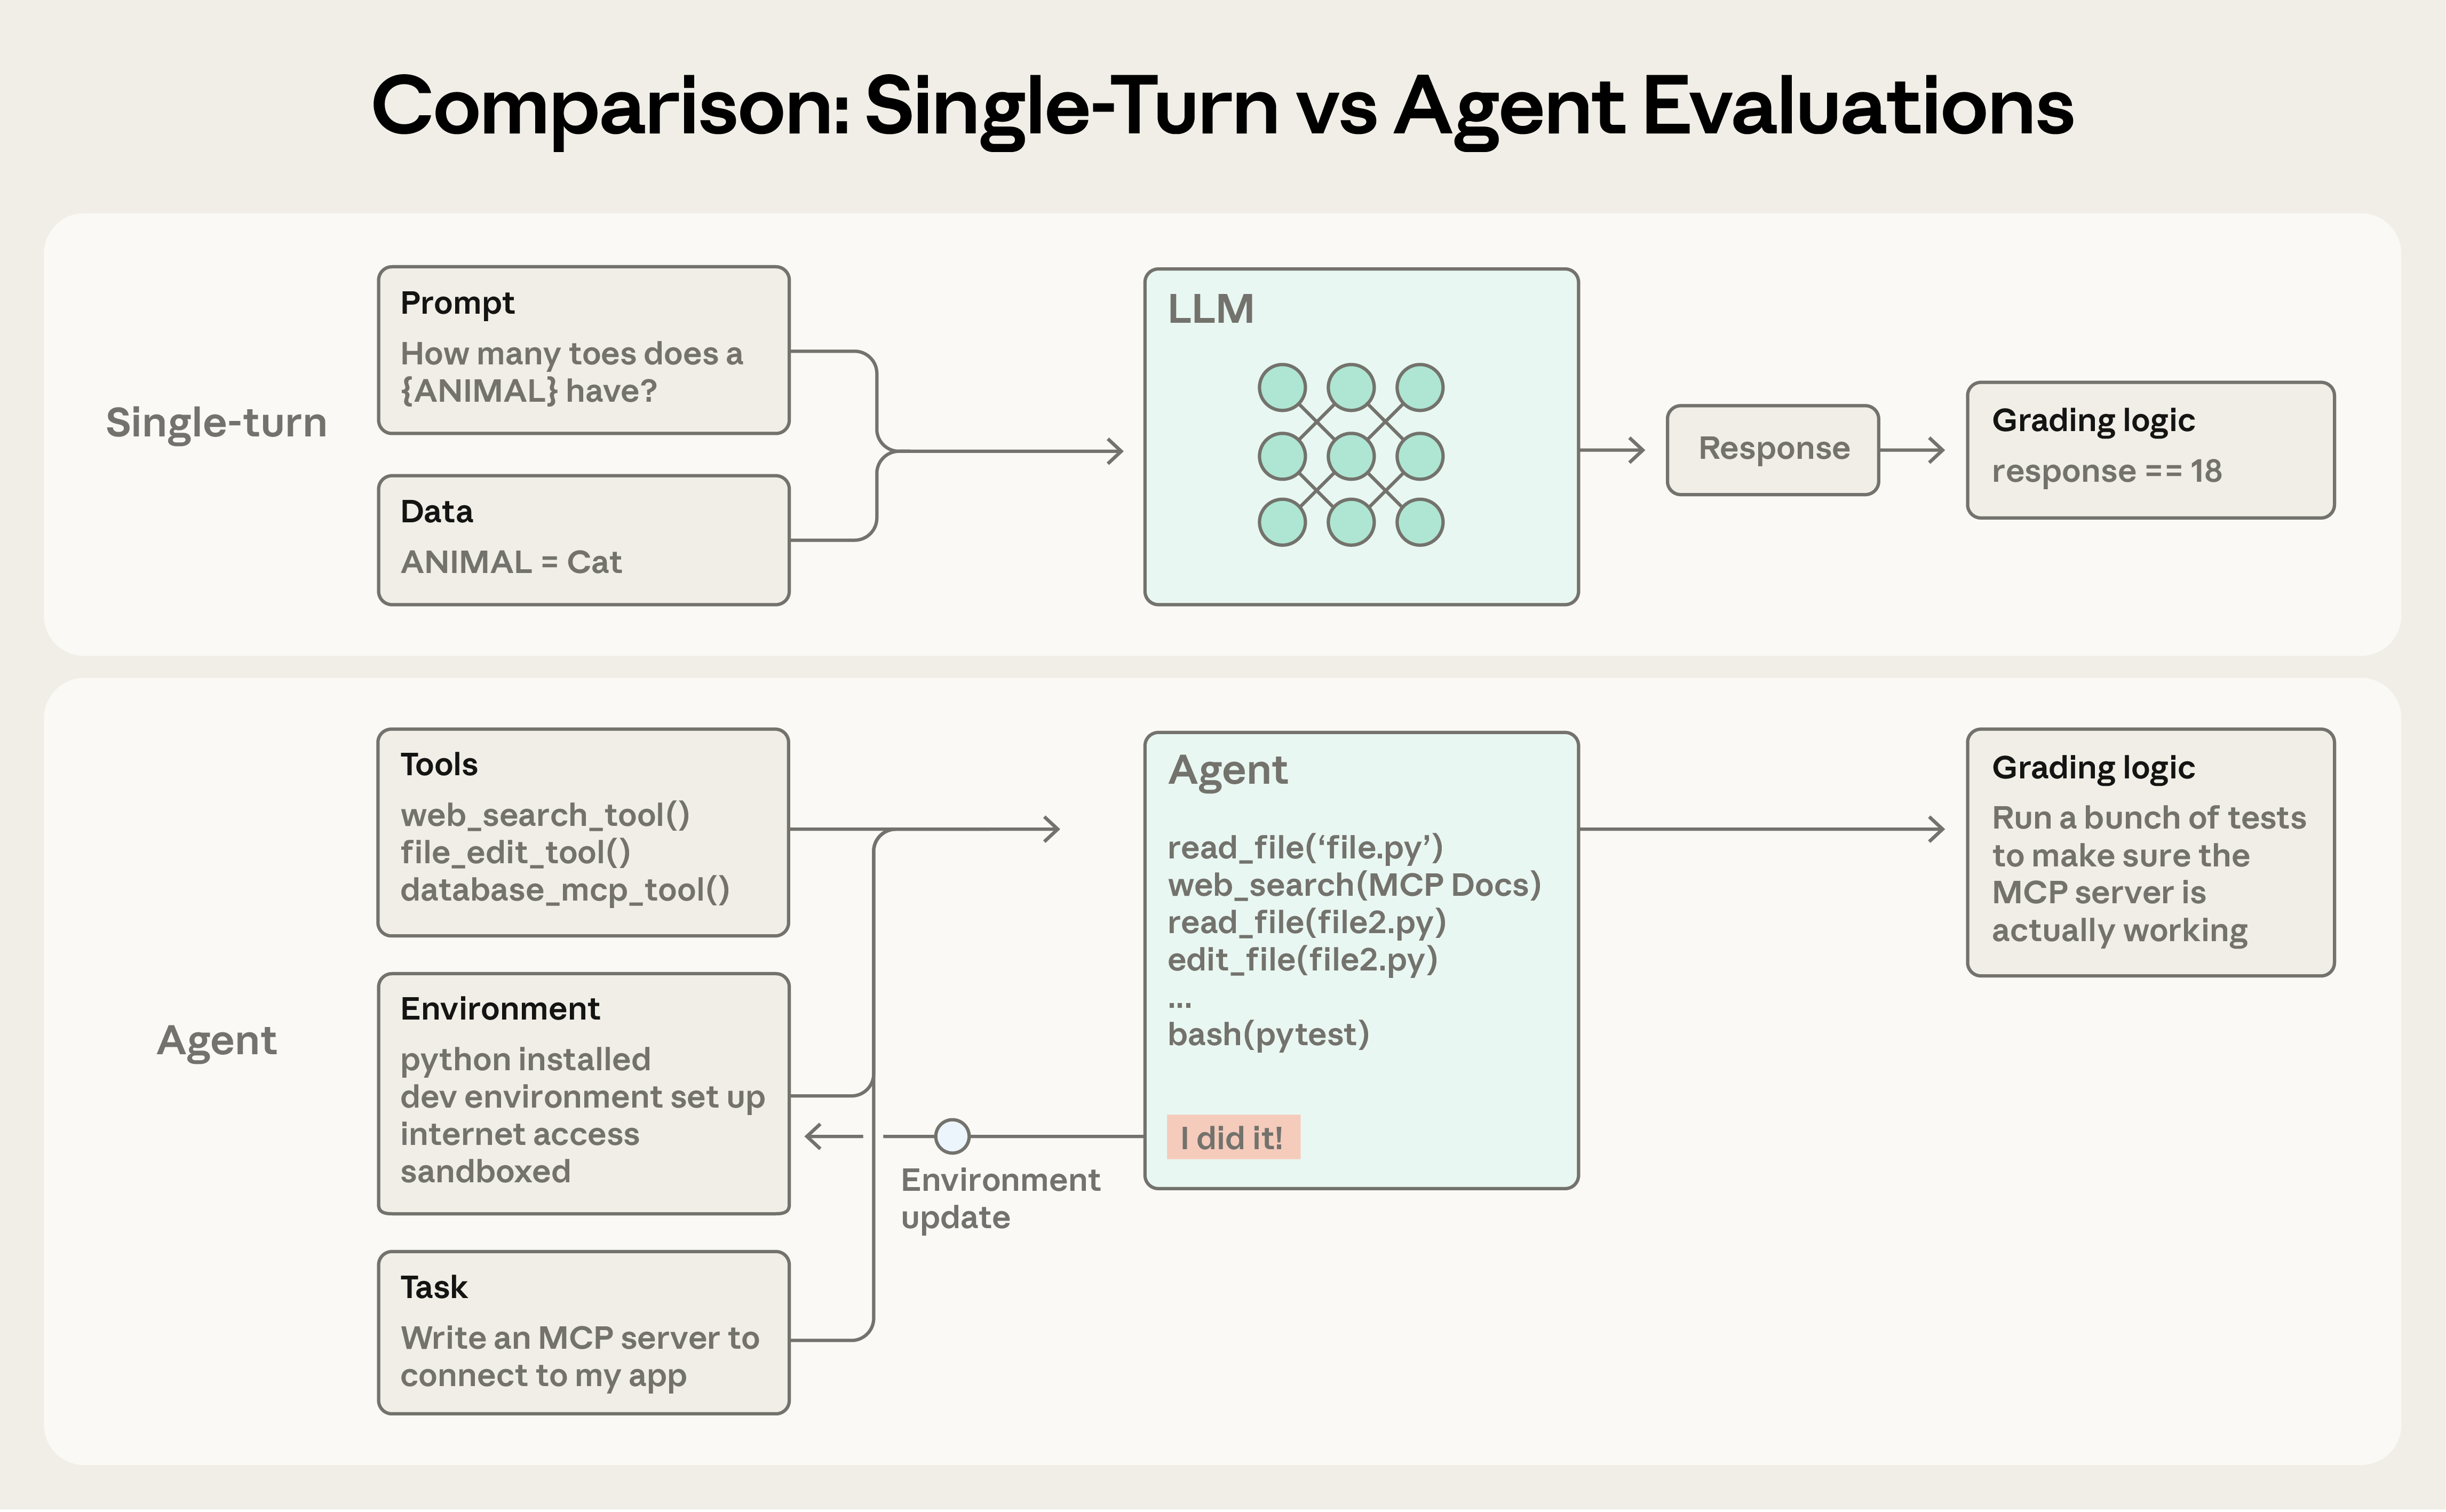
智能体评估则更为复杂。智能体在多轮中使用工具,修改环境中的状态并随时调整——这意味着错误可能传播并不断累积。前沿模型还可能找到超出静态评估边界的创造性解法。例如,Opus 4.5 在解决一道关于订机票的 𝜏2-bench 题目时,发现了政策中的一个漏洞。按评估的字面要求,它“失败”了,但实际上为用户想出了更好的方案。
在构建智能体评估时,我们采用以下定义:
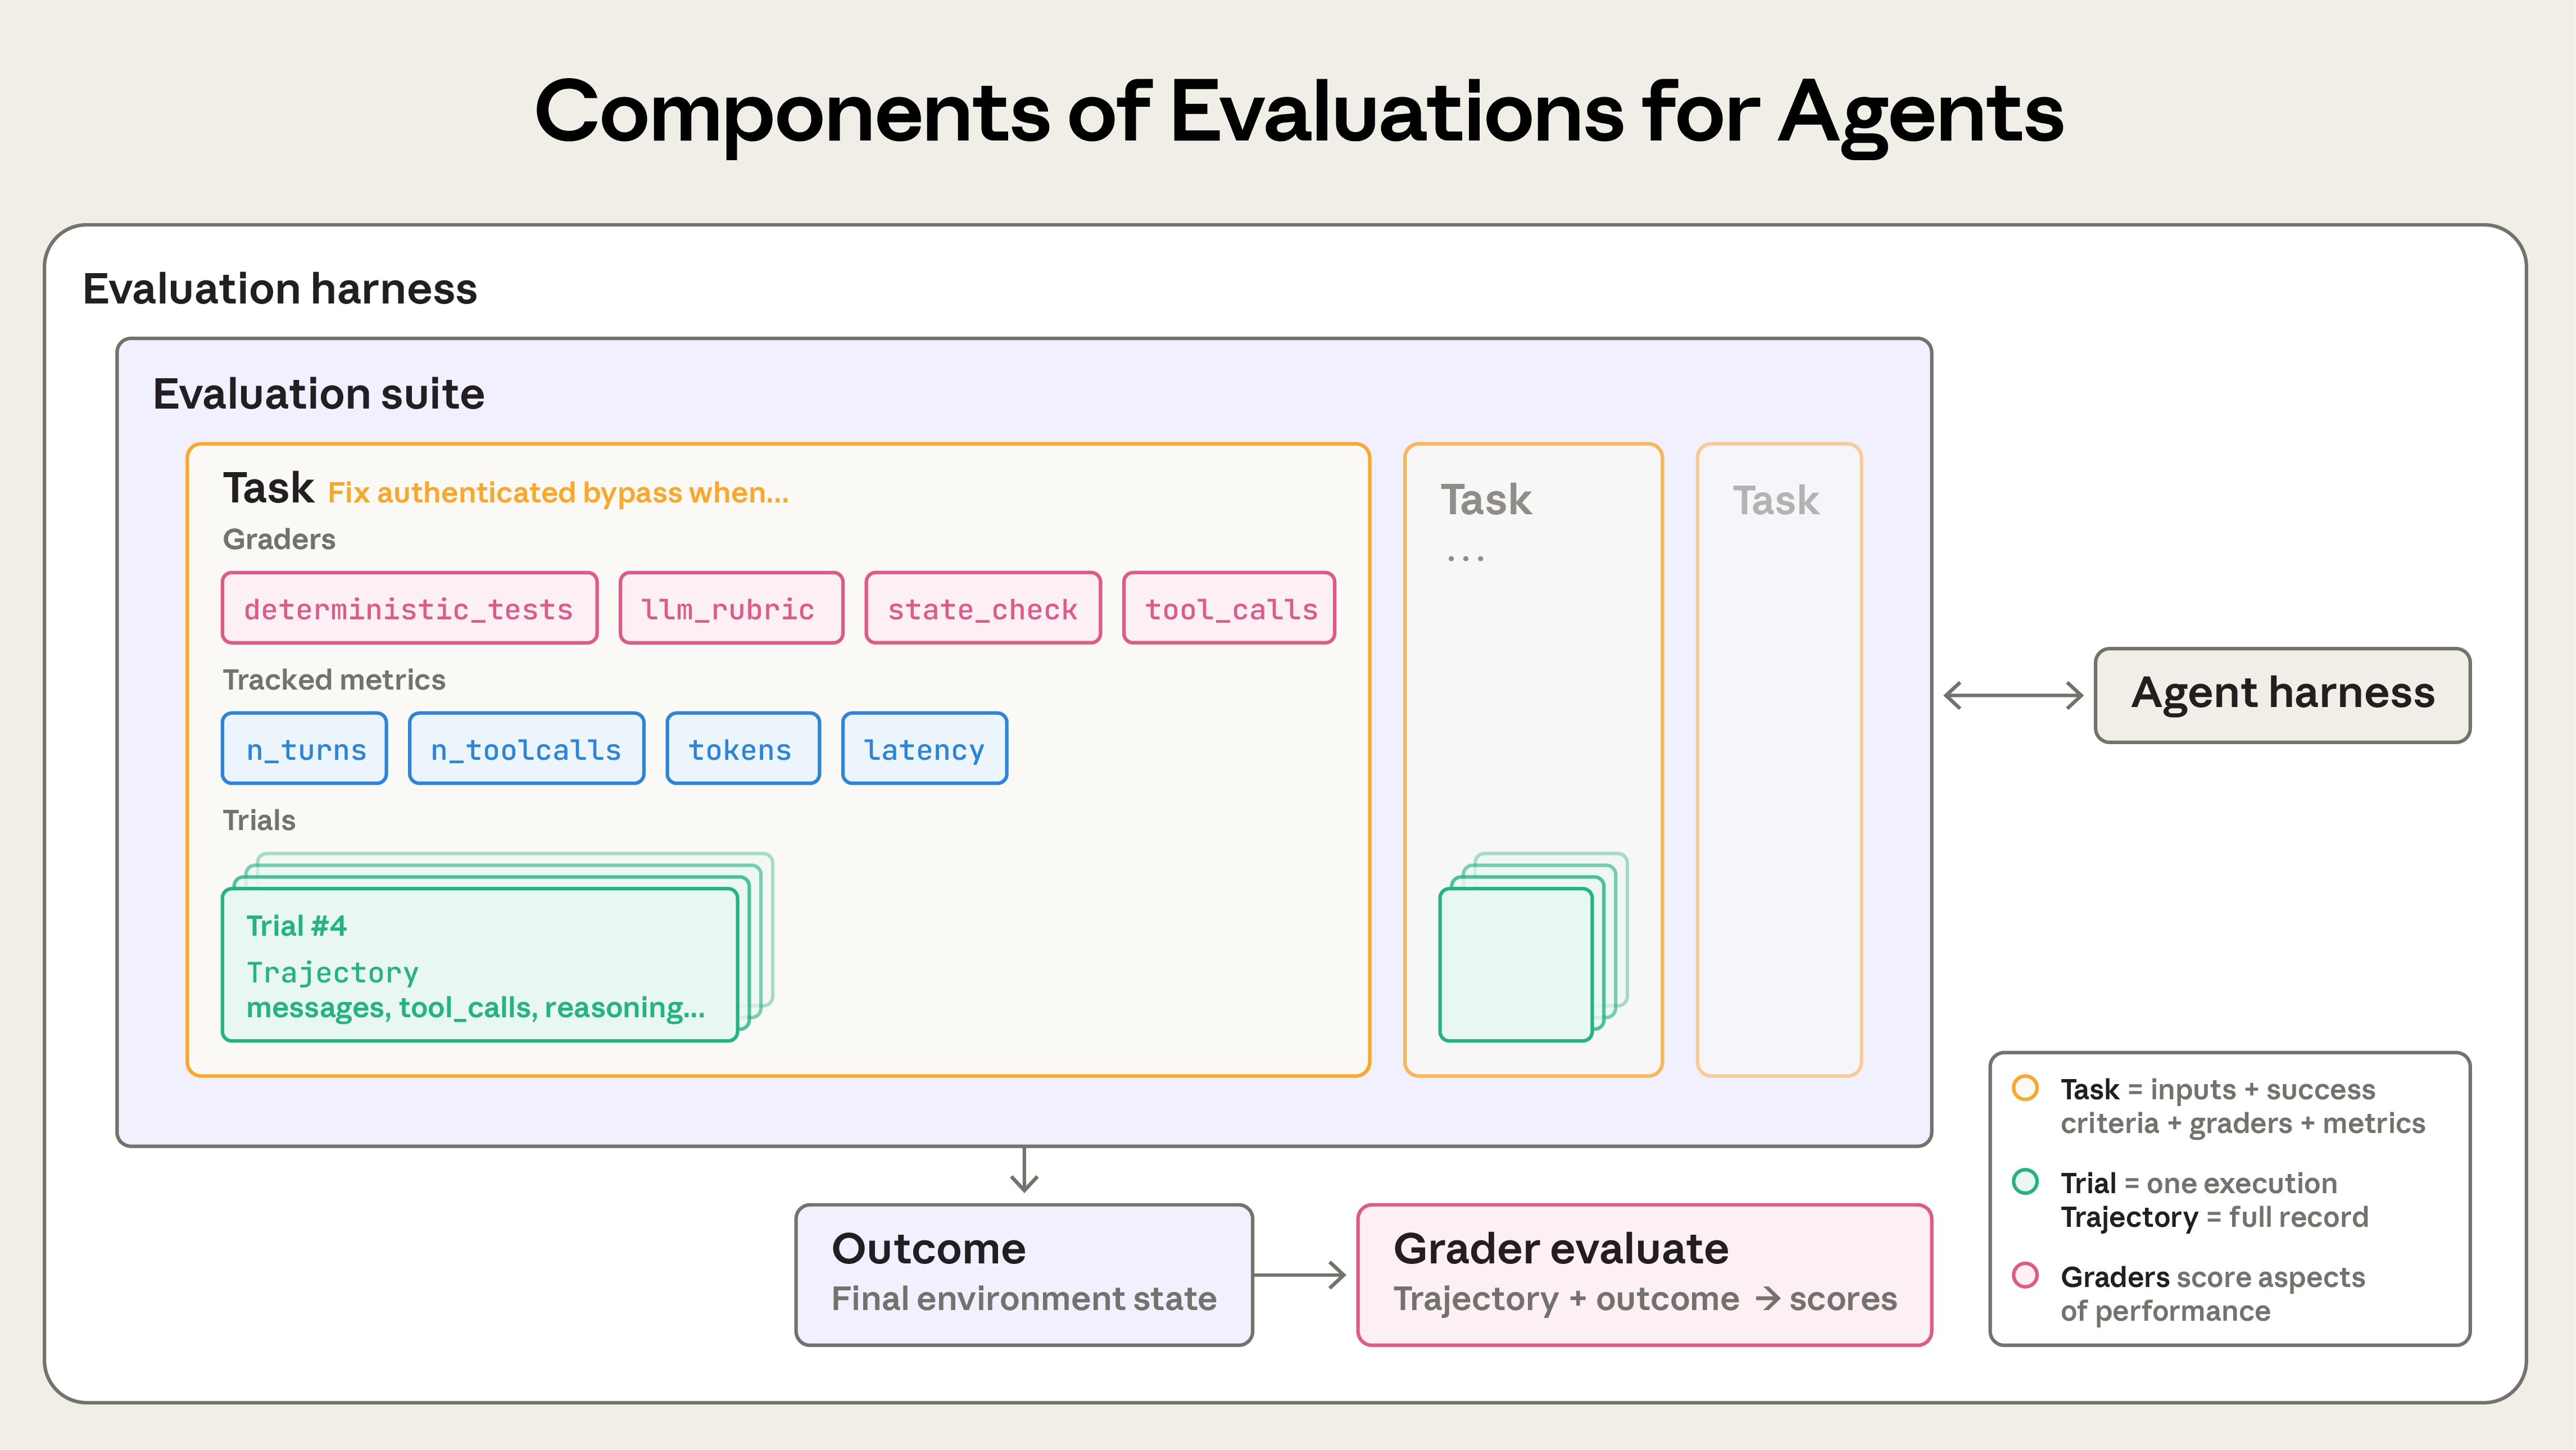
- 任务(又称问题或测试用例)是具有明确输入和成功标准的单个测试。
- 对任务的每一次尝试称为一次试验(trial)。由于模型输出在不同运行之间会有差异,我们会运行多次试验以得到更一致的结果。
- 评分器(grader)是对智能体表现的某个方面打分的逻辑。一个任务可以有多个评分器,每个评分器包含多个断言(有时称为检查项)。
- 转录(transcript,也称追踪或轨迹)是一次试验的完整记录,包括输出、工具调用、推理、中间结果以及任何其他交互。对于 Anthropic API,这就是评估运行结束时完整的 messages 数组——包含评估期间对 API 的所有调用和所有返回的响应。
- 结果(outcome)是试验结束时环境中的最终状态。订机票的智能体可能会在转录的结尾说“您的航班已预订”,但真正的结果是环境的 SQL 数据库中是否存在这条预订记录。
- 评估框架(evaluation harness)是端到端运行评估的基础设施。它提供指令和工具,并发运行任务,记录所有步骤,为输出评分,并汇总结果。
- 智能体框架(agent harness,或称 scaffold)是让模型能够作为智能体行动的系统:它处理输入、编排工具调用并返回结果。当我们评估“一个智能体”时,评估的是框架和模型协同工作的整体。例如,Claude Code 是一个灵活的智能体框架,我们通过 Agent SDK 使用它的核心原语构建了我们的长时间运行智能体框架。
- 评估套件(evaluation suite)是一组旨在衡量特定能力或行为的任务。套件中的任务通常共享一个宽泛的目标。例如,客户支持评估套件可能会测试退款、取消订单和升级处理。
为什么要构建评估?
团队刚开始构建智能体时,凭借手动测试、内部试用(dogfooding)和直觉,往往能走得出人意料地远。更严谨的评估甚至可能显得是拖慢发布的额外负担。但过了早期原型阶段,一旦智能体投入生产并开始规模化,没有评估的开发就会难以为继。
转折点往往出现在用户反馈智能体在改动后表现变差,而团队“盲飞”,除了猜测和试错外没有办法验证。没有评估,调试只能是被动的:等待投诉、手动复现、修复缺陷,然后祈祷没有其他地方出现回归。团队无法区分真正的回归与噪声,无法在发布前针对数百个场景自动测试改动,也无法衡量改进。
我们多次见证了这一演变过程。例如,Claude Code 起初基于 Anthropic 员工和外部用户的反馈快速迭代。后来我们加入了评估——先是针对简洁性、文件编辑等狭窄领域,再扩展到过度设计等更复杂的行为。这些评估帮助发现问题、指导改进,并让研究与产品的协作更有重点。结合生产监控、A/B 测试、用户研究等手段,评估为 Claude Code 在规模化过程中持续改进提供了信号。
在智能体生命周期的任何阶段编写评估都是有用的。在早期,评估迫使产品团队明确智能体的成功意味着什么;在后期,评估则帮助维持一致的质量标准。
Descript 的智能体帮助用户编辑视频,因此他们围绕成功的编辑工作流的三个维度构建了评估:不要搞砸,做我要求的,并且做好。他们从手动评分演进到使用由产品团队定义标准、并定期进行人工校准的 LLM 评分器,现在定期运行两套独立的套件,分别用于质量基准测试和回归测试。Bolt 的 AI 团队则在较晚的时候才开始构建评估,那时他们已经有了一个被广泛使用的智能体。他们在 3 个月内搭建了一套评估系统:运行其智能体并用静态分析为输出评分,用浏览器智能体测试应用,并用 LLM 评审来判断遵循指令等行为。
有些团队在开发之初就创建评估;另一些则在规模化之后,当评估成为改进智能体的瓶颈时才加入。在智能体开发之初,评估尤其有用,可以明确地固化预期行为。两位工程师阅读同一份初始规格,对 AI 应如何处理边界情况可能会得出不同的理解。评估套件可以消除这种歧义。无论何时创建,评估都有助于加速开发。
评估还决定了你采用新模型的速度。当更强大的模型发布时,没有评估的团队要花数周时间测试,而有评估的竞争对手能迅速判断模型的优势、调整提示词,并在几天内完成升级。
一旦有了评估,你就免费获得了基线和回归测试:延迟、token 用量、单任务成本和错误率都可以在固定的任务集上跟踪。评估还可以成为产品团队与研究团队之间带宽最高的沟通渠道,定义研究人员可以据以优化的指标。显然,评估的好处远不止跟踪回归和改进。由于成本是前期可见的,而收益是逐步累积的,它不断叠加的价值很容易被忽视。
如何评估 AI 智能体
如今大规模部署的常见智能体类型有好几种,包括编码智能体、研究智能体、计算机使用智能体和对话智能体。每种类型都可能部署在各种各样的行业中,但可以用相似的技术进行评估。你不需要从零开始发明评估。下面各节介绍了几类智能体经过验证的技术。请以这些方法为基础,再将其扩展到你的领域。
智能体的评分器类型
智能体评估通常结合三类评分器:基于代码的、基于模型的和人工的。每个评分器评估转录或结果的某一部分。有效评估设计的一个关键环节,是为任务选择合适的评分器。
基于代码的评分器
| 方法 | 优势 | 劣势 |
|---|---|---|
| • 字符串匹配检查(精确匹配、正则、模糊匹配等) • 二元测试(fail-to-pass、pass-to-pass) • 静态分析(lint、类型、安全) • 结果验证 • 工具调用验证(所用工具、参数) • 对话记录分析(轮次、token 用量) |
• 快速 • 低成本 • 客观 • 可复现 • 易于调试 • 验证特定条件 |
• 对不完全符合预期模式的合理变体过于脆弱 • 缺乏细腻度 • 难以评估一些较主观的任务 |
基于模型的评分器
| 方法 | 优势 | 劣势 |
|---|---|---|
| • 基于评分细则(rubric)打分 • 自然语言断言 • 两两比较 • 基于参考答案的评估 • 多评审共识 |
• 灵活 • 可扩展 • 能捕捉细微差别 • 能处理开放式任务 • 能处理自由格式的输出 |
• 非确定性 • 比代码评分更贵 • 需要与人工评分器校准以保证准确性 |
人工评分器
| 方法 | 优势 | 劣势 |
|---|---|---|
| • 领域专家(SME)评审 • 众包评判 • 抽样抽查 • A/B 测试 • 标注者间一致性 |
• 黄金标准级质量 • 与专家用户的判断一致 • 用于校准基于模型的评分器 |
• 昂贵 • 缓慢 • 通常需要大规模接触人类专家 |
对每个任务,评分方式可以是加权的(各评分器的综合得分须达到阈值)、二元的(所有评分器都必须通过),或两者混合。
能力评估与回归评估
能力评估(或称“质量”评估)要问的是:“这个智能体能把哪些事做好?”它们的初始通过率应当较低,针对智能体吃力的任务,给团队提供一座可以攀爬的“山坡”。
回归评估要问的是:“智能体是否仍能处理以前能完成的所有任务?”其通过率应接近 100%。它们用来防止倒退:分数下降就说明某处出了问题,需要修复。团队在能力评估上不断爬坡的同时,也必须运行回归评估,确保改动不会在别处引发问题。
智能体上线并优化之后,通过率很高的能力评估可以“毕业”,转为持续运行的回归测试集,用来发现任何漂移。过去衡量“我们到底能不能做到”的任务,如今衡量的是“我们还能不能稳定地做到”。
评估编程智能体
编程智能体负责编写、测试和调试代码,像人类开发者一样浏览代码库、运行命令。针对现代编程智能体的有效评估,通常依赖定义明确的任务、稳定的测试环境,以及对生成代码的全面测试。
确定性评分器天然适合编程智能体,因为软件通常很容易评估:代码能不能跑,测试能不能过?两个被广泛使用的编程智能体基准测试 SWE-bench Verified 和 Terminal-Bench 都采用了这种方式。SWE-bench Verified 向智能体提供来自热门 Python 仓库的 GitHub issue,并通过运行测试套件来给方案评分;只有在修复了失败的测试且没有破坏已有测试时,方案才算通过。在这项评估上,大语言模型(LLM)仅用一年时间就从 40% 提升到了 >80%。Terminal-Bench 则另辟蹊径:它测试端到端的技术任务,例如从源码编译 Linux 内核,或训练一个机器学习模型。
一旦有了一组通过/失败测试来验证编程任务的关键结果,通常也值得对对话记录(transcript)进行评分。例如,基于启发式的代码质量规则可以在“测试是否通过”之外评估生成的代码,而带有清晰评分细则的基于模型的评分器,则可以评估智能体如何调用工具、如何与用户交互等行为。
示例:编程智能体的理论评估
设想一个编程任务:智能体需要修复一个身份验证绕过漏洞。如下方示意性的 YAML 文件所示,可以同时使用评分器和指标来评估这个智能体。
task:
  id: "fix-auth-bypass_1"
  desc: "Fix authentication bypass when password field is empty and ..."
  graders:
    - type: deterministic_tests
      required: [test_empty_pw_rejected.py, test_null_pw_rejected.py]
    - type: llm_rubric
      rubric: prompts/code_quality.md
    - type: static_analysis
      commands: [ruff, mypy, bandit]
    - type: state_check
      expect:
        security_logs: {event_type: "auth_blocked"}
    - type: tool_calls
      required:
        - {tool: read_file, params: {path: "src/auth/*"}}
        - {tool: edit_file}
        - {tool: run_tests}
  tracked_metrics:
    - type: transcript
      metrics:
        - n_turns
        - n_toolcalls
        - n_total_tokens
    - type: latency
      metrics:
        - time_to_first_token
        - output_tokens_per_sec
        - time_to_last_token
请注意,这个示例是为了演示而展示了全部可用的评分器类型。在实际中,编程评估通常依靠单元测试来验证正确性,并用 LLM 评分细则评估整体代码质量,只在必要时才增加其他评分器和指标。
评估对话智能体
对话智能体在客服、销售或教练等领域与用户交互。与传统聊天机器人不同,它们会保持状态、使用工具,并在对话进行中采取行动。编程和研究智能体同样可能与用户进行多轮交互,但对话智能体带来了一个独特的挑战:交互本身的质量就是评估对象的一部分。针对对话智能体的有效评估,通常依赖可验证的最终状态结果,以及同时涵盖任务完成度和交互质量的评分细则。与大多数其他评估不同,它们往往需要第二个 LLM 来模拟用户。我们在对齐审计智能体中就采用了这种方法,通过长时间的对抗式对话对模型进行压力测试。
对话智能体的成功可以是多维度的:工单是否已解决(状态检查)、是否在 <10 轮内完成(对话记录约束)、语气是否恰当(LLM 评分细则)?包含这种多维性的两个基准测试是 𝜏-Bench 及其后继者 τ2-Bench。它们模拟零售客服、机票预订等领域的多轮交互,由一个模型扮演用户角色,智能体则在贴近现实的场景中应对。
示例:对话智能体的理论评估
设想一个客服任务:智能体需要为一位心情沮丧的客户处理退款。
graders:
  - type: llm_rubric
    rubric: prompts/support_quality.md
    assertions:
      - "Agent showed empathy for customer's frustration"
      - "Resolution was clearly explained"
      - "Agent's response grounded in fetch_policy tool results"
  - type: state_check
    expect:
      tickets: {status: resolved}
      refunds: {status: processed}
  - type: tool_calls
    required:
      - {tool: verify_identity}
      - {tool: process_refund, params: {amount: "<=100"}}
      - {tool: send_confirmation}
  - type: transcript
    max_turns: 10
tracked_metrics:
  - type: transcript
    metrics:
      - n_turns
      - n_toolcalls
      - n_total_tokens
  - type: latency
    metrics:
      - time_to_first_token
      - output_tokens_per_sec
      - time_to_last_token
与前面的编程智能体示例一样,这个任务也是为了演示而展示了多种评分器类型。在实际中,对话智能体的评估通常使用基于模型的评分器,同时评估沟通质量和目标完成情况,因为许多任务(比如回答问题)可能有多个“正确”答案。
评估研究智能体
研究智能体负责收集、综合和分析信息,然后产出答案或报告等结果。编程智能体可以靠单元测试给出二元的通过/失败信号,研究智能体则不同,研究质量只能相对于任务来判断。什么算“全面”、“来源可靠”,甚至什么算“正确”,都取决于具体情境:市场扫描、并购尽职调查和科学报告,各自需要不同的标准。
研究类评估面临独特的挑战:专家可能对某份综合报告是否全面存在分歧;随着参考内容不断变化,基准真值(ground truth)也会随之漂移;而更长、更开放的输出则为出错留下了更多空间。例如,BrowseComp 这样的基准测试检验的是 AI 智能体能否在开放网络中“大海捞针”——这类问题被设计成易于验证、但很难解答。
构建研究智能体评估的一种策略是组合多种评分器。依据性(groundedness)检查验证论断是否有检索到的来源支撑;覆盖度检查定义一个好答案必须包含的关键事实;来源质量检查确认所参考的来源是权威的,而不只是最先检索到的。对于有客观正确答案的任务(“X 公司第三季度的营收是多少?”),精确匹配就够用。LLM 既可以标出缺乏依据的论断和覆盖上的缺口,也可以核查开放式综合内容是否连贯、完整。
鉴于研究质量具有主观性,基于 LLM 的评分细则应经常与人类专家的判断进行校准,才能有效地为这类智能体评分。
计算机操作智能体
计算机操作智能体(computer use agents)通过与人类相同的界面与软件交互——屏幕截图、鼠标点击、键盘输入和滚动——而不是通过 API 或代码执行。它们可以使用任何带图形用户界面(GUI)的应用,从设计工具到老旧的企业软件。评估需要让智能体在真实或沙箱环境中运行,让它使用软件应用,并检查它是否达成了预期结果。例如,WebArena 测试基于浏览器的任务,用 URL 和页面状态检查来验证智能体导航是否正确,对修改数据的任务还要做后端状态验证(确认订单确实已下单,而不仅仅是出现了确认页面)。OSWorld 将其扩展到完整的操作系统控制,其评估脚本会在任务完成后检查多种产物:文件系统状态、应用配置、数据库内容和 UI 元素属性。
浏览器操作智能体需要在 token 效率和延迟之间取得平衡。基于 DOM 的交互执行很快,但消耗大量 token;基于截图的交互较慢,但更省 token。例如,让 Claude 总结一篇维基百科文章时,从 DOM 中提取文本更高效;而在亚马逊上寻找一款新的笔记本电脑保护套时,截图更高效(因为提取整个 DOM 会消耗大量 token)。在我们的 Claude for Chrome 产品中,我们开发了评估来检查智能体是否针对每种情境选对了工具。这让我们能够更快、更准确地完成基于浏览器的任务。
如何看待智能体评估中的非确定性
无论是哪种类型的智能体,其行为在不同运行之间都会有所变化,这使得评估结果比乍看上去更难解读。每个任务都有各自的成功率——也许一个任务是 90%,另一个是 50%——而在一次评估运行中通过的任务,下一次可能就失败了。有时,我们想衡量的正是智能体在某个任务上多常(即多大比例的试验)能够成功。
有两个指标可以帮助捕捉这种细微差别:
pass@k 衡量智能体在 k 次尝试中至少得到一个正确解的可能性。随着 k 增大,pass@k 分数会上升:“射门”次数越多,至少成功一次的几率越高。pass@1 为 50% 意味着模型第一次尝试就能完成评估中一半的任务。在编程场景中,我们往往最关心智能体能否一次就找到解法——也就是 pass@1。在其他场景中,只要有一个方案可行,提出许多方案也是可以接受的。
pass^k 衡量全部 k 次试验都成功的概率。随着 k 增大,pass^k 会下降,因为要求更多次试验都保持一致,门槛更高。如果你的智能体单次试验成功率为 75%,并运行 3 次试验,那么三次全部通过的概率是 (0.75)³ ≈ 42%。这个指标对面向客户的智能体尤其重要,因为用户期望它每一次都表现可靠。
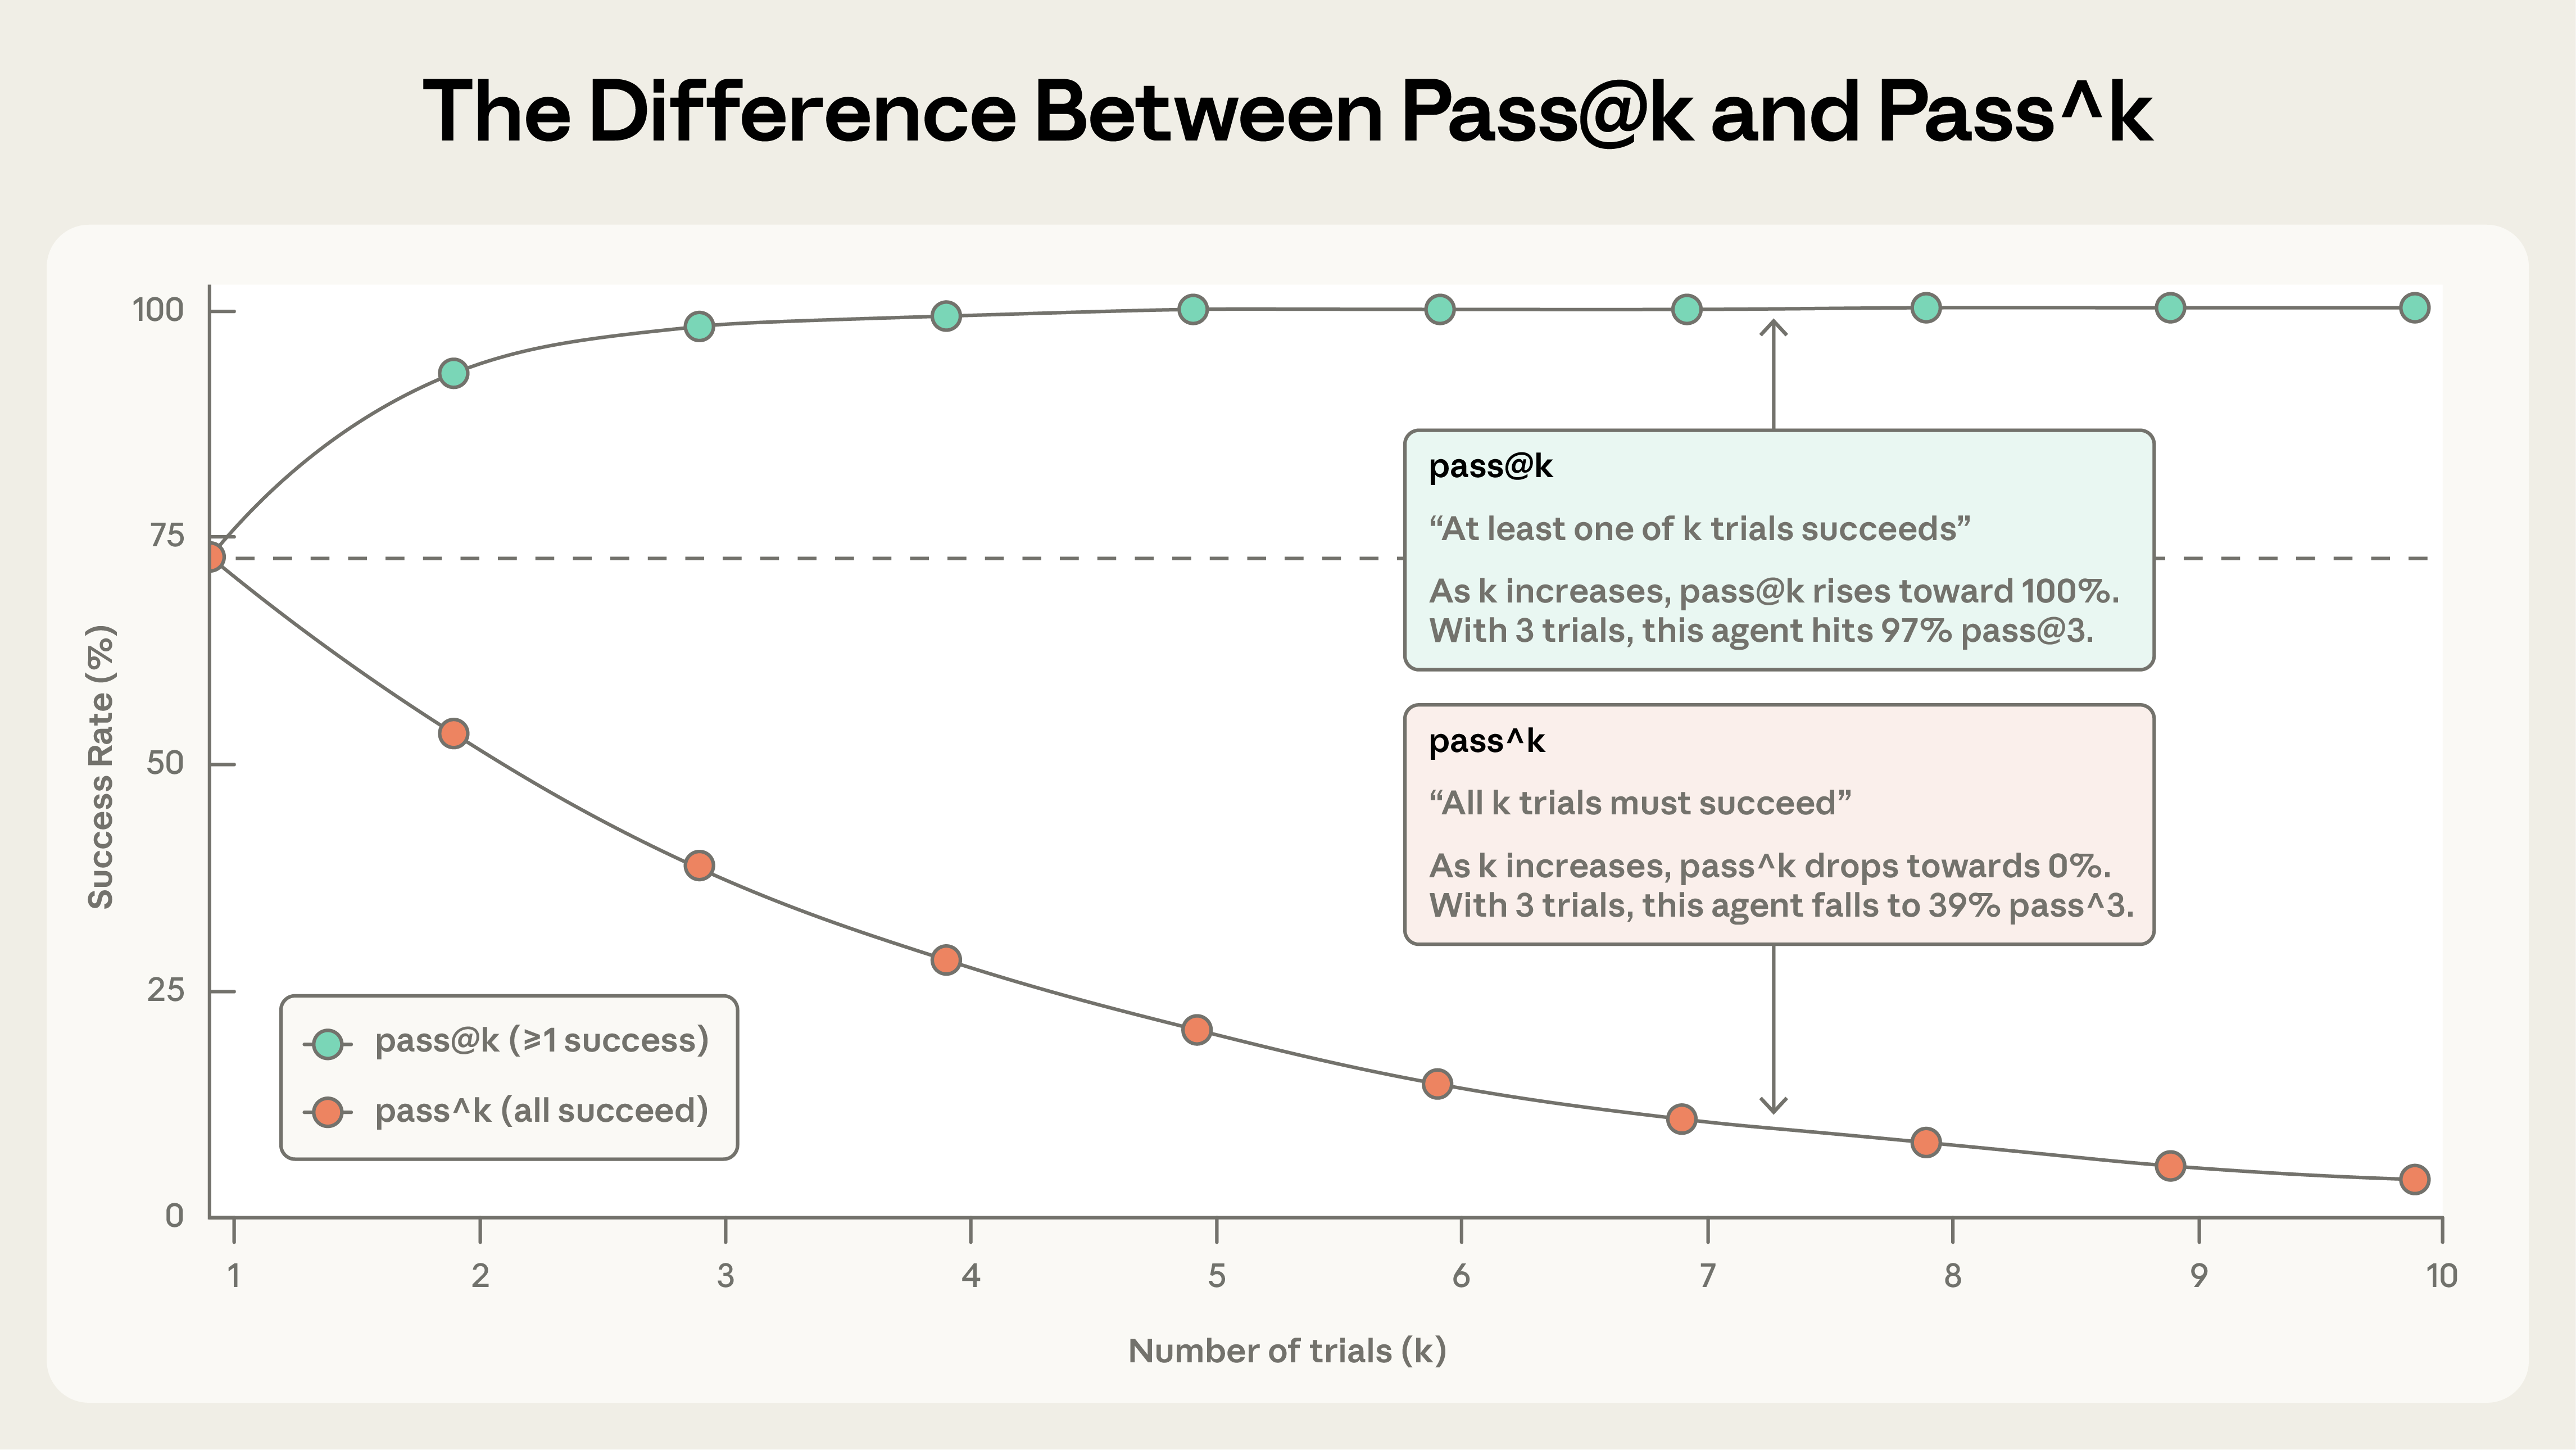
两个指标都有用,具体用哪个取决于产品需求:对于只要成功一次就行的工具,用 pass@k;对于一致性至关重要的智能体,用 pass^k。
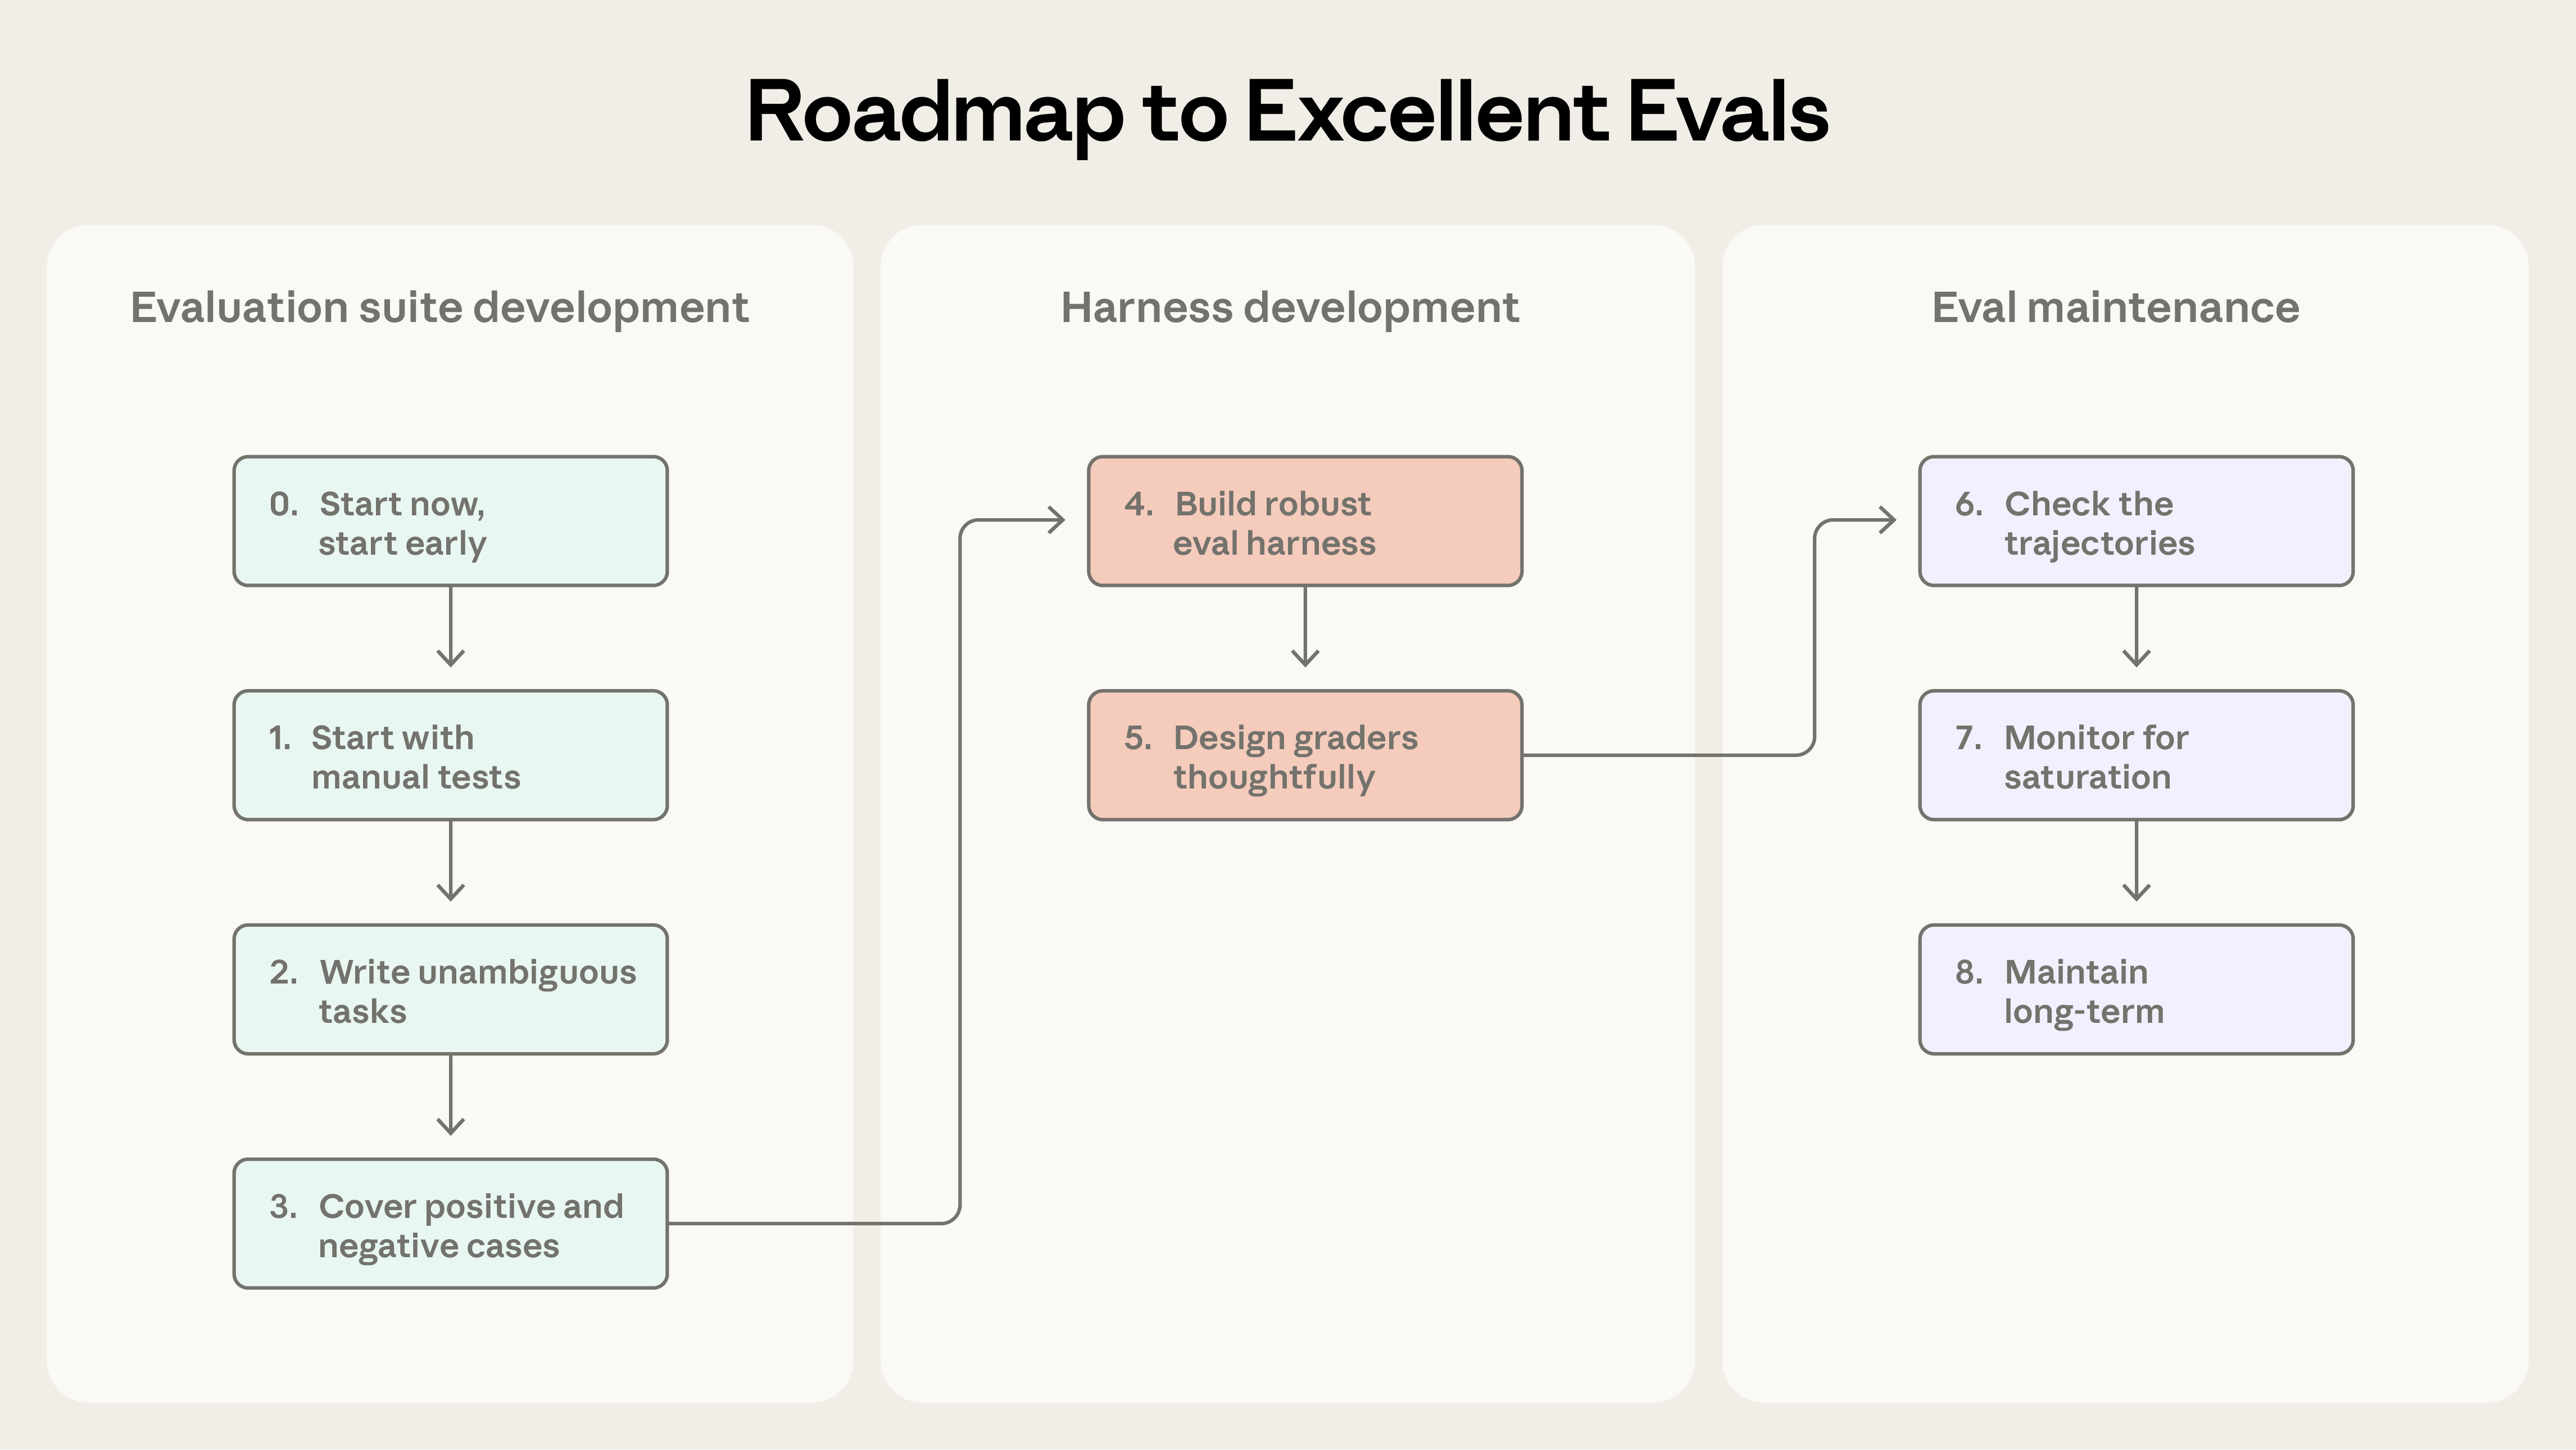
从零到一:构建出色智能体评估的路线图
本节给出我们经过实战检验的实用建议,帮助你从没有评估走到拥有值得信赖的评估。可以把它看作评估驱动的智能体开发路线图:尽早定义成功,清晰地衡量它,并持续迭代。
为初始评估数据集收集任务
第 0 步:尽早开始
我们看到一些团队因为觉得需要数百个任务而迟迟不开始构建评估。实际上,从真实失败案例中提炼出 20 到 50 个简单任务,就是一个很好的起点。毕竟在智能体开发早期,对系统的每次改动往往都有清晰、显著的影响,这种大效应量意味着小样本就足够了。更成熟的智能体可能需要更大、更难的评估来检测较小的效果,但一开始最好采取 80/20 的做法。评估拖得越久就越难建。早期,产品需求自然可以转化为测试用例;等得太久,你就只能从一个线上系统里反推成功标准。
第 1 步:从你已在手动测试的内容入手
从开发过程中你已在做的手动检查开始——每次发布前验证的行为,以及终端用户常做的任务。如果已经上线,就去看缺陷跟踪系统和客服工单队列。把用户反馈的故障转化为测试用例,能确保你的测试集反映真实使用情况;按对用户的影响程度排序,则有助于把精力投入到最关键的地方。
第 2 步:编写无歧义的任务,并配上参考解
把任务质量做好,比看上去要难。一个好任务应该满足:两位领域专家独立判断,会得出相同的通过/失败结论。他们自己能完成这个任务吗?如果不能,任务就需要打磨。任务规范中的歧义会变成指标中的噪声。基于模型的评分器的评判标准也是如此:含糊的评分细则会产生不一致的判断。
每个任务都应当能被正确遵循指令的智能体通过。这一点可能很微妙。例如,对 Terminal-Bench 的审查发现:如果任务要求智能体编写一个脚本,却没有指定文件路径,而测试又假定了某个特定的脚本路径,智能体就可能因为与自身无关的原因而失败。评分器检查的所有内容,都应该能从任务描述中明确得知;智能体不应因为规范含糊而失败。对于前沿模型,在多次试验中通过率为 0%(即 pass@100 为 0%),往往说明任务本身有问题,而不是智能体无能,这时应当仔细复查任务规范和评分器。对每个任务,建议创建一个参考解:一个已知可行、能通过所有评分器的输出。这既证明任务是可解的,也验证了评分器配置正确。
第 3 步:构建均衡的问题集
既要测试行为应该出现的情形,也要测试不应该出现的情形。单边的评估会导致单边的优化。例如,如果你只测试智能体在该搜索时是否搜索,最终可能得到一个几乎什么都要搜索的智能体。尽量避免类别不平衡的评估。我们在为 Claude.ai 的网页搜索构建评估时就亲身体会到了这一点。当时的挑战是,既要防止模型在不该搜索时去搜索,又要保留它在适当时进行深入研究的能力。团队构建了覆盖两个方向的评估:模型应该搜索的查询(比如查天气),以及应该凭已有知识回答的查询(比如“苹果公司是谁创办的?”)。在欠触发(该搜索时不搜索)与过触发(不该搜索时搜索)之间找到恰当的平衡很困难,对提示词和评估都经过了很多轮改进。随着出现更多示例问题,我们会继续向评估中补充,以提高覆盖面。
设计评估框架(harness)与评分器
第 4 步:构建稳健的评估框架,并保证环境稳定
关键在于,评估中的智能体要与生产环境中使用的智能体大致一致,并且环境本身不能引入额外的噪声。每次试验都应当从干净的环境开始,实现“隔离”。运行之间不必要的共享状态(残留文件、缓存数据、资源耗尽)会因基础设施的不稳定而不是智能体的表现,造成相关联的失败。共享状态还可能人为抬高表现。例如,在一些内部评估中,我们观察到 Claude 通过查看之前试验留下的 git 历史,在某些任务上获得了不公平的优势。如果多个不同的试验都因环境中的同一限制(比如 CPU 内存有限)而失败,那么这些试验并不独立,因为它们受同一因素影响,评估结果也就无法可靠地衡量智能体表现。
第 5 步:审慎设计评分器
如前所述,出色的评估设计需要为智能体和任务选择最合适的评分器。我们建议尽可能使用确定性评分器,在必要时或需要额外灵活性时使用 LLM 评分器,并审慎地使用人工评分器做进一步验证。
人们有一种常见的本能,就是检查智能体是否遵循了非常具体的步骤,比如按正确顺序进行的一系列工具调用。我们发现这种做法过于僵化,会导致测试过于脆弱,因为智能体经常会找到评估设计者没有预料到的有效途径。为了避免不必要地惩罚创造力,通常更好的做法是评判智能体产出了什么,而不是它走了哪条路。
对于包含多个组成部分的任务,要设置部分得分。一个客服智能体如果正确识别了问题并验证了客户身份,但没能完成退款,显然比一开始就失败的要好。在结果中体现这种成功的连续谱很重要。
模型评分往往需要仔细迭代才能验证其准确性。LLM 作为评审(LLM-as-judge)的评分器应当与人类专家紧密校准,以确信人工评分与模型评分之间的差异很小。为避免幻觉,要给 LLM 留一条退路,比如指示它在信息不足时返回“Unknown”。另外,为任务的每个维度制定清晰、结构化的评分细则,并用各自独立的 LLM 评审分别给每个维度打分,而不是用一个评审给所有维度打分,也会有帮助。一旦系统足够稳健,只需偶尔进行人工审查即可。
有些评估存在隐蔽的失效模式,即使智能体表现良好也会得到低分,因为智能体是由于评分缺陷、智能体框架的限制或任务歧义而没能解决任务。即便是经验丰富的团队,也可能忽略这些问题。例如,Opus 4.5 在 CORE-Bench 上最初只得了 42%,直到一位 Anthropic 研究员发现了多个问题:评分过于死板,当期望答案是“96.124991…”时会判“96.12”不合格;任务规范含糊;还有一些随机性任务根本无法精确复现。修复这些缺陷并改用约束更少的脚手架之后,Opus 4.5 的得分跃升至 95%。同样,METR 发现其时间跨度基准测试中有若干任务配置有误:任务要求智能体优化到某个给定的分数阈值,但评分却要求超过该阈值。这使得 Claude 等遵循指令的模型受到惩罚,而无视既定目标的模型反而得分更高。仔细复核任务和评分器,有助于避免这类问题。
让你的评分器能够抵御绕过和作弊。智能体不应该能轻易地对评估“作弊”。任务和评分器的设计应当保证:只有真正解决问题才能通过,而不是靠钻非预期的漏洞。
长期维护和使用评估
第 6 步:检查对话记录
除非你阅读许多次试验的对话记录和评分,否则无从知道评分器是否运作良好。在 Anthropic,我们投入开发了查看评估对话记录的工具,并且定期花时间阅读它们。当一个任务失败时,对话记录会告诉你,是智能体真的犯了错,还是你的评分器拒绝了一个有效的解法。它也常常能揭示关于智能体和评估行为的关键细节。
失败应当看上去是公平的:智能体错在哪里、为什么错,都很清楚。当分数不再上升时,我们需要确信这是由于智能体的表现,而不是评估本身的问题。阅读对话记录是验证评估是否在衡量真正重要之事的方式,也是智能体开发的一项关键技能。
第 7 步:监控能力评估的饱和
通过率达到 100% 的评估可以追踪回归,却无法再提供改进的信号。评估饱和是指智能体通过了所有可解的任务,再没有提升空间。例如,SWE-Bench Verified 的分数今年起步于 30%,而前沿模型如今已接近饱和,>80%。当评估接近饱和时,进展也会放缓,因为只剩下最难的任务。这会让结果具有欺骗性:能力上的大幅提升,只表现为分数的小幅增长。例如,代码审查初创公司 Qodo 起初对 Opus 4.5 并不感冒,因为他们的一次性(one-shot)编程评估没能体现模型在更长、更复杂任务上的进步。对此,他们开发了新的智能体化评估框架,从而更清楚地看到了进展。
作为原则,在有人深入研究评估的细节并阅读了一些对话记录之前,我们不会轻信评估分数。如果评分不公平、任务含糊、有效解法被惩罚,或者评估框架限制了模型,这个评估就应该修订。
第 8 步:通过开放贡献与维护,让评估套件长期保持健康
评估套件是一件“活的”产物,需要持续关注和明确的归属,才能保持有用。
在 Anthropic,我们尝试过多种评估维护方式。最有效的做法是设立专门的评估团队负责核心基础设施,而领域专家和产品团队贡献大部分评估任务,并自己运行评估。
对 AI 产品团队来说,负责并迭代评估应当像维护单元测试一样成为日常工作。团队可能在 AI 功能上白白浪费数周:这些功能在早期测试中“能用”,却达不到那些未明说的期望,而一个设计良好的评估本可以早早将这些期望暴露出来。定义评估任务,是检验产品需求是否具体到可以动手构建的最佳方式之一。
我们建议实践评估驱动开发:在智能体能够满足之前,先构建评估来定义计划中的能力,然后迭代,直到智能体表现良好。在内部,我们经常构建一些今天“够用”、但实际上是在押注几个月后模型能力的功能。起始通过率较低的能力评估能让这一点显现出来。当新模型发布时,运行这套评估很快就能看出哪些押注押对了。
最贴近产品需求和用户的人,最适合定义什么是成功。借助当前的模型能力,产品经理、客户成功经理或销售人员都可以使用 Claude Code,以 PR 的形式贡献评估任务——让他们去做!或者,更好的是,积极地支持他们。
评估如何与其他方法配合,以全面理解智能体
自动化评估可以在数千个任务上对智能体运行,而无需部署到生产环境,也不会影响真实用户。但这只是理解智能体表现的众多方式之一。完整的图景还包括生产环境监控、用户反馈、A/B 测试、人工查看对话记录,以及系统化的人工评估。
理解 AI 智能体表现的各种方法概览
| 方法 | 优点 | 缺点 |
|---|---|---|
| 自动化评估在没有真实用户的情况下以程序方式运行测试 | • 迭代更快 • 完全可复现 • 不影响用户 • 可以在每次提交时运行 • 无需部署到生产环境即可大规模测试各种场景 |
• 需要更多前期投入来构建 • 需要随产品和模型的演进持续维护,以避免漂移 • 如果与真实使用模式不符,可能造成虚假的信心 |
| 生产环境监控追踪线上系统中的指标和错误 | • 大规模揭示真实用户行为 • 能发现合成评估遗漏的问题 • 提供智能体实际表现的基准真值 |
• 属于被动响应;问题在你察觉之前就已触及用户 • 信号可能有噪声 • 需要投入建设埋点监测 • 缺少用于评分的基准真值 |
| A/B 测试用真实用户流量比较不同变体 | • 衡量真实的用户结果(留存、任务完成) • 可控制混杂因素 • 可扩展且系统化 |
• 速度慢;需要数天或数周才能达到显著性,且需要足够的流量 • 只能测试你已部署的改动 • 若无法深入查看对话记录,则对指标变化背后“为什么”的信号较少 |
| 用户反馈踩、缺陷报告等明确的信号 | • 能暴露你没有预料到的问题 • 附带来自真实用户的实际案例 • 反馈往往与产品目标相关 |
• 稀少且存在自选择偏差 • 偏向严重问题 • 用户很少解释某件事为什么失败 • 无法自动化 • 主要依靠用户来发现问题,可能对用户造成负面影响 |
| 人工查看对话记录由人通读智能体的对话 | • 培养对失效模式的直觉 • 能发现自动化检查遗漏的细微质量问题 • 帮助校准“好”的标准,并把握细节 |
• 耗时 • 无法规模化 • 覆盖不一致 • 审阅者疲劳或审阅者不同,都会影响信号质量 • 通常只给出定性信号,而非清晰的定量评分 |
| 系统化人工研究由受过训练的评分员对智能体输出进行结构化评分 | • 来自多位人工评分员的黄金标准级质量判断 • 能处理主观或含糊的任务 • 为改进基于模型的评分器提供信号 |
• 相对昂贵,周转缓慢 • 难以频繁运行 • 评分员之间的分歧需要调和 • 复杂领域(法律、金融、医疗)需要人类专家来开展研究 |
这些方法对应智能体开发的不同阶段。自动化评估在上线前和 CI/CD 中尤其有用,在每次智能体变更和模型升级时运行,是抵御质量问题的第一道防线。生产环境监控在上线后发挥作用,用来发现分布漂移和意料之外的真实世界故障。A/B 测试在流量充足后用于验证重大改动。用户反馈和对话记录审查则是持续进行的实践,用来填补空白:持续分诊反馈,每周抽样阅读对话记录,并按需深入挖掘。系统化的人工研究则留给校准 LLM 评分器,或评估以人类共识作为参考标准的主观输出。
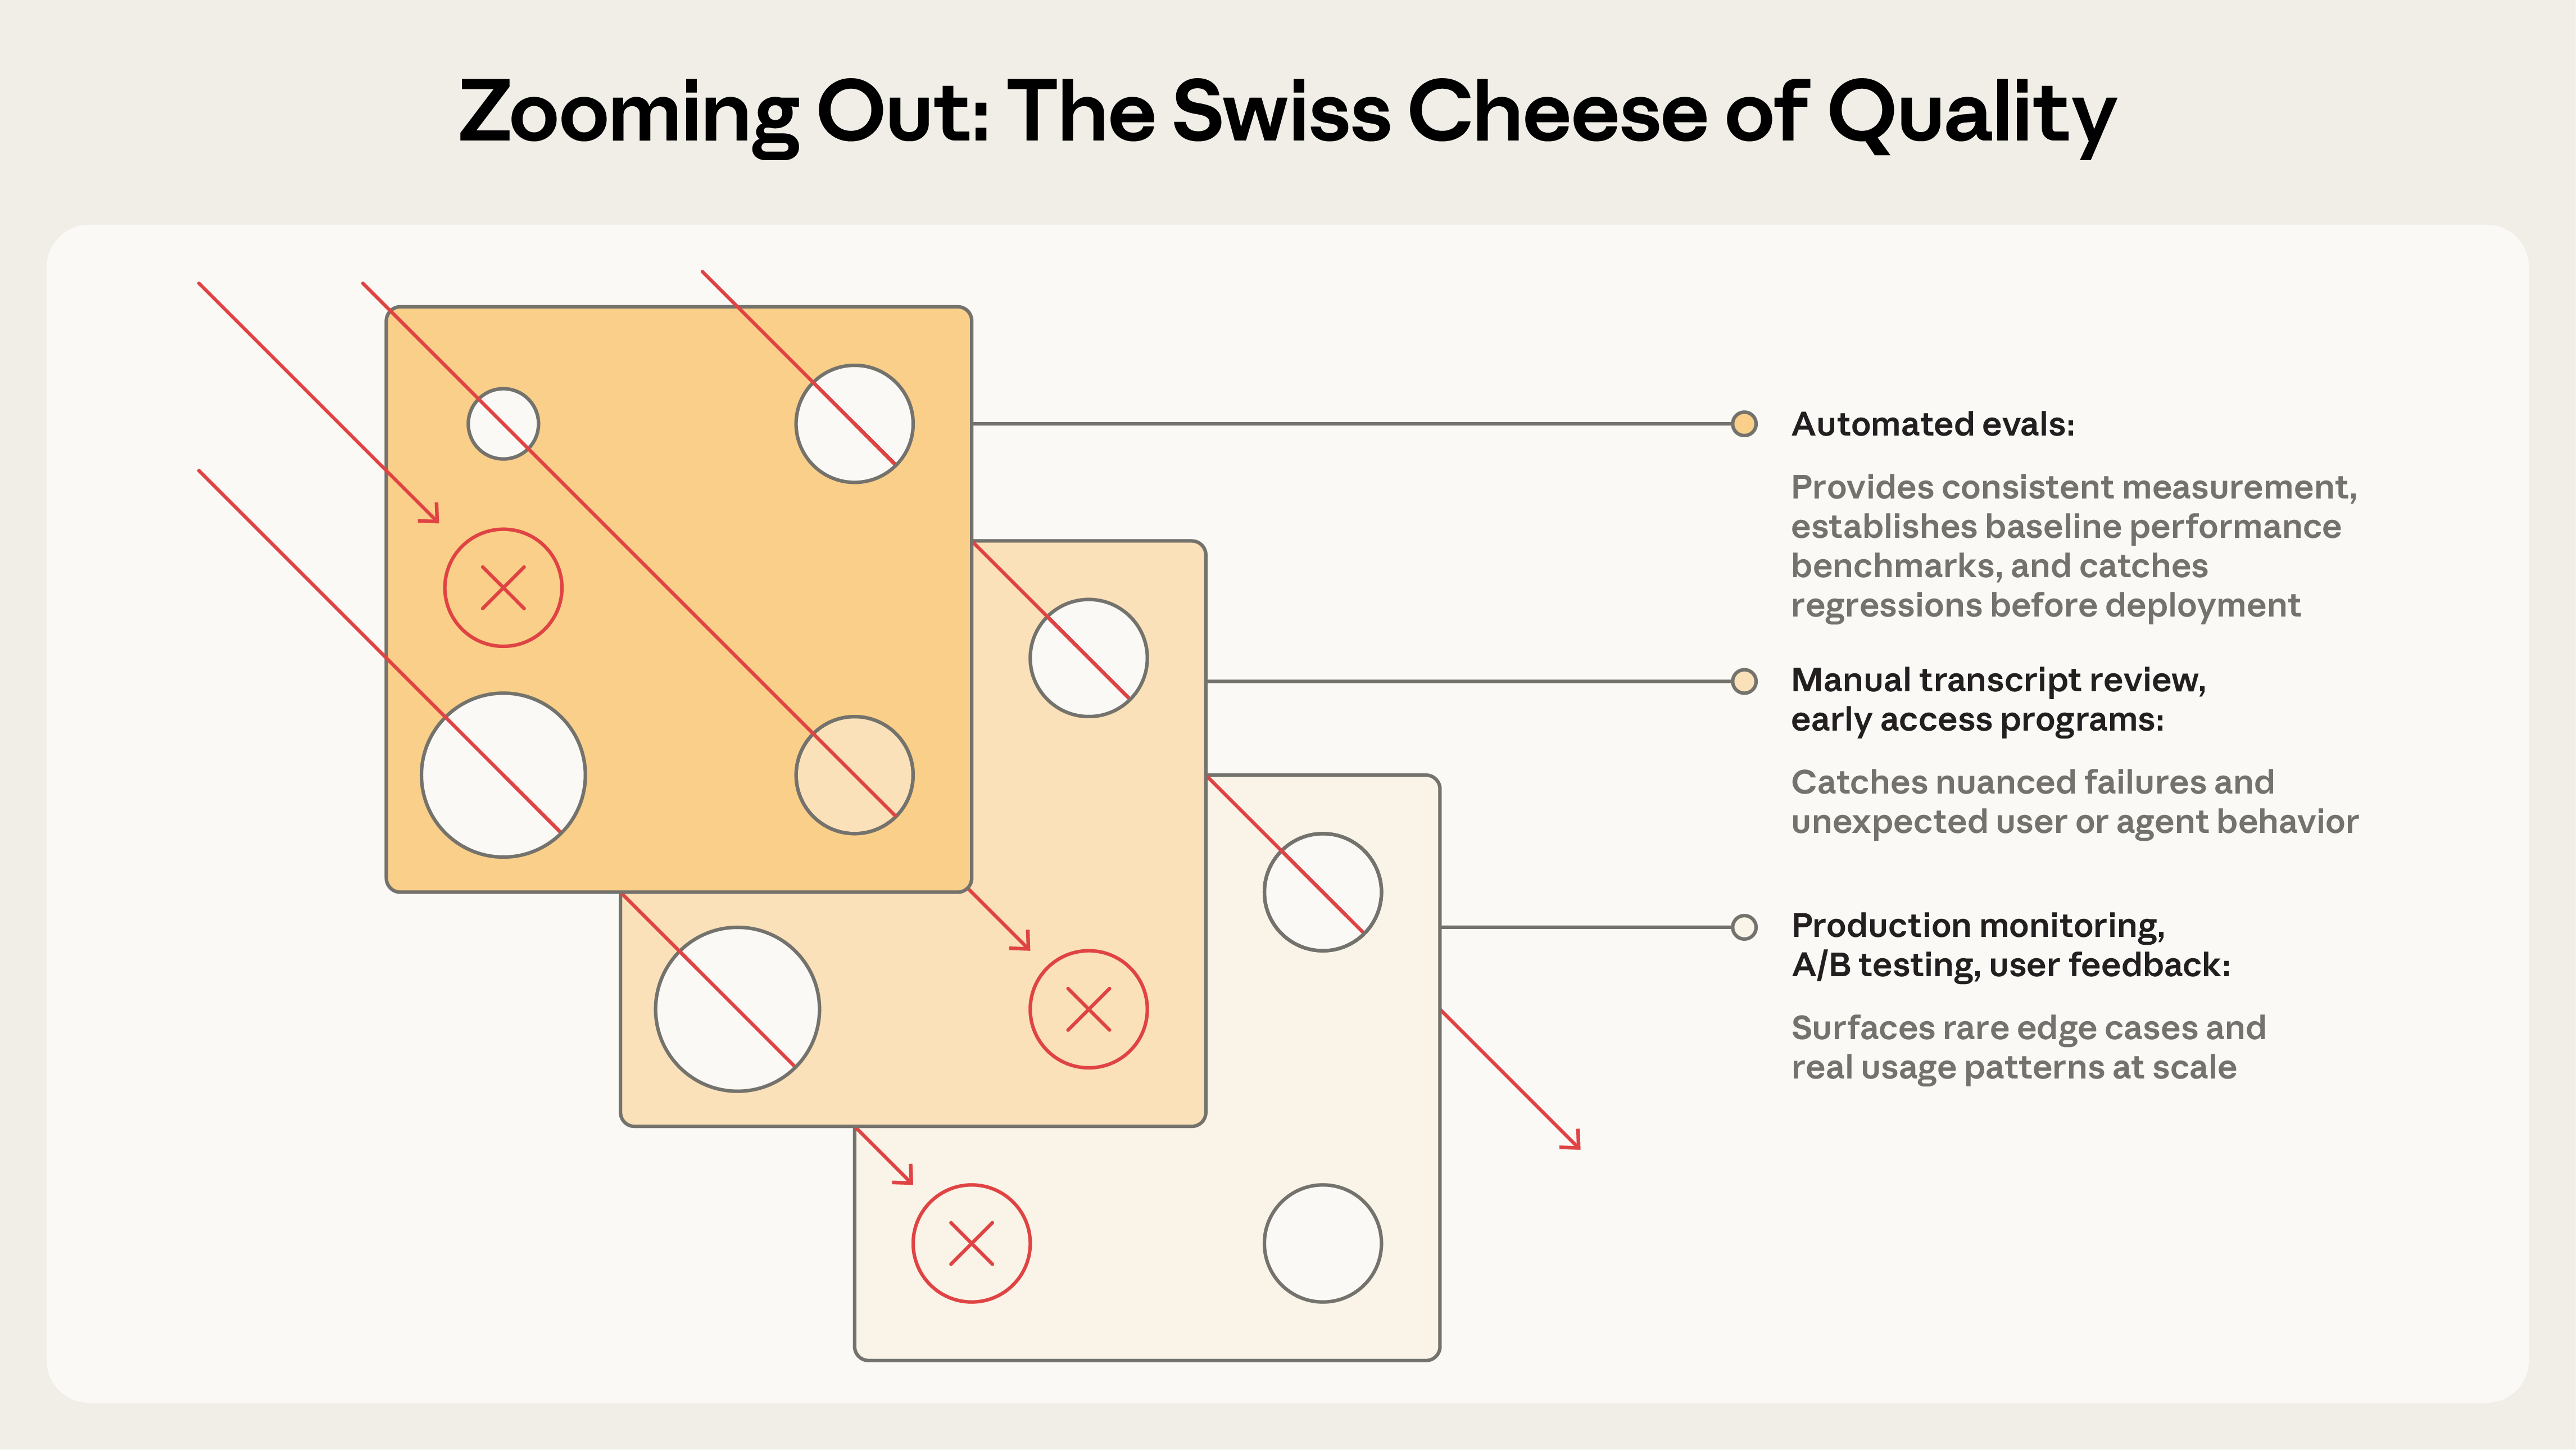
最有效的团队会把这些方法结合起来:用自动化评估实现快速迭代,用生产环境监控获取基准真值,用定期的人工审查进行校准。
结语
没有评估的团队会陷入被动应对的循环——修好一个故障,又冒出另一个,分不清真正的回归与噪声。尽早投入的团队则发现情况恰好相反:随着故障变成测试用例、测试用例防止回归、指标取代猜测,开发反而加速了。评估为整个团队提供了一座清晰的“山坡”可以攀爬,把“感觉智能体变差了”变成可以采取行动的事情。其价值会不断累积,但前提是把评估当作核心组成部分,而不是事后补上的东西。
不同类型的智能体,模式各有差异,但这里描述的基本原则始终不变。尽早开始,不要等待完美的测试集。从你见到的故障中提取贴近现实的任务。定义无歧义且稳健的成功标准。审慎设计评分器,并组合多种类型。确保问题对模型来说足够难。持续迭代评估,以提高其信噪比。多读对话记录!
AI 智能体评估仍是一个新兴且快速演进的领域。随着智能体承担更长的任务、在多智能体系统中协作,并处理越来越主观的工作,我们需要调整自己的方法。随着认识的加深,我们会继续分享最佳实践。
致谢
本文由 Mikaela Grace、Jeremy Hadfield、Rodrigo Olivares 和 Jiri De Jonghe 撰写。我们还要感谢 David Hershey、Gian Segato、Mike Merrill、Alex Shaw、Nicholas Carlini、Ethan Dixon、Pedram Navid、Jake Eaton、Alyssa Baum、Lina Tawfik、Karen Zhou、Alexander Bricken、Sam Kennedy、Robert Ying 等人的贡献。特别感谢在评估合作中让我们受益良多的客户和合作伙伴,包括 iGent、Cognition、Bolt、Sierra、Vals.ai、Macroscope、PromptLayer、Stripe、Shopify、Terminal Bench 团队等。这项工作凝聚了多个团队的共同努力,他们帮助在 Anthropic 形成了评估实践。
附录:评估框架
若干开源和商业框架可以帮助团队实施智能体评估,而无需从零搭建基础设施。如何选择,取决于你的智能体类型、现有技术栈,以及你需要的是离线评估、生产环境可观测性,还是两者兼有。
Harbor 专为在容器化环境中运行智能体而设计,提供跨云服务商大规模运行试验的基础设施,以及用于定义任务和评分器的标准化格式。Terminal-Bench 2.0 等热门基准测试通过 Harbor 注册表发布,因此可以很方便地运行成熟的基准测试以及自定义评估套件。
Braintrust 是一个将离线评估与生产环境可观测性和实验跟踪结合起来的平台——适合既要在开发期间迭代、又要在生产中监控质量的团队。它的 `autoevals` 库内置了针对事实性、相关性及其他常见维度的评分器。
LangSmith 提供追踪、离线与在线评估以及数据集管理,并与 LangChain 生态系统紧密集成。Langfuse 提供类似的能力,是适合有数据驻留要求的团队的自托管开源替代方案。
Arize 提供 Phoenix(一个用于 LLM 追踪、调试以及离线或在线评估的开源平台)和 AX(一款在 Phoenix 基础上扩展、面向规模化、优化与监控的 SaaS 产品)。
许多团队会组合使用多种工具、自己搭建评估框架,或者一开始只用简单的评估脚本。我们发现,框架固然是加快进展和实现标准化的有效途径,但它们的价值取决于你放进去运行的评估任务。通常最好的做法是迅速选定一个适合自己工作流的框架,然后把精力投入到评估本身,不断打磨高质量的测试用例和评分器。