在过去 30 天里,Cloudflare 研发组织中有 93% 的人使用了由我们在自家平台上构建的基础设施所驱动的 AI 编码工具。
十一个月前,我们启动了一个大项目:把 AI 真正融入我们的工程栈。我们需要构建内部的 MCP 服务器、接入层和 AI 工具,让智能体在 Cloudflare 内部真正派上用场。我们从全公司抽调工程师,组建了一个名为 iMARS(Internal MCP Agent/Server Rollout Squad,内部 MCP 智能体/服务器推广小组)的攻坚小组。后续的持续工作落在了 Dev Productivity 团队身上,该团队还负责我们大量的内部工具,包括 CI/CD、构建系统和自动化。
以下数字反映了过去 30 天我们自身使用智能体 AI 的情况:
- 3,683 名内部用户在积极使用 AI 编码工具(占全公司的 60%,占研发组织的 93%),公司总员工约 6,100 人
- 4,795 万次 AI 请求
- 295 个团队目前在使用智能体 AI 工具和编码助手。
- 每月 2,018 万次 AI Gateway 请求
- 2,413.7 亿个 token 经 AI Gateway 路由
- Workers AI 处理了 518.3 亿个 token
对内部开发速度的影响显而易见:我们从未见过合并请求数量在季度之间有如此幅度的增长。
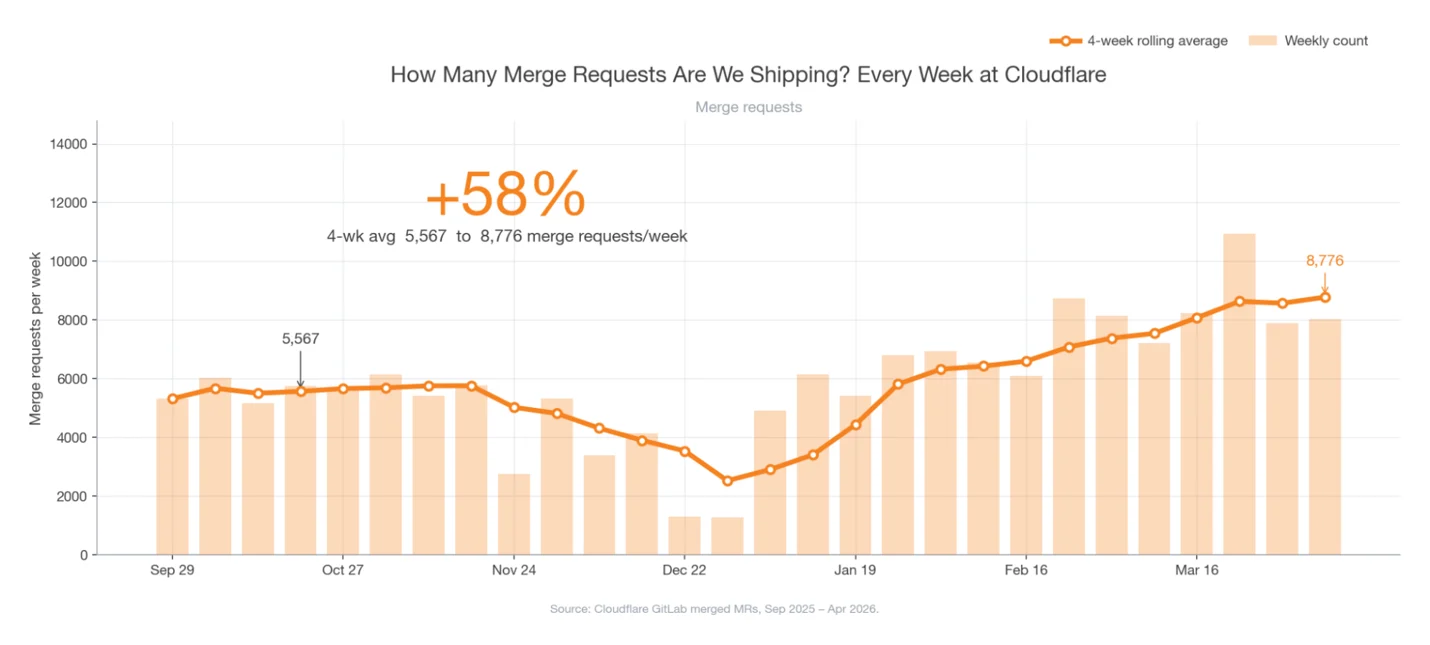
随着 AI 工具的采用不断增加,4 周滚动平均值已从每周约 5,600 个攀升至 8,700 多个。3 月 23 日当周达到 10,952 个,几乎是第四季度基线的两倍。
MCP 服务器是起点,但团队很快意识到我们需要走得更远:重新思考标准如何固化为规范、代码如何评审、工程师如何入职上手,以及变更如何在数千个代码仓库间传播。
本文将深入讲述过去十一个月里这一切是什么样子,以及我们最终走到了哪一步。我们选在现在发布,为 Agents Week 收尾,因为我们内部构建的 AI 工程栈,运行在我们本周发布和增强的同一批产品之上。
The architecture at a glance
面向工程师的工具层(OpenCode、Windsurf 以及其他兼容 MCP 的客户端)既包括开源的编码助手工具,也包括第三方的。
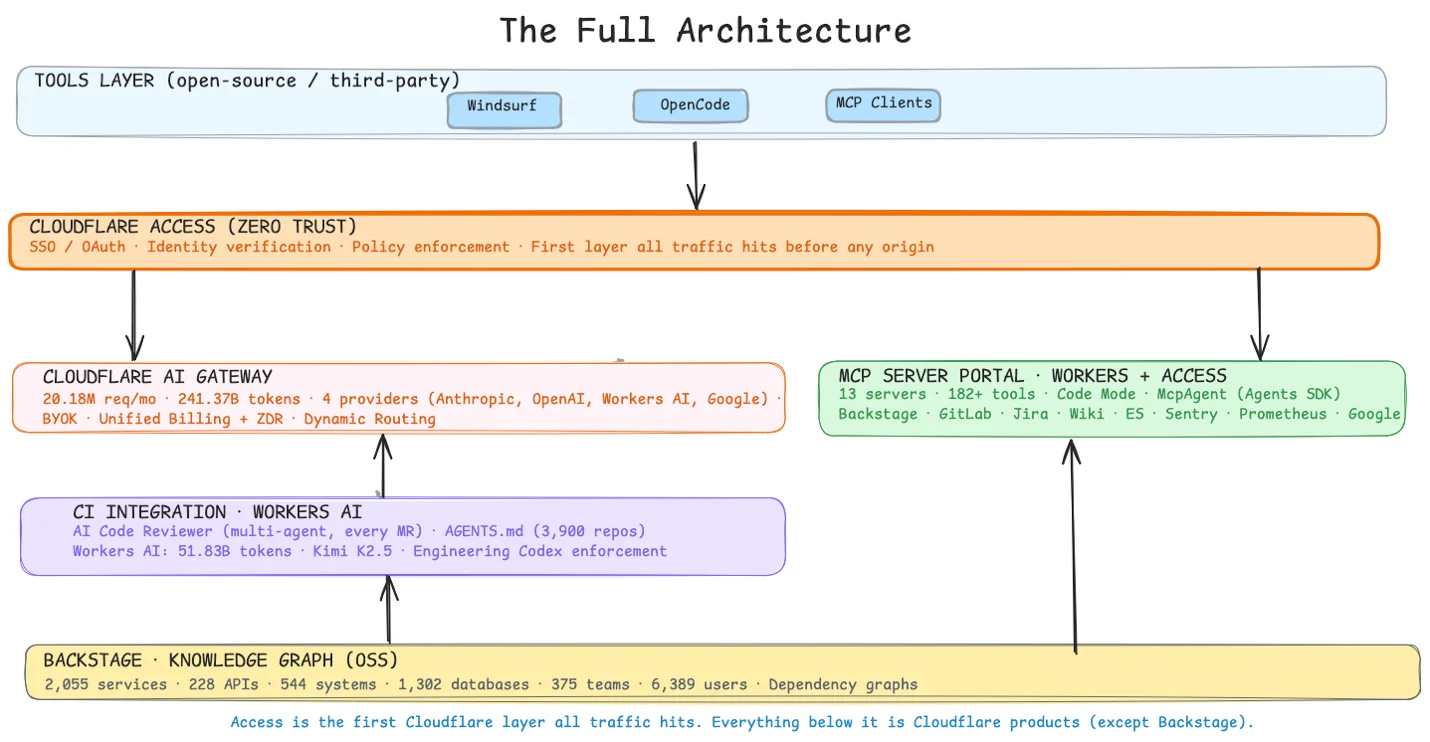
每一层都对应我们使用的一款 Cloudflare 产品或工具:
| 我们构建了什么 | 构建所用 |
|---|---|
| 零信任认证 | Cloudflare Access |
| 集中式 LLM 路由、成本跟踪、BYOK 和零数据留存(Zero Data Retention)控制 | AI Gateway |
| 使用开放权重模型的平台内推理 | Workers AI |
| 采用单次 OAuth 的 MCP Server Portal | Workers + Access |
| AI Code Reviewer 的 CI 集成 | Workers + AI Gateway |
| 为智能体生成的代码提供沙箱执行(Code Mode) | Dynamic Workers |
| 有状态、长时间运行的智能体会话 | Agents SDK(McpAgent、Durable Objects) |
| 用于克隆、构建和测试的隔离环境 | Sandbox SDK,Agents Week 期间正式发布(GA) |
| 持久化的多步骤工作流 | Workflows,Agents Week 期间扩容 10 倍 |
| 包含 1.6 万多个实体的知识图谱 | Backstage(开源) |
这些都不是仅限内部使用的基础设施。上面列出的一切(Backstage 除外)都是已发布的产品,其中许多还在 Agents Week 期间获得了重大更新。
我们将分三幕来讲:
- 平台层:认证、路由和推理是如何工作的(AI Gateway、Workers AI、MCP Portal、Code Mode)
- 知识层:智能体如何理解我们的系统(Backstage、AGENTS.md)
- 约束层:我们如何在大规模下保持高质量(AI Code Reviewer、Engineering Codex)
第一幕:平台层
AI Gateway 如何帮助我们保障安全并改善开发者体验
当有 3,600 多名内部用户每天使用 AI 编码工具时,你需要解决跨众多客户端、使用场景和角色的访问与可见性问题。
一切都从 Cloudflare Access 开始,它负责所有认证和零信任策略的执行。认证通过后,每个 LLM 请求都会经由 AI Gateway 路由。这为我们提供了统一的位置来管理提供商密钥、成本跟踪和数据留存策略。
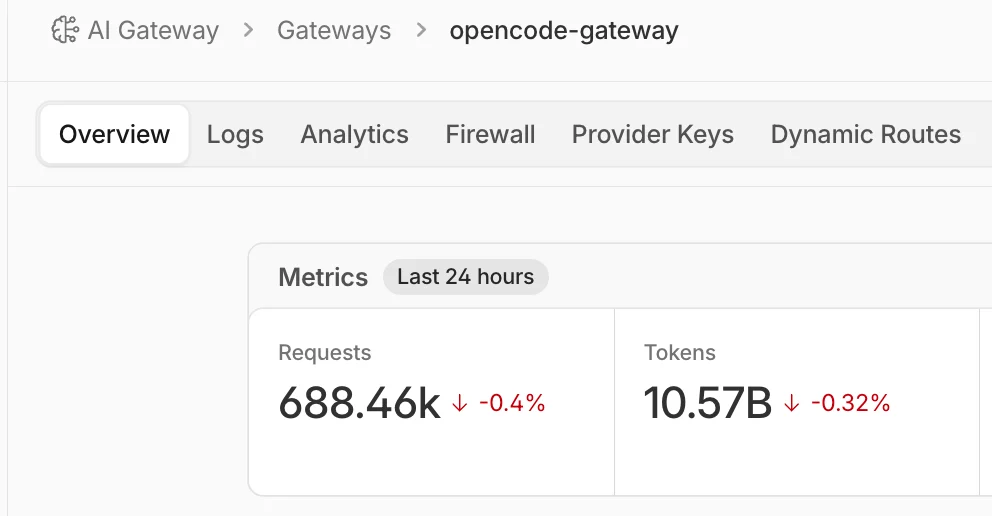
OpenCode 的 AI Gateway 概览:每天 68.846 万次请求、105.7 亿个 token,通过一个端点路由到四家提供商。
AI Gateway 的分析数据展示了月度用量在各模型提供商之间的分布。过去一个月,内部请求量的构成如下。
| 提供商 | 每月请求数 | 占比 |
|---|---|---|
| 前沿实验室(OpenAI、Anthropic、Google) | 1,338 万 | 91.16% |
| Workers AI | 130 万 | 8.84% |
目前,前沿模型承担了大部分复杂的智能体编码工作,但 Workers AI 已经是其中相当重要的一部分,并且在我们的智能体工程工作负载中占比越来越高。
我们如何越来越多地利用 Workers AI
Workers AI 是 Cloudflare 的无服务器 AI 推理平台,在我们遍布全球的网络中的 GPU 上运行开源模型。除了与前沿模型相比大幅降低成本之外,一个关键优势是推理与你的 Workers、Durable Objects 和存储位于同一网络。无需处理跨云跳转,而跨云会带来更高的延迟、网络不稳定,以及额外的网络配置管理负担。
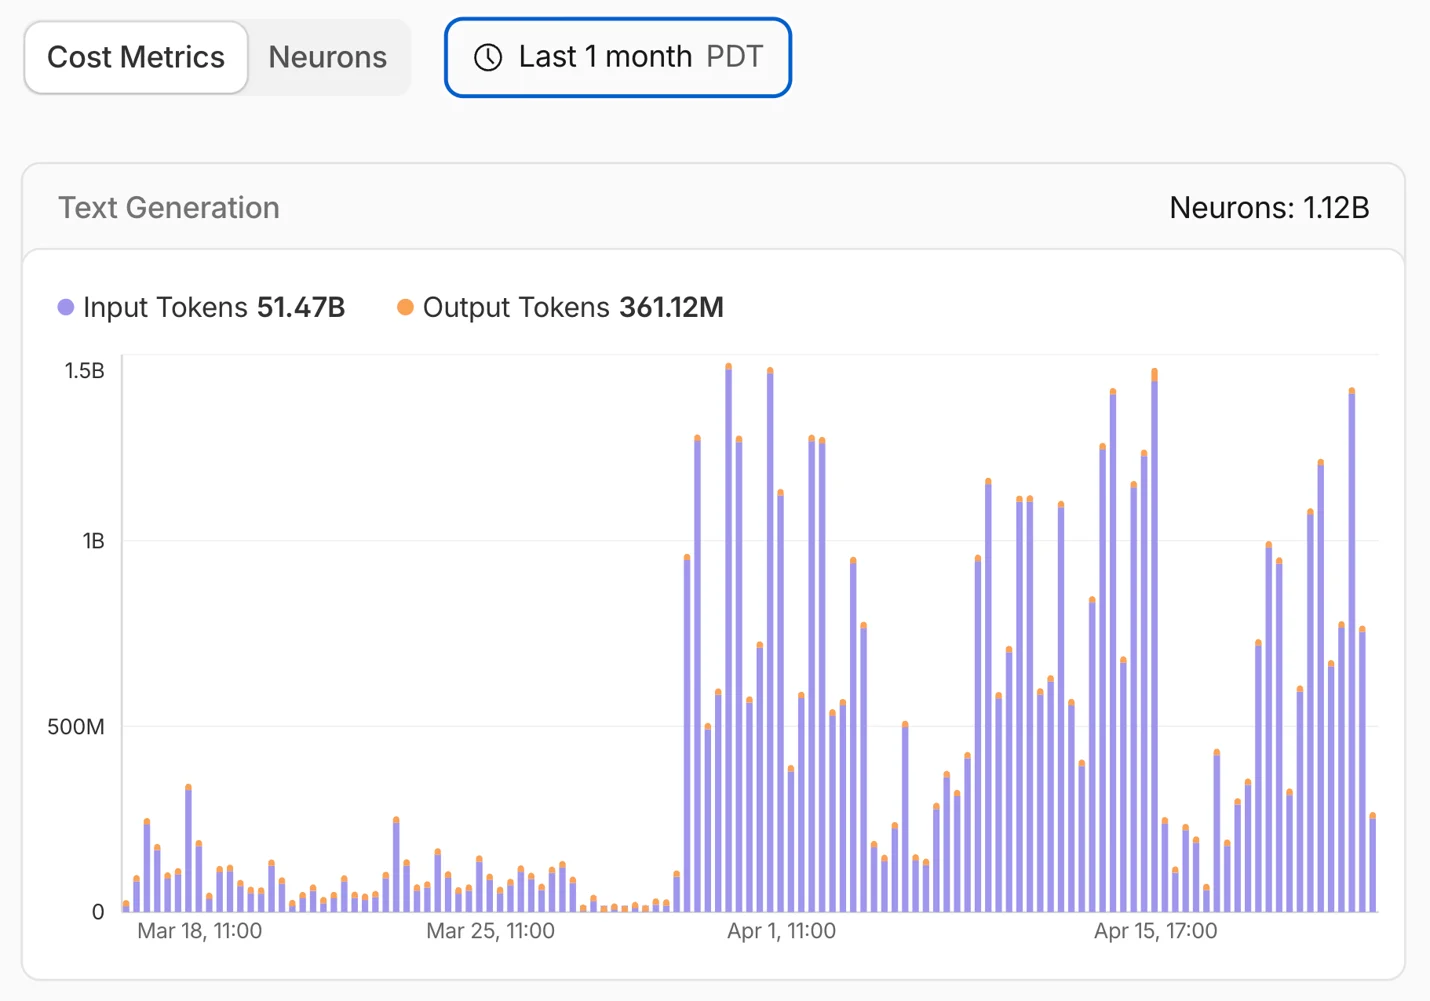
过去一个月的 Workers AI 用量:514.7 亿输入 token,3.6112 亿输出 token。
Kimi K2.5 于 2026 年 3 月在 Workers AI 上线,是一款前沿规模的开源模型,具备 256k 上下文窗口、工具调用和结构化输出能力。正如我们在 Kimi K2.5 发布文章中所述,我们有一个安全智能体,每天用 Kimi 处理超过 70 亿个 token。如果用中端专有模型,估计每年要花 240 万美元。而在 Workers AI 上,成本便宜 77%。
除安全之外,我们还把 Workers AI 用于 CI 流水线中的文档评审、为数千个代码仓库生成 AGENTS.md 上下文文件,以及那些同网络延迟比模型峰值能力更重要的轻量推理任务。
随着开源模型不断进步,我们预计 Workers AI 将承担越来越大比例的内部工作负载。
有一件事我们很早就做对了:从第一天起就通过单一代理 Worker 进行路由。我们本可以让客户端直连 AI Gateway,起初设置起来会更简单。但通过 Worker 集中处理,意味着我们之后可以添加按用户归属、模型目录管理和权限控制,而无需改动任何客户端配置。下面“引导配置”部分描述的每一项功能,之所以存在,都是因为我们有这个单一的咽喉要道。代理模式提供了直连所不具备的控制平面,如果日后接入其他编码助手工具,同一个 Worker 和发现端点也能处理它们。
工作原理:一个 URL 配置一切
整个设置从一条命令开始:
opencode auth login https://opencode.internal.domain
这条命令会触发一连串操作,配置好提供商、模型、MCP 服务器、智能体、命令和权限,用户无需碰任何配置文件。
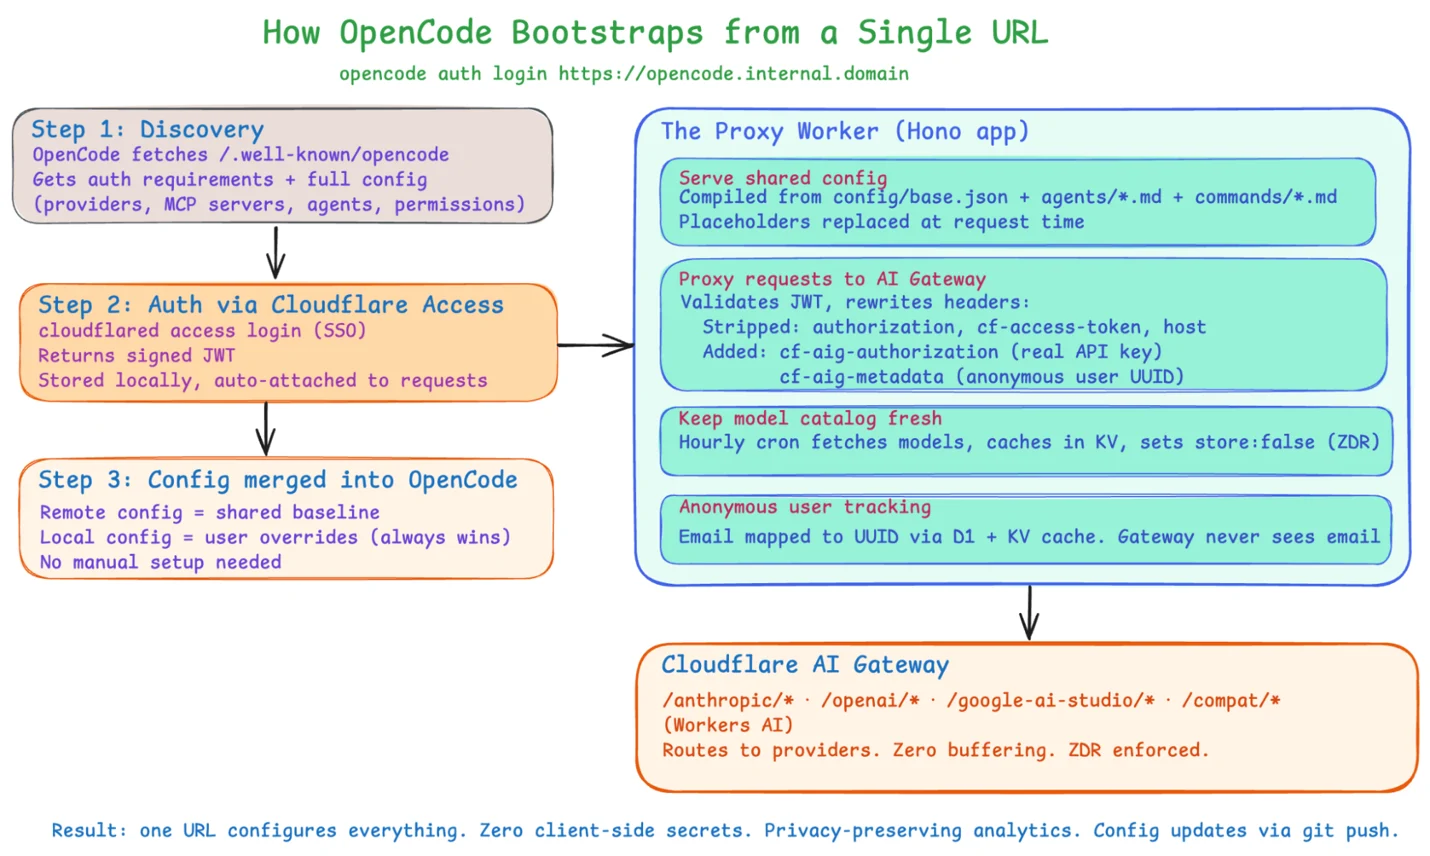
第 1 步:发现认证要求。OpenCode 从形如 https://opencode.internal.domain/.well-known/opencode 的 URL 获取配置。
这个发现端点由一个 Worker 提供,其响应中有一个 auth 块,告诉 OpenCode 如何认证,另有一个 config 块,包含提供商、MCP 服务器、智能体、命令和默认权限:
{
  "auth": {
    "command": ["cloudflared", "access", "login", "..."],
    "env": "TOKEN"
  },
  "config": {
    "provider": { "..." },
    "mcp": { "..." },
    "agent": { "..." },
    "command": { "..." },
    "permission": { "..." }
  }
}
第 2 步:通过 Cloudflare Access 认证。OpenCode 运行认证命令,用户通过他们在 Cloudflare 处理其他一切事务时使用的同一套 SSO 完成认证。cloudflared 会返回一个已签名的 JWT。OpenCode 将其保存在本地,并自动附加到之后的每个提供商请求上。
第 3 步:配置合并进 OpenCode。所提供的配置是整个组织共享的默认值,但本地配置始终优先。用户可以覆盖默认模型、添加自己的智能体,或调整项目级和用户级权限,而不会影响其他任何人。
代理 Worker 内部。这个 Worker 是一个简单的 Hono 应用,做三件事:
- 提供共享配置。配置在部署时由结构化的源文件编译生成,其中包含 {baseURL} 这样代表 Worker 源地址的占位值。请求到来时,Worker 会替换这些占位值,使所有提供商请求都经由 Worker 路由,而不是直接发往模型提供商。每个提供商都有一个路径前缀(Workers AI 为
/anthropic, /openai, /google-ai-studio/v1beta, /compat),Worker 会把请求转发到对应的 AI Gateway 路由。 - 将请求代理到 AI Gateway。当 OpenCode 发出形如
POST /anthropic/v1/messages的请求时,Worker 会校验 Cloudflare Access 的 JWT,然后在转发之前重写请求头:
Stripped:   authorization, cf-access-token, host
Added:      cf-aig-authorization: Bearer <API_KEY>
            cf-aig-metadata: {"userId": "<anonymous-uuid>"}
- 请求发往 AI Gateway,由它路由到相应的提供商。响应则不经任何缓冲直接透传。客户端配置中的
apiKey字段是空的,因为真正的密钥由 Worker 在服务端注入。用户的机器上不存在任何 API 密钥。 - 保持模型目录最新。每小时一次的 cron 触发器会从
models.dev获取当前的 OpenAI 模型列表,缓存在 Workers KV 中,并为每个模型注入store: false,以启用零数据留存(Zero Data Retention)。新模型会自动获得 ZDR,无需重新部署配置。
匿名用户跟踪。JWT 校验通过后,Worker 会把用户的邮箱映射为一个 UUID,用 D1 做持久化存储,用 KV 做读缓存。AI Gateway 在 cf-aig-metadata 中只会看到匿名的 UUID,永远看不到邮箱。这让我们既能做按用户的成本跟踪和用量分析,又不会向模型提供商或 Gateway 日志暴露用户身份。
配置即代码。智能体和命令以带有 YAML frontmatter 的 markdown 文件编写。构建脚本把它们编译成一份按 OpenCode JSON schema 校验过的 JSON 配置。每个新会话都会自动获取最新版本。
整体架构很简单,任何人都可以用我们的开发者平台轻松部署:一个代理 Worker、Cloudflare Access、AI Gateway,以及一个客户端可访问、能自动配置一切的发现端点。用户只需运行一条命令就完成了。无需手动配置任何东西,笔记本上没有 API 密钥,也不用手动设置 MCP 服务器连接。要修改我们的智能体工具、更新 3,000 多人在编码环境中获得的内容,只需一个 wrangler deploy 就够了。
MCP Server Portal:一次 OAuth,多个 MCP 工具
我们在另一篇文章中介绍了在企业规模上治理 MCP 的完整做法,包括如何将 MCP Server Portals、Cloudflare Access 和 Code Mode 结合使用。下面是我们内部构建内容的简要版本。
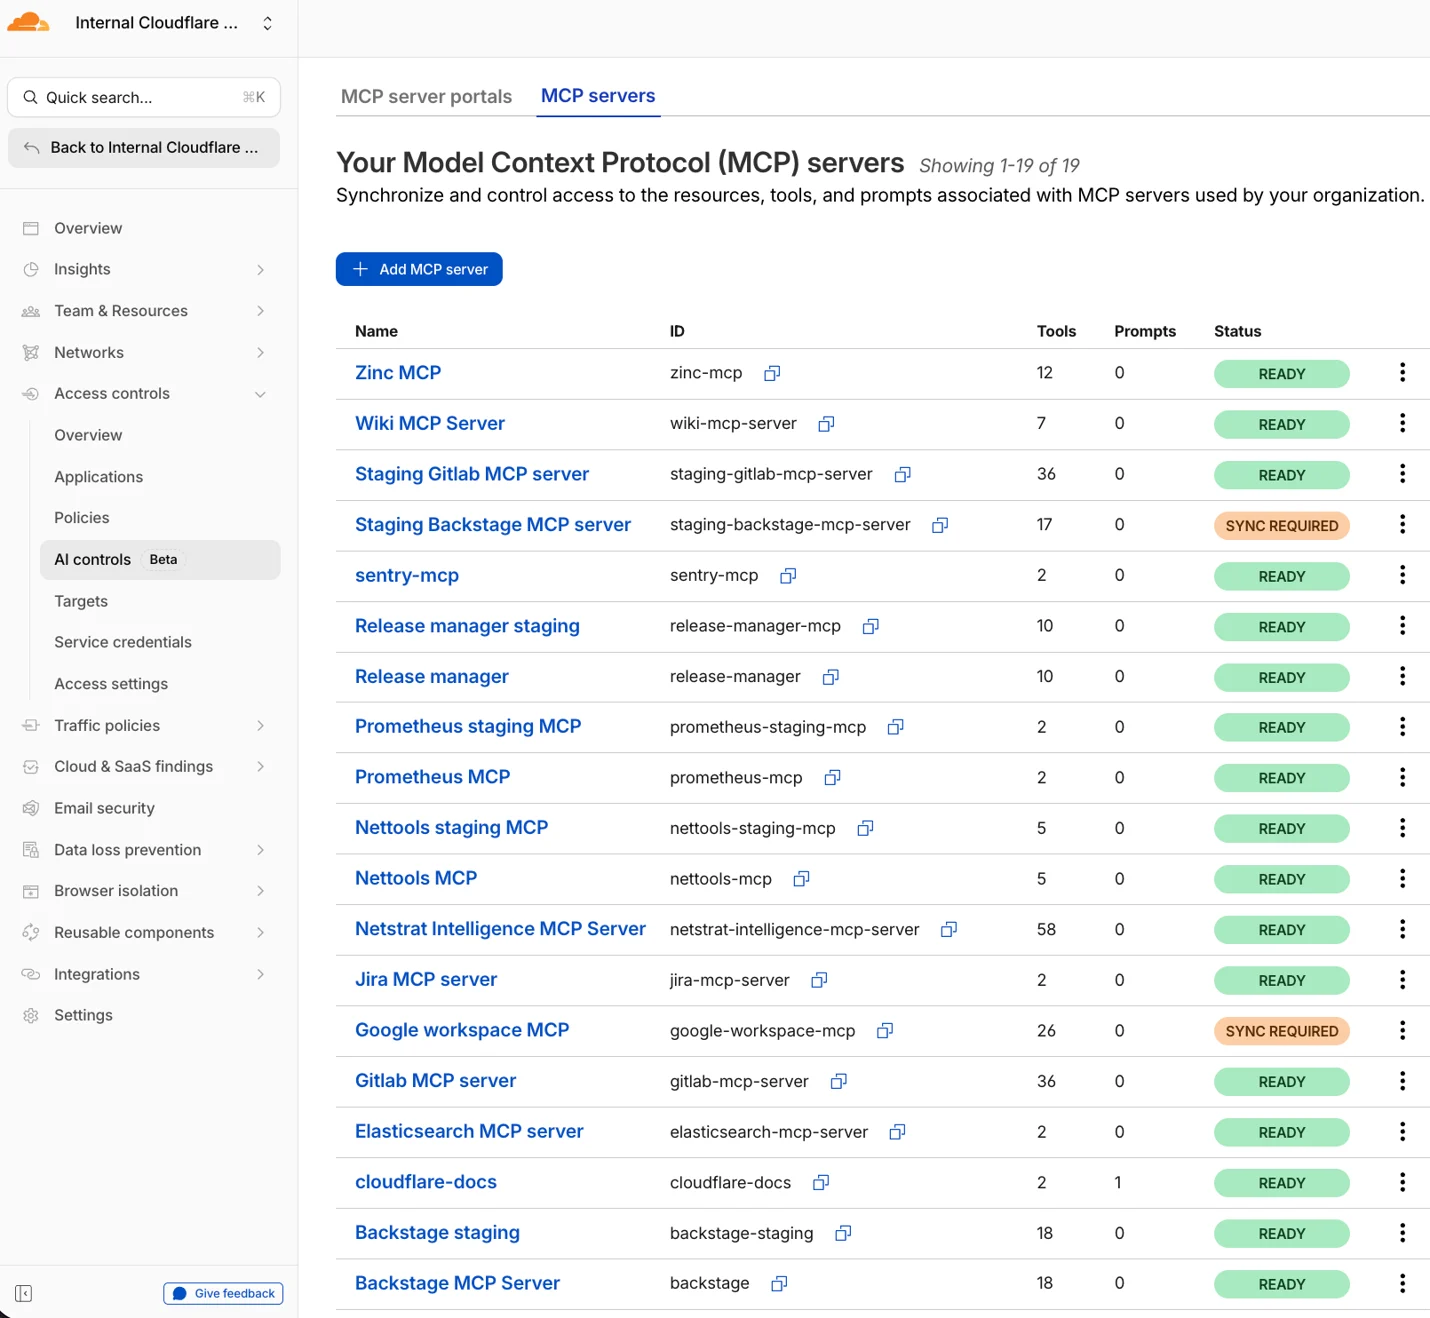
我们的内部门户聚合了 13 个生产环境的 MCP 服务器,暴露出 182 个以上的工具,涵盖 Backstage、GitLab、Jira、Sentry、Elasticsearch、Prometheus、Google Workspace、我们内部的 Release Manager 等。这统一了访问方式,并简化了一切:用一个端点、一套 Cloudflare Access 流程管控对每个工具的访问。
每个 MCP 服务器都建立在同样的基础上:Agents SDK 中的 McpAgent、用于 OAuth 的 workers-oauth-provider,以及用于身份的 Cloudflare Access。整套东西放在一个单体仓库(monorepo)里,共享认证基础设施、Bazel 构建、CI/CD 流水线,以及用于 Backstage 注册的 catalog-info.yaml。新增一个服务器,基本上就是复制一个现有的,再改一下它所封装的 API。关于其工作方式及背后的安全架构,请参阅我们的企业级 MCP 参考架构。
门户层的 Code Mode
MCP 是连接 AI 智能体与工具的合适协议,但有一个现实问题:每个工具定义在模型开始工作之前就会占用上下文窗口的 token。随着 MCP 服务器和工具数量增加,token 开销也水涨船高,规模一大,这就成了实实在在的成本。Code Mode 是正在兴起的解决办法:模型不再预先加载每个工具的 schema,而是通过代码来发现并调用工具。
我们的 GitLab MCP 服务器最初暴露了 34 个独立工具(get_merge_request、list_pipelines、get_file_content 等等)。这 34 个工具的 schema 每次请求大约占用 15,000 个上下文窗口 token。在 200K 的上下文窗口里,这意味着还没提问就先耗掉了 7.5% 的预算。再乘以每个请求、每位工程师、每一天,累积起来相当可观。
MCP Server Portals 现在支持 Code Mode 代理,让我们可以集中解决这个问题,而不必逐个服务器处理。门户不再向客户端暴露每个上游工具的定义,而是把它们折叠为两个门户级工具:portal_codemode_search and portal_codemode_execute。
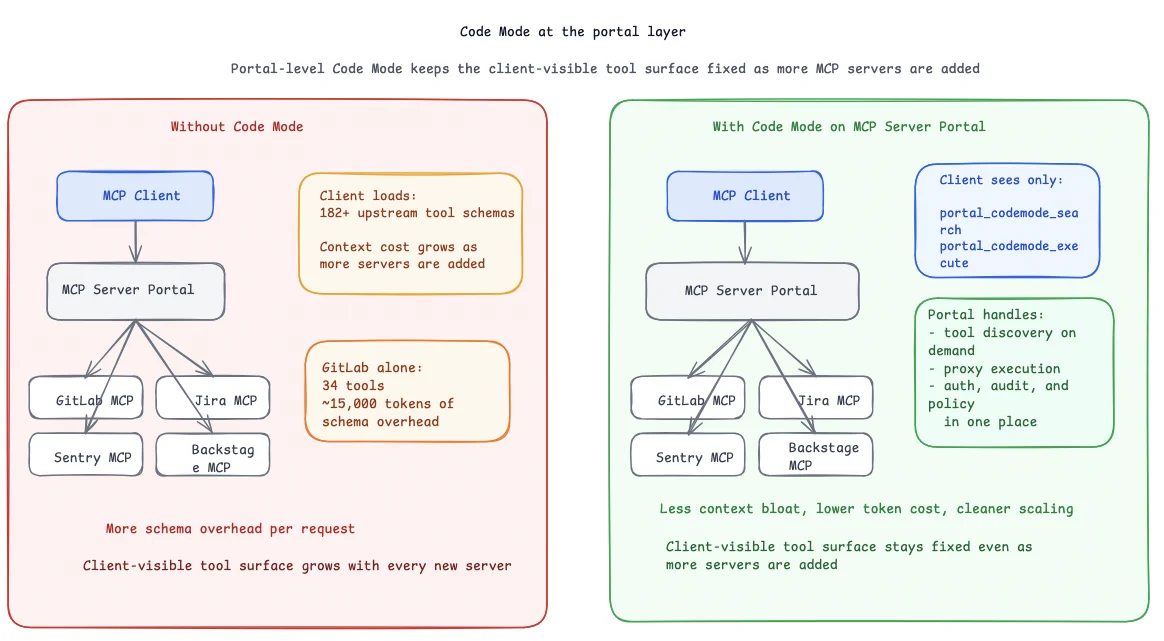
在门户层做这件事的好处是扩展起来很干净。没有 Code Mode 时,每新增一个 MCP 服务器,每次请求的 schema 开销就增加一份。有了门户级 Code Mode,即使我们在门户后面接入更多服务器,客户端看到的仍然只有两个工具。这意味着更少的上下文膨胀、更低的 token 成本,以及整体上更清爽的架构。
第二幕:知识层
Backstage:支撑这一切的知识图谱
在 iMARS 团队能构建出真正有用的 MCP 服务器之前,我们需要先解决一个更根本的问题:关于我们的服务和基础设施的结构化数据。我们需要智能体理解代码库之外的上下文,比如谁拥有什么、服务之间如何相互依赖、文档在哪里,以及某个服务访问哪些数据库。
我们运行 Backstage 作为服务目录。它是最初由 Spotify 构建的开源内部开发者门户,采用自托管(需要说明的是,并未运行在 Cloudflare 产品上),跟踪的内容包括:
- 2,055 个服务、167 个库和 122 个包
- 228 个带有 schema 定义的 API
- 分属 45 个领域的 544 个系统(产品)
- 1,302 个数据库、277 张 ClickHouse 表、173 个集群
- 375 个团队和 6,389 名用户,附带归属关系映射
- 依赖图,将服务与它们所依赖的数据库、Kafka 主题和云资源连接起来
我们的 Backstage MCP 服务器(13 个工具)可通过 MCP Portal 使用,智能体能够查询某个服务归谁所有、检查它依赖什么、找到相关的 API 规范,并拉取 Tech Insights 评分,全程无需离开编码会话。
没有这些结构化数据,智能体就像盲人摸象。它们能读到眼前的代码,却看不到代码周围的系统。目录把一个个孤立的仓库变成了整个工程组织的互联地图。
AGENTS.md:让数千个仓库为 AI 做好准备
在推广初期,我们不断遇到同一种失败模式:编码智能体产出的改动看起来合理,对该仓库来说却仍然是错的。问题通常出在本地上下文:模型不知道正确的测试命令、团队当前的约定,或者代码库的哪些部分是禁区。这促使我们转向 AGENTS.md:每个仓库中一个简短的结构化文件,告诉编码智能体代码库实际是如何运作的,并迫使团队把这些上下文明确写出来。
AGENTS.md 是什么样的
我们构建了一套系统,在整个 GitLab 实例中生成 AGENTS.md 文件。由于这些文件直接位于模型的上下文窗口中,我们希望它们保持简短且信息密度高。一个典型的文件如下所示:
# AGENTS.md

## Repository
- Runtime: cloudflare workers
- Test command: `pnpm test`
- Lint command: `pnpm lint`

## How to navigate this codebase
- All cloudflare workers  are in src/workers/, one file per worker
- MCP server definitions are in src/mcp/, each tool in a separate file
- Tests mirror source: src/foo.ts -> tests/foo.test.ts

## Conventions
- Testing: use Vitest with `@cloudflare/vitest-pool-workers` (Codex: RFC 021, RFC 042)
- API patterns: Follow internal REST conventions (Codex: API-REST-01)

## Boundaries
- Do not edit generated files in `gen/`
- Do not introduce new background jobs without updating `config/`

## Dependencies
- Depends on: auth-service, config-service
- Depended on by: api-gateway, dashboard
智能体读到这个文件时,不必从零开始推断这个仓库。它知道代码库是如何组织的、应遵循哪些约定,以及适用哪些 Engineering Codex 规则。
我们如何大规模生成
生成流水线先从我们的 Backstage 服务目录拉取实体元数据(归属、依赖、系统关系),再分析仓库结构以检测语言、构建系统、测试框架和目录布局,然后把检测到的技术栈映射到相关的 Engineering Codex 标准。接着由一个能力足够的模型生成结构化文档,系统随后发起合并请求,供所属团队评审和完善。
我们已经用这种方式处理了大约 3,900 个仓库。初次生成并不总是完美,对于多语言仓库或特殊的构建设置尤其如此,但即便是这样的基线,也比让智能体从零推断一切要好得多。
最初的合并请求解决了冷启动问题,但让这些文件保持最新同样重要。过时的 AGENTS.md 可能比没有文件更糟。我们用 AI Code Reviewer 闭合了这个循环,当仓库变更表明 AGENTS.md 应当更新时,它能够提示出来。
第三幕:约束层
AI Code Reviewer
Cloudflare 的每个合并请求都会经过 AI 代码评审。集成方式很简单:团队在流水线中添加一个 CI 组件,从那时起,每个 MR 都会被自动评审。
我们使用 GitLab 的自托管方案作为 CI/CD 平台。评审器实现为一个 GitLab CI 组件,由各团队纳入自己的流水线。当 MR 被创建或更新时,CI 作业会运行 OpenCode,并配有一个多智能体评审协调器。协调器按风险等级(trivial、lite 或 full)对 MR 分类,再委派给专门的评审智能体:代码质量、安全、codex 合规、文档、性能和发布影响。每个智能体都通过 AI Gateway 访问模型,从中央仓库拉取 Engineering Codex 规则,并读取仓库的 AGENTS.md 以获得代码库上下文。结果以结构化的 MR 评论形式回帖。
另有一个基于 Workers 的配置服务,负责按评审智能体集中选择模型,这样我们无需修改 CI 模板就能切换模型。评审过程本身运行在 CI runner 中,每次执行都是无状态的。
输出格式
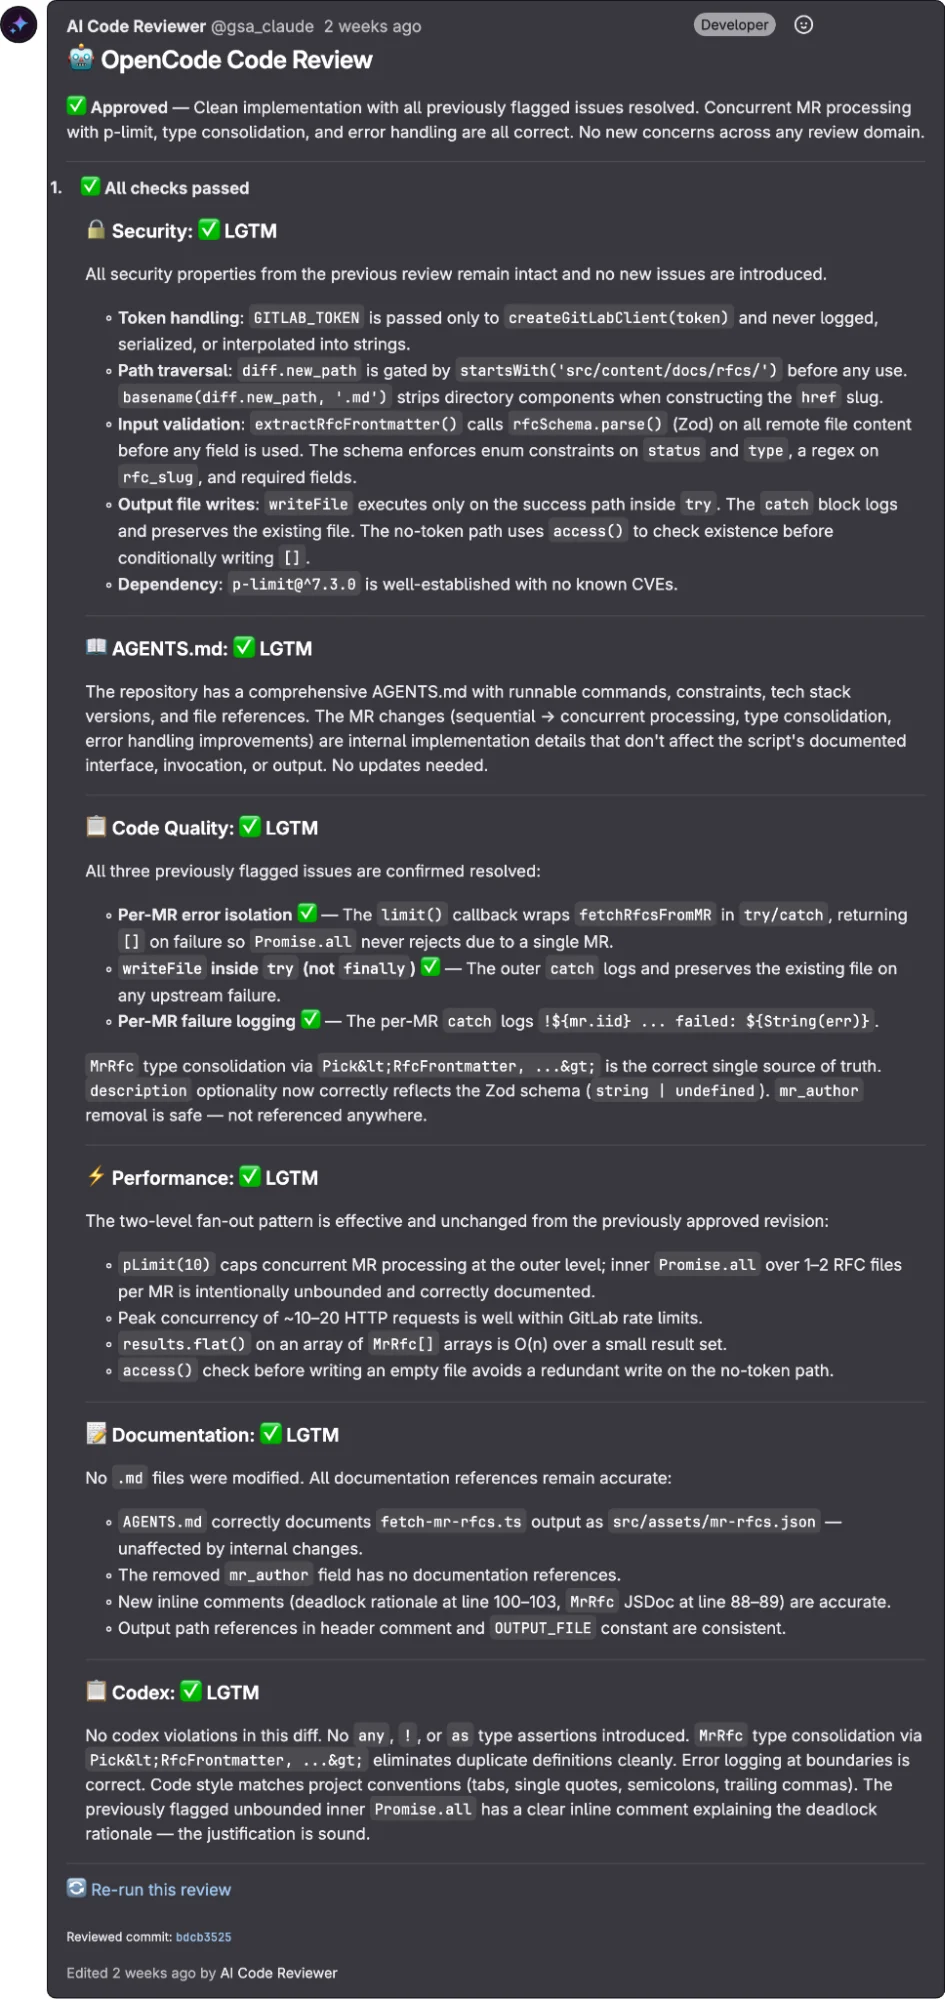
我们花了不少功夫把输出格式打磨好。评审按类别划分(安全、代码质量、性能),工程师可以扫一眼标题,而不必阅读大段文字。每条发现都有严重程度(Critical、Important、Suggestion 或 Optional Nits),让人一眼就能分清哪些需要关注,哪些只是提供信息。
评审器会在多轮迭代之间保持上下文。如果它在之前某一轮评审中标记的问题后来已被修复,它会确认这一点,而不是再次提出同样的问题。当某条发现对应 Engineering Codex 中的某条规则时,它会引用具体的规则 ID,把一条 AI 建议变成对组织标准的引用。
Workers AI 处理了代码审查器约 15% 的流量,主要用于文档审查任务——在这类任务上,Kimi K2.5 表现出色,成本只是前沿模型的一小部分。而对推理能力要求最高的安全敏感型审查和架构复杂的审查,则交给 Opus 4.6 和 GPT 5.4 这样的模型。
过去 30 天:
- 在我们的标准 CI 流水线上,所有代码仓库的 AI 代码审查器覆盖率达到 100%。
- 547 万次 AI Gateway 请求
- 处理了 247.7 亿个 token
与本文同步发布的还有一篇详细的技术博客,介绍了审查器的内部架构,包括我们如何在不同模型之间路由、多智能体编排,以及我们总结出的成本优化策略。
Engineering Codex:以智能体技能形式呈现的工程标准
Engineering Codex 是 Cloudflare 全新的内部标准体系,我们的核心工程标准都收录其中。我们采用多阶段 AI 蒸馏流程,输出一组 codex 规则(“如果你需要 X,就使用 Y。如果你在做 Y 或 Z,就必须做 X。”),以及一个智能体技能,该技能采用渐进式披露,并在 markdown 文件之间使用嵌套的分层信息目录和链接。
工程师在本地开发时可以使用这个技能,比如用“我的 Rust 服务应该如何处理错误?”或“检查这段 TypeScript 代码是否合规”这样的提示词。我们的 Network Firewall 团队用多智能体共识流程审计了 rampartd:每条要求都被评为 COMPLIANT、PARTIAL 或 NON-COMPLIANT,并附上具体的违规细节和整改步骤,把以往需要数周人工完成的工作变成了结构化、可重复的流程。
在审查阶段,AI 代码审查器会在反馈中引用具体的 Codex 规则。
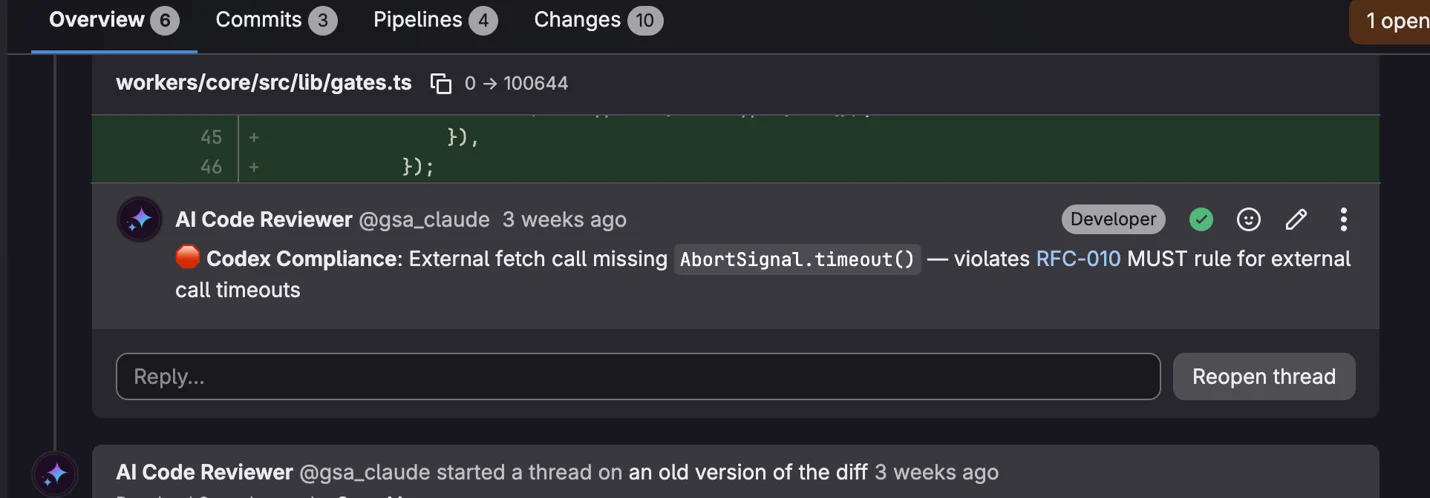
AI 代码审查:按类别展示审查发现(此处为 Codex 合规性),指出违反了 codex RFC。
这些部分单独看都算不上新鲜。很多公司都有服务目录、上线审查机器人或发布工程标准。区别在于把它们串起来。当智能体可以从 Backstage 拉取上下文、读取所编辑仓库的 AGENTS.md,并由同一套工具链按 Codex 规则进行审查时,初稿往往已经接近可以直接上线。六个月前还不是这样。
成绩单
从启动这项工作到研发团队采用率达到 93%,用时不到一年。
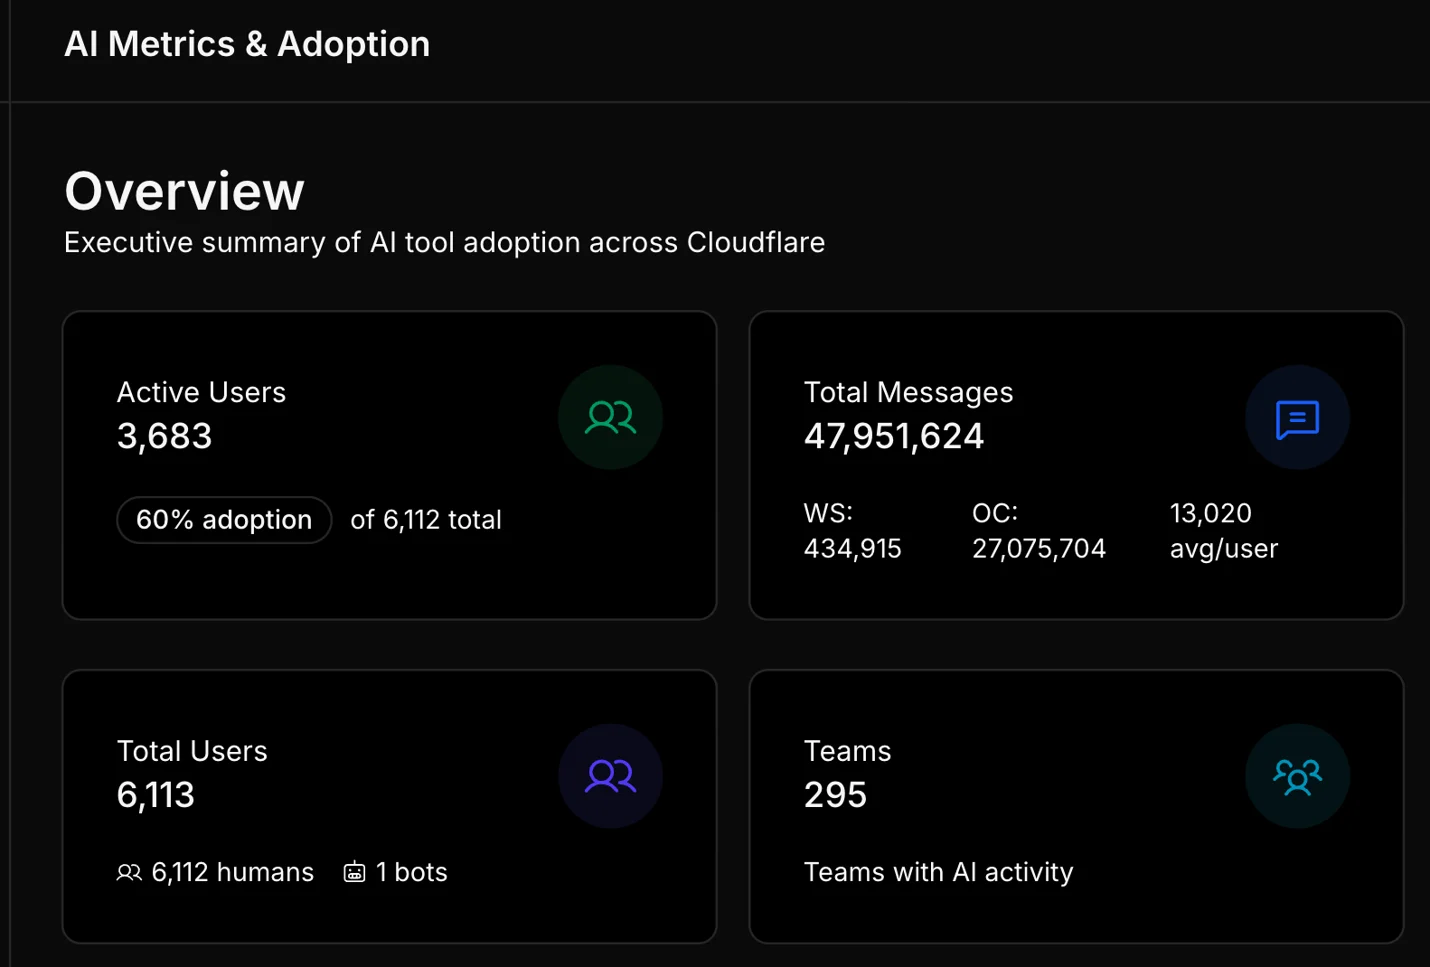
全公司采用情况(2026 年 2 月 5 日至 4 月 15 日):
| 指标 | 数值 |
|---|---|
| 活跃用户 | 3,683(占全公司 60%) |
| 研发团队采用率 | 93% |
| AI 消息数 | 4,795 万 |
| 有 AI 活动的团队 | 295 |
| OpenCode 消息数 | 2,708 万 |
| Windsurf 消息数 | 43.49 万 |
AI Gateway(过去 30 天,合计):
| 指标 | 数值 |
|---|---|
| 请求数 | 2,018 万 |
| Token 数 | 2,413.7 亿 |
Workers AI(过去 30 天):
| 指标 | 数值 |
|---|---|
| 输入 token | 514.7 亿 |
| 输出 token | 3.6112 亿 |
下一步:后台智能体
我们内部工程栈的下一步演进将包括后台智能体:可以按需启动,拥有与本地相同的工具(MCP 门户、git、测试运行器),但完全运行在云端。其架构使用 Durable Objects 和 Agents SDK 做编排;当任务需要完整的开发环境时,例如克隆仓库、安装依赖或运行测试,就委派给 Sandbox 容器。Sandbox SDK 已在 Agents Week 期间正式发布(GA)。
原生集成到 Agents SDK 中的长时间运行智能体同样在 Agents Week 期间发布,解决了此前需要各种变通办法的持久会话问题。SDK 现在支持长时间运行而不被驱逐的会话,足以让智能体在一次会话中完成克隆大型仓库、运行完整测试套件、针对失败反复迭代并提交 MR 的全过程。
这是一项历时十一个月的工作,旨在重新思考的不只是代码如何编写,还包括代码如何审查、标准如何落实,以及变更如何在数千个仓库中安全上线。每一层都运行在我们客户所用的同一批产品之上。
开始构建
Agents Week 刚刚发布了你所需的一切。平台已经就绪。
npx create-cloudflare@latest --template cloudflare/agents-starter
这个智能体入门模板能让你先跑起来。下图是你准备扩展时的完整架构:最上层是你的工具(聊天机器人、Web UI、CLI、浏览器扩展),中间是负责会话状态和编排的 Agents SDK,底层则是你从中调用的 Cloudflare 各项服务。
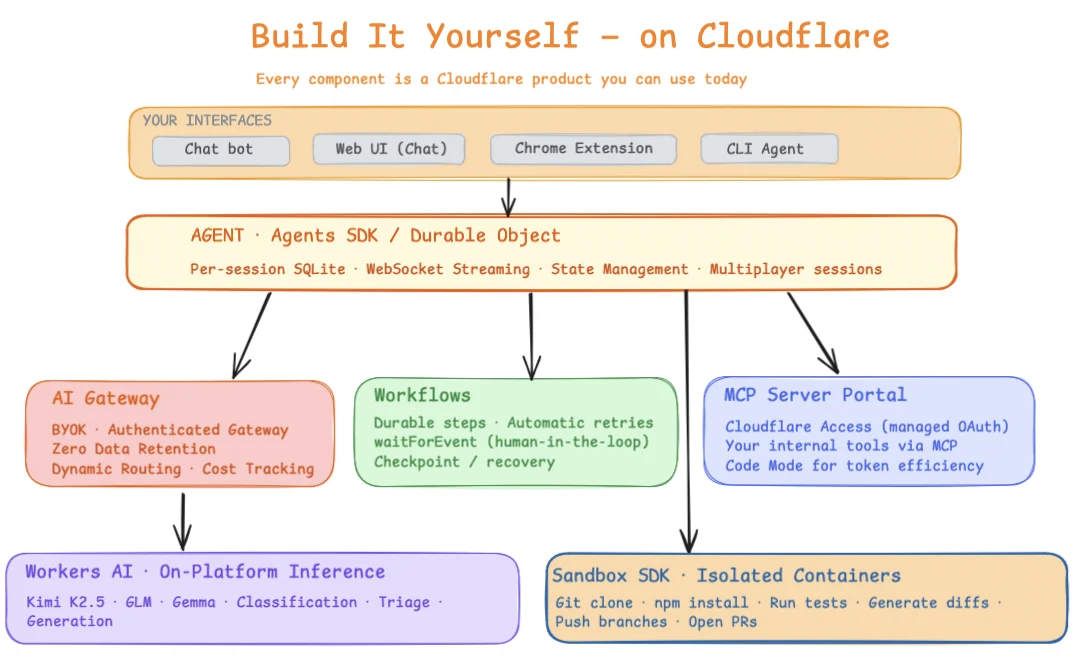
文档: Agents SDK · Sandbox SDK · AI Gateway · Workers AI · Workflows · Code Mode · MCP on Cloudflare
仓库: cloudflare/agents · cloudflare/sandbox-sdk · cloudflare/mcp-server-cloudflare · cloudflare/skills
想进一步了解 Cloudflare 如何使用 AI,请阅读我们的 AI 代码审查流程一文,也欢迎查看我们在 Agents Week 期间发布的全部内容。
我们很期待看到你构建的成果。欢迎在 Discord、X 和 Bluesky 上找到我们。
Ayush Thakur 构建了 AGENTS.md 体系以及面向 OpenCode 基础设施的 AI Gateway 集成;Scott Roemeschke 是 Cloudflare 开发者生产力团队的工程经理;Rajesh Bhatia 负责 Cloudflare 的生产力平台职能。本文由 Devtools 团队协作完成,并得到了全公司志愿者通过 iMARS(Internal MCP Agent/Server Rollout Squad,内部 MCP 智能体/服务器推广小组)特别行动小组提供的帮助。