去年,我们介绍了 Brain2Qwerty v1,这项研究利用 AI 在不做任何手术植入的情况下把大脑活动解码为文本。现在,我们分享下一步成果:Brain2Qwerty v2,这是目前性能最高的端到端流水线,能够从非侵入式脑记录中实时解码整句话,准确率已接近此前只有需要开颅手术的技术才能达到的水平。
为了帮助加速神经科学的突破,我们将发布 Brain2Qwerty v1 和 v2 的完整训练代码,我们的合作伙伴巴斯克认知、大脑与语言中心(BCBL)也将发布 v1 数据集。我们相信,这项研究有望为数百万因脑损伤而无法交流的人带来真正的改变。立体定向脑电图和皮层脑电图等侵入式手术已经表明,通过神经假体向 AI 解码器输送信号可以恢复沟通能力,但这些方法很难规模化。我们的非侵入式方法有助于弥合这一差距。
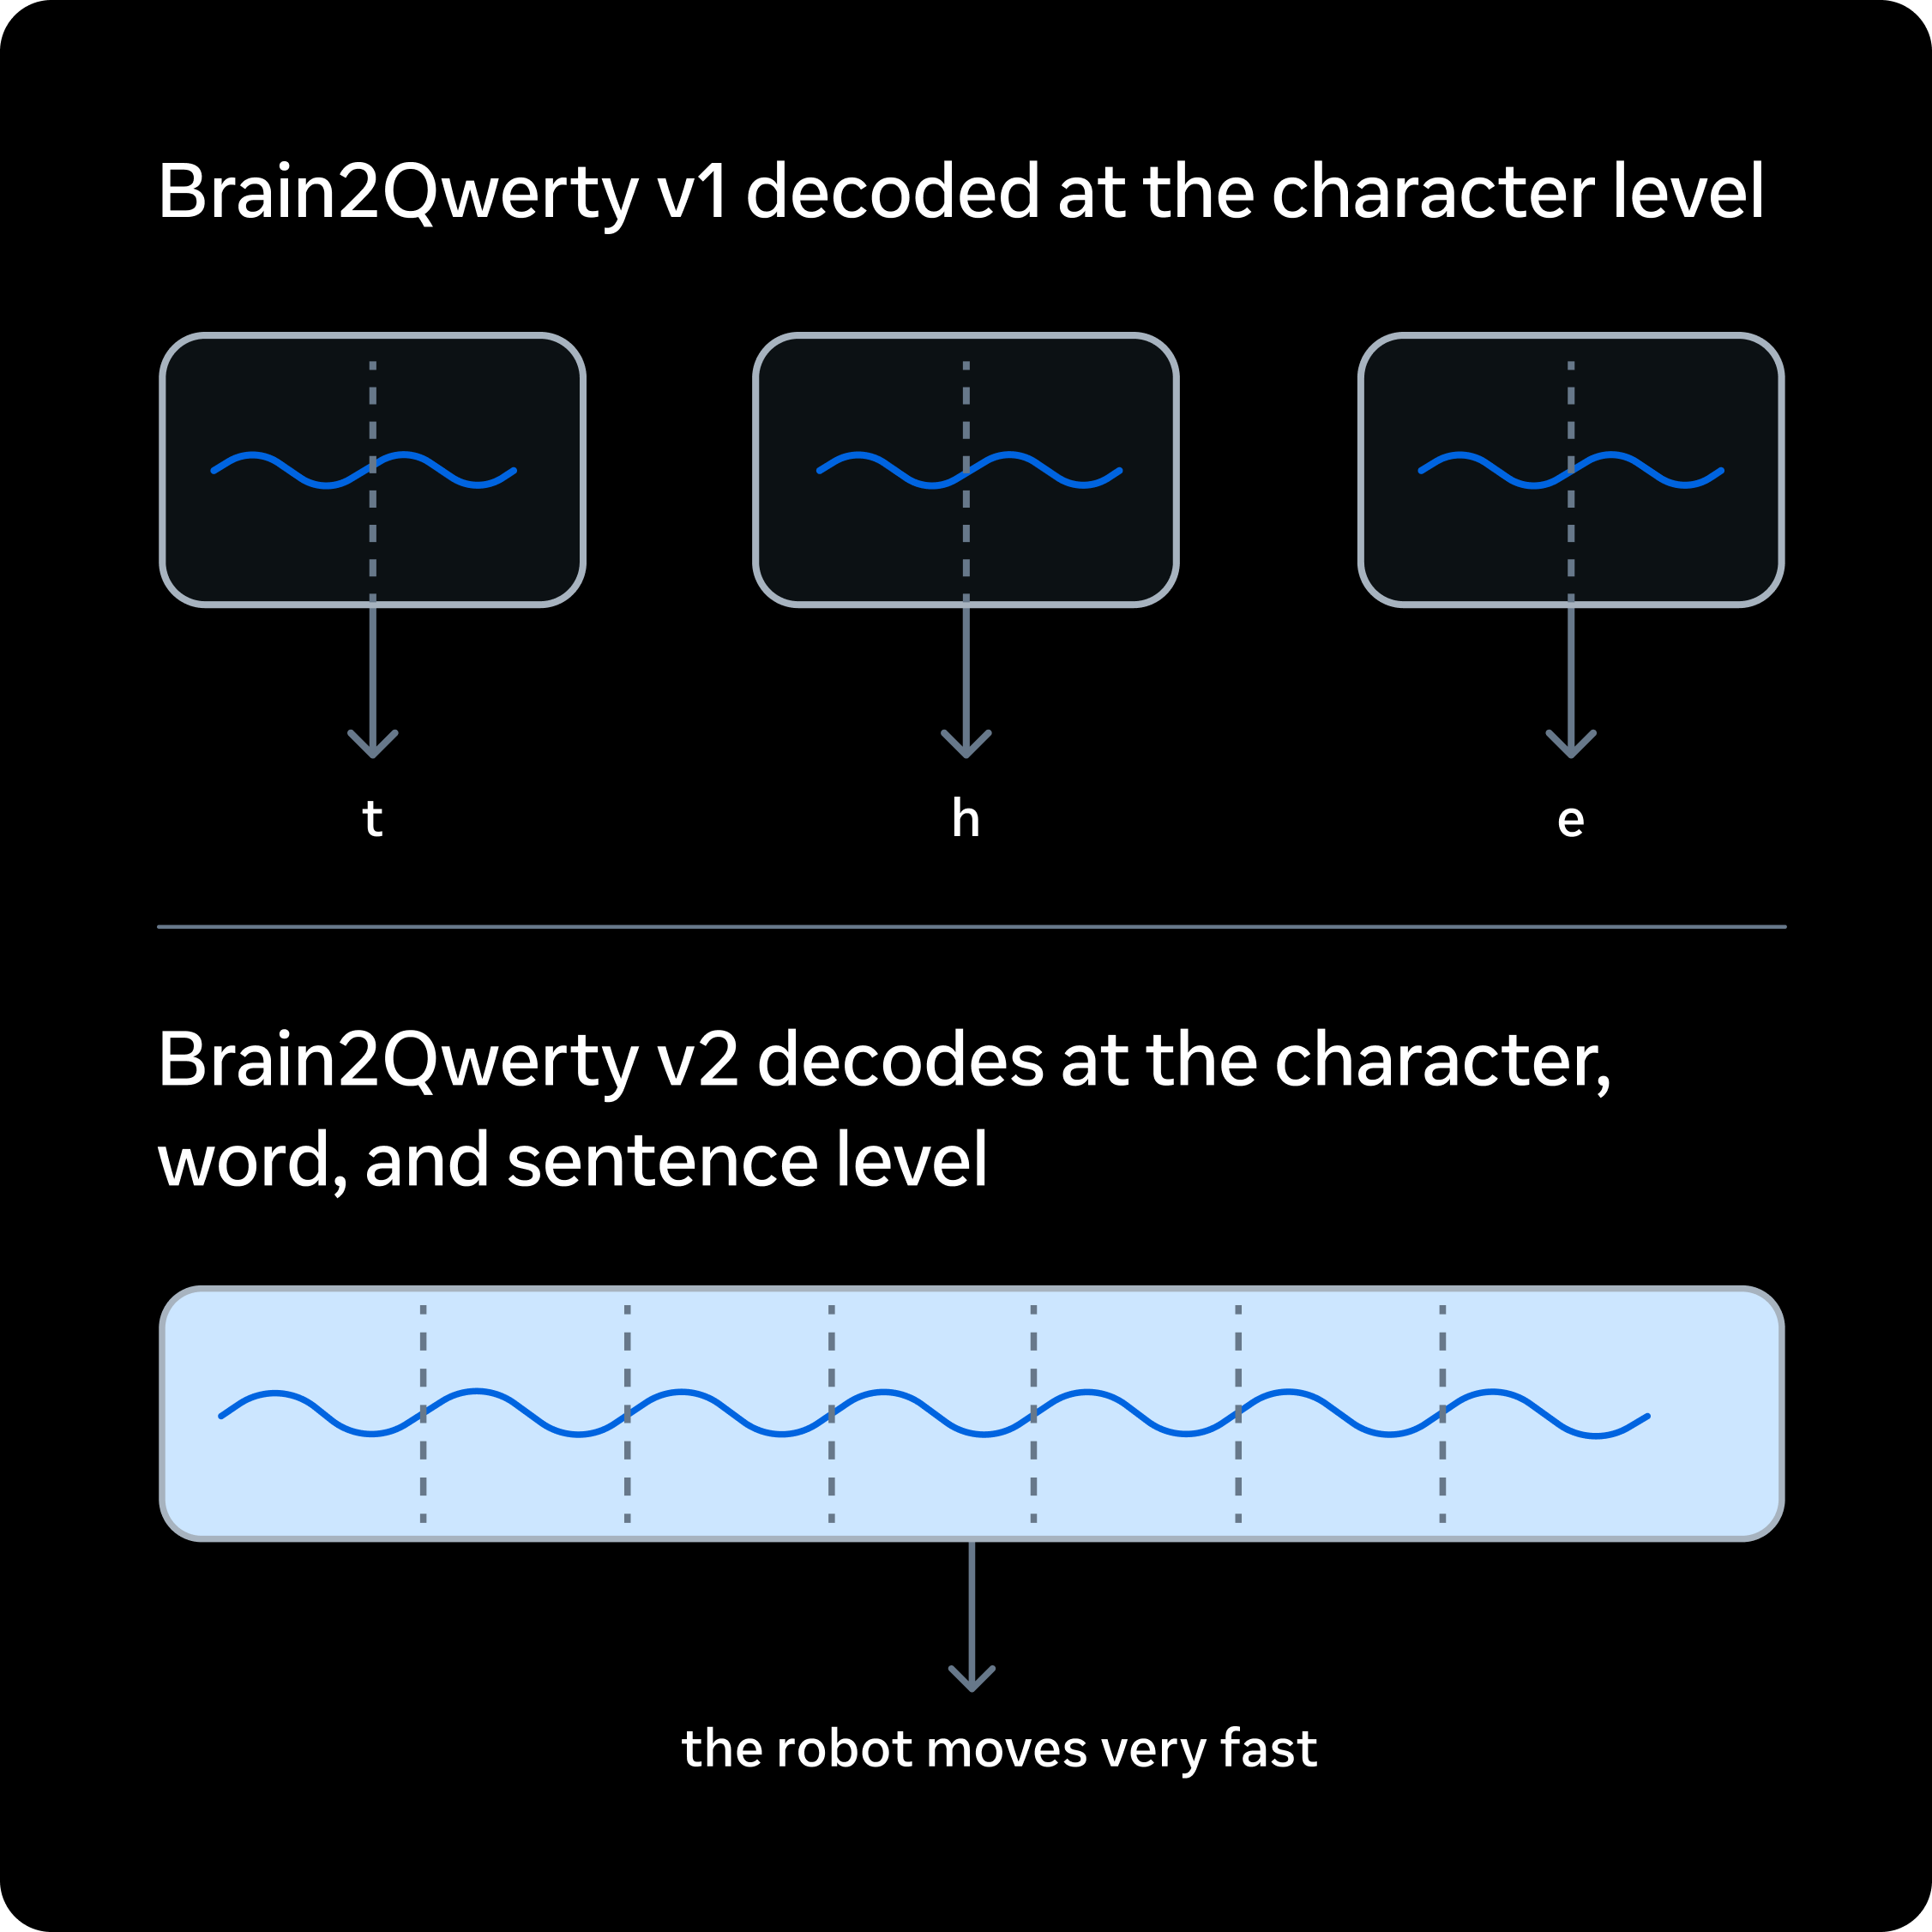
我们用来自九名志愿者的约 22,000 个句子训练了 Brain2Qwerty v2,每位参与者在积极打字的同时佩戴脑磁图(MEG)设备,记录了 10 小时。我们没有依赖手工设计的流水线来检测神经事件,而是采用端到端深度学习,直接从原始脑信号中解码。
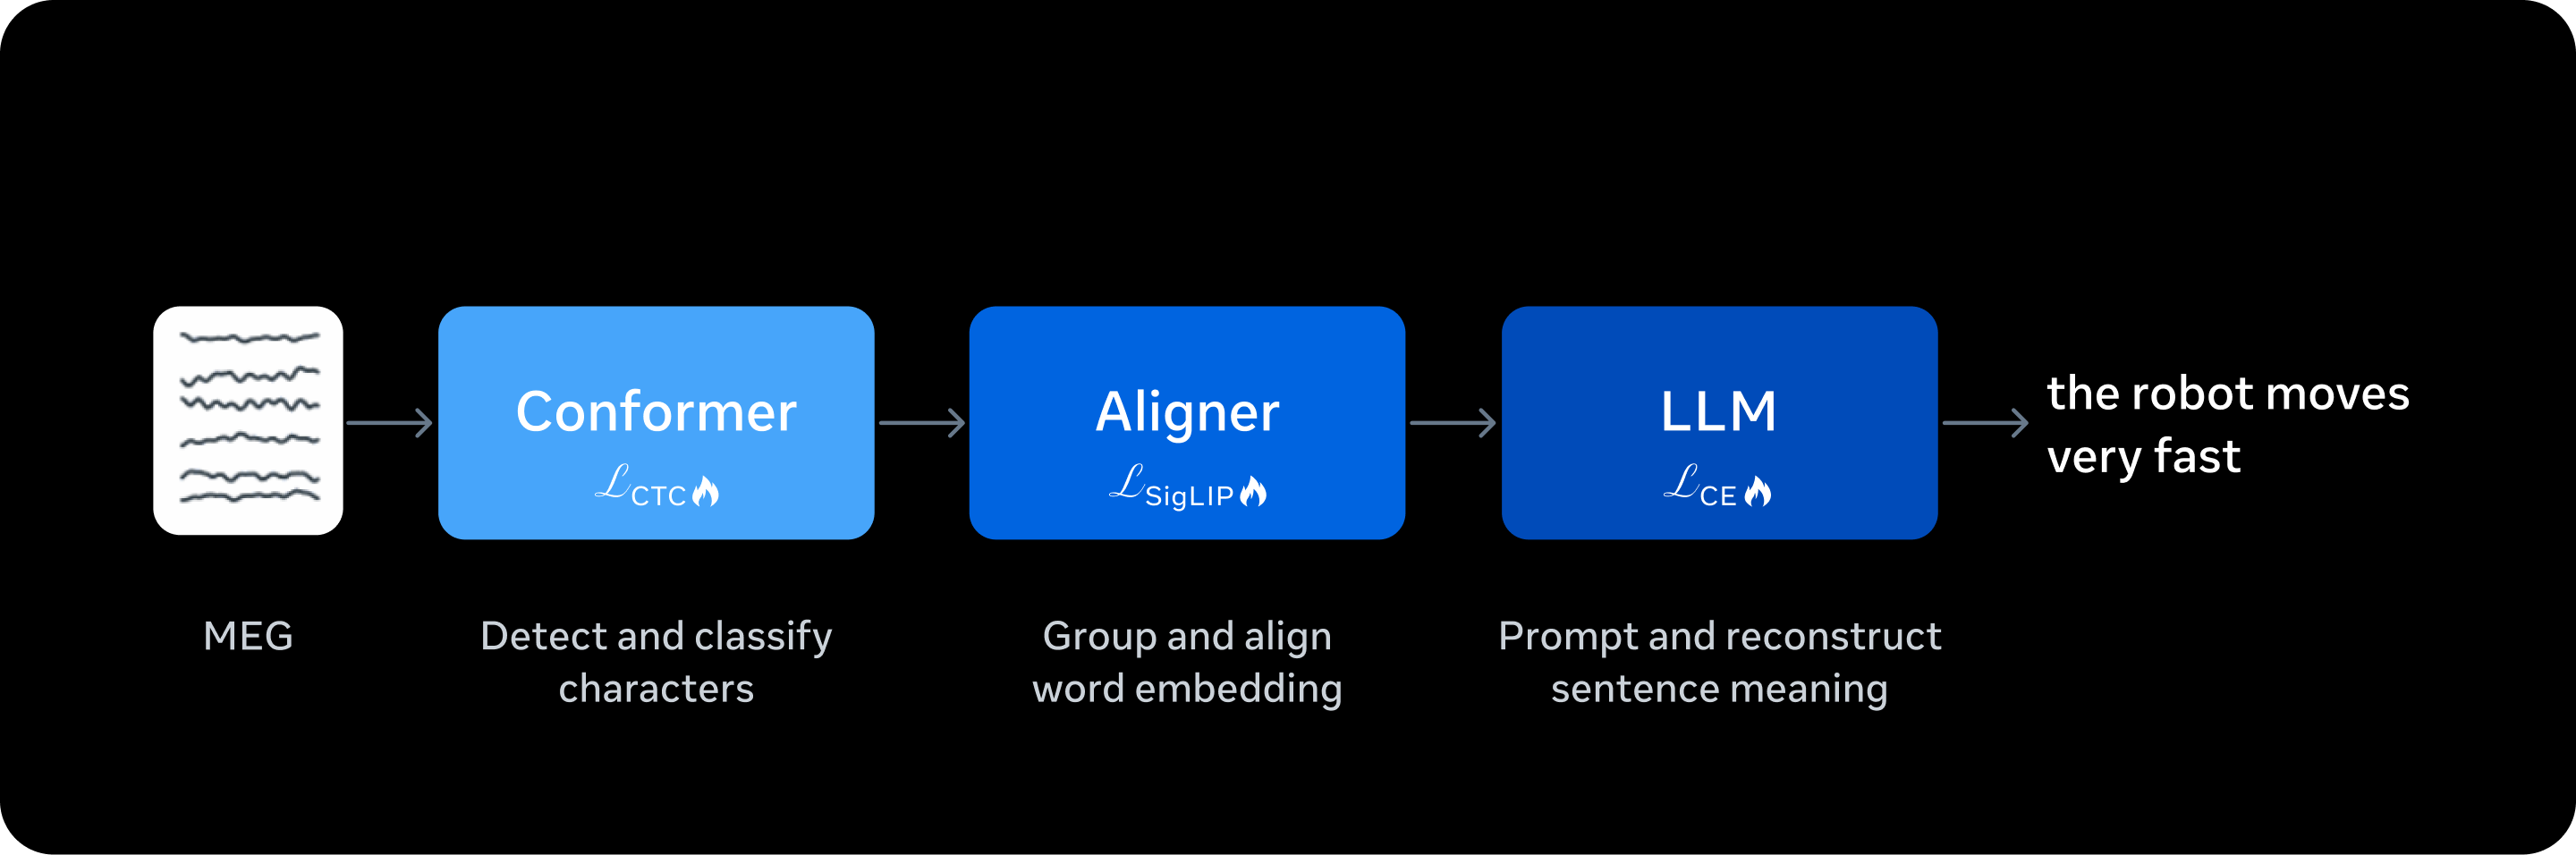
在神经数据上微调大语言模型,使系统能够利用语义上下文,弥合嘈杂的脑记录与连贯语言之间的差距。我们还部署了 AI 智能体来探索解码流水线的优化方案,最终的训练配置则由工程师手动选定。
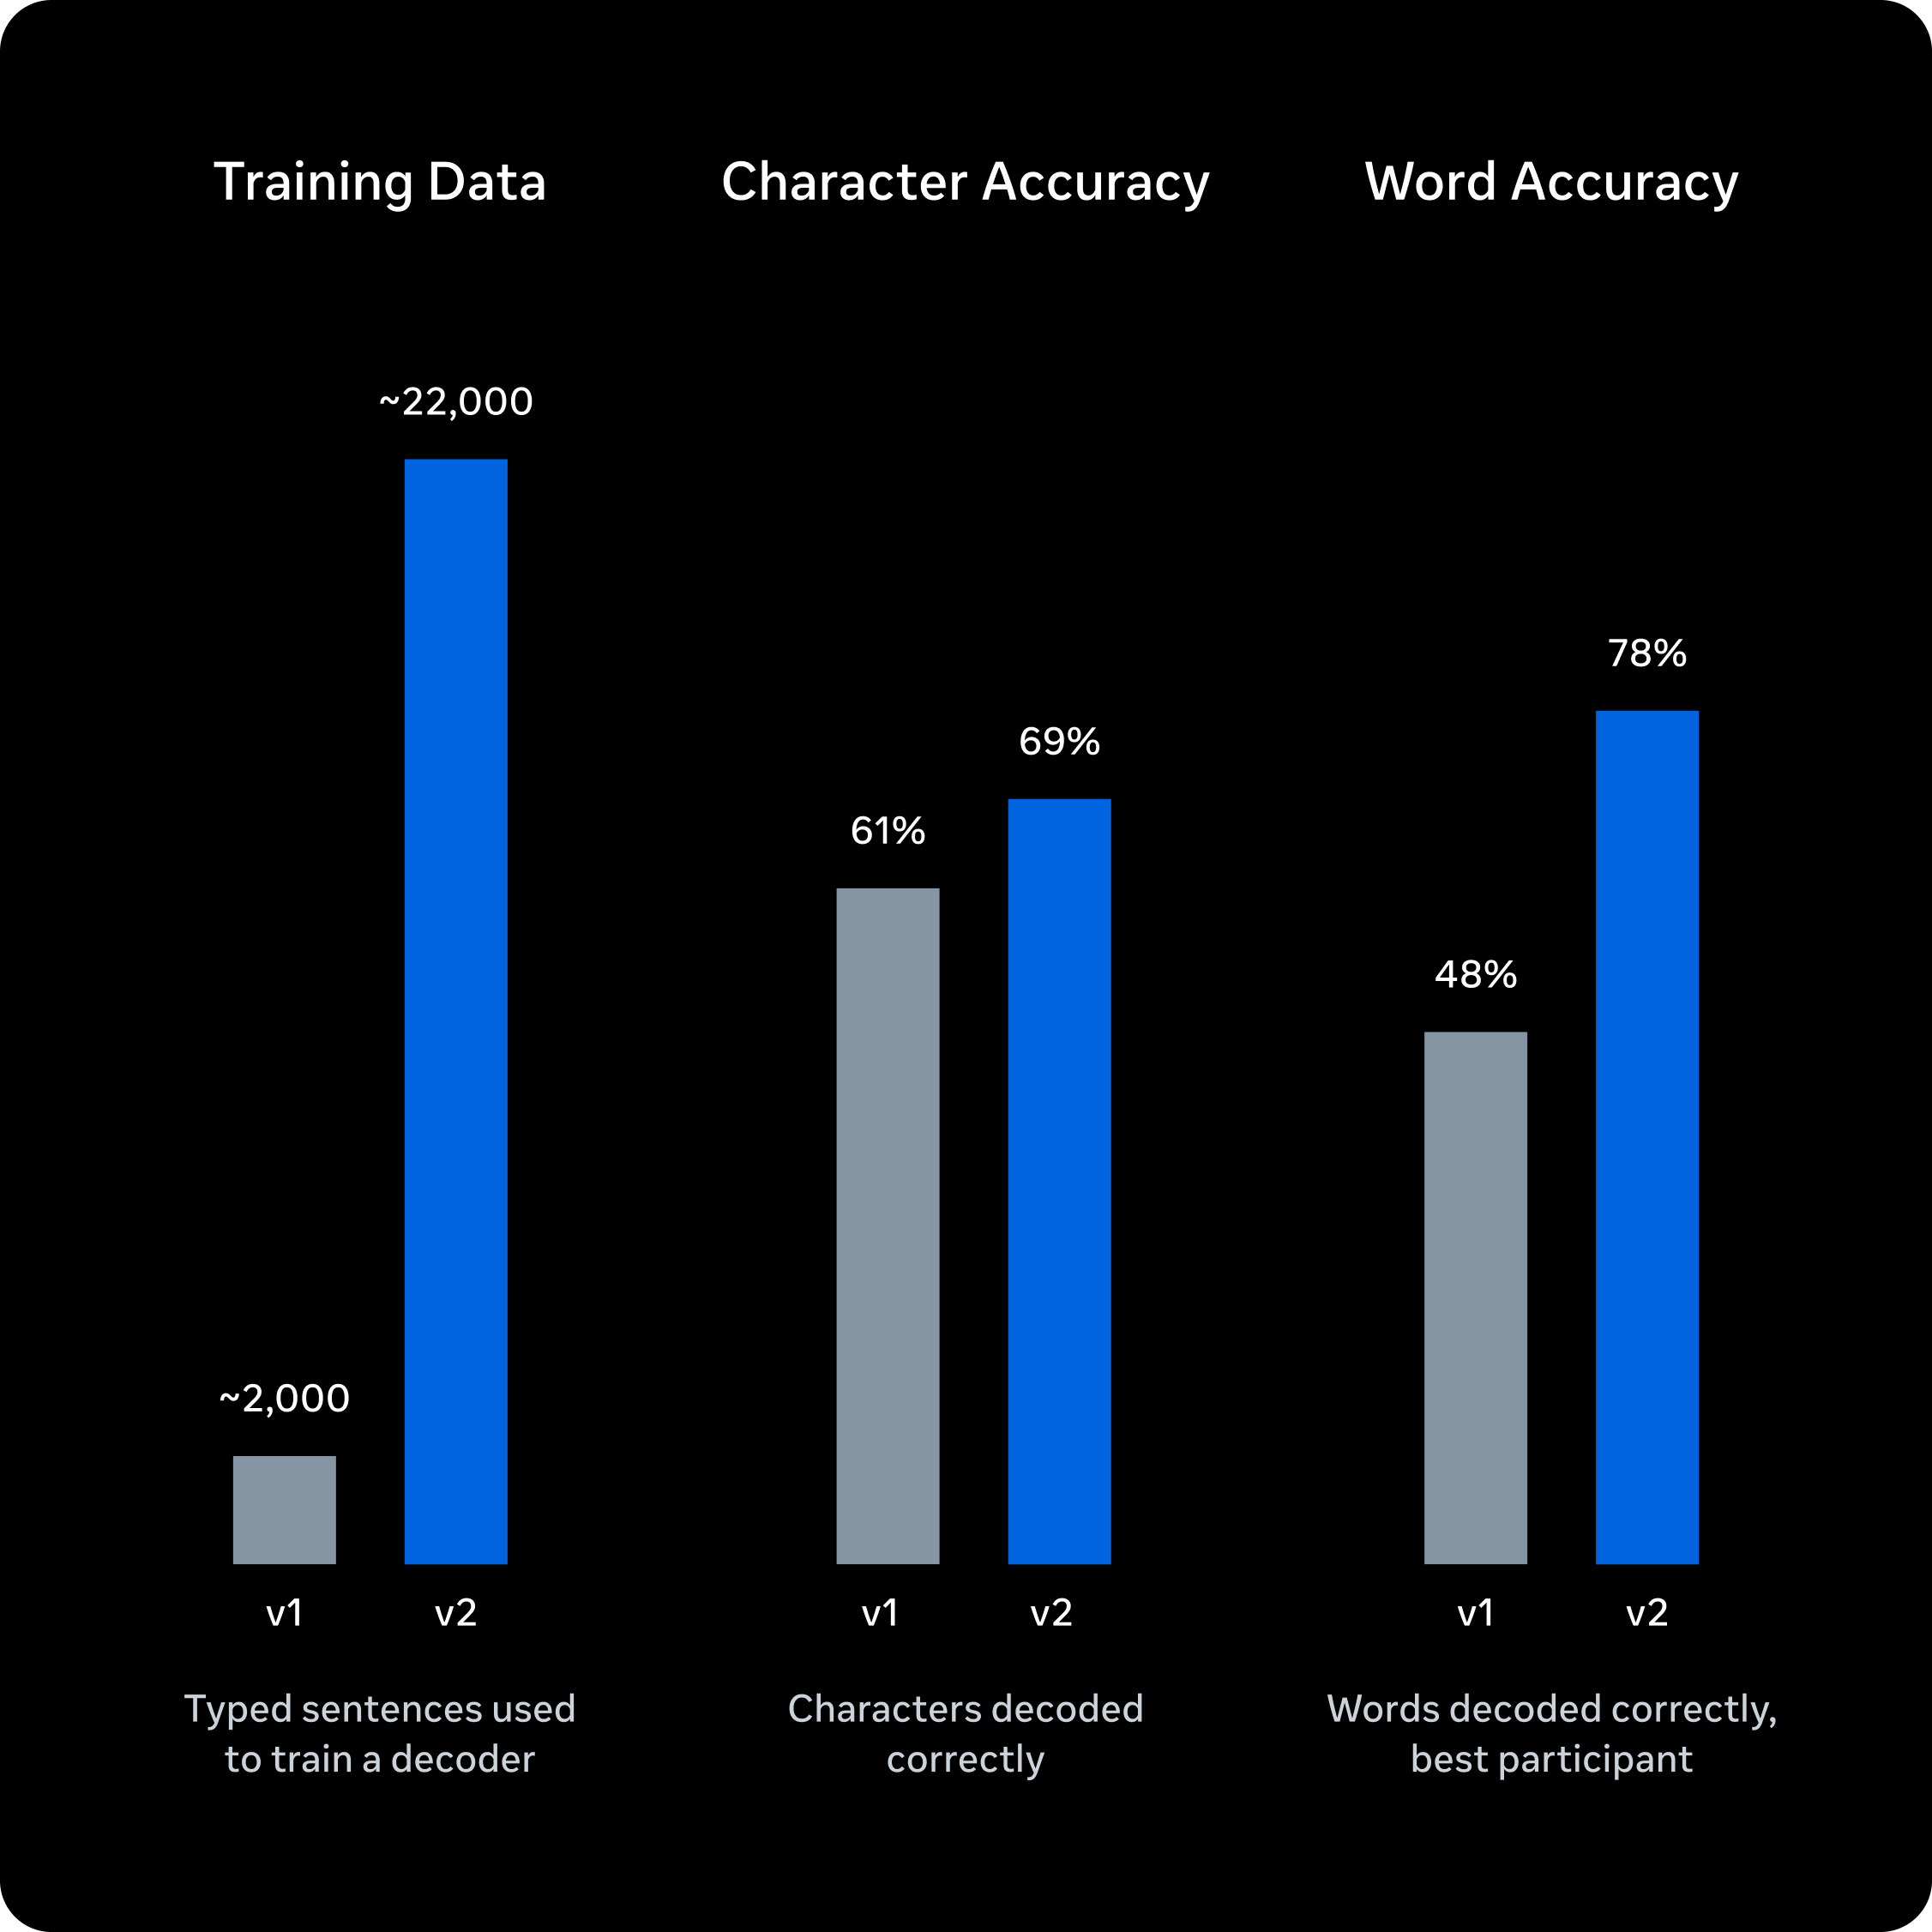
结果是:Brain2Qwerty v2 能从嘈杂的神经输入中连贯地还原句子,单词准确率达到 61%,大幅超过其他非侵入式方法的 8% 单词准确率。对于表现最好的参与者,我们实现了 78% 的单词准确率,超过一半的句子解码出来最多只有一个单词错误。
我们还发现,解码准确率随数据量呈对数线性提升,这表明与手术方法之间剩余的性能差距,仅靠扩大数据规模就有可能进一步缩小。这项工作是我们构建开放的大脑基础模型这一努力的一部分,相关成果包括用于感知编码的 Tribev2 模型、用于大规模处理脑数据的 NeuralSet,以及用于系统评估模型的 NeuralBench。我们与社区密切合作,近期还通过 Digital Brain Project 设立了 500 万美元的基金来推动开放数据集。我们希望这项公开进行的工作,能比各自为战更快地推动神经科学在神经系统疾病的识别、诊断和治疗方面取得进展。
阅读 Brain2Qwerty v2 论文
下载代码
下载数据
阅读 Brain2Qwerty v1 博客
阅读 Nature Neuroscience 上关于 Brain2Qwerty 的文章