每一次 NVIDIA CUDA Toolkit 的发布,都会带来新功能和性能改进,帮助开发者从 NVIDIA GPU 和更广泛的 NVIDIA 软件平台中获得更多价值。
CUDA Toolkit 13.4 新增了对 Windows on Arm 的支持。CUDA 应用此前一直通过 Linux 支持 Arm 平台;此次发布将这一能力扩展到了 Windows on Arm 平台。
本次发布还提供了对 NVIDIA Rubin GPU 架构的早期开发者支持、增强的 GPU 管理能力、扩展的 CUDA Python 和 CCCL 功能,以及 NVIDIA Nsight 开发者工具和核心数学库的更新。
CUDA 13.4 增强功能
本节详细介绍 CUDA 13.4 中的其他增强功能。
以预览形式向开发者开放 NVIDIA Rubin
CUDA Toolkit 13.4 以预览形式新增了对 NVIDIA Rubin 架构(计算能力 107)的功能性支持,让开发者可以在 Rubin 的 CUDA 支持于未来某个 CUDA Toolkit 版本中正式发布(GA)之前,就开始移植应用。Rubin 是驱动智能体 AI 时代的下一代 GPU 架构。
Multi-Process Service V3
多进程服务(MPS)V3 为 CUDA MPS 引入了现代化的控制层,简化了共享 GPU 资源的自动化与管理。此次更新为开发者和编排层提供了可脚本化的 CLI、具名服务器实例,以及用于组织并发工作负载的命名空间。它还新增了 TOML 配置支持、流式多处理器(SM)分区控制,以及与 cgroup 集成的 GPU 显存限制。这些能力可实现精确的 GPU 分区,通过编程方式定义计算性能、显存边界和执行优先级。本次发布确保 MPS 能够融入容器化环境,在最大化硬件利用率的同时,为每个进程保持严格的资源隔离。要开始使用 MPS V3,请参阅快速入门和完整文档。
CUDA Compute Fabric Transport
CUDA Compute Fabric Transport(CFT)为高级应用和通信库引入了一种以传输为中心的方式,可在大规模 NVIDIA NVLink 互连结构上移动数据。软件不再需要把每一个远端 GPU 分配都映射到进程的虚拟地址空间,而是可以通过端点 ID 和偏移量指向具名的逻辑端点,然后直接从 GPU 发起异步的 put、get 和归约操作。
这种方式降低了大型多 GPU 系统中的虚拟地址压力,支持单播和多播通信模式,并会报告完成与错误状态,使应用能够检测、重试或改道处理失败的互连传输。
CFT 仅通过 CUDA Driver API 提供,面向那些需要更高层通信库所不具备的特定功能的通信库开发者。大多数应用开发者最适合使用 NVIDIA NCCL 或 NVSHMEM 等库。要了解更多,请参阅 CUDA Programming Guide。
局部性域(Locality domains)
CUDA 13.4 提供了对局部性域的编程访问。局部性域是 GPU 的一部分,包含流式多处理器(SM)和设备显存。应用可以在某个局部性域中分配设备显存,并创建一个在同一局部性域内拥有 SM 资源的绿色上下文(green context)。将计算放在靠近其所访问显存的位置,可以提升拥有多个局部性域的设备的性能。有关如何查询和使用局部性域的更多信息,请参阅 CUDA Programming Guide。
查询统一内存的位置
用于查询统一内存驻留信息的 API 支持,为对性能敏感的库和运行时提供了一种直接的方式,来了解托管数据或系统分配数据当前驻留在何处。统一内存让异构编程更简单,但高性能软件仍然需要局部性感知,以避免不必要的页迁移、远程内存访问或低效的中转路径。借助驻留查询,CUDA 应用和库可以更明智地决定在何处、何时调度计算和数据移动。要了解更多,请参阅以下内容的 API 参考:cudaMemGetLocationInfo.
CUDA 驱动与 CUDA 工具包解耦
CUDA SDK 安装程序不再捆绑 NVIDIA 驱动。请使用你偏好的包管理器,单独安装相应的 nvidia-open 驱动或 cuda-toolkit 软件包。
一致性平台默认采用 Coherent Driver-based Memory Management
在 NVIDIA Grace Hopper、NVIDIA Grace Blackwell 和 NVIDIA Vera Rubin 等 NVIDIA 一致性平台上,驱动现在默认使用基于一致性驱动的内存管理(Coherent Driver-based Memory Management,CDMM),而不再是 NUMA。NUMA 模式仍然完全受支持,可通过内核模块参数选择。如果你打算使用它,请在升级之前完成更改。这是一项节点级的全局设置,需要重新加载驱动或重启。该模式应当在升级之前选定。有关 CDMM 的更多信息,请参阅文章理解硬件一致性平台上的内存管理和白皮书。
编译器/NVCC
主机编译器兼容性现已包括受支持主机平台上的 GCC 16 和 Clang 22。新的 SM_107 架构目标支持为 Rubin GPU 编译。
CUDA Python
CUDA Python 扩展了对核心 CUDA API 和高性能算法的 Pythonic 访问,并在开发工具、内存管理、图(graph)工作流和应用可移植性方面带来更新。
cuda.core
继 CUDA Python 1.0 发布之后,cuda.core 1.1.0 扩展了稳定的 Pythonic CUDA API,新增纹理与表面编程、更丰富的托管内存控制、改进的 CUDA 图集成,以及面向开发工具和智能体的完整类型信息。
完整的变更列表,请参阅 cuda.core 1.1.0 发行说明。
纹理与表面编程
新的 cuda.core.texture 模块为 CUDA 纹理和表面内存提供了一等公民级别的 Python API。OpaqueArray 和 MipmappedArray 表示按硬件布局的 GPU 分配,TextureObject 支持无绑定(bindless)、由硬件做过滤的内核读取,SurfaceObject 则支持带类型的内核端加载与存储。以下示例创建一个不透明的 CUDA 数组,并将其绑定到纹理对象,用于由硬件做过滤的内核读取。
from cuda.core import Device
from cuda.core.texture import (
      OpaqueArrayOptions,
      ResourceDescriptor,
      TextureObjectOptions,
)
from cuda.core.typing import ArrayFormatType, FilterModeType

dev = Device()
dev.set_current()
stream = dev.create_stream()

with dev.create_opaque_array(
      OpaqueArrayOptions(
          shape=(1024, 1024),
          format=ArrayFormatType.FLOAT32,
          num_channels=1,
      )
) as array:
      array.copy_from(image, stream=stream)

      resource = ResourceDescriptor.from_opaque_array(array)
      options = TextureObjectOptions(filter_mode=FilterModeType.LINEAR)

      with dev.create_texture_object(
          resource=resource,
          options=options,
      ) as texture:
          # Pass texture.handle to a CUDA C++ kernel.
          run_kernel(texture.handle)
支持 NUMA 感知的托管内存
ManagedMemoryResource.allocate() 现在返回一个带有基于属性的接口的 ManagedBuffer,用于 CUDA 内存建议(memory advice)。应用可以配置以读为主的数据、首选放置位置和处理器访问权限。
新的 Host 类型在指定内存位置时与 Device 相互补充。它可以表示任意主机内存、某个特定的 NUMA 节点,或与调用线程相关联的 NUMA 节点。
以下示例配置托管内存的放置与访问,将数据预取到 GPU,然后把输出移动到主机内存。
from cuda.core import Device, Host, ManagedMemoryResource
from cuda.core.utils import prefetch_batch

dev = Device()
dev.set_current()
stream = dev.create_stream()

mr = ManagedMemoryResource()
weights = mr.allocate(weights_nbytes, stream=stream)
output = mr.allocate(output_nbytes, stream=stream)

weights.read_mostly = True
weights.preferred_location = dev
weights.accessed_by.add(dev)

prefetch_batch(stream, [weights, output], dev)

# Launch GPU work, then move the result to host memory.
output.prefetch(Host(), stream=stream)
stream.sync()
改进的开发与图工作流
cuda.core 1.1 为每个公共 API 提供 .pyi 类型存根,让 IDE 获得自动补全,也让编码智能体能够获取类型信息、函数签名、返回类型等。
在众多 CUDA 图工作流改进中,GraphBuilder.graph_definition 将捕获的图暴露为一个 GraphDefinition。开发者可以借此把流捕获与显式的图构建结合起来,包括检查或扩展已捕获的图。
其他新增内容包括:按设备枚举 NVLink、扩展的绿色上下文工作队列配置、Program 和 ObjectCode 支持类路径输入,以及公开的 Buffer.size 属性。本次发布还强化了 IPC 校验、自由线程(free-threaded)Python 的正确性,以及 CUDA 进程检查点恢复。
cuda.compute
cuda.compute 以 Pythonic 的方式提供对 NVIDIA CUDA Core Compute Libraries(CCCL)中高性能、可定制 GPU 算法的访问,包括排序、扫描、归约、变换等。
cuda.compute 1.1 支持针对多种 GPU 架构对算法对象进行提前(AoT)编译,包括在没有 GPU 的构建系统上。ProxyArray 和 ProxyValue 在不分配设备显存的情况下描述参数类型,而 serialize() 会创建一个可存储和部署的产物。在目标系统上,deserialize() 无需重新编译即可恢复该算法,并加载与当前 GPU 架构相匹配的构建。
以下示例在无需 GPU 的情况下为 sm_80 和 sm_90 编译一个归约操作,然后保存下来以便后续部署。
import numpy as np

from cuda.compute import (
      OpKind,
      ProxyArray,
      ProxyValue,
      make_reduce_into,
      serialize,
)

reducer = make_reduce_into(
      d_in=ProxyArray(np.int32),
      d_out=ProxyArray(np.int32),
      op=OpKind.PLUS,
      h_init=ProxyValue(np.int32),
      compute_capability=[80, 90],  # Build for sm_80 and sm_90.
)

with open("reduce.cclb", "wb") as file:
      file.write(serialize(reducer))
CCCL
CUDA 13.4 附带 CCCL 3.4,其特性包括:NVIDIA Blackwell GPU 上更快的 cub::DeviceScan、覆盖 CUB 设备级算法的单次调用 API、批量 warp 归约,以及 cuda::std 中熟悉的 C++ 标准库并行算法。
NVIDIA Blackwell GPU 上更快的设备级扫描
现已提供面向 Blackwell 的 cub::DeviceScan 全新 warp 特化实现。该实现利用张量内存加速器(Tensor Memory Accelerator,TMA),使内存搬运与计算相互重叠,同时降低同步开销。
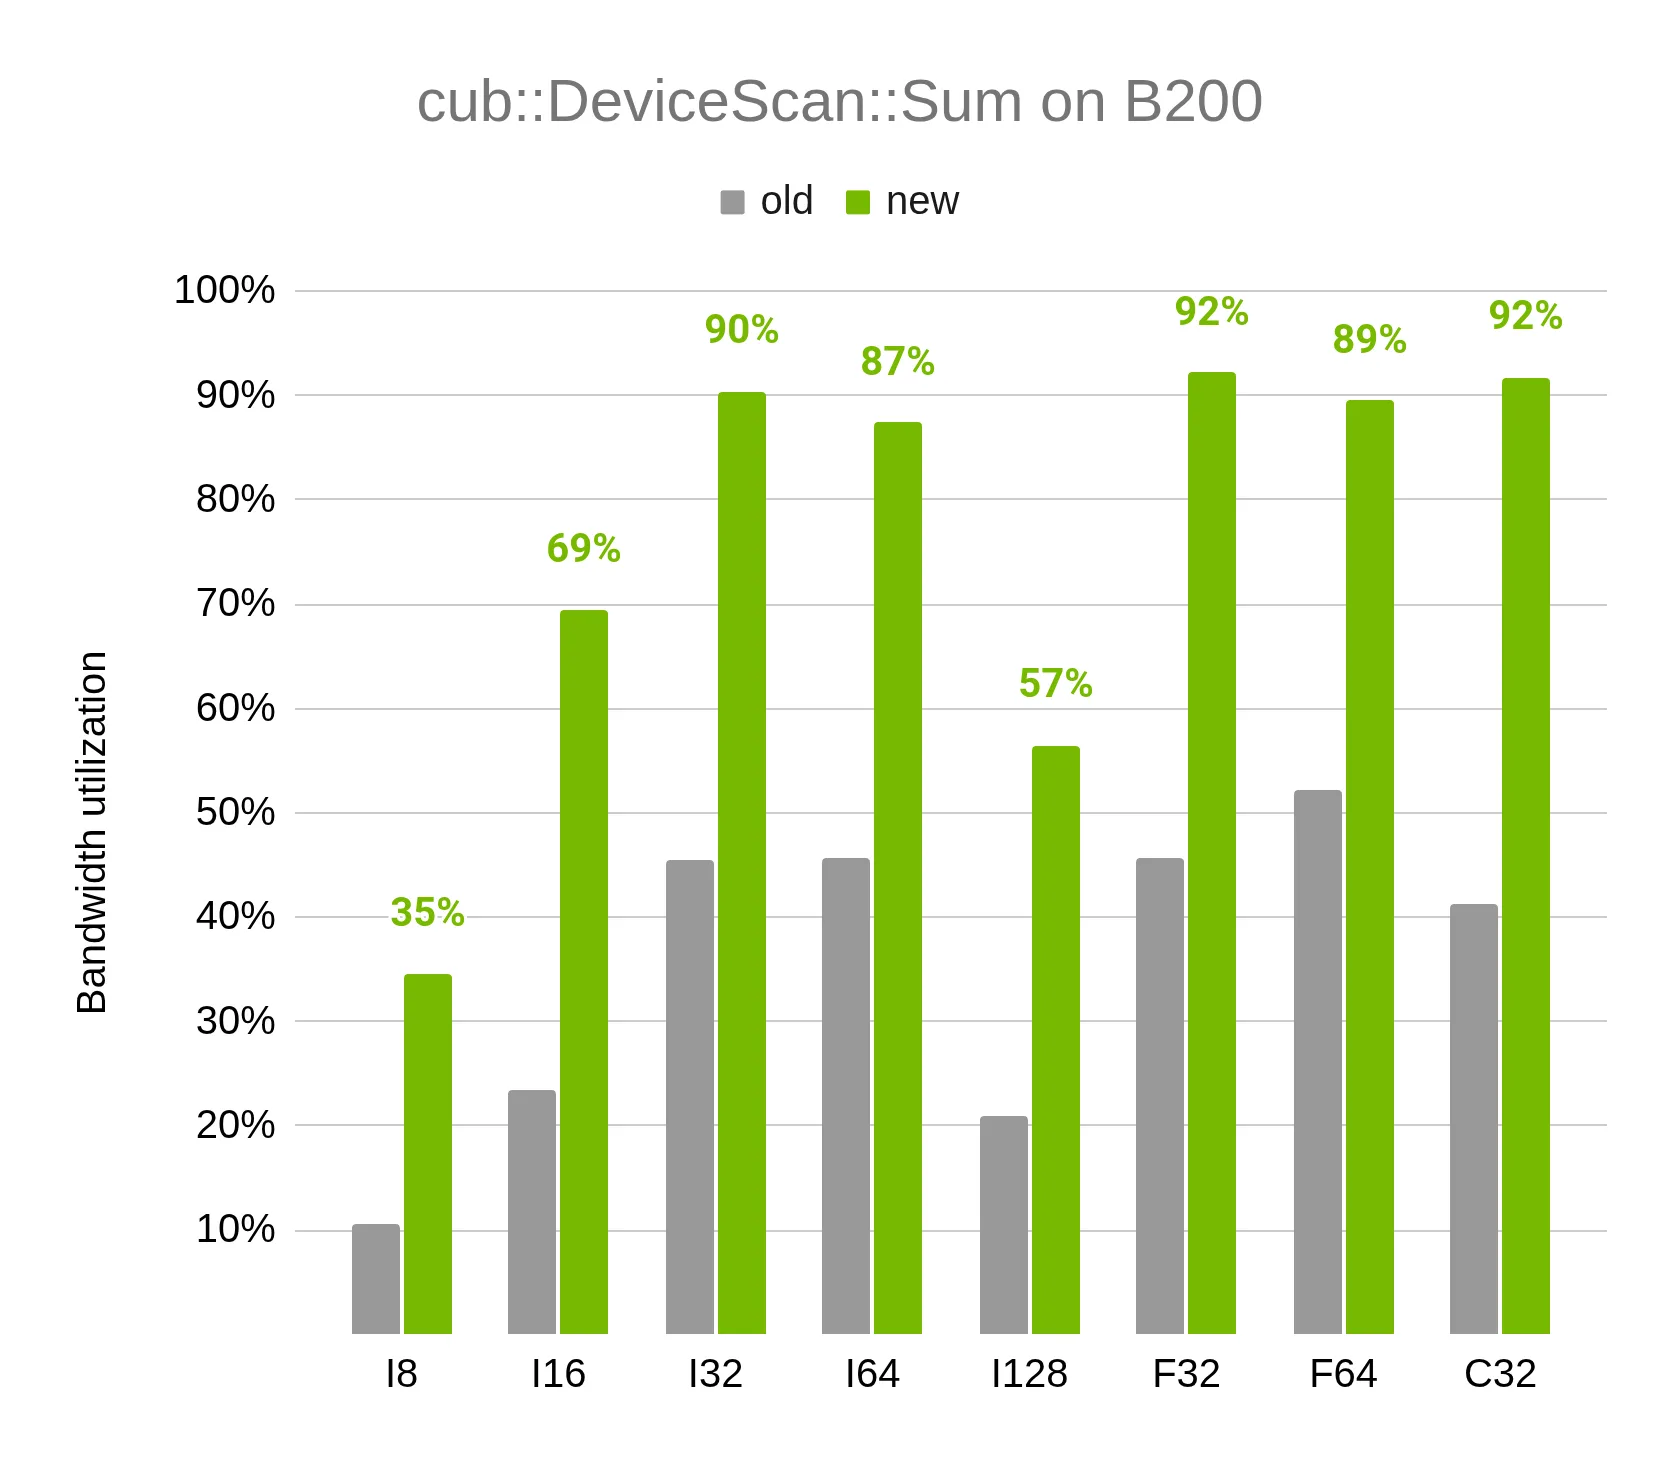
在 NVIDIA Blackwell GPU 上的基准测试结果中,新的 cub::DeviceScan::Sum 实现在所测试的各种数据类型上,内存带宽利用率最高可达 92%(此前实现最高约为 50%)。该实现针对大规模扫描负载做了优化,同时为不受支持的架构、数据类型、迭代器和工具链保留了回退路径。
面向 CUB 设备级算法的单次调用 API
CCCL 3.4 完成了基于执行环境的单次调用重载在 CUB 设备级算法上的全面铺开。此前,应用通常需要先调用一次 CUB 算法来确定其临时存储需求,分配该存储,然后再调用一次算法来执行操作。新的重载则从通过执行环境提供的内存资源中获取临时存储。更多信息请参阅用单次调用 API 简化 CUB和 CUB 设备级原语文档。
以下示例创建了一个带有 CUDA 流和内存池的执行环境,然后在无需手动管理临时存储的情况下运行一次归约。
auto device = cuda::devices[0];
auto stream = cuda::stream{device};
auto pool   = cuda::device_default_memory_pool(device);

auto env = cuda::std::execution::env{
      cuda::stream_ref{stream},
      pool
};

cub::DeviceReduce::Sum(d_input, d_output, num_items, env);
这既减少了样板代码,又集中了对算法如何执行以及如何获取临时存储的控制。传统的两阶段 API 并未被弃用,仍然可供需要显式管理存储的应用使用。
warp 内的批量归约
新增了一个 CUB warp 级集合操作 cub::WarpReduceBatched,用于对分布在一个 warp 中的多个独立批次的值进行归约。它会将这些批次一并处理,尽量减少 shuffle 操作,并提高每个 warp 所完成的有效工作量。
GPU 上的并行 C++ 标准库算法
CUDA 13.4 在 cuda::std 中引入了 C++ 标准库的并行算法模型。开发者可以使用 cuda::execution::gpu 执行策略调用数十种熟悉的算法,包括 copy_if、find_if、merge,以及归约、变换和扫描操作。
以下示例使用 GPU 执行策略,将一个设备可访问区间中的正值复制到另一个区间。
#include <cuda/std/algorithm>
#include <cuda/std/execution>

struct is_positive
{
    __host__ __device__
    bool operator()(int value) const
    {
        return value > 0;
    }
};

cuda::std::copy_if(
      cuda::execution::gpu,
      d_first,
      d_last,
      d_output,
      is_positive{}
);
这些算法作用于设备可访问的区间,底层使用 CCCL 和 CUB 的实现。这为 CUDA C++ 开发者提供了一个标准且易于辨识的 GPU 执行接口,同时仍可通过可定制的执行策略使用流和内存资源等 CUDA 特有功能。更多细节请参阅 cuda::std 并行算法文档。
CUDA Tile IR 支持 Programmatic Dependent Launch
CUDA Tile IR 新增了对 Programmatic Dependent Launch(PDL)的支持,使同一 CUDA 流上的内核之间可以相互重叠,让依赖内核在其前驱内核完成之前就开始执行。要了解这些操作的更多信息,请参阅 CUDA Tile IR 发行说明。
CUDA Tile C++ 中的新视图
CUDA Tile C++ 新增了用于加载和存储数据的视图。
- 跨步视图(Strided view)会创建大小静态确定的数据块,块与块之间的间距由编译期的步长因子决定。这有助于实现模板(stencil)类操作中常见的数据访问模式。
- 聚集散射视图(Gather scatter view)支持访问数组中不相邻的数据块。这有助于访问具有稀疏访问模式的数据。
开发者工具
以下是开发者工具方面的一系列增强。
Nsight Python
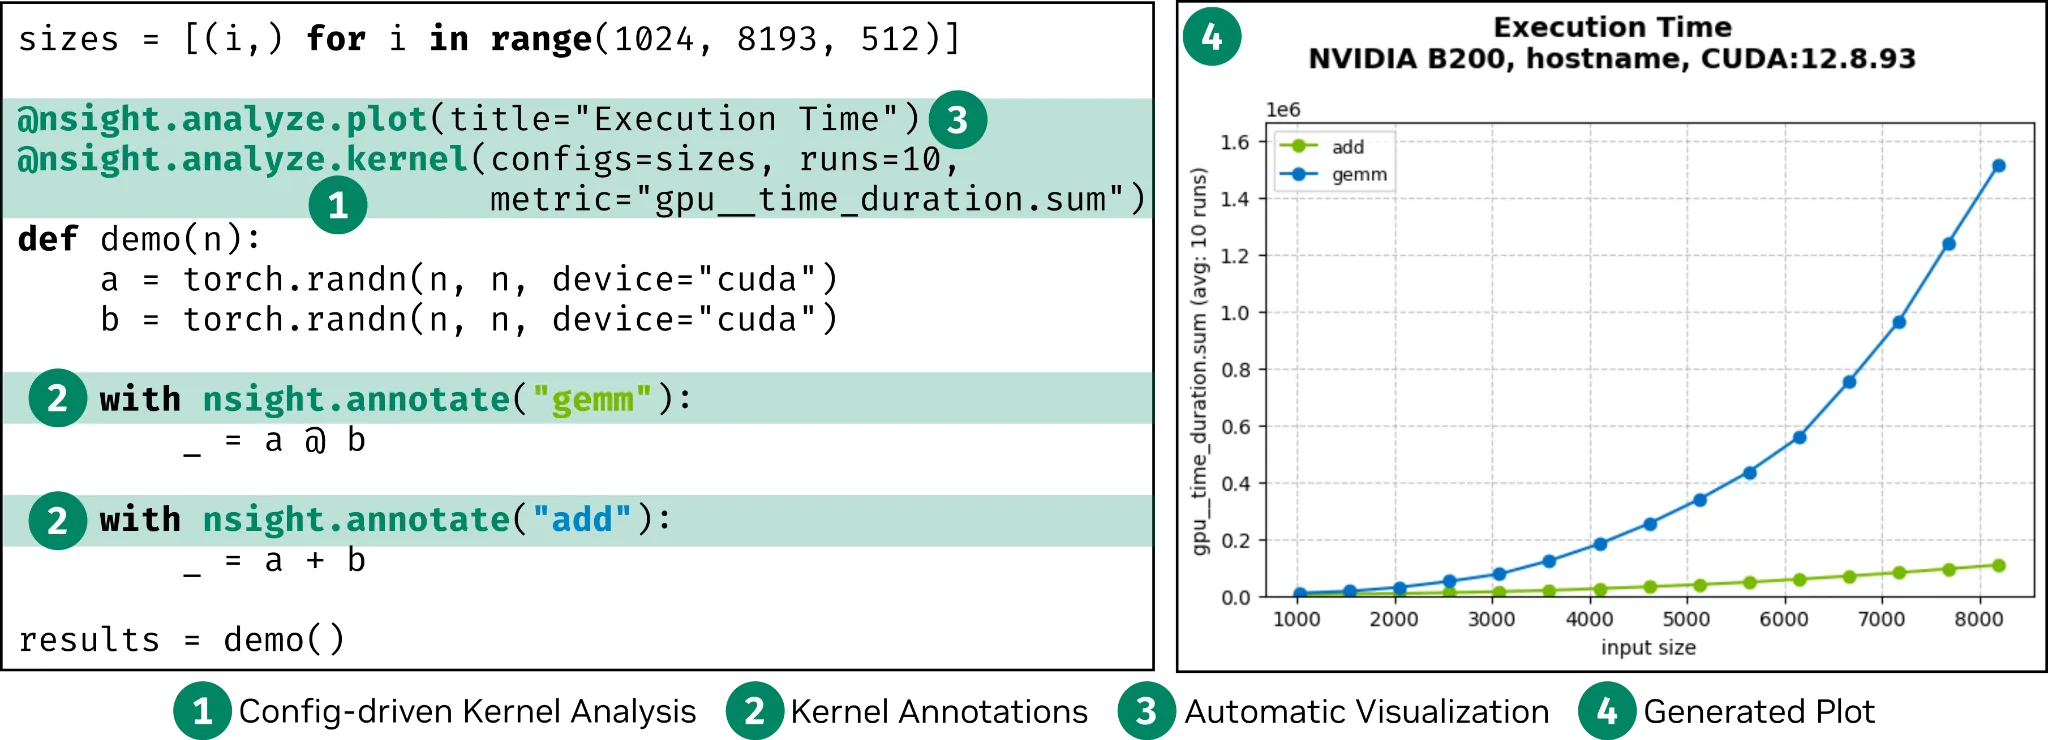
Nsight Python 1.0 是一个 Python 内核性能分析接口,借助 NVIDIA Nsight 工具,自动完成跨多种内核配置的性能分析。通过装饰器和上下文管理器,可以在一个脚本中完成内核基准测试、架构指标采集、GPU 降频预防和性能可视化。无需样板代码,也无需手动解析报告。Nsight Python 以极小的代码开销,提供可扩展的架构指标,而不仅仅是墙上时钟计时。
NVIDIA Nsight Compute
Nsight Compute 2026.3 为 CUDA Tile 工作负载新增了 Tile IR 支持,开发者可以在源码页面中查看 Tile IR,并将其与 CUDA Tile 源码及生成的代码关联起来。该版本还改进了 OptiX 工作负载的寄存器溢出(register-spill)信息,并增强了 Nsight Copilot。
NVIDIA Nsight Systems
Nsight Systems 2026.5.1 扩大了在 CUDA、CPU、AI 框架、网络和存储方面的平台覆盖范围与工作负载可见性。该网页版新增了对 CUDA 13.4、Rubin GPU 和 Windows on Arm 的支持。它还将 NVTX 区间投射到“All Streams”层级结构中,还原(demangle)cuTile 名称,并在时间线上显示通过 CiG 流提交的 CUDA 工作负载。
CPU 指标集将相关的硬件计数器分组,以便一次采集完成,帮助开发者通过 Topdown 指标集逐步定位瓶颈。对于 PyTorch 工作负载,新的 --pytorch=functions-trace-shapes 选项会向被追踪的函数添加张量形状和训练参数等信息。开发者可以在形状追踪提供的额外细节与现有函数追踪选项的较低开销之间做出选择。
网络、存储与集群性能分析
网络性能分析新增了通过 NVIDIA DOCA Telemetry Service 进行的高频网卡(NIC)指标采集,使开发者无需提升权限,即可将流量、拥塞通知和发送等待与应用活动关联起来。新的 NCCL 掉队者(straggler)分析方案会分析集合通信的耗时,找出反复拖慢通信器进度的 rank。有关采集要求和方案用法,请参阅 Nsight Systems 用户指南和采集后分析指南。
存储性能分析现在包含一个 S3 访问汇总分析方案,可汇总跨进程和主机的访问模式与 I/O 统计信息,帮助找出热点存储桶和对象、频繁的小数据量传输以及工作负载失衡。NVIDIA SCADA 指标分析将 SCaled Accelerated Data Access 存储架构中的计数器和直方图带入时间线,开发者可以在其中将存储服务器的活动与 GPU 和 CPU 事件关联起来。
对于多节点和集群的性能分析,实验性的 vClock 插件可以在 PTP 等高精度同步不可用时改善报告对齐,既不需要修改系统时钟,也不需要特权访问。
二进制负载与插件开发
NVTX 二进制负载现在可以导出为动态关系表,负载字段表示为列,以便在 SQLite、Arrow 以及 Arrow/Parquet 格式中做下游分析。Nsight Systems 插件框架还新增了初始化阶段、进程退出回调 API,以及在子进程中加载插件库的能力。开发者可以在应用启动之前初始化采集,捕获关闭过程中产生的数据,并将性能分析覆盖范围扩展到子进程。
NVIDIA Nsight Cloud
Nsight Cloud 让在远程无头系统上查看和分析性能分析报告变得更容易。Nsight Operator 在分析、OpenTelemetry 和 NVIDIA Dynamo 方面做了改进,并上线了新的文档站点。
NVIDIA Nsight AI
Nsight AI 将专门的 AI 辅助带入加速计算开发工作流。由 NVIDIA 托管的 CUDA MCP Server 可将受支持的 AI 编码智能体连接到最新的 CUDA 文档和代码示例,而开源的 Nsight Copilot Blueprint 则提供自托管的 CUDA AI 后端,适合希望在自己环境中部署和运维的团队。
NVIDIA Compute Sanitizer
Compute Sanitizer 改进了共享内存越界检测,在 Hopper 及更新架构上采用编译期补丁方式。Initcheck 现已支持 Batched memcpy async,racecheck 则支持按集群块(per-cluster-block)过滤。
NVIDIA 核心数学库
CUDA Toolkit 13.4 中的核心数学库现已对 Rubin GPU 架构提供功能性支持,并为 N1X 笔记本生态提供 Windows on Arm 支持。
13.4 中 cuBLAS 的更新包括以下特性:
- cuBLAS 通过 Ozaki-II 方案的定点仿真提升了双精度性能。
- 在 Blackwell 数据中心 GPU 上,cuBLASLt 会跨流式多处理器(SM)动态调度 Grouped GEMM 计算,以尽量减少常见 MoE 工作负载中的负载不均。与早期的工具包版本相比,这种方式提升了包含大量分组(例如 32 个)的 Grouped GEMM 调用的性能。当 Grouped GEMM 操作与其他设备内核并发运行时,它同样可以提升性能。
- cuBLASLt 新增了实验性的缩放模式
CUBLASLT_MATMUL_MATRIX_SCALE_VEC32_MN_K4_UE8M0和CUBLASLT_MATMUL_MATRIX_SCALE_VEC128_MN_K4_UE8M0,它们采用另一种缩放因子布局,支持A和BFP8 精度张量。这些模式将缩放因子按 4 个一组打包,并以 M 主序或 N 主序布局存储。当主维度不能被 4 整除时,会添加填充。更多细节请参阅文档。
开始使用 CUDA Toolkit 13.4
CUDA Toolkit 13.4 拓展了 CUDA 开发的边界:支持 Windows on Arm,预览支持 NVIDIA Rubin GPU 架构,更新了 GPU 资源管理与通信能力,并在 CUDA Python、CCCL、NVIDIA Nsight 开发者工具和核心数学库方面带来了增强。
下载 CUDA Toolkit 13.4,并查阅 CUDA Toolkit 13.4 发行说明,了解完整的功能列表、支持的平台和兼容性信息。
致谢
感谢以下 NVIDIA 贡献者:Andy Terrel、Rob Armstrong、Jackson Marusarz、Mahender Hari、Becca Zandstein、Mridula Prakash、Daniel Rodriguez、Noah Stern。