Hugging Face WebAI 团队最大的目标之一,是让浏览器内推理尽可能快、尽可能易用。要做到这一点需要多层面的努力:模型需要适合浏览器的表示形式,运行时需要构建高效的执行计划,而位于技术栈最底层的各个 GPU 操作,则需要充分发挥众多不同设备和浏览器实现的性能。
今天,我们发布这项工作的第一层:@huggingface/kernels,这是一个用于从 Hugging Face Hub 加载并运行优化 WebGPU 内核的极简库,同时发布的还有首批共 207 个内核,位于 huggingface.co/webgpu-kernels。
这批内核覆盖了各类机器学习架构和工作负载中用到的操作。更重要的是,每个内核都以完整、带版本的软件包形式发布:它的接口、着色器模板、正确性用例、基准测试用例和使用说明都集中放在 Hub 上。
我们还推出了 Fleet,一套在浏览器内运行的 GPU 基准测试套件,可以在你的硬件上运行内核并打分。除了得到自己机器上的结果之外,Fleet 还为社区提供了一种途径,让大家贡献来自各种设备的性能和正确性证据,而这些设备是我们在常规测试实验室里永远无法覆盖的。经你同意后,每次运行都会增加一份私密证据,帮助我们发现故障(结果错误、慢得离谱的情况等)、改进内核变体,并在真实世界的各种硬件上做出更好的优化决策。
太长不看
- 207 个 WebGPU 内核,作为独立仓库发布在
webgpu-kernels组织下,采用 Apache-2.0 许可证。 - 一个 JavaScript 加载器
@huggingface/kernels,可直接从 Hub 下载、准备并运行内核。 - 每个内核都有明确的契约和可复现的证据,包括清单(manifest)、正确性测试、基准测试用例和 WGSL 着色器模板。
- Fleet,一个基于浏览器的基准测试工具,通过众包方式收集真实 GPU 上的正确性与性能证据,帮助我们改进内核及其变体。
为什么从内核入手?
在浏览器中运行的模型,最终会变成一连串 GPU 操作:矩阵乘法、归一化、卷积、注意力原语、量化操作、数据布局转换等等。WebGPU 通过可移植的 API 让这些操作可在现代浏览器中使用,而 WGSL 则为执行这些操作的着色器提供了通用语言。
然而,可移植并不会自动带来性能。两个着色器可以实现同一个操作、产生相同的输出,却在不同加速器上表现截然不同。工作组大小、内存访问模式、向量化、数据类型和融合策略都会影响性能。最佳选择还会随输入形状、设备、浏览器和可用的 WebGPU 特性而变化。
这就是内核构成快速浏览器推理基础层的原因。上层运行时的效率,最多只能和它所调度的操作一样高。让这些操作可以被单独发现、测试、做基准测试并进行版本管理,我们就能独立改进底层基础,同时为上层保持稳定的契约。
一个内核仓库,而不只是一个着色器
集合中的每个内核都有自己的仓库和内核卡片。卡片记录了该操作的语义、输入、输出、属性、支持的数据类型、源文件,以及一个可直接运行的 @huggingface/kernels 示例。
例如,ai.onnx.Add 实现了带多向广播的逐元素加法。它是神经网络中最简单的操作之一,从残差连接到加偏置,处处都会用到。它的卡片记录了两个输入、广播后的输出形状、支持的数据类型,以及适用于不同形状和设备的变体。
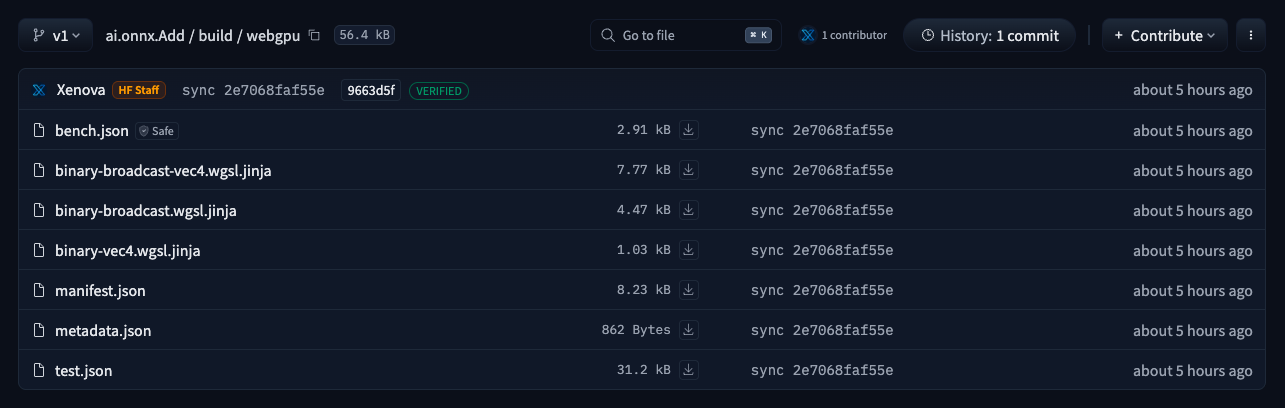
ai.onnx.Add 仓库把清单、正确性与基准测试用例以及 WGSL 着色器模板打包在一起。在卡片背后,仓库中包含理解和评估该实现所需的各种制品:
manifest.json是操作契约的唯一可信来源,定义了输入、输出、属性、类型约束和形状推导规则。metadata.json记录内核标识符、摘要和来源信息。test.json包含正确性用例,可据此对照预期行为检查实现。bench.json包含基准测试和调优用例,代表了评估该内核所用的工作负载。*.wgsl.jinja文件包含参数化的 WGSL 实现,用于针对特定请求和设备生成着色器。
这种结构把着色器变成了可复用的软件制品。无需阅读 WGSL 就能查看接口,正确性和性能用例随实现一同发布,已发布的版本也可以被显式加载,而不必依赖没有版本的文件 URL。我们的内核还可以作为参考实现,供开发自定义 WebGPU 内核或把这些操作集成到自家运行时的开发者使用。
从 Hub 加载内核
从 npm 安装该软件包:
npm install @huggingface/kernels@preview
运行这些内核需要支持 WebGPU 的浏览器。WebGPU 是否可用取决于浏览器、操作系统、GPU 和驱动。你可以在 JavaScript 中用
"gpu" in navigator来检查。
@huggingface/kernels 在内核仓库与你的应用之间架起桥梁。用 Hub 仓库 ID 和契约版本调用 getKernel,然后用带类型的输入数据和张量形状调用返回的函数即可。下面是一个简单的加偏置示例:
import { getKernel } from "@huggingface/kernels";

const add = await getKernel("webgpu-kernels/ai.onnx.Add", { version: 1 });

const { c } = await add({
  a: {
    data: new Float32Array([1, 2, 3, 4, 5, 6]),
    shape: [2, 3],
  },
  b: {
    data: new Float32Array([10, 20, 30]),
    shape: [3],
  },
});
第二个输入沿第一个维度广播,生成形状为 [2, 3] 的输出。加载器会根据清单契约和输入推导出输出形状和逻辑数据类型,并自动分配 c。
对六个浮点数做加法,有意选了最小的演示规模。在这个规模下,GPU 往返的开销远大于计算本身。重点在于调用模式:对于真正能体现优化内核价值的重型操作,例如矩阵乘法(ai.onnx.MatMul),调用模式完全不变,只需更换仓库 ID 和输入。
即使是这样基础的操作,也能说明内核为什么需要变体。形状相同的加法可以走直接的向量化路径,而广播输入则需要不同的索引逻辑。已发布的 Add 内核包含针对相同形状、向量化广播、标量处理和通用广播的变体。运行时可以选择适合当前调用和设备的实现,而无需改变面向应用的 API。
version: 1 选项选择已发布内核契约的第 1 版。它与 ONNX opset、算子的 since_version 或模型修订版本都是分开的。把这些概念区分开,应用就可以依赖稳定的、面向 JavaScript 的契约,而内核实现则在其背后持续演进。
这些内核有多快?
那么,优化内核究竟能带来多大差别?我们在 Apple M4 GPU 上,使用 ONNX Runtime Web 1.30.0-dev.20260826-b1f76d586a,让我们的内核集合与 ORT WebGPU 正面对比。我们从覆盖全部 207 个操作的 1,756 个测试用例出发,保留了双方输出一致且计时可靠的 809 个用例。
在这些对比中,我们的内核按几何平均快 2.57 倍,按中位数快 1.90 倍,629 胜、176 负、4 平。下面详细看看四个常见操作:
| 操作 | 对比用例数 | 我们的 WebGPU 内核 | ORT WebGPU | 加速比 |
|---|---|---|---|---|
| Add | 5 | 0.064 ms | 0.227 ms | 3.52x |
| MatMul | 29 | 0.115 ms | 0.131 ms | 1.14x |
| Softmax | 12 | 0.114 ms | 0.240 ms | 2.11x |
| LayerNormalization | 6 | 0.061 ms | 0.135 ms | 2.22x |
个别用例的优势要大得多。一个特别棘手的双线性 Einsum 用例(i,ij,j,规模为 4096),我们的内核耗时 0.136 ms,而 ORT WebGPU 耗时 1,396 ms:快了1 万倍以上。针对 [256, 4096] 的逐行 CumSum 则快 301 倍,耗时 0.016 ms 对 4.784 ms。这些是特殊情况,并不是你在所有场景下都能期待的加速,但它们表明,当通用实现走到慢路径时,专用内核能带来多大帮助。
我们计时的是 GPU 本身完成的工作,不包括加载内核、创建会话、上传输入、编译着色器和读回输出等准备工作。非常短的工作负载本来就更难测量,小规模用例还可能受益于 GPU 缓存,因此这些数字更适合作为有参考价值的对比,而不是对每个应用的承诺。
它们也只是单个操作的结果,而不是完整模型的结果。具体性能会因 GPU 和浏览器而异,这正是 Fleet 对于描绘更全面的图景如此重要的原因。
我们也在与 ONNX Runtime 团队合作,把这些改进贡献到上游,让更广泛的 ONNX Runtime Web 生态受益。
从一台设备到一个机群
WebGPU 的性能会因 GPU、浏览器和驱动而异,所以单台机器上的结果只能说明一部分情况。Fleet 让任何人都能在浏览器中运行正确性和性能检查,看看这些内核在自己的硬件上表现如何。
经用户同意后,每次运行都会以私密方式贡献证据,帮助我们发现特定设备上的故障、比较各种变体,并改进选择规则。目标很简单:借助广泛的真实世界覆盖,让内核对所有人都更快、更可靠。
为 WebAI 构建共享的基础
首批 207 个内核只是起点,而不是终点。把内核独立发布在 Hub 上,为我们提供了一个共同的场所,用来查看契约、比较实现、复现正确性检查并改进性能,而不必把每个着色器都直接嵌入每个运行时。
这个集合也是 Hub 更广泛的内核生态的一部分:在内核页面上,WebGPU 内核与面向 CUDA、ROCm、Metal 及其他平台的内核并列,可以像 Hub 上的其他制品一样进行筛选、排序和浏览。

这几部分相辅相成:
- 内核仓库定义透明、带版本的操作契约。
@huggingface/kernels让这些操作可以方便地从 JavaScript 加载和运行。- Fleet 通过众包收集真实世界的证据,覆盖的设备范围比常规基准测试实验室广泛得多。
- 每一次贡献的运行都可能揭示故障、指导调优、改进变体选择,并帮助验证未来的内核版本。
这是我们浏览器推理技术栈后续工作的底层基础。我们期待把这些内核接入更高层的模型工具,继续扩大操作覆盖范围,让快速的本地推理在整个 WebAI 生态中更易于使用。
欢迎浏览 WebGPU 内核集合,试用 @huggingface/kernels,并加入 Fleet,从你的设备贡献证据,帮助我们让内核对所有人都更好。