摘要
处理长提示词并不一定意味着响应变慢。在 Together AI,我们构建了缓存感知预填-解码分离架构(cache-aware prefill–decode disaggregation,CPD)。这一服务架构按缓存命中率有意将冷、热工作负载分开,从而实现快速的上下文复用。通过隔离繁重的预填(prefill)并利用分布式 KV 缓存,CPD 在长上下文推理中可将可持续吞吐量提升最高 40%,并显著降低首词元延迟(time-to-first-token,TTFT),在混合的真实流量下尤其如此。
如今的 AI 原生应用正在不断突破上下文长度的极限。从多轮对话、编程助手,到智能体记忆和检索增强系统,长提示词正成为常态。但高效地服务这些大上下文依然是一大挑战:TTFT 会升高,且波动更大。推理性能越来越不只取决于模型算力,也取决于系统处理共享上下文的效率。在真实负载中,很多请求并非全新。其中一些包含大量此前见过的上下文,例如共享的系统提示词、对话历史或常用文档,我们称之为热请求(warm request)。另一些则主要引入新的上下文,需要完整计算,这就是冷请求(cold request)。
前缀缓存(prefix caching)和预填-解码分离(prefill–decode disaggregation,PD)等近期进展,已经改善了长上下文服务。前缀缓存通过复用此前计算好的提示词前缀 KV 缓存来减少重复工作;PD 则把计算密集的预填阶段与对延迟敏感的解码阶段分开,以减少二者之间的干扰。再配合分块预填(chunk prefill)、序列/上下文并行等相关技术,它们共同降低了开销,提高了硬件利用率。
然而,在极高负载下的真实工作负载带来了超出常规服务场景的新挑战。设想这样一个系统:一部分并发用户提交超过 100K 词元、完全全新的大提示词,另一部分用户则在多轮对话中继续,其上下文大多复用此前内容。PD 确保解码不会被预填阻塞,但所有预填,无论冷热,仍然共享同一份预填容量。大型冷提示词每次会占用这些资源数秒,原本可以通过缓存复用快速完成的热请求,最终只能在同一个队列里等待。结果,TTFT 上升并不是因为这些请求需要大量计算,而是因为它们被堵在了需要大量计算的请求后面。
为弥补这一缺口,我们构建了缓存感知的分离式服务架构,用各自独立的计算资源处理热请求和冷请求。通过识别请求包含多少可复用的上下文,系统可以做出更聪明的调度决策,减少不必要的等待,并在计算资源之间更有效地路由任务。系统不再让昂贵的冷预填占据共享容量,而是为热请求铺设快速通道,同时仍能高效处理新的上下文。
因此,缓存感知的分离式设计使系统在负载下能够更平滑地扩展。如图 1 所示,在对尾部延迟敏感的 SLA 下,它始终能比传统基线维持更高的可达吞吐量。在我们的评测中,CPD 相比现有的分离式设计将可持续 QPS 提升最高 35–40%,即使存在大型冷提示词,也能保持更紧的尾部延迟上界。
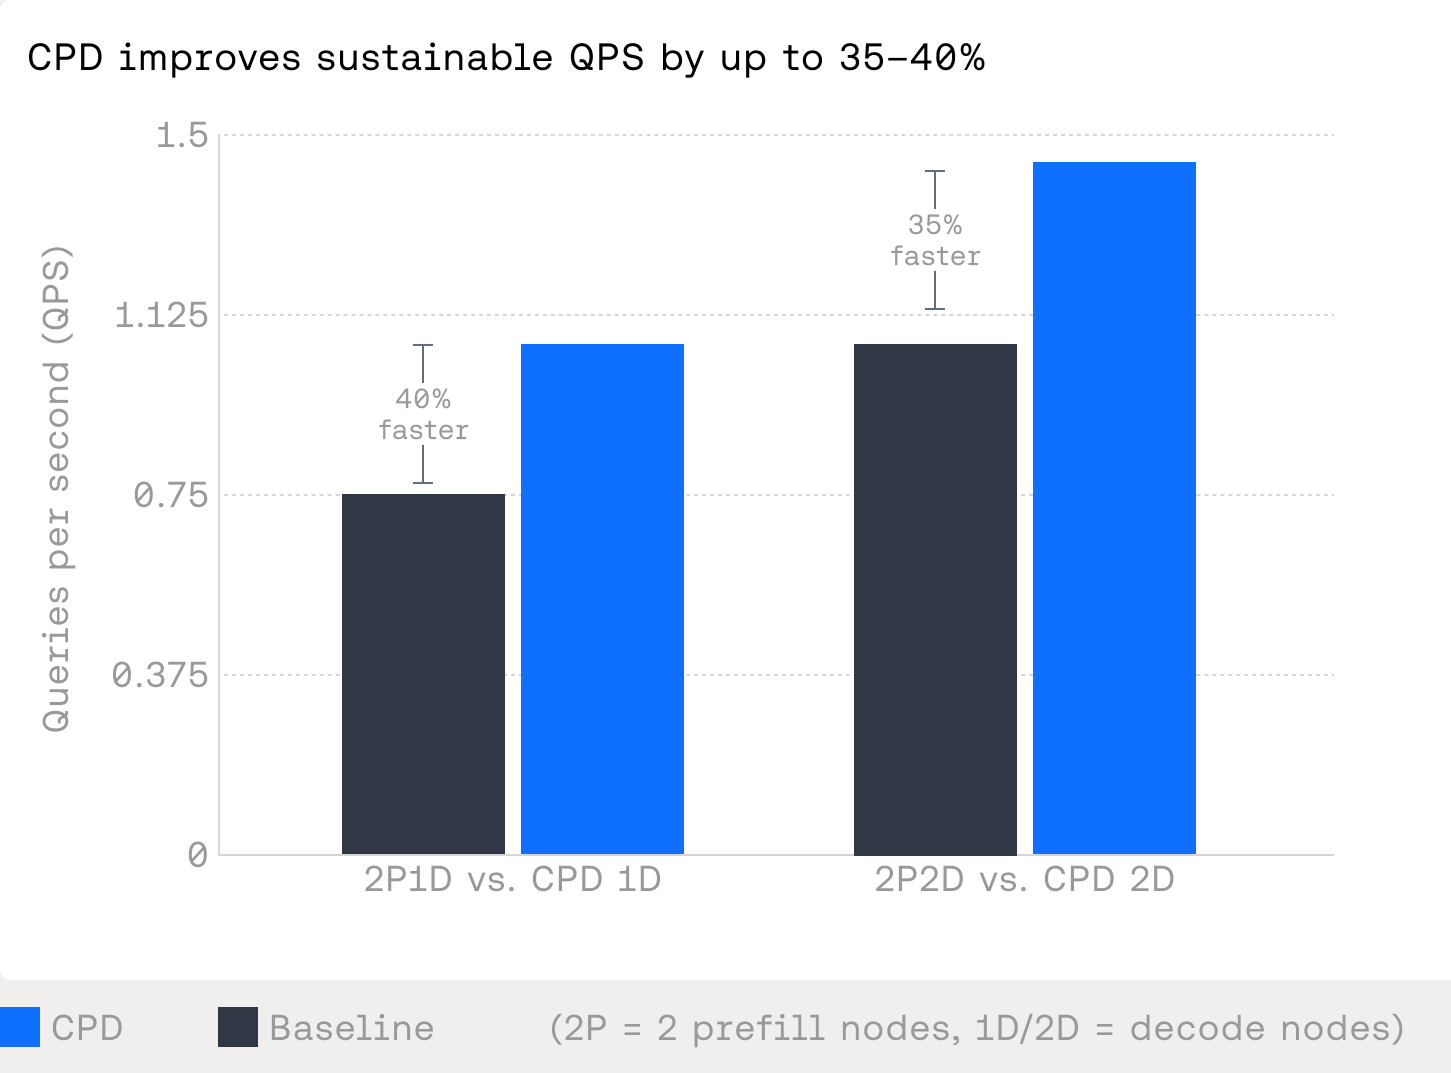 *图 1。延迟 SLO 约束下的最大可达 QPS。*
CPD 的工作原理
我们提出缓存感知预填-解码分离架构(CPD),它在标准的预填-解码分离式服务基础上,加入了缓存感知路由和共享 KV 缓存层级。核心思路很简单:不要让昂贵的“冷”预填阻塞可复用上下文的快速通道。
系统将推理分成三种角色:
- Pre-Prefill 节点:处理低复用(冷)提示词,计算新的上下文,并把 KV 缓存写入分布式缓存。
- Prefill 节点:优先处理高复用(热)请求,从缓存中读取 KV 块,而不是重新计算前缀。
- Decode 节点:专注于延迟,不受预填干扰。
预填和解码本已分离,而 CPD 增加了一个专用的预预填层(pre-prefill tier),用于处理几乎没有缓存复用的请求。这些节点计算大型新上下文,并把其 KV 缓存写入分布式缓存。与此同时,普通预填节点专注于能够复用已有状态的请求,从缓存中读取 KV 块,而不是重新计算。解码节点保持隔离,专注于延迟。
在底层,CPD 依赖三级 KV 缓存层级,如图 2 所示。最快的一层位于 GPU 显存,其次是主机 DRAM,再往下是通过 RDMA 连接的集群级分布式缓存。当冷请求由 pre-prefill 节点处理时,其 KV 状态会被写入分布式缓存。后续相似的请求可以高带宽地批量取回这些状态,把原本数秒的计算变成数百毫秒的传输加少量重算。随着时间推移,频繁访问的上下文会自然向 GPU 靠近,进一步压低延迟。
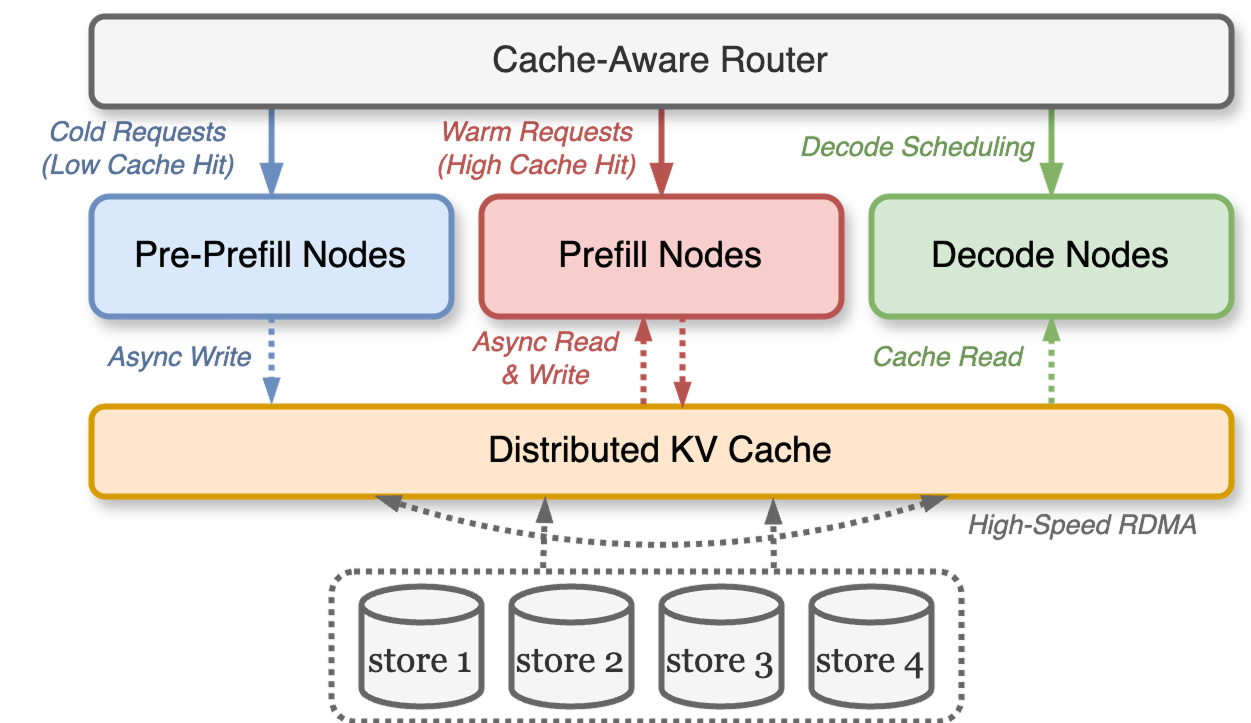
路由器把这一切串联起来。对每个请求,它会估算提示词中有多少可以从缓存提供。低复用的请求被引导至 pre-prefill 节点,高复用的请求则直接进入普通预填节点。这种工作负载分离避免了大型冷预填占满共享算力,同时系统仍能摄入新的上下文并持续预热缓存。最终得到的服务栈能让快速通道始终保持快速,即使在混合且突发的长上下文负载下也是如此。
重复请求中会发生什么
当相同或相似的长上下文多次出现时,CPD 的优势就会变得明显,这在编程助手、智能体和多轮对话场景中很常见。每一次请求都会让工作负载更远离重计算瓶颈,更多地转向前缀缓存复用。
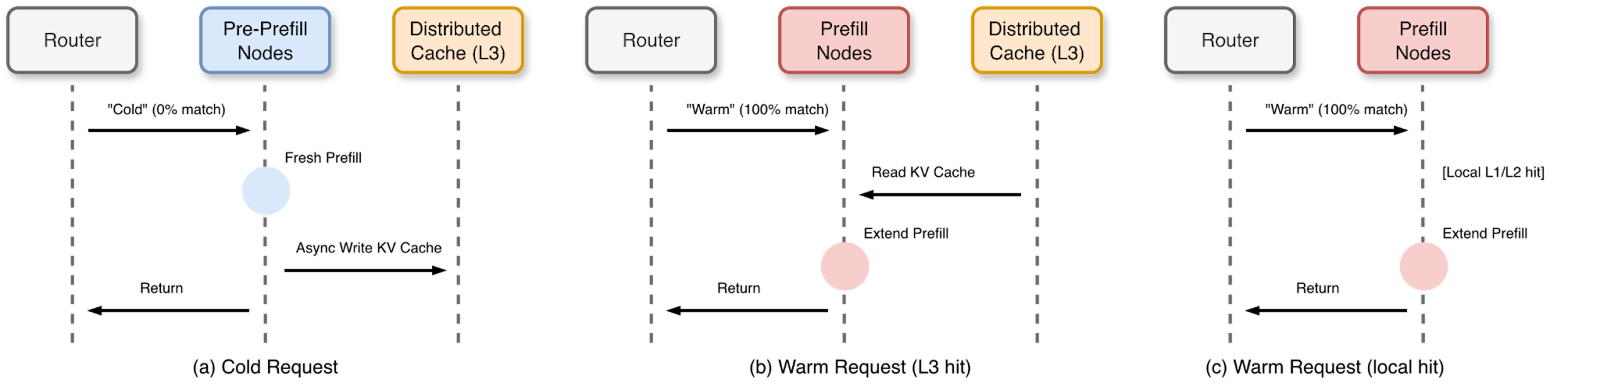
请求 1:冷请求(引导)
大上下文第一次出现时,会被归类为冷请求。路由器把它发送到 pre-prefill 节点,由该节点执行完整的预填计算。与此同时,生成的 KV 缓存会被写入分布式缓存。
这个请求要付出全部的计算成本,但它通过把新上下文变成可复用的状态,为系统做好了铺垫。
请求 2:热请求(分布式缓存复用)
当相同的上下文再次出现时,路由器会将其识别为热请求。普通预填节点不再重新计算前缀,而是通过 RDMA 从分布式缓存取回 KV 块,并加载到 GPU 显存中。
原本数秒的计算现在被高带宽传输和少量处理取代。延迟大幅下降,GPU 的计算压力也随之减小。
请求 3:热请求(本地复用)
如果该上下文仍然活跃在同一节点上,其 KV 状态可能已经驻留在 GPU 或主机内存中。无需再从分布式缓存传输,系统直接复用本地缓存。
此时,预填的开销降到最低,延迟进一步缩短。原本需要数秒计算的同一个 100K 词元上下文,现在只需几百毫秒即可完成服务。此外,CPD 不只是复用前缀,它还把重计算与由复用驱动的流量隔离开来,使系统能够扩展长上下文推理,而不会让冷负载独占共享资源。
评测
我们从两个互补的维度评测 CPD,这两个维度对真实负载下的长上下文服务系统至关重要:
- 负载递增时的延迟与吞吐量扩展:随着目标 QPS 增加,TTFT(p50 和 p90)与单 GPU 吞吐量如何变化。
- 竞争条件下的有效服务容量:在预填侧饱和导致延迟迅速膨胀之前,系统每块 GPU 能维持多少可持续 QPS。
我们将传统的基于 PD 的部署与 CPD 进行对比,重点关注缓存感知的分离如何在冷热混合负载下改变饱和行为和延迟:
- 2P1D/2P2D(基线):两个预填节点加一个或两个解码节点,采用标准 PD 路由,所有请求共享同一份预填容量。
- CPD-1D/2D:缓存感知流水线,由一个专用的 pre-prefill 层、一个普通预填层和一个或两个解码节点组成,由能区分冷热请求的 CPD 感知路由器统一协调。
所有实验均在 NVIDIA B200 GPU 上进行。每个预填阶段在每个节点的 4 块 B200 GPU 上使用张量并行,解码阶段则在 4 块 B200 GPU 上使用数据并行并对注意力进行分片。我们将在途请求数上限设为 24,以反映真实的准入控制,并避免尾部延迟被无限放大。
对于每个目标 QPS,系统先在 30 秒内逐步提升流量,然后以稳态负载持续 600 秒。QPS 从 0.4 扫描到 1.6,步长为 0.2,以覆盖从轻载到饱和的系统行为。
工作负载配置
为反映真实的长上下文推理负载,我们基于一个编程智能体场景设计了基准测试,该场景具有大型共享上下文和多轮交互。这一负载模拟了 AI 辅助软件开发的情形:智能体在多个轮次中维持大量代码库上下文,读取文件、分析依赖、实施修改并迭代修复。测试使用合成数据,其中冷热预填请求的混合比例贴近真实,用以考验 CPD 的调度决策。
结果
图 4 共同展示了随着系统负载增加,CPD 如何同时改变延迟扩展行为和服务容量。
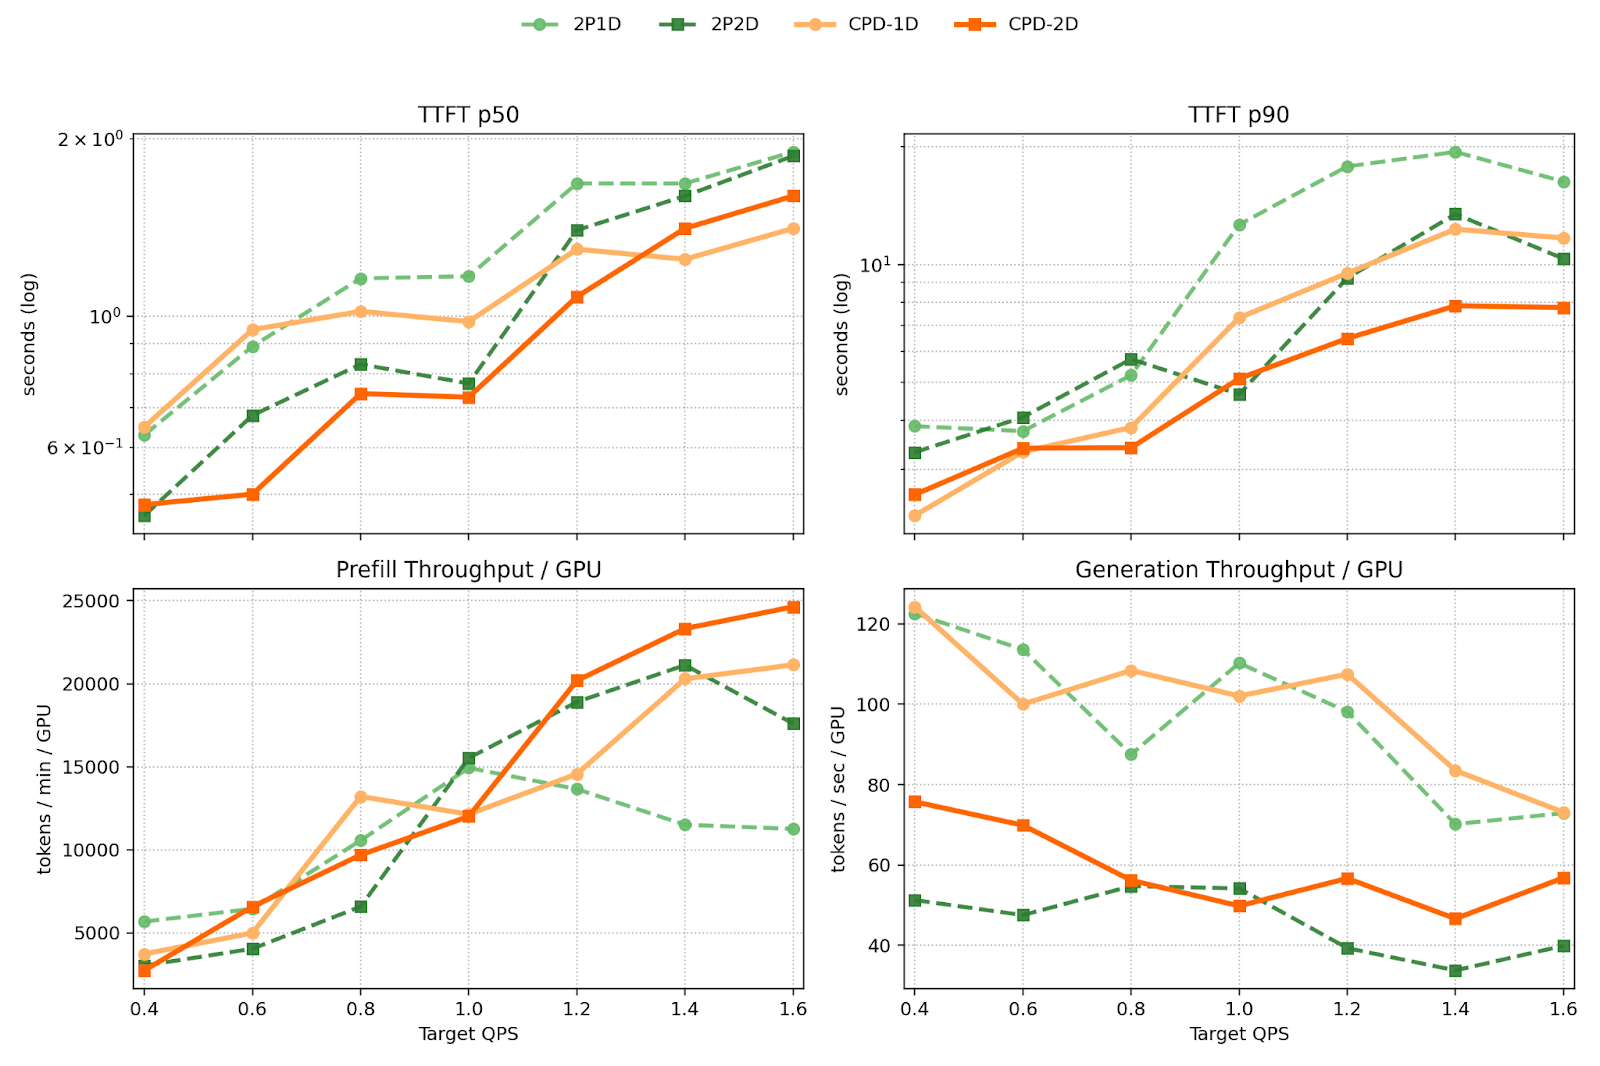 *图 4。目标 QPS 递增时,2P1D/2P2D 与 CPD 的性能对比。*
饱和行为
随着目标 QPS 增加,一旦预填容量成为主要瓶颈,两个系统便开始出现分化。2P1D 基线较早达到饱和,实际达成的 QPS 在每 GPU 0.75–0.8 QPS 左右趋于平坦,此后排队延迟迅速增长。相比之下,在相同负载下 CPD 可继续扩展到约每 GPU 1.1–1.15 QPS,在进入饱和之前可持续吞吐量提升约 40%。
饱和点的这种右移与图 4(左下)的吞吐量曲线一致:随着负载增加,CPD 保持着更高的有效预填吞吐量。通过将冷预填与由缓存支撑的热请求分开,CPD 避免了长时间运行的冷提示词独占共享预填容量,使系统能够在更高的施加负载下高效运行。
负载下的延迟
在轻载时,2P1D 与 CPD 的中位 TTFT(p50)相当,说明 CPD 在未拥塞状态下不会引入额外开销。然而,当 QPS 增加到接近基线的饱和点时,两者的表现急剧分化。
对于 2P1D,TTFT p50 迅速升至 1 秒以上,很快进入数秒的区间,反映出请求在大型冷预填后面排队。CPD 的增长则平缓得多:如图 4(左上)所示,即使在基线已经饱和的目标 QPS 下,CPD 仍能将中位 TTFT 维持在亚秒到低秒级。这一改进直接源于工作负载隔离,复用缓存上下文的热请求不再被迫等待昂贵的冷预填执行。
尾部延迟(TTFT p90)呈现出更微妙的规律。在中等负载下,两个系统的 p90 表现相近。负载进一步增加时,两种设计的 p90 TTFT 都会上升,但在所评测的整个范围内,CPD 始终低于或与基线相当(图 4,右上)。重要的是,CPD 在大幅改善中位延迟的同时,并未造成不成比例的尾部放大。虽然冷流量的突发仍可能增加 pre-prefill 层内的排队,但其影响基本得到控制,从而保持了可预测的尾部表现。
吞吐效率
图 4 中的吞吐量分解揭示了这些改进的根本原因。在较高 QPS 下,CPD 能维持更高的单 GPU 预填吞吐量,而基线的预填吞吐量在达到平台期后,会随着排队加剧而下降。两个系统的生成吞吐量大致相当,说明所观察到的性能差异主要来自更高效的预填调度,而非解码侧的优化。
关键结果与讨论
图 4 表明,CPD 改变了冷热混合负载下长上下文服务的工作点。将解码容量从 1D 增加到 2D,可提高基线与 CPD 两种配置的整体吞吐量并推迟饱和,证实解码侧并行有助于提升服务容量。
重要的是,即使扩大解码容量,CPD 仍能持续带来改进。在 1D 和 2D 两种设置下,与对应基线相比,CPD 都能维持更高的单 GPU 有效 QPS,且中位 TTFT 的增长更平缓。此外,CPD 的解码吞吐量相当或更高,说明它的收益不仅限于预填隔离,还延伸到更高效的端到端流水线利用率。
这些改进并非来自模型执行速度本身的提升,而是来自预填路径上的缓存感知隔离。通过防止长时间运行的冷预填阻塞由缓存支撑的热请求,CPD 即使在高负载下也为复用保留了一条快速通道。这说明,随着上下文窗口不断增长,系统级调度和复用感知的设计与模型及硬件效率一样,已成为影响推理性能的一阶因素。