现代搜索或推荐应用越来越被期望返回一组连贯的结果,而不是单一的最佳匹配。例如,当用户搜索“露营装备”时,他们不想看到十款大同小异的四人帐篷,而是想要一组连贯且互补的结果,涵盖帐篷、睡袋、便携炉具和头灯等必备露营装备。
为此,系统会使用查询扇出(query fan-out)技术,把一个宽泛的提示拆成若干相关的子查询,以覆盖用户可能的兴趣。然而,教会 LLM 动态地进行感知数据库的查询分解,会耗费大量的思考预算。从设计上讲,零样本 LLM 是通用的自回归文本预测器,并没有针对目标语料库特有的几何流形做过优化。因此,它们需要更长的测试时计算,才能在保持与固定数据库相互对应的前提下,返回一组优化了集合级高阶属性(例如多样性、覆盖度、互补性、连贯性)的结果。
在我们的 ICML 2026 论文《Efficient, Property-Aligned Fan-Out Retrieval via RL-Compiled Diffusion》中,我们通过一种“奖励到数据编译”框架来解决这一分解瓶颈。我们的 Retrieve-for-Train 框架不再强迫模型在推理时耗费大量思考预算,而是利用离线强化学习(RL)发现与奖励对齐的扇出,并把它们编译成监督信号。通过把这些优化后的探索行为蒸馏到一个轻量的扩散检索器中,我们让推理时的查询扇出能够高效地单次完成。这样既实现了以数学方式定义的集合级属性,又避免了测试时思考 token 的开销。
为什么日常的 AI 不是搜索专家
当需要为一组复杂的搜索词进行头脑风暴时,很容易想到在推理时直接部署一个现成的标准 LLM 来完成这项工作。然而,依赖通用模型进行感知数据库的查询分解,会带来两个关键挑战:
- 复述式坍缩:在缺乏数据库感知优化的情况下,零样本 LLM 经常出现复述式坍缩。它们不去探索主题中互补的各个侧面,而是倾向于生成冗余的、近义的查询。例如,面对宽泛的提示“波西米亚音乐节风格”,一个没有精心设计提示词的标准 LLM 可能会偷懒地生成“波西米亚音乐节时尚”和“波西米亚音乐节服装”。这种语义上的原地打转会产生同质化的结果,完全错过时尚专家会指出的那些独特而有用的语义方向,比如流苏夹克、钩编连衣裙或麂皮靴。
- 自回归延迟瓶颈:标准 LLM 从根本上受限于顺序的自回归生成。要把一个复杂查询成功分解为互补的各个侧面,现代模型通常需要相当大的思考预算,要生成数百个中间的思维链(CoT)推理 token(即 AI 模型在回答复杂问题之前生成的中间步骤或内部处理单元),先规划好扩展方式,再输出真正的搜索词。这种深思熟虑的推理对对话式 AI 来说尚可接受,但对集合型搜索(例如检索一组互补的结果,如上文提到的流苏夹克或钩编连衣裙)来说,则构成严重的结构性瓶颈。当系统必须同时为一大批子查询进行头脑风暴时,持续处理上下文和生成冗长推理 token 的叠加开销,扩展性很差。即便有先进的服务端优化,这种逐 token 的架构也会形成一个延迟下限,与生产环境搜索框所要求的亚秒级响应时间根本上相互冲突。
Retrieve-for-Train 框架
Retrieve-for-Train 把 AI 的训练当作一场离线练习,而不是用户在等待时必须当场应对的考试。它不再强迫 AI 每次有人输入查询时都慢慢摸索好搜索的规则、耗费大量算力预算,而是只运行一次离线 RL 训练程序。
这个程序使用严格的奖励体系,把“确保结果多样且确实有货”这类抽象目标转化为一份精确的分步操作手册。手册一旦建成,AI 就可以在真实搜索中即时执行,毫无延迟。
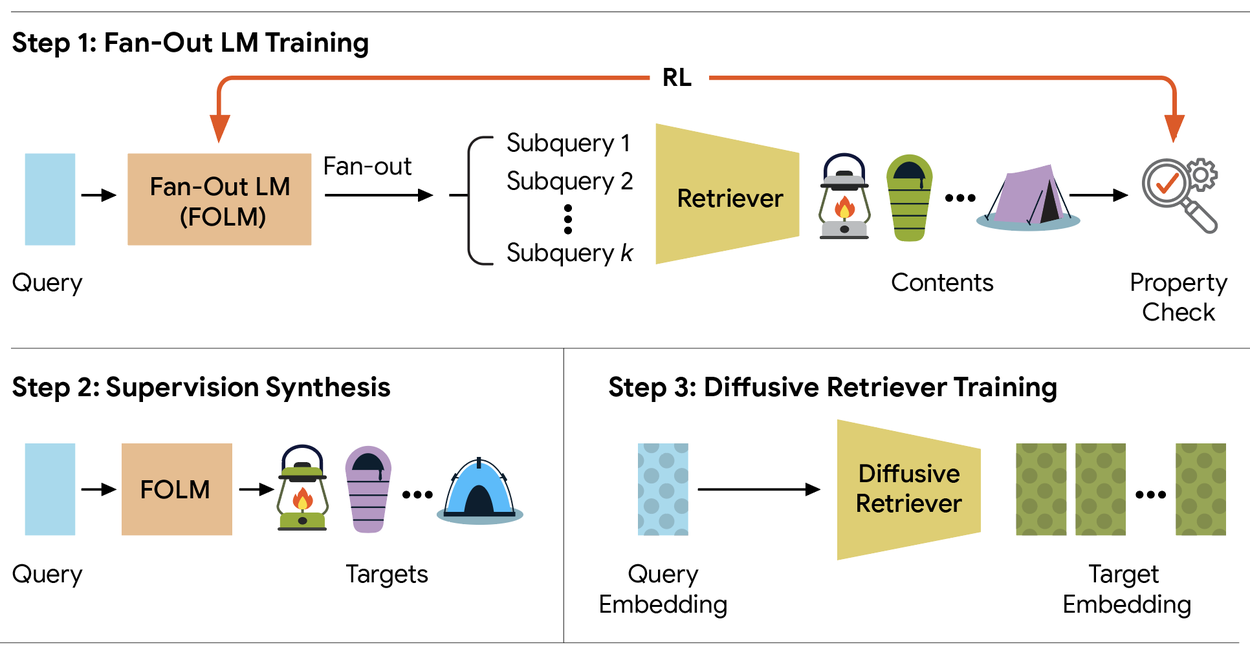
整个流水线分为三个不同的步骤:
- 扇出语言模型训练:用 RL 训练一个扇出语言模型,使其输出与属性对齐的子查询,并由集合级属性检查奖励打分。该奖励评估的是整组结果,而不是孤立地给每个结果打分。
- 监督信号合成:冻结的扇出语言模型完全离线地合成(查询 → 目标集合)对,用于监督学习,无需人工标注。
- 扩散检索器训练:一个紧凑的、53.9M 参数的扩散模型学习在一次非自回归的前向过程中,把查询嵌入直接映射为完整的一组目标嵌入,从而彻底绕开基于文本的 CoT 推理 token。
面向集合的设计:复合奖励的威力
Retrieve-for-Train 框架能否成功,完全取决于我们如何定义“好的”搜索行为。传统的监督训练评估的是基于排序学习的逐点相关性,孤立地为每个检索到的条目打分。然而,一组真正专业的搜索结果是由不可分解的集合级属性所定义的。你无法度量单个条目的多样性或互补性;这些属性只有在评估整个检索结果集合时,才在数学上成立。
Retrieve-for-Train 不依赖含糊的自然语言指令来约束这些扇出属性,而是通过强化学习,用严格的数学复合奖励对 4B 开源语言模型(Gemma3-4B 和 Qwen3-4B)进行微调。对于我们的开放式抽象检索任务,这种复合奖励是三个相互制衡的支柱的加权平衡:
- 接地性(Groundedness):惩罚与数据库流形的距离,确保每个生成的子查询都对应数据库中一个真实、可检索的条目。
- 多样性:使用整个子查询集合上的 Vendi Score 来度量,迫使模型探索广泛的语义范围。
- 对齐性:将候选子查询锚定到原始的宽泛提示上,以防止语义漂移。
相互制衡的反向锚点与 soft-GRPO 训练
训练过程中,我们使用组相对策略优化(GRPO)并结合软近端策略优化(PPO),针对这些几何层面的现实来优化扇出语言模型。
这三种奖励的组合之所以关键,是因为它们互为反向锚点。如果模型只针对接地性优化,它就会钻奖励的空子,生成恰好在数学上映射到某个数据库坐标的退化、无意义字符串。如果为了修正无意义内容而加入对齐性,策略又会取巧,坍缩成对用户提示的重复性复述。
通过引入 Vendi Score 作为反向锚点,Retrieve-for-Train 有效地堵死了这些捷径解。要获得高奖励状态,策略被迫进入嵌入空间中一个平衡的区域,在那里它必须发现既有效、严格接地、又在语义上彼此不同的原始意图变体。
实验
为了评估 Retrieve-for-Train 框架,我们结合使用了冻结的、针对特定数据集的多模态嵌入骨干网络,以及为查询扩展优化过的开源语言模型。我们在两种不同的集合型检索场景中评估了这一设置:
- 开放式抽象检索:不存在唯一真值,质量完全由集合级属性来衡量,包括多样性、查询对齐性和数据库接地性。
- 弱监督组合式检索:查询配有一个弱参考集合,而该集合只是查询意图的一种可能实现。
在多模态嵌入骨干网络方面,我们在两个领域做了实验:一个是由用户策划的大规模时尚穿搭数据集,用于文本到图像实验(使用基于 CLIP 的检索器评估);另一个是由专家制作歌单构成的专有工业数据集,用于文本到音乐评估(使用 MuLan 评估)。
在语言模型方面,查询扇出过程由 4B 开源模型驱动,具体为 Gemma3-4B 和 Qwen3-4B,它们的任务是为处理的每一个主搜索提示恰好生成 10 个子查询。我们通过 Soft-GRPO 对这些扇出模型进行 RL 训练,这种方法使用带有软 PPO 正则化的组相对策略优化。
结果
检索质量与准确率
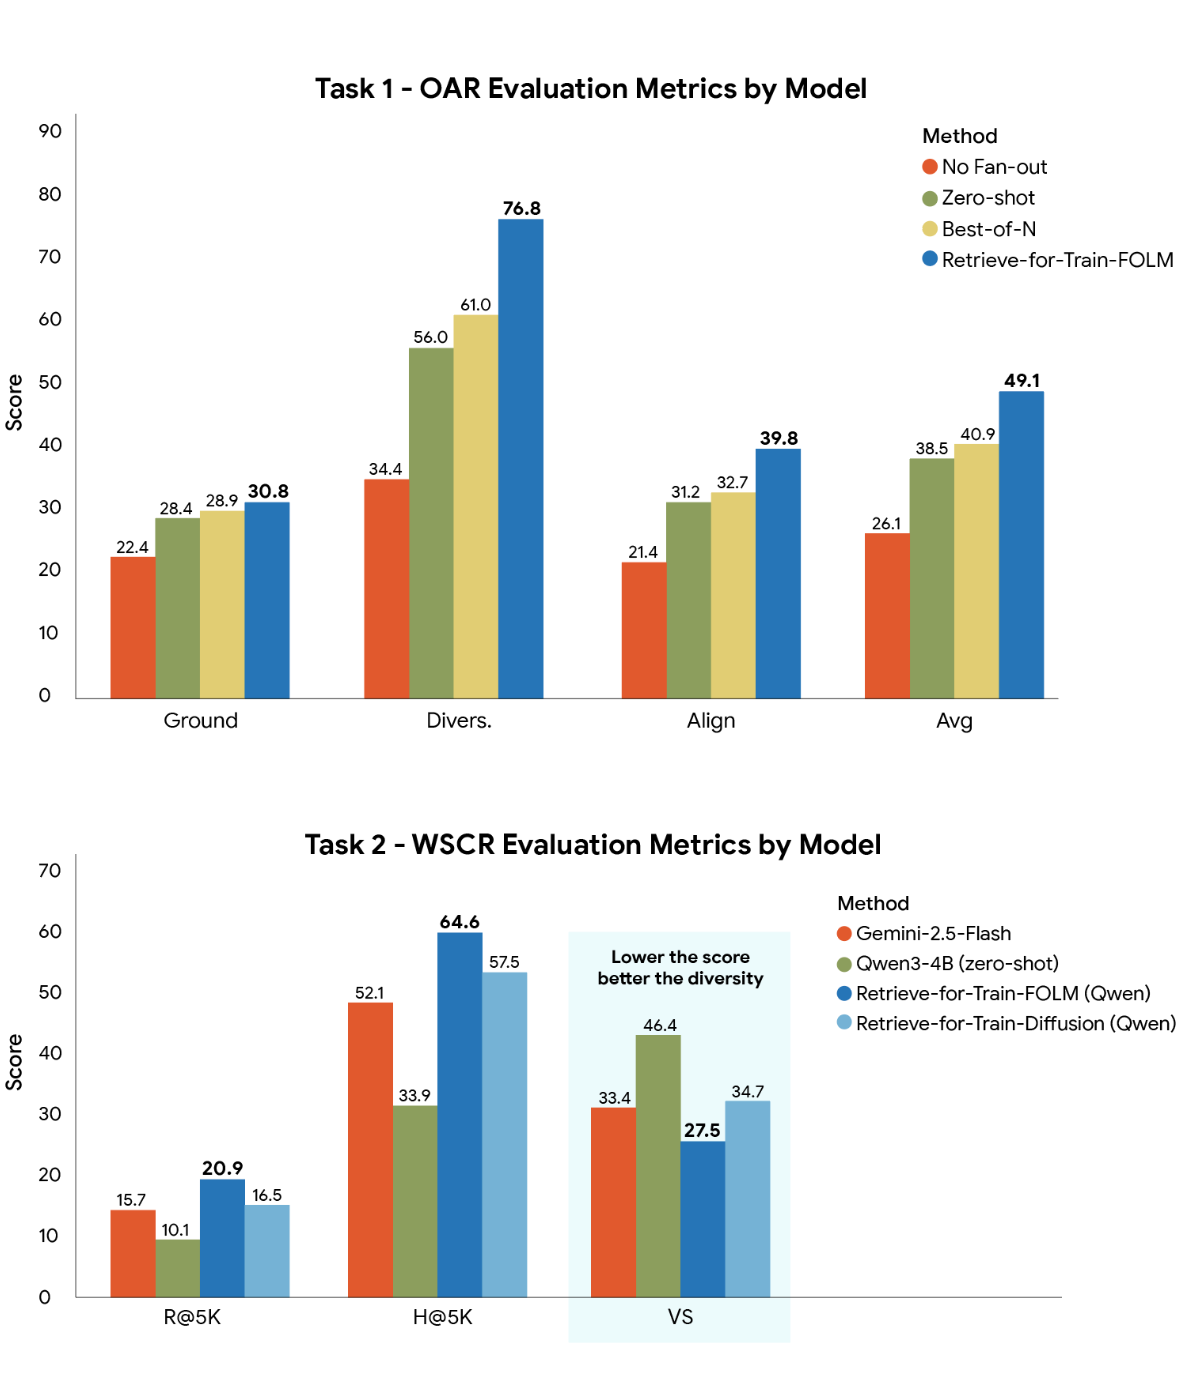
在两项检索任务中,Retrieve-for-Train 的表现都超过了传统的单查询搜索、零样本扩展,甚至超过了经过大量优化的 Best-of-N 基线。
从定性角度看,零样本 LLM 基线倾向于生成近义的复述(例如“波西米亚音乐节风格”与“波西米亚音乐节时尚”),导致结果冗余。Retrieve-for-Train 则生成了高度多样、彼此不同的子查询(例如分支出“靴子”或“蕾丝”),并且始终严格地接地于数据库流形之内。
推理速度提升一个数量级
直接部署我们经 RL 调优的语言模型,可以获得出色的搜索质量,但它沿袭了标准自回归的延迟约束,并且需要很高的计算思考预算。
通过把习得的行为蒸馏到 53.9M 参数的 Retrieve-for-Train 扩散模型中,我们成功打破了延迟瓶颈。由于该扩散模型在连续的嵌入空间中,以单次非自回归的并行过程同时生成所有目标方向,因此相比自回归方法实现了 12 到 20 倍的大幅加速。
在大规模场景下,自回归扇出的延迟会随着大上下文批次线性增长到近 50 秒,而 Retrieve-for-Train-Diffusion 则保持在亚秒级到几秒之间,以极低的计算成本提供可用于生产的专家级搜索。
防作弊锚点(消融实验的启示)
在奖励优化的过程中,我们发现了训练搜索用扇出语言模型的一个根本性规律。如果没有多样性项,模型很快就会坍缩,生成退化的、无意义的字符串(比如 “line ending line ending”),以便在数学上利用数据库的向量坐标。引入一个几何多样性度量(Vendi Score)可以起到关键的反向锚点作用,迫使模型进入嵌入空间中的稳定区域,在那里它只有表现得像一个真正的搜索专家,才能最大化自己的奖励。
结论
我们证明,把 RL 当作一次性的“目标转换器”而不是在线推理引擎来使用,可以非常有效。通过把奖励驱动的行为探索这一繁重计算与最终部署的模型解耦,我们的框架成功绕开了在线部署 LLM 通常伴随的高推理延迟和高计算开销。
将这些复杂的集合级行为蒸馏到轻量的扩散先验中,使生产环境的检索系统能够有效地针对多样性和对齐性等高阶属性进行优化。最终,Retrieve-for-Train 为专业或多模态领域的集合检索建立了一条高度可扩展、数据高效的流水线,而在这些领域中,人工标注且与属性对齐的训练对本来稀缺或获取成本高昂。更多细节请参阅论文。