突破发生在一个假日周末,2022 年阵亡将士纪念日。当硅谷大多数人都在烧烤聚会时,Dan Fu、Tri Dao 和他们的同事即将证明:AI 业界的主流看法错了。
当时的共识早已定论:Transformer 的注意力机制已经优化到位,GPU 专家早就把硬件性能榨干了,几乎没有多少提升空间。
然后,Dan、Tri 和他们的同事发表了 FlashAttention。
当天下午,时任 Tesla AI 高级总监的 Andrej Karpathy 就发推提到了它。几个小时内,它便在各个 AI 研究圈子里迅速传开。“说实话,我们发布时没指望有人会注意到,”Dan 回忆道,“我们本来准备周二早上再发几篇博客和代码。但周一晚上 7 点,我们看到 Karpathy 发了推,才知道大家确实在关注这件事。”
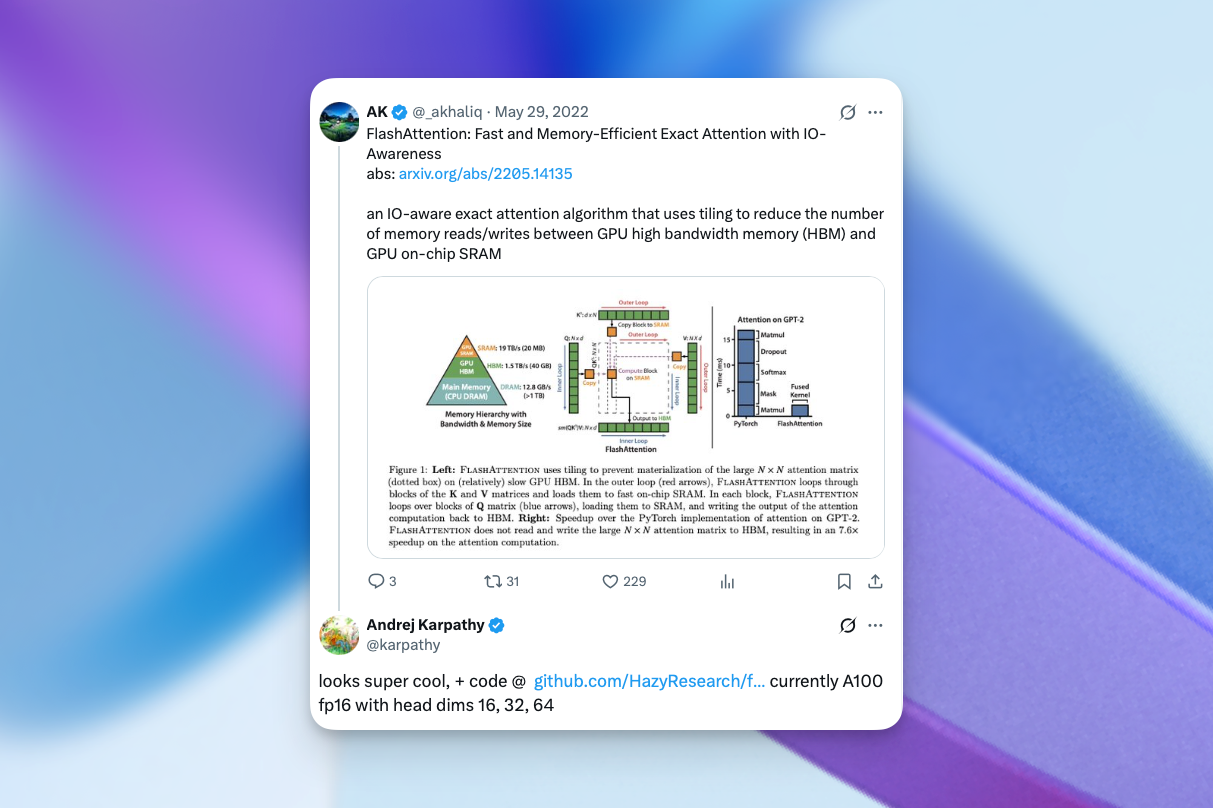
此前关于稀疏化和低秩方法的研究,理论上能带来加速,实际性能却只提升了 10%。FlashAttention 团队另辟蹊径:弄清 GPU 上真实的内存搬运和计算模式。他们把经典数据库系统的原理(关于数据局部性和内存层级的、并不光鲜的东西)用到注意力计算上,实现了 2–3 倍的加速。
对论文背后的研究者来说,其意义再清楚不过:GPU 优化中仍有巨大的潜力尚未开发。这篇论文成为了如今 AI 领域最具影响力的内核研究团队之一的起点,也是 AI Native Cloud 的关键基石。
没人谈论的问题
关于 AI,很多人并不明白一点:拥有最好的模型和最好的硬件还不够。瓶颈在于两者之间的鸿沟,也就是把数学运算翻译成芯片指令的软件层。这正是内核(kernel)的用武之地。
研究者设计出来的东西,与硬件上真正跑得快的东西之间,差距巨大。许多奠基性的架构(ResNet、LSTM、RNN)诞生于规模化范式形成之前。随着研究者开始把模型扩展到数千亿参数,硬件也随之演进。GPU 越来越像专门的矩阵乘法机器,针对主导现代 AI 的 Transformer 架构做了调优。
内核是数学抽象与硅片现实之间的翻译层:它是告诉 GPU 如何高效搬运数据、执行计算的软件。做对了,就能释放硬件的全部威力;做错了,硬件就只能闲置。
对 AI 原生应用(以 AI 为核心构建的产品)来说,这道鸿沟事关生死。运行在低于最优水平的基础设施上,你做不出响应迅速的 AI 原生应用;推理成本比应有水平高出一倍时,你也无法扩展 AI 原生业务。AI Native Cloud 需要 AI 原生的基础设施,从硅片层开始优化。
一周追平一年的工作
2025 年 3 月,我们的内核团队已经发展到约 15 人:既有想挑战系统问题的 ML 研究者,也有转入 AI 领域的 GPU 老手。我们刚拿到 NVIDIA 新一代 Blackwell GPU,它与前代相比,能力有根本性的不同。
挑战非常具体:NVIDIA 的团队花了一年时间为 Blackwell 开发优化内核,投入了几十名工程师,对硬件了如指掌。而我们只有一周。
我们需要一个能让我们快速推进的工具,这个工具就是 ThunderKittens,一个我们与斯坦福的研究者合作开发的库。
“我们有把内核适配到新硬件的经验,也知道这需要时间,”Dan 说,“比如 FlashAttention-3 是在 Hopper 全面上市一年之后才出来的。我们想打造工具,让为新一代硬件快速构建内核变得更容易,ThunderKittens 就是答案。”
ThunderKittens 围绕 NVIDIA 的张量核心(tensor core,GPU 上专用于矩阵乘法的硬件单元)构建。通过围绕张量核心建立抽象,ThunderKittens 把过去需要 1000 多行的 CUDA 代码缩减到 100–200 行。
团队不分昼夜地工作,让 ThunderKittens 适配 Blackwell 的新特性:速度比上一代快 2–2.5 倍的第五代张量核心,提供额外 256KB 超高速片上存储的新张量内存层,以及允许线程块更深入协同的 CTA 对。
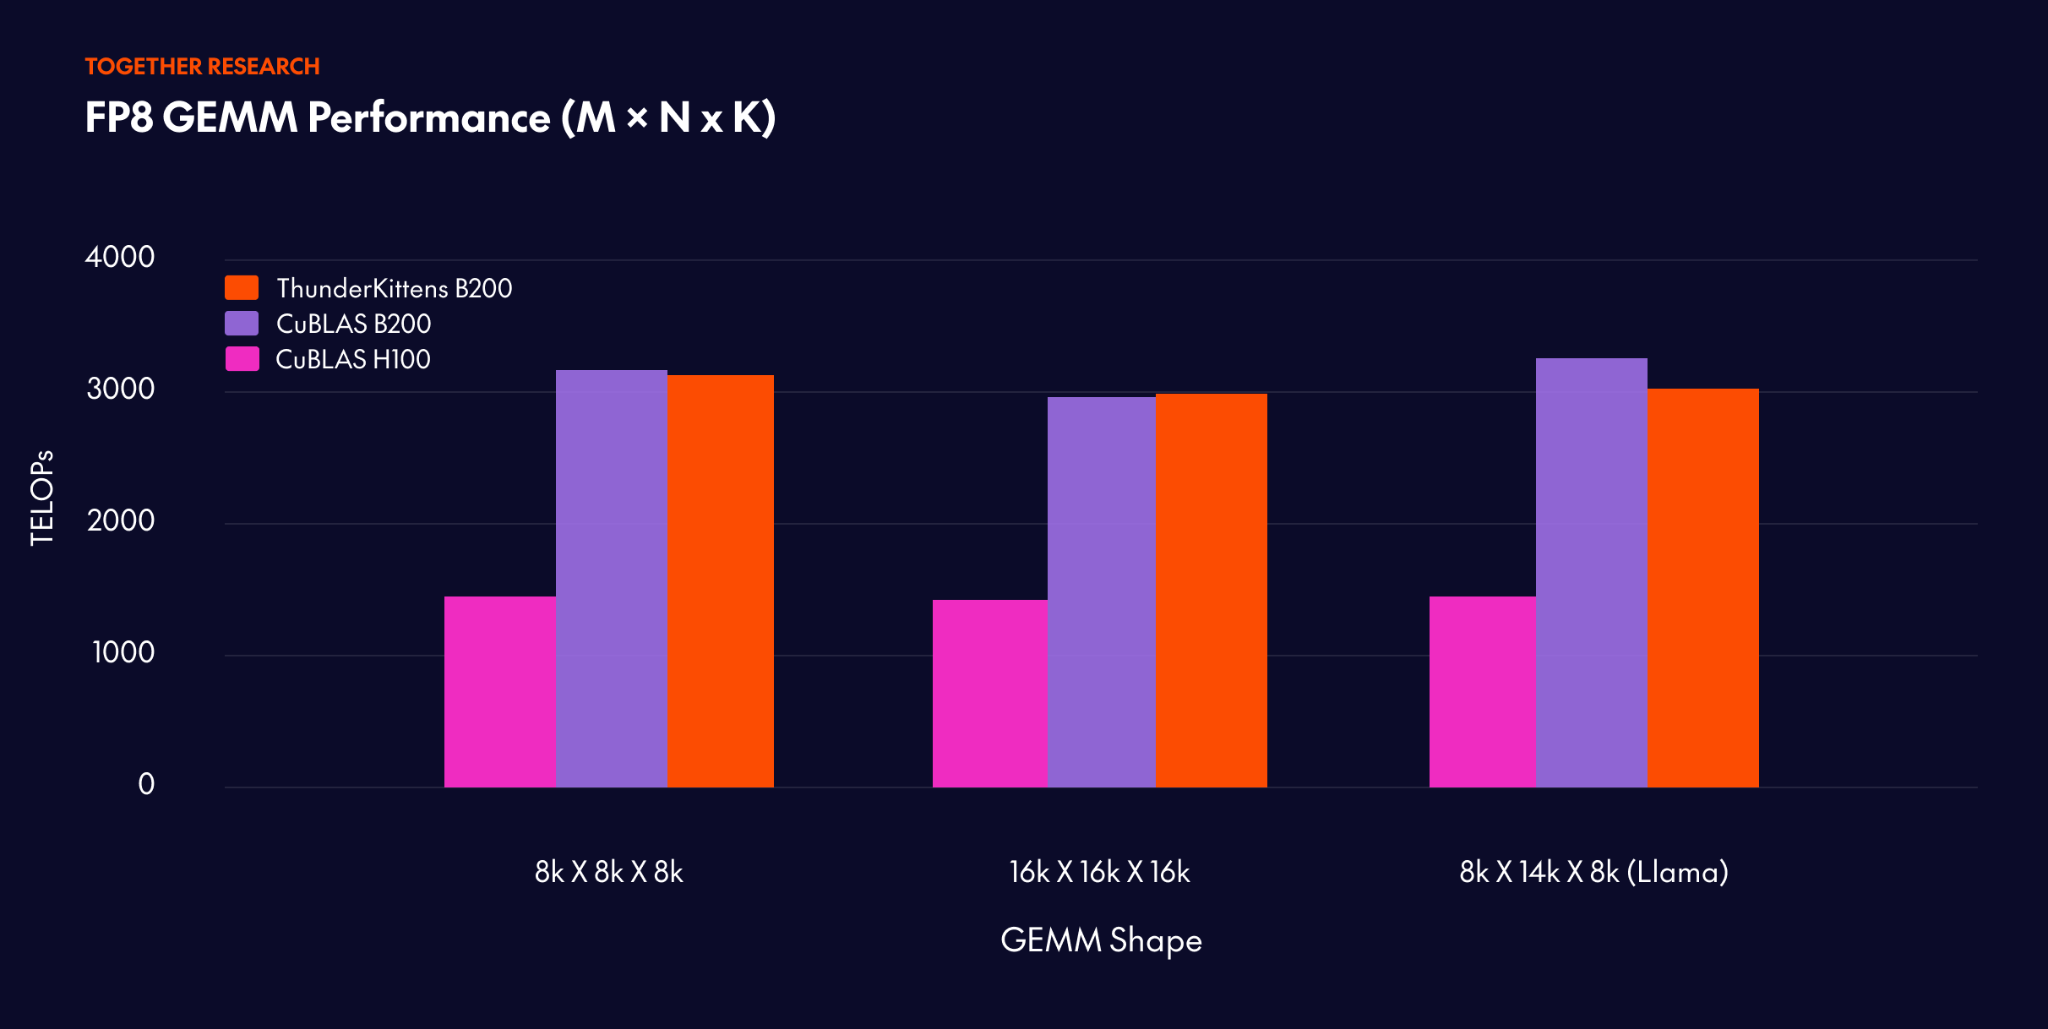
拿到硬件后的一周之内,我们就做出了 Blackwell 上最快的 FP4 和 FP8 GEMM 内核之一,相比 H100 上的 cuBLAS,最高提速 2 倍。
学术引擎
ThunderKittens 并非凭空而来,它是这支团队构建方式的更大模式的一部分。
Dan Fu 在 UCSD 运营一个实验室,专注于风险更高的基础研究,其中包括他个人钟爱的 FFT 算法项目(大多数业界研究者绝不会碰的小众领域)。Together AI 联合创始人兼首席科学家 Tri Dao 在 Princeton,Simran Arora 在 Caltech。
这是一种共生模式:在学术界为想法降低风险,在 Together AI 将其产品化。博士生加入公司,Together AI 的实习生则在学术实验室里做更长期的研究。想法双向流动。
这种理念也影响着招聘。我们要找的不是只想交付代码或刷引用数的人,而是会为内存访问模式失眠的人,是在数据流图里发现美的人,是对把前沿研究带入生产真正感到兴奋的人。研究本质上意味着反复失败,你必须首先由真正的兴趣驱动。即便是 FFT 这类不赶时髦的方向,只要真正有趣,也值得追求。
这支团队已成为下一代系统研究者的跳板,他们能够弥合理论与生产之间的鸿沟。我们已经“毕业”了 Yucheng Lu 教授,他现在是纽约大学上海分校的助理教授,领导 HeavyBall Research 小组。
Together Megakernel:从 281ms 到 77ms
把这台学术引擎应用于生产场景的一个例子,来自一家领先的实时语音智能体公司。他们带着一个硬性约束找到 Together:生成前 64 个 token 的时间(time-to-first-64-tokens)一旦超过约 100ms,对话体验就会被破坏。他们之前部署在 NVIDIA B200 GPU 上的方案是 281ms。对大多数工作负载来说已经很快,但对他们来说还不够快。
Together 的内核团队与他们合作选定模型架构,然后手工优化了一个 Megakernel 实现,让整个模型在单个内核中运行,目标直指 NVIDIA H100 的 HBM 带宽上限。
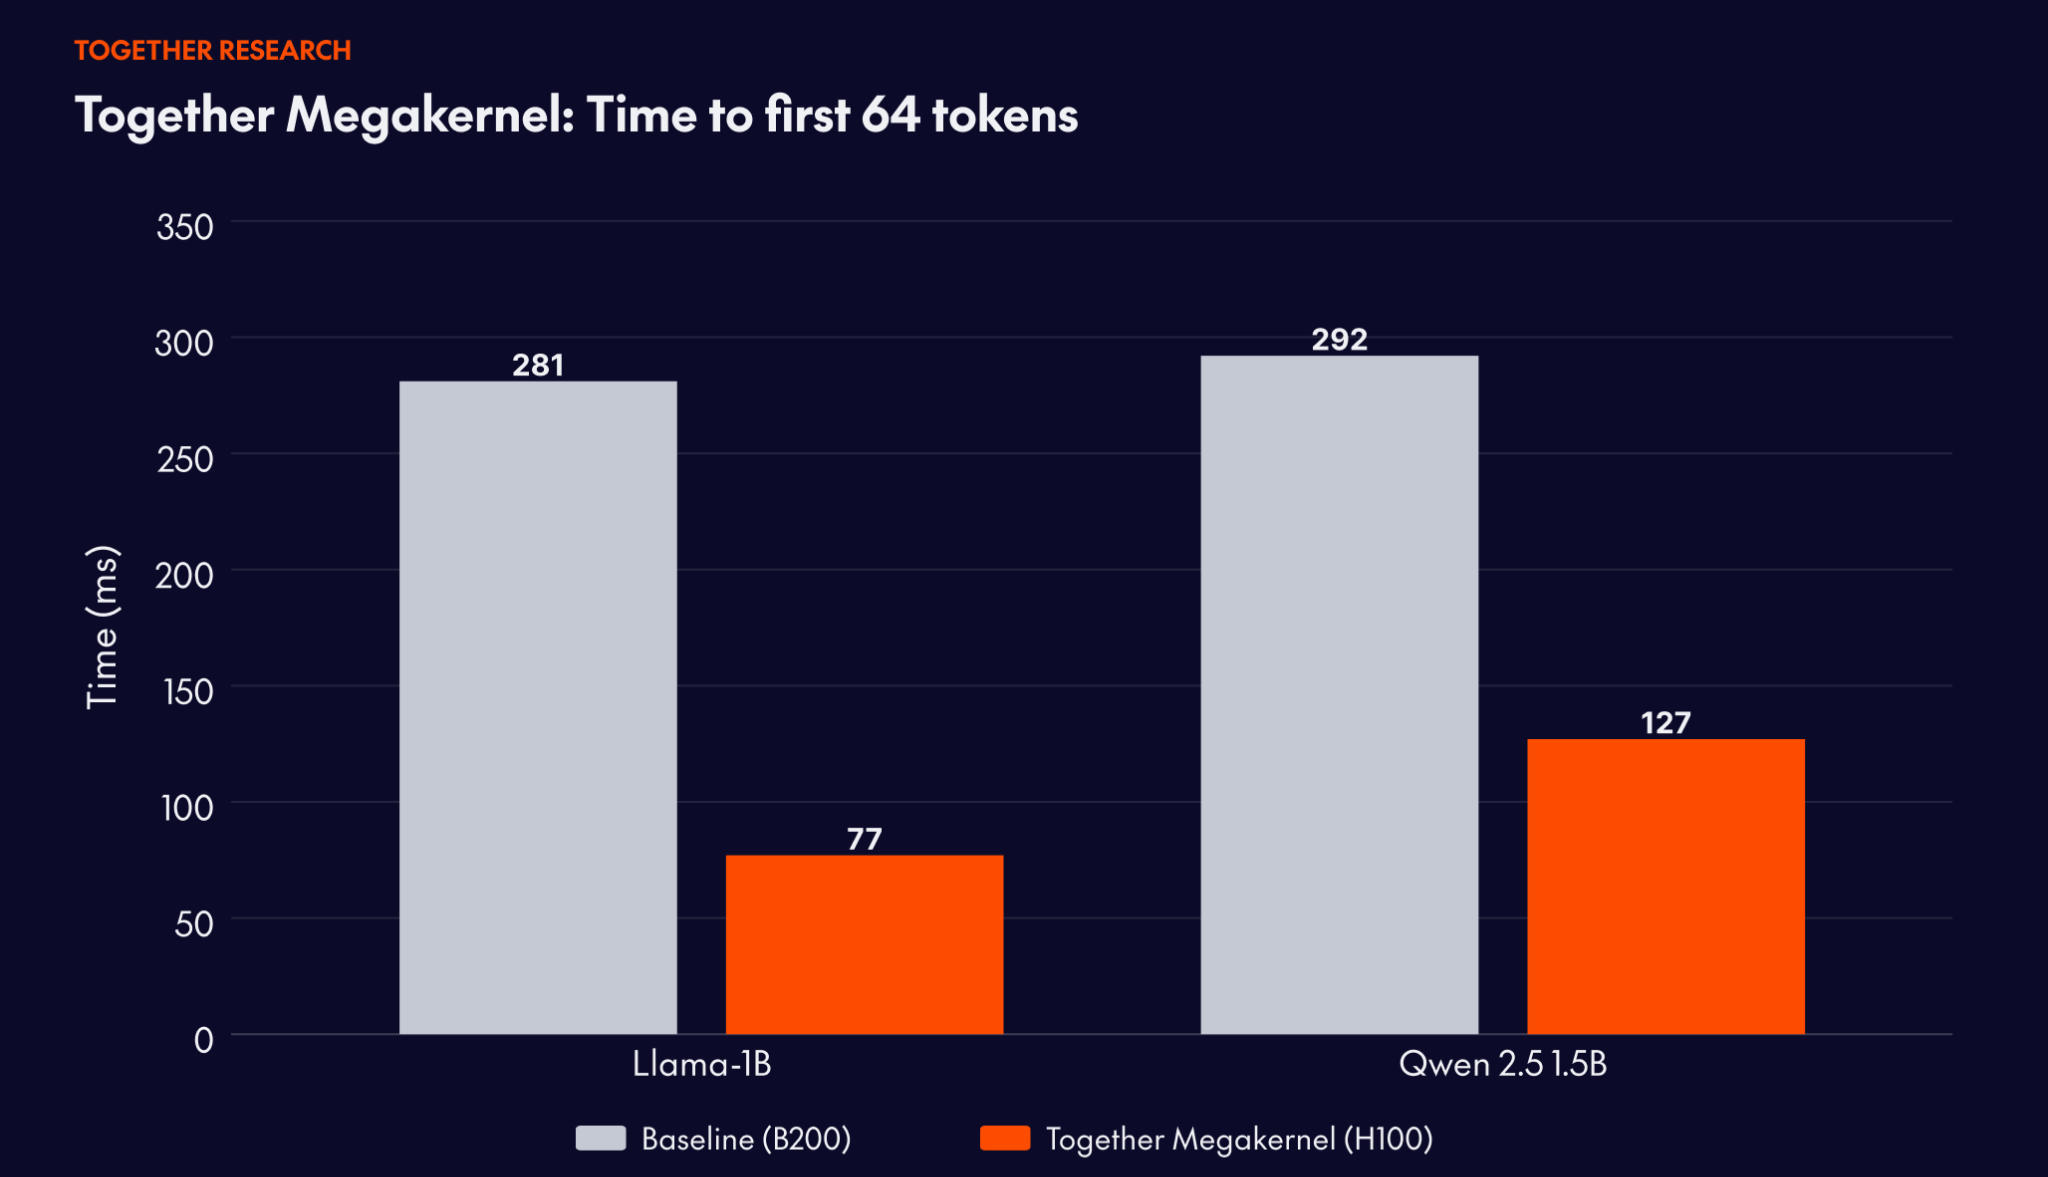
结果:在 Llama-3.2-1B 上达到 77ms,性能提升 3.6 倍,单位经济效益比其之前的部署好 7.2 倍。在 Qwen 2.5 1.5B 上为 127ms,而 B200 基线为 292ms。
Together Megakernel 是最初与斯坦福合作者共同开发的开源研究成果的生产级实现。它与 FlashAttention 同出一脉的研究传承,是软硬件协同设计,缩小了理论上可能达到的水平与已部署系统实际交付水平之间的差距。
世界级研究遇上生产现实
Together AI 的不同之处在于:我们的内核团队不只是发表论文的研究组织。我们直接面向客户,与战略合作伙伴一起改进他们的部署。
以 Cursor 为例。当你构建的 AI 原生产品中每一毫秒延迟都至关重要,开发者在实时等待代码补全时,通用基础设施是不够用的。你需要针对自己特定的工作负载、特定的模型、特定的 SLA 要求做定制优化。
这就是与 Together AI 合作能得到的:直接对接顶级的内核研究团队。我们分析你的工作负载,找出瓶颈,编写定制内核来消除它们。我们不是那种让你在大池塘里做一条小鱼的超大规模云厂商,让你提交工单,然后指望有人最终会看你的问题。
对于 SLA 要求最严苛的客户(需要实时响应的客户,以及在海量规模下每提升一个百分点的效率就意味着数百万美元成本节省的客户),我们会打造定制方案:针对系统瓶颈的定制内核,针对特定模型架构的定制优化,整个研究团队全力以赴,让你的部署快到物理极限。
这就是 AI Native Cloud 在实践中的样子:世界级的研究团队与 AI 原生的构建者携手合作,缩小理论上可能与生产中实际运行之间的差距。
协作、好奇、不懈
我们的团队文化建立在求知欲和协作之上,而非竞争,约 15 个人,带着 Dan Fu 所说的“干劲十足”(gung ho)的心态。
“我们都是和善的人,”Dan 说,“没有摇滚明星式的自大。只有对这个时代兴奋不已、喜欢一起攻克难题的人。”
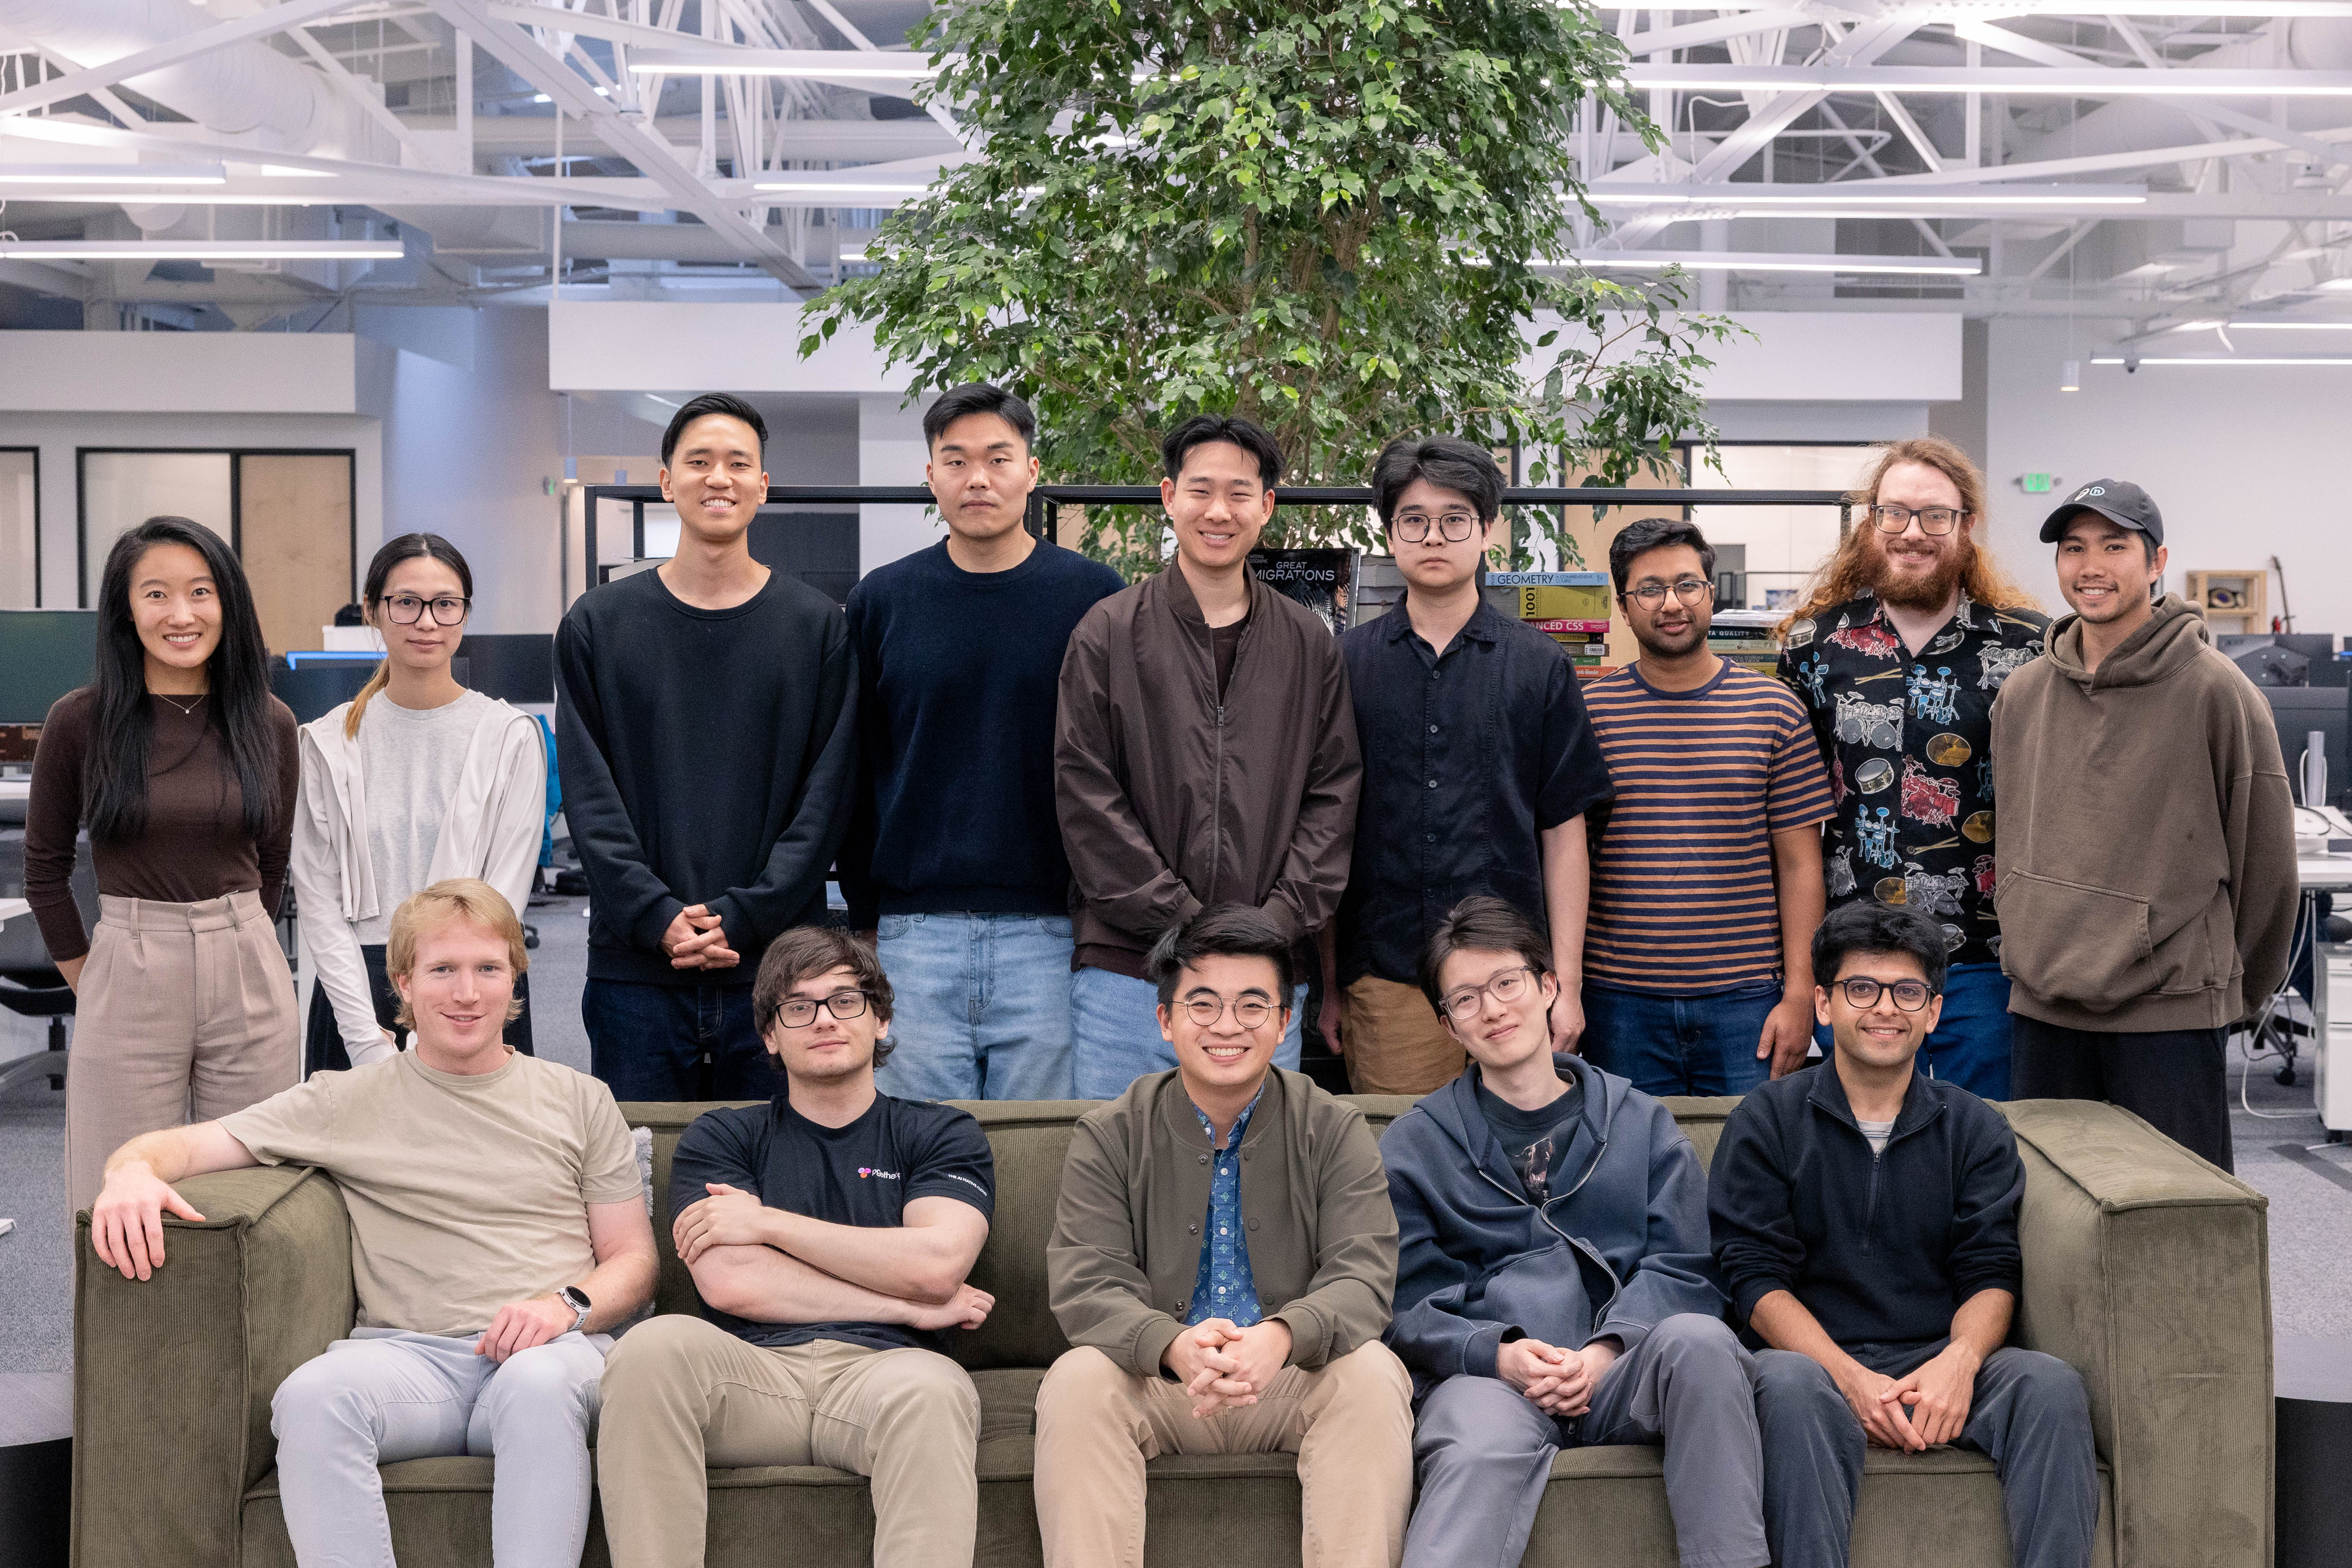
团队主要有两类人:想挑战系统问题的 ML 人才,以及转入 ML 的 GPU/图形领域人才。双方都需要学习另一半的知识。“你要理解所有的环节,才知道它们如何协同工作,”Dan 解释道。
我们在找愿意深入技术细节、不放过任何角落的人:不只是知道怎样让东西跑起来,还要知道它为什么能跑、怎样能跑得更好、是什么基本原理支配着它的行为。
这份工作有时并不光鲜。一次内核优化落地时,不会有任何公告,只有更短的训练时间、更低的成本、更高的吞吐量:这些指标决定了生产系统能不能跑起来。
但这些幅度的差别,比几乎任何其他事情都重要。
它决定了一个模型是三周训完还是三个月训完;一个 API 是 100 毫秒响应还是 1 秒响应;同样的结果是花 \$1000 万的算力还是 \$500 万。对下一代 AI 原生应用和公司而言,这些差别决定了你的产品用起来是瞬时响应还是迟钝卡顿,你的单位经济模型是否成立,你能扩展到数百万用户,还是止步于几千人。
数据质量很重要,模型架构很重要,训练技术也很重要。但如果你无法让硬件高效运转,其他这些都无法规模化。
而对于某一类工程师来说,那些在内存访问模式和计算效率中发现美、想要打造让其他一切成为可能的无形脚手架的人,这里是最令人兴奋的地方。
加入我们
我们正在为内核研究团队招人。如果你热衷于性能优化,渴望在硬件与 AI 的交叉领域工作,立即申请。