AI 性能取决于三个维度:
- 准确性:模型推理和生成输出的质量
- 吞吐量:数据中心每秒能生成多少 token
- 交互性:用户感受到的模型响应速度,主要由延迟决定
部署必须兼顾这三者:响应缓慢,高准确性就白费;每位用户的体验卡顿,原始吞吐量也意义不大。因此,实用的系统需要同时优化准确性、吞吐量和交互性。
本文聚焦吞吐量和交互性,以及模型设计的选择如何在不牺牲准确性的前提下影响二者(凡涉及准确性的取舍,我们都会指出)。
在准确性固定的前提下,问题就变成了一条二维的帕累托前沿:提升其中一个通常要以牺牲另一个为代价。目标是把整条前沿向外推,使曲线下的面积最大化(见下方图 1)。
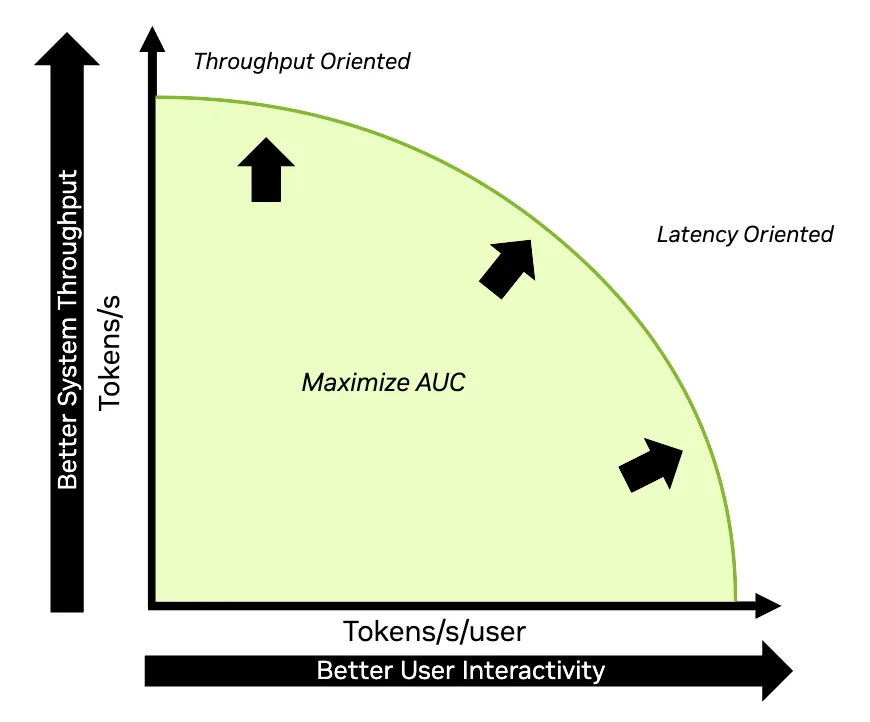
我们先从 LLM 说起,它是当今最突出的 AI 工作负载。这种权衡有两个视角:系统部署方优先关注整个集群的吞吐量(tokens/sec),而用户看重更低的首 token 延迟和 token 间延迟。token 间延迟的倒数是 tokens/sec/user,数值越高意味着响应越灵敏。
一次完整的响应看起来是这样的:提示词 → [首 token 延迟] → 首个 token → [token 间延迟] → 下一个 token,依此类推。
这是写给模型开发者的实用入门指南,面向希望自己的模型在现代硬件上运行良好的人。道理很简单:与硬件契合的模型不仅运行更快,扩展性更好、成本更低,也更容易被广泛采用。
首先来看部署场景,它沿两条轴线变化(见下方图 2)。

工作负载从短上下文到长上下文不等,服务目标则从面向吞吐量(最大化 tokens/sec)到面向延迟(最小化响应时间)不等;许多场景介于两者之间。
每个象限需要不同的优化:长上下文、面向吞吐量的服务把大部分时间花在注意力上;而面向延迟的服务会引入模型并行来缩短注意力和 FFN 的耗时,代价是通信和固定开销。短上下文、面向吞吐量的服务在注意力和 FFN 之间的时间分配更均衡,在大规模下可从并行(如专家并行)中获益。
阿姆达尔定律在此适用:优化某一部分,收益最多只有它所占时间那么大。如果注意力占运行时间的 77%,调优前馈层只能带来微不足道的收益;注意力路径才是投入精力能见到回报的地方。弄清自己处于哪种场景,就知道该把重点放在哪里。
本文给出一些简单的经验法则,帮助你尽早做出这些决策,适合任何想充分发挥硬件性能、却不想成为系统工程师的人。本系列的后续每一章将针对硬件感知设计的不同维度,帮助你避免算力瓶颈,在数据中心规模上顺畅部署,让设计契合你的用例,并在实践中实现扩展。
设计更聪明,部署更快速,扩展更广阔。让我们开始吧。
LLM 中线性层的硬件友好维度设计
Transformer 的一个关键设计选择是它的宽高比:模型宽度与层数()之间的平衡。在解码器式模型中,这些因素决定了计算和内存如何分布在整个模型栈上。宽度本身由两个维度决定,即隐藏维度()和 MLP 层中的中间投影维度()。
、 和 一起,还决定了模型与并行策略的映射有多顺畅,以及它在多 GPU 上的扩展效果。本文探讨这三个选择如何影响吞吐量、交互性和可扩展性,并重点关注线性层。
算术强度的作用
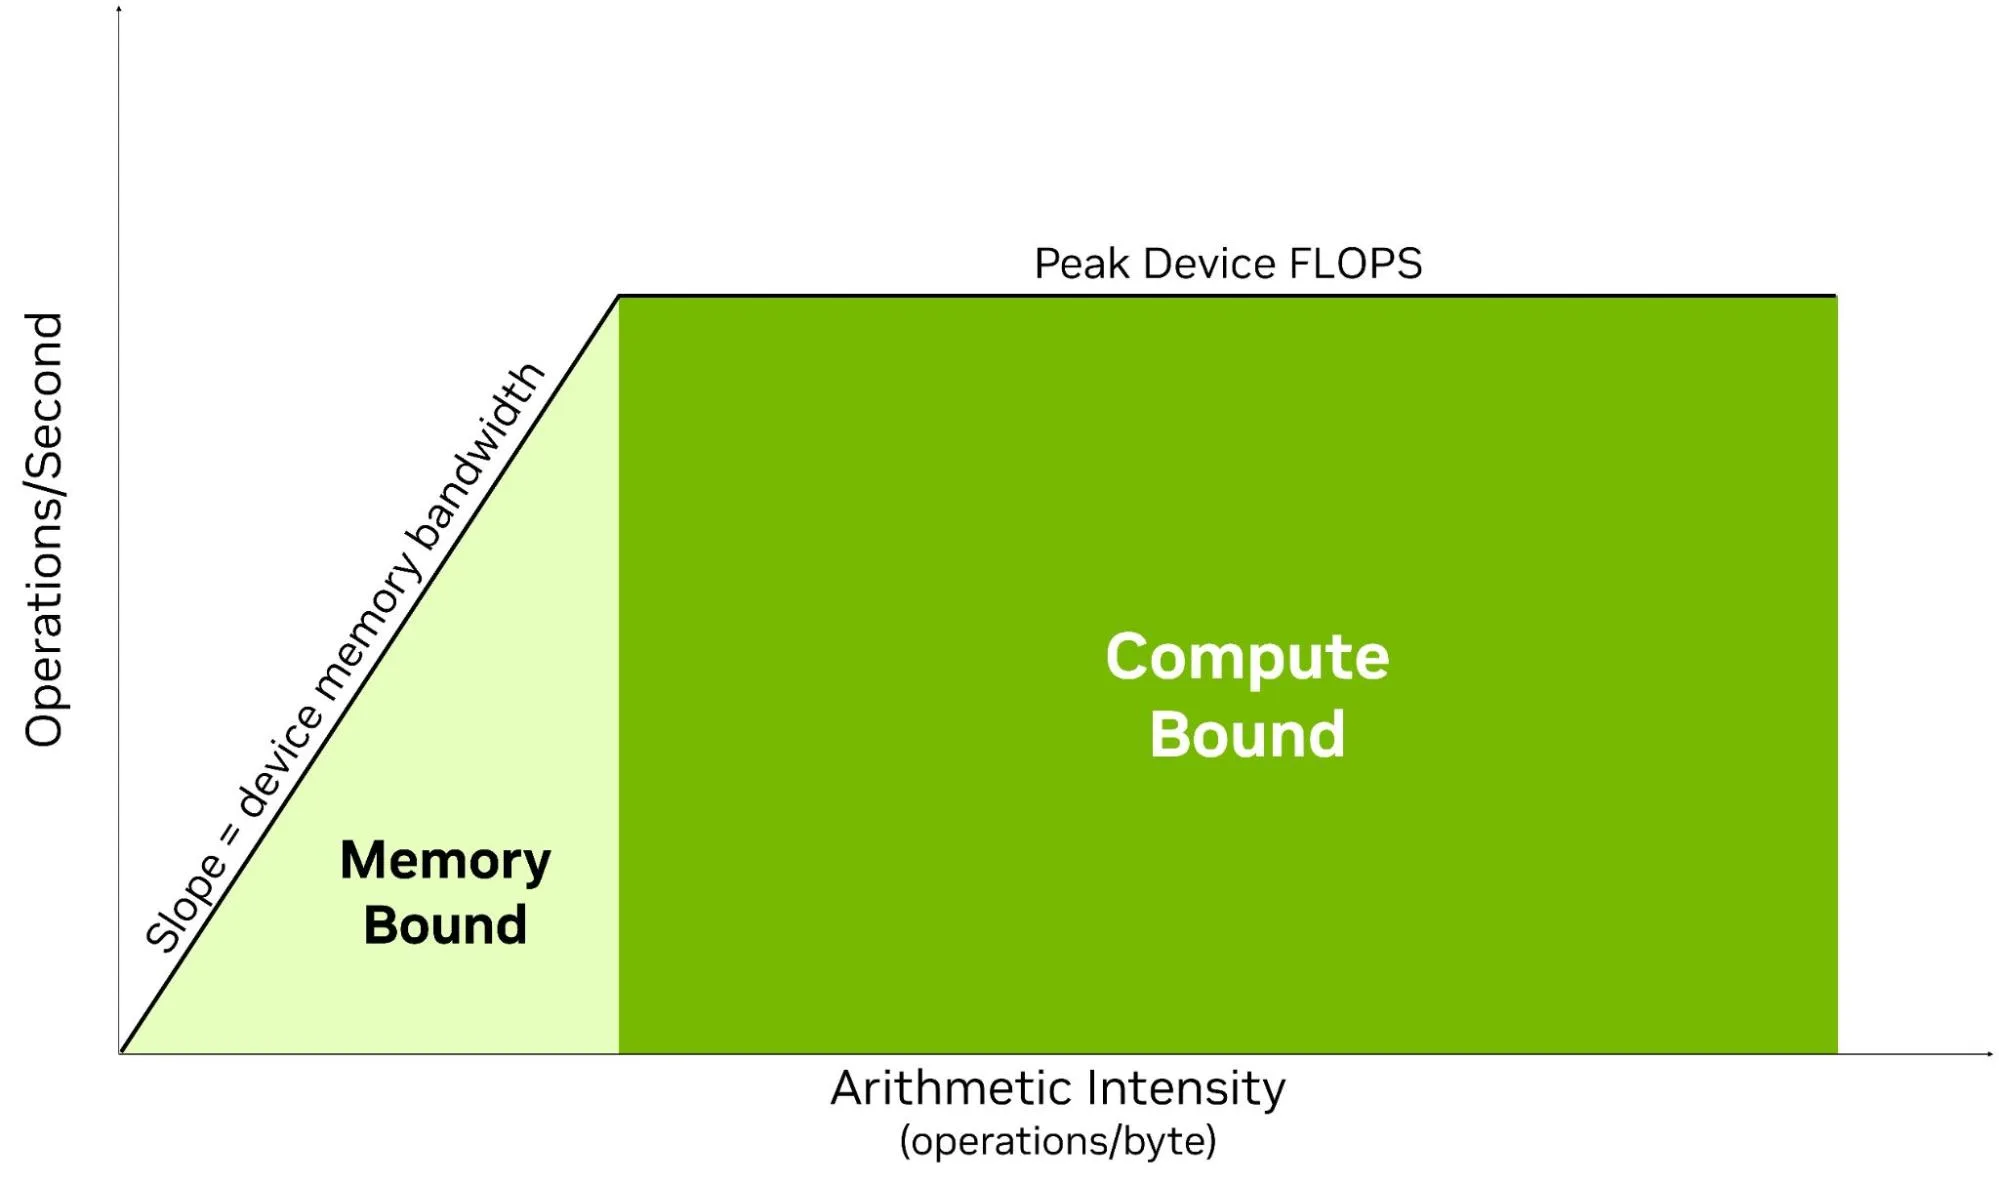
在任何硬件上,可达到的性能都受屋顶线模型(roofline model)限制。工作负载落在哪个位置,取决于它的算术强度,即每移动一字节内存所执行的计算操作数。
算术强度低的工作负载受内存带宽限制(内存受限);算术强度高的则受设备峰值计算吞吐量(以 FLOPS 计)限制(计算受限)。当目标是最大吞吐量(每秒 token 数)时,你希望把工作负载推入计算受限区域,从而用满硬件的全部数学运算能力。
对延迟敏感的解码则正好相反:它在低并发下运行,受内存限制,因此缩短内存访问时间才是降低响应延迟的办法。
提高每字节操作数有一个直接的办法,就是增大批大小,但模型形状同样重要。我们来看 和 如何决定一个 GEMM 是计算受限还是内存受限。在单个设备上运行时, 和 决定了如下形式的 GEMM 的形状:
按照典型线性代数库的惯例, 是大小为 的矩阵( 行, 列), 是 的矩阵。乘积 有 个输出,每个都是长度为 的点积,共需 次融合乘加(FMA)。由于每次 FMA 为 2 FLOPs(一次乘法、一次加法),成本为:
其中 是由所用精度决定的每元素字节数。把 视为输入、 视为权重,下方的表 1 给出了每个线性层的 token 数()、 和 到 GEMM 的 、、 的映射。
| 层名称 | 投影 (输入 → 输出) |
GEMM M | GEMM N | GEMM K |
|---|---|---|---|---|
| Q/K/V 输入线性层* | H → 3H | Tokens | 3H | H |
| 注意力输出线性层 | H → H | Tokens | H | H |
| FFN-1(上投影) | H → H′ | Tokens | H′ | H |
| FFN-2(下投影) | H′ → H | Tokens | H | H′ |
表 1. Transformer 块中线性层的 GEMM 维度(M、N、K),以 Tokens、H 和 H′ 表示
考虑每个 GEMM 都是“方阵”的情形,即 。此时单个 GEMM 执行 次 FLOPs,同时搬运约 个元素的内存,因此算术强度随 增长。实际后果是:当 或 较小时,即使 token 维度很大,GPU 花在搬运数据上的时间占比也会更高,而不是做数学运算。
举一个具体的例子,以 FFN-2 为例,故意取很小的 和 ,在 GB300 上使用 4 位输入和 8 位输出。如下方表 2 所示,即使 token 数很大(GEMM-M 很高),该层仍然是内存受限的,由数据搬运主导;写入成本占主导,是因为输出为 FP8 而输入为 FP4,加之归约维度很小,使得该 GEMM 保持内存受限。
| M(Tokens) | $N$ | $K$ | 数学运算(µs) | FP4 读取(µs) | FP8 写入(µs) |
| 256 | 8192 | 512 | 0.14 | 0.30 | 0.26 |
| 2048 | 8192 | 512 | 1.15 | 0.37 | 2.10 |
| 16384 | 8192 | 512 | 9.16 | 0.89 | 16.8 |
下方图 4 中的图表在 GB300 硅片上展示了这一点。使用 NVFP4 GEMM,并将 token 维度(GEMM-M)固定为较大的 8192,我们扫描归约维度(GEMM-K)(左图)和投影维度(GEMM-N)(右图)。在这两种情况下,当被扫描的维度较小时吞吐量都急剧下降,证实了较小的 或 会使硬件利用不足。( 和 对应 或 ,具体取决于层;见上方表 1。)

这一点对模型设计者很重要:要让算力跑满,模型维度与批大小同样关键。
准则 1: 对于参数量固定的模型,应倾向于使用接近方阵的权重矩阵,避免让投影维度或归约维度过小。
但仅有尺寸还不够。要获得较高的 Tensor Core 利用率,GEMM 的各个维度还必须与底层的分块(tiling)几何结构干净地对应;对齐不佳会造成分块量化(tile quantization),即使算术强度很高,吞吐量也会下降。
GPU 如何执行 GEMM
GPU 执行 GEMM 的方式是把输出矩阵切分成若干分块,每个分块由一个流式多处理器(SM)计算。在较新的 GPU 上,SM 不必各自为战,它们可以协作处理一个更大的分块:借助 clusterMMA,相邻的两个 SM 可以合力处理同一个分块;而协作网格阵列(Cooperative Grid Array,CGA)则让一整组 SM 作为一个集群共同工作。
协作提升了数据复用,但也扩大了有效分块,因此维度必须是更大数值的整数倍才能保持对齐。当某个维度不是有效分块的整数倍时,边缘分块只被部分填充,却仍会启动并执行一个完整分块的计算量;未使用的(填充)部分没有做任何有用功,既浪费周期又拉低吞吐量。图 5 展示了这一点:在 256×128 的基础分块、clusterMMA 和 4×2 CGA 的配置下,以细粒度步长扫描 GEMM-N 时,当 N 为 256(clusterMMA 带来的 2×128)或 512(CGA 带来的 2×256)的整数倍时,会出现局部吞吐量峰值。

为避免这种浪费,应选择分块尺寸的较大整数倍,并与 GPU 缓存行宽度对齐的模型维度。128 的倍数是安全且可移植的下限;256(clusterMMA)或 512(CGA)的倍数则与更大的协作分块对齐,能获得最高的吞吐量。
准则 2: 让模型维度至少是 128 的倍数,以对齐 GPU 分块大小和缓存行宽度;并优先选择 256 或 512,以匹配 clusterMMA 和 CGA 形成的更大分块。
更宽的模型比更深的模型对硬件更友好
在参数预算固定的情况下,更宽的模型通过更高的权重复用和更短的串行关键路径,比更深的模型具有更高的算术强度和更低的延迟。这使得更宽的模型对以吞吐量为导向和以延迟为导向的服务目标都有优势。
话虽如此,宽深比也会影响模型质量:深度贡献表示能力,所以存在一个有用的宽深比区间,而不是“越宽越好”。只在精度能保持的范围内偏向宽度,而不要为了让模型变宽就削减层数。
准则 3: 在可以选择时,优先选择更少、更大的运算,而不是大量更小的运算;这能最大化算术强度并提高硬件利用率,对吞吐量和交互性都有好处。换句话说,更宽的 Transformer 模型比更深的模型对硬件更友好。
量化:一个性能杠杆
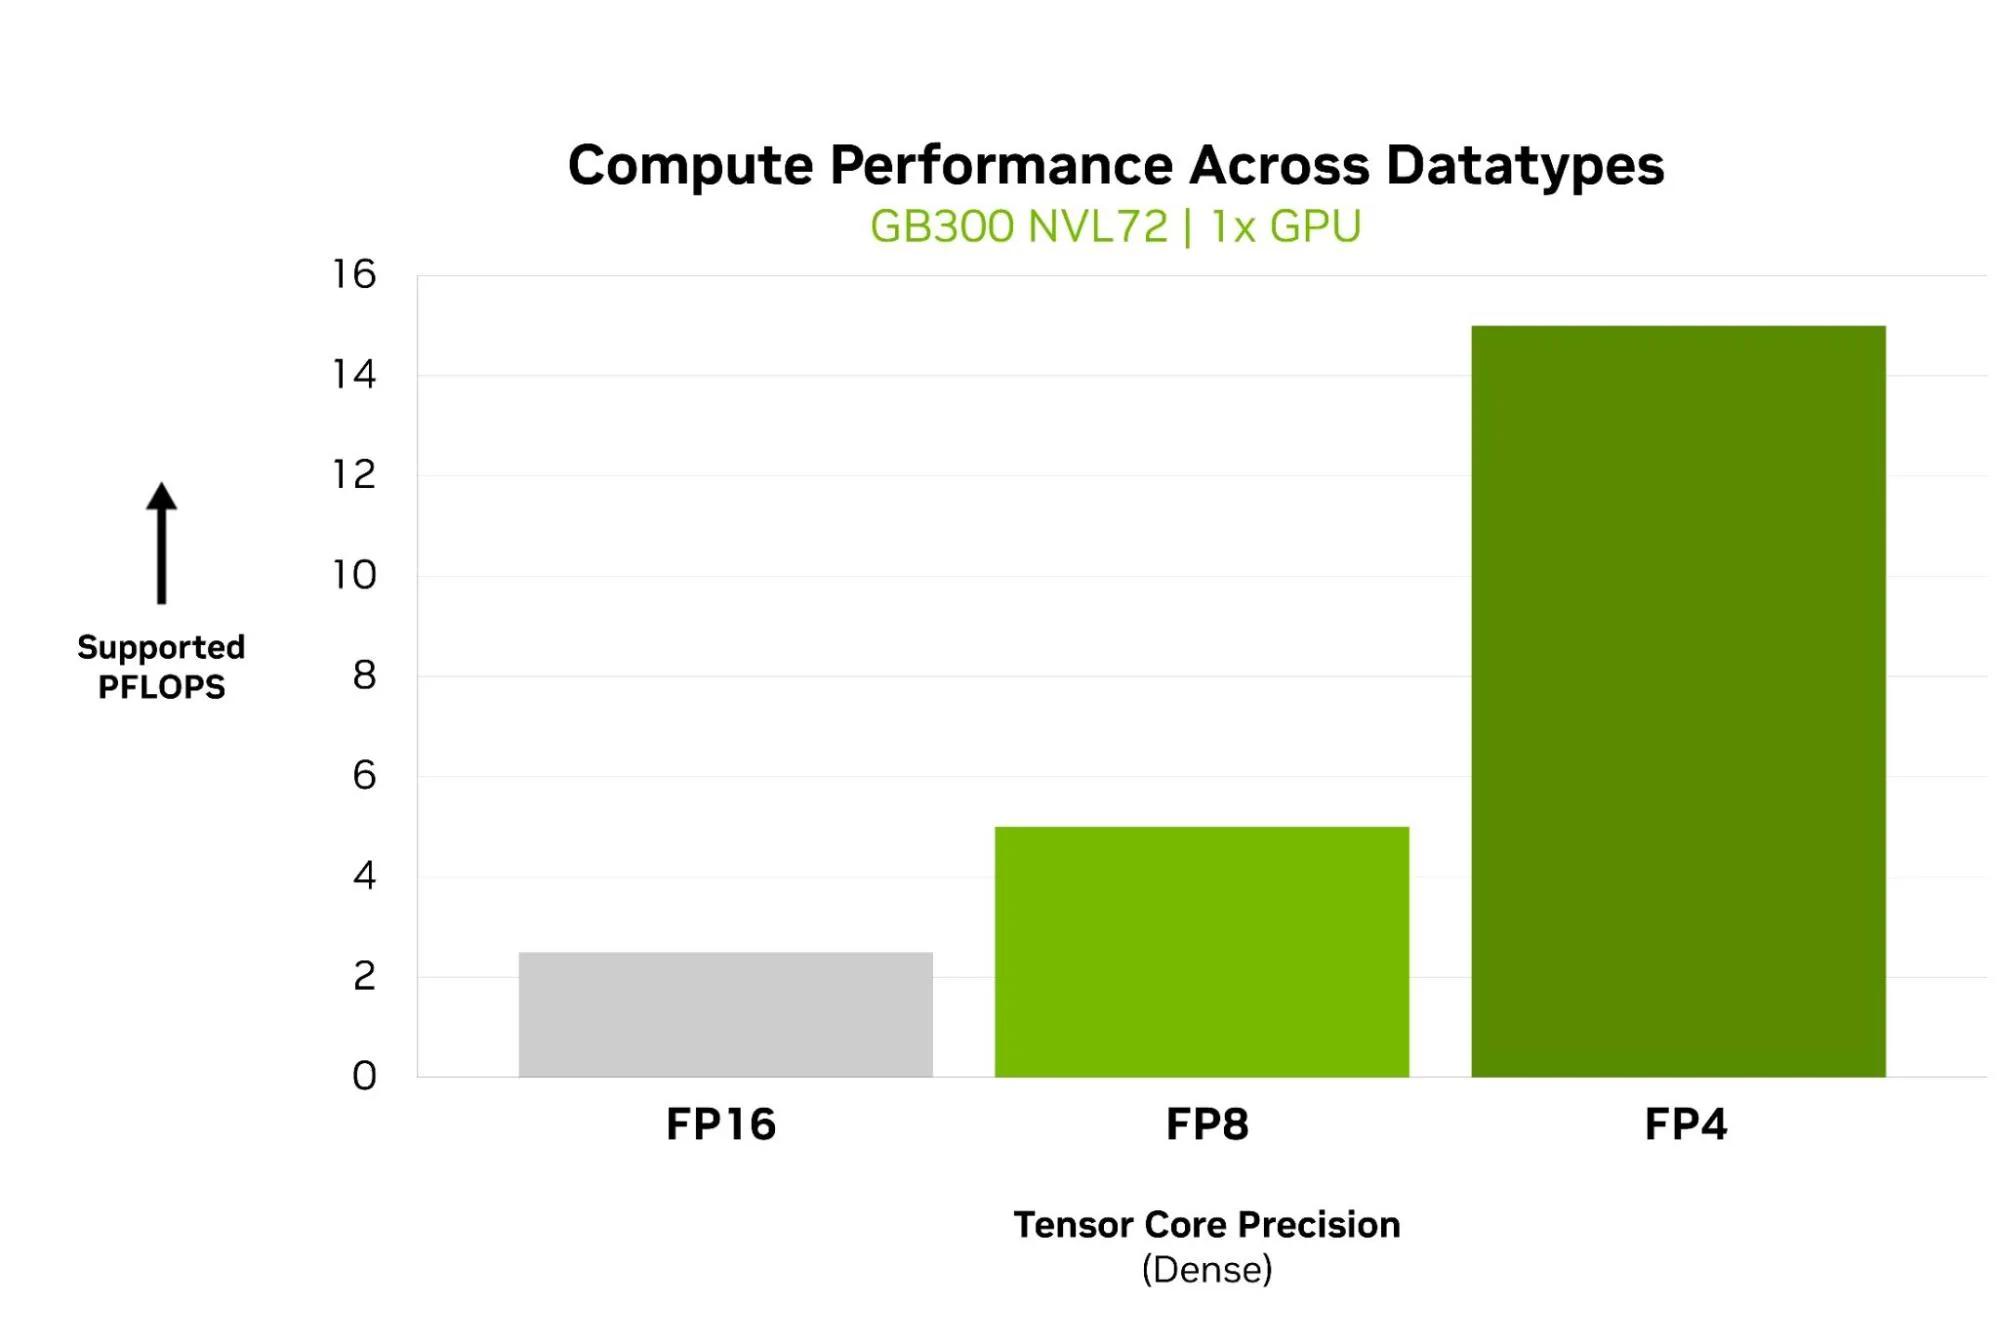
量化对计算受限和内存受限的工作负载都有帮助,因为它能同时提升数学运算吞吐量并减少内存流量。Blackwell 系统支持 NVFP4,以及 FP8、FP16/BF16 等其他位宽格式(见下方图 6)。
NVFP4 专为兼顾模型精度与速度而设计:它对每个包含 16 个值的微块应用细粒度的 FP8(E4M3)缩放因子,并对每个张量再施加第二级 FP32 缩放因子。这种分层缩放大幅降低了量化误差,同时保持 4 位计算的速度,使 NVFP4 在各类 LLM 工作负载上都能与更高精度的结果非常接近(见下方图 7,DeepSeek-R1)。

NVIDIA 提供端到端工具链让这一切切实可行:NVIDIA Model Optimizer 和 LLM Compressor 支持训练后量化(PTQ)、量化感知训练(QAT)和高级校准,能够以极小的精度损失将模型量化为 NVFP4。
因此,大多数以矩阵乘法为主的运算(例如线性层)可以充分利用 NVFP4 获得更高吞吐量,同时保持模型的保真度。如需进一步了解低位宽训练,请参阅 Pretraining Large Language Models with NVFP4(NVIDIA Research,2025)。
准则 4: 在网络中引入计算开销大的运算时,要考虑它们能否在部署时被量化。设计能受益于低精度执行的层,是充分发挥现代 GPU 性能的关键。
大规模专家并行提升吞吐量
在以吞吐量为导向的服务中,目标很简单:用最少的 GPU,尽可能快地服务尽可能多的用户。由于目前大多数最先进的 LLM 都是混合专家(MoE)模型,一种非常有效的做法是专家并行(EP):注意力部分采用数据并行,同时把 FFN 专家分布到各个 GPU 上。
对注意力采用数据并行(DP),可以避开张量并行(TP)的一个关键局限,即合并部分结果所需的昂贵的 AllReduce。这一开销会随并发度增长,拖累吞吐量,因此 TP 并不适合这里。DP 注意力的扩展更为自然:增加 GPU 会直接提高全局并发度,而更高的并发度意味着 MoE FFN 中更大的 GEMM-M。
假设词元路由是均匀的:
其中全局并发度(global concurrency)等于每个 GPU 的并发词元数乘以 GPU 数量,top-k 是每个词元激活的专家数(DeepSeek-R1 为 8),#experts 是专家总数(DeepSeek-R1 为 256)。由于 GEMM-M 随并发度增长、随模型稀疏度缩小,因此提高并发度是在稀疏 MoE 模型中获得高 GEMM 利用率的关键;又因为单 GPU 的并发度受 KV 缓存占用所限,将 EP 扩展到更多 GPU 就成为提高并发度的主要手段。
即便每个专家的有效批大小(即其 GEMM-M)很小,无论是由于并发度有限还是词元路由不均衡,扩大 EP 仍然能从两方面带来好处:
- 通过聚合带宽加快执行:把专家分布到更多 GPU 上,可以提高加载专家权重时可用的有效内存带宽,从而降低端到端的 FFN 延迟。
- 降低单 GPU 内存占用:每个 GPU 只存储一部分专家,释放出的内存可用于提高每个 GPU 的有效并发度,更好地让算力饱和。
EP 确实带来了两个挑战,即 all-to-all 通信开销和专家负载不均衡,但 NVIDIA 在 TensorRT-LLM 中的 Wide-EP 功能同时解决了这两个问题:
- 高性能 all-to-all 内核,可在 Blackwell 多节点 NVLink 系统上扩展 EP;以及
- 自适应负载均衡器,根据实时负载模式重新分配专家流量,从而在词元和专家分布倾斜时保持稳定。
详情请参阅 TensorRT-LLM 中关于专家并行扩展的文档。对于以吞吐量为导向的 MoE 部署,关键杠杆就是专家并行。
准则 5: 只要采用合适的并行策略,最显著的是把专家并行扩展到足够宽,包含大量专家的复杂稀疏 MoE 模型依然可以实现高吞吐量。
为流水线并行而设计
当你对 prefill 和 decode 进行解耦(disaggregation)时,流水线并行就变得重要。对于某些模型规模、流量模式和延迟目标,这可以是一种有效的服务策略,我们在 Beyond the Buzz: A Pragmatic Take on Inference Disaggregation(NVIDIA Research,2025)中对此做过分析:让 prefill 和 decode 采用不同的模型切分方式,可以分别对二者进行优化和扩展,从而提高整体吞吐量。
对于 prefill,要在降低首词元延迟(FTL)的同时保持高吞吐量,尤其是在长上下文场景下,需要激进的并行化。分块流水线并行(Chunked Pipeline Parallelism,CPP)非常适合这里:它既把模型各层切分到不同 GPU 上,又把输入上下文切成多个块,让它们在流水线中流动(见下方图 8)。

这使 prefill 工作节点能够在严格的 FTL 预算内处理长序列,而无需诉诸大规模张量并行(见下方图 9)。
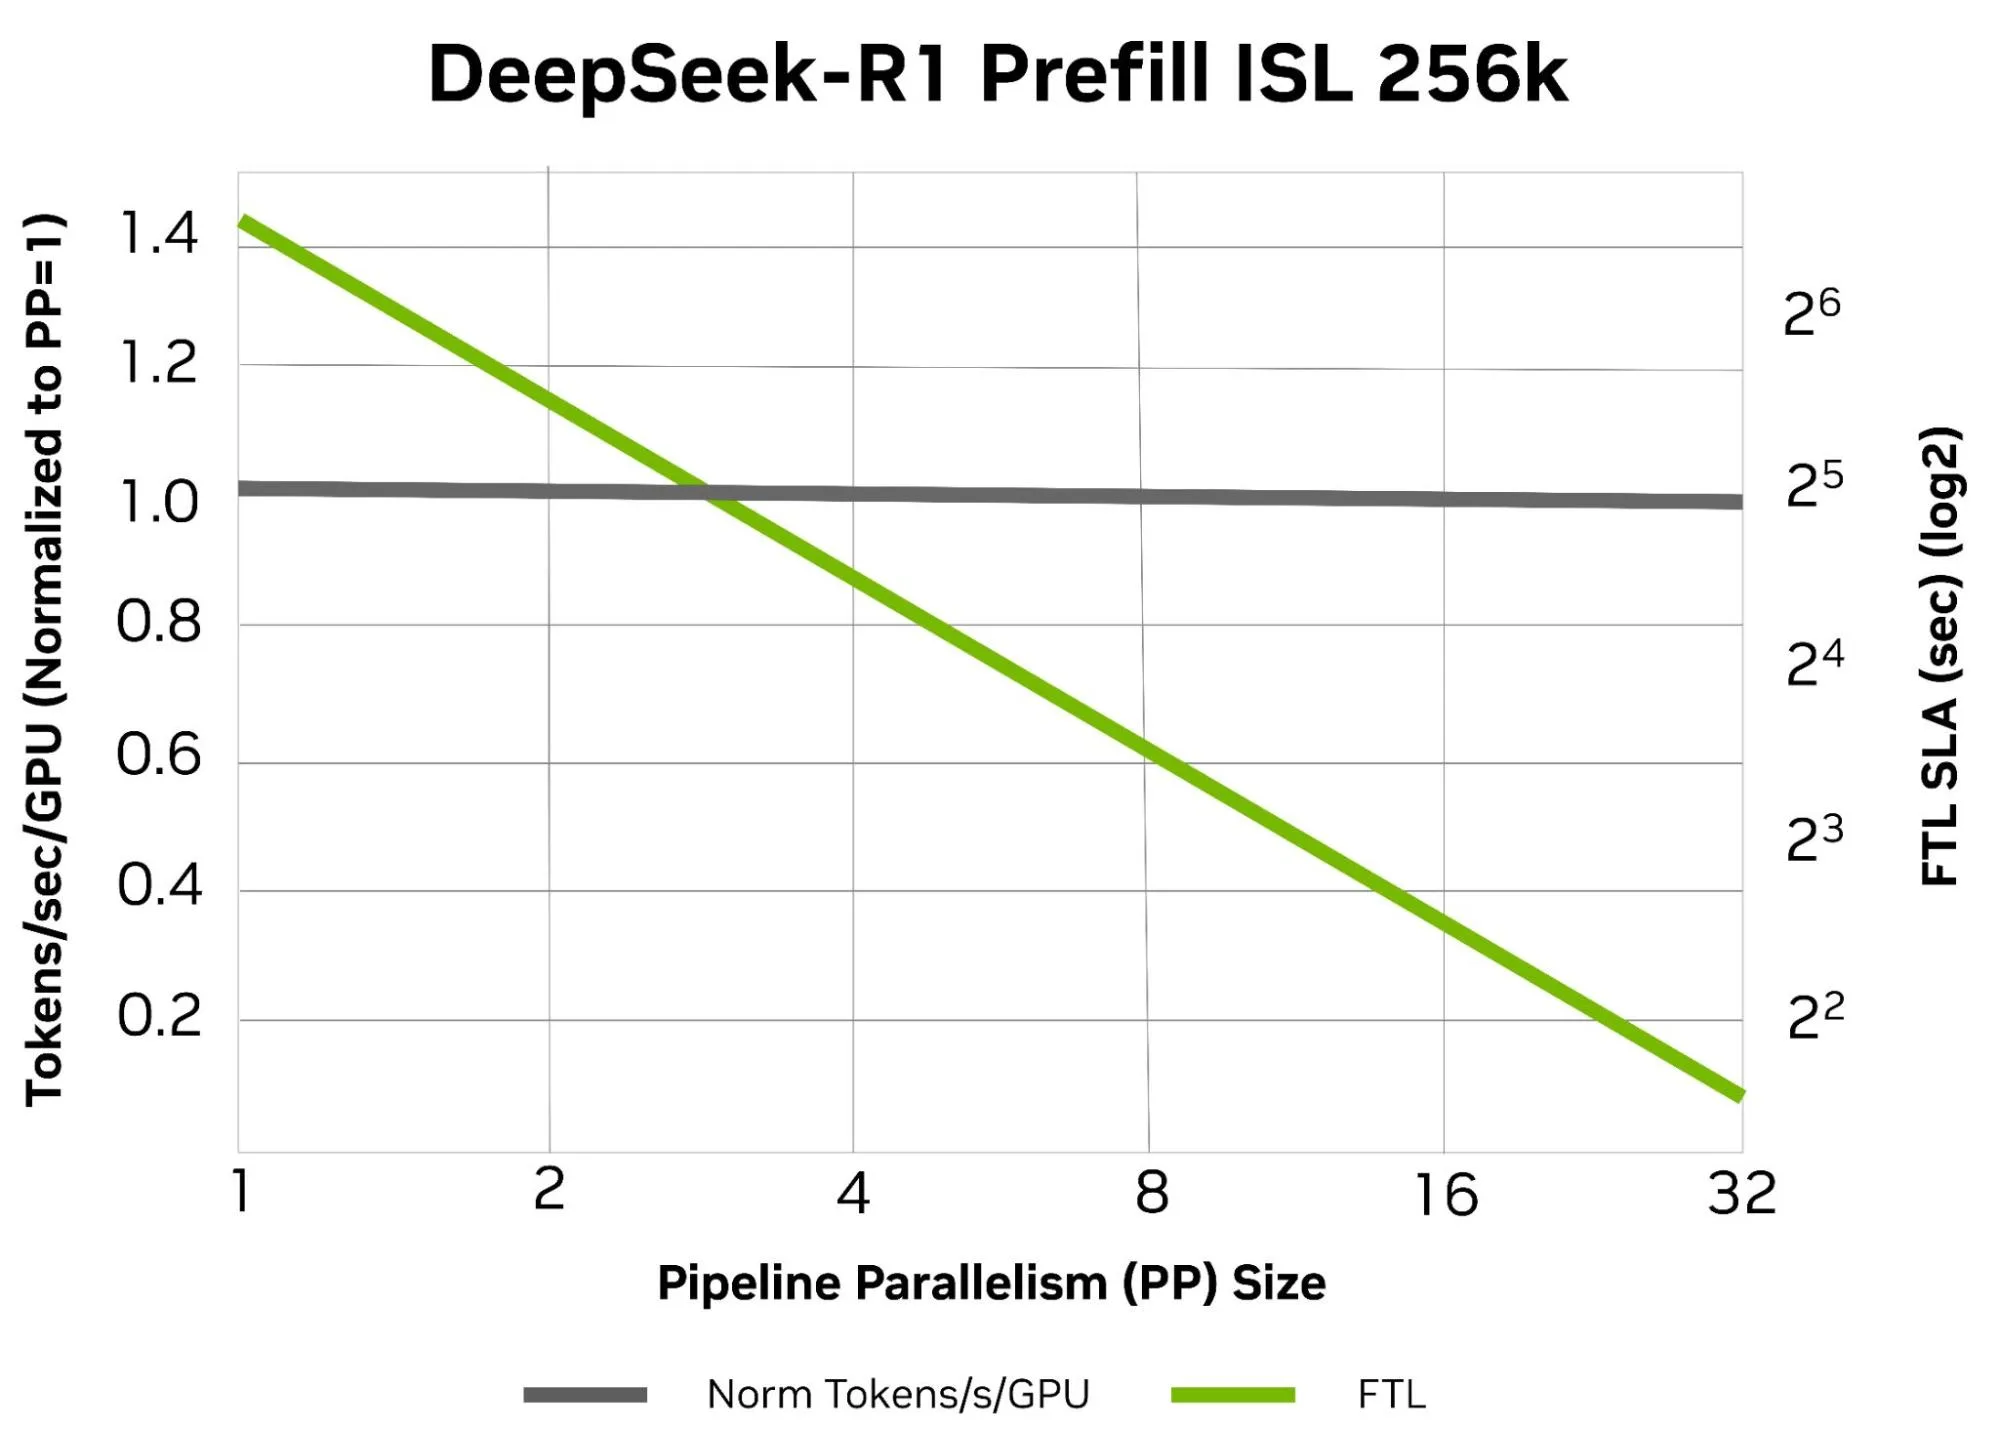
只有流水线各级保持均衡,CPP 才有回报;不均衡的各级会产生流水线气泡,使部分 GPU 处于空闲状态。保持各级均衡的一个有效办法,是用可重复、能均匀划分的层模式来构建模型。
准则 6: 设计具有规整、可重复层模式的模型,使其易于切分成均衡的流水线级。这会让模型非常适合分块流水线并行,在满足严格首词元延迟目标的同时实现更高吞吐量。
混合并行策略,满足以延迟为导向的服务目标
到目前为止,我们关注的都是吞吐量;以延迟为导向的服务则受不同的约束。要降低延迟,就需要让每个 GPU 承担更少的工作(更低的并发度)或使用更多 GPU。然而,缩小批大小最终只会降低注意力的延迟:随着 GEMM-M 缩小,GEMM-N 和 GEMM-K 维度仍然很大,FFN 延迟变为内存受限,读取 权重矩阵成为瓶颈。
在这种低并发度的状态下,注意力和 FFN 应当各自独立并行化。FFN 通过 TP、EP 或 TP×EP 把权重分散到多个 GPU 上来加速。TP 更适合专家较大的粗粒度 MoE 模型,而 EP 更适合细粒度 MoE 模型,因为后者较小的 在 TP 下会产生低效的小型 GEMM。
相比之下,注意力受益于 TP 和 KV 并行。然而,TP 只能扩展到 KV 头的数量;超过这个数量后,KV 缓存就必须被复制,从而引入冗余工作。由于现代 MQA/GQA/MLA 模型的 KV 头很少,这很快就会成为瓶颈。Helix Parallelism(NVIDIA Research,2025)通过在注意力阶段沿序列维度对 KV 缓存分片,然后在 FFN 中复用同一批 GPU 做 TPxEP,克服了这一问题。Helix 已在 TensorRT-LLM 中得到支持。尽管这些混合方案带来了额外的通信,Blackwell NVL72 的高带宽 NVLink 互连消化了其中大部分成本,其余部分则可与计算重叠。
准则 7: 设计模型和部署方案时,应使注意力与 FFN 的并行化解耦,这样增加 GPU 就能有针对性地攻克主要瓶颈,从而提升交互性。
后续步骤
在设计下一个模型时,不妨把这些准则当作一份设计检查清单:
- 让维度接近方阵,并对齐到 128(最好是 256)
- 优先选择宽度而非深度
- 为低精度(NVFP4)执行而设计模型
- 使用规整、可重复的层模式,使其能干净地映射到流水线并行
这样的小选择可以显著提高 GPU 利用率,让同样的硬件实现更快的推理、更高的吞吐量和更好的交互性。
要将这些准则付诸实践,可以使用 NVIDIA Model Optimizer 进行 NVFP4 量化,并使用 TensorRT-LLM 实现专家并行、流水线并行和 Helix 并行。