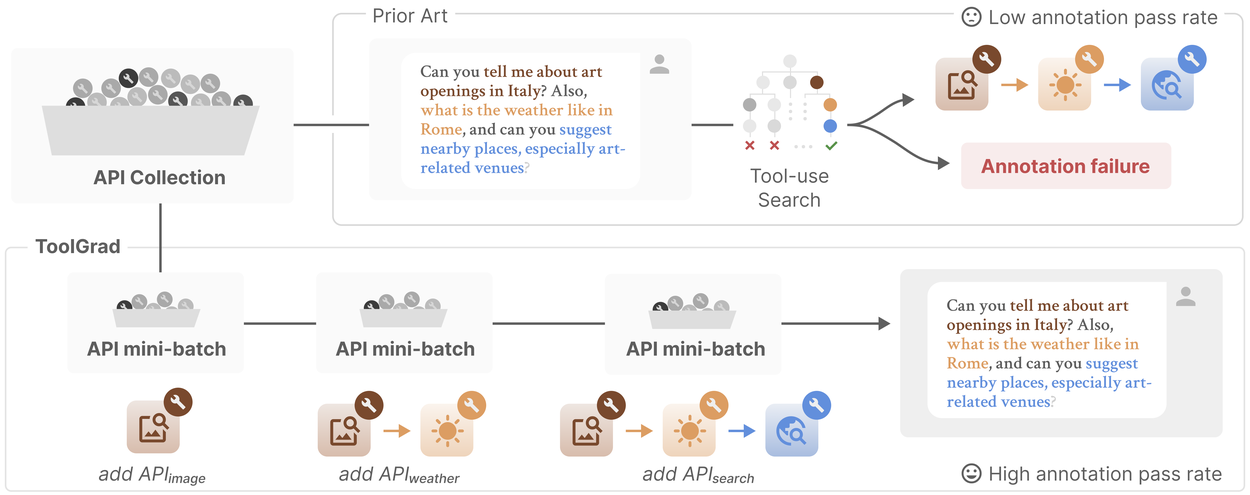
AI 智能体在自动化现实任务方面展现出巨大潜力,例如执行 Google 搜索、读取本地计算机文件,或运行生成的 Python 脚本。要实现这样的智能体工作流,LLM 需要学会正确、高效地使用工具。要教大语言模型使用工具,我们需要工具使用链及其对应用户查询的数据集。在我们早先的工作 InstructPipe 中,评估数据是人工标注的,但要为先进的 LLM 微调工作流扩大人工标注规模并不现实。为了简化数据工作流,此前的研究(例如 ToolBench 和 ToolACE)尝试用智能体通过试错自动搜索工具使用路径。这种有代表性的标注方式包含两步:(1)从采样的 API 池中生成一条假设的用户指令;(2)用深度优先搜索(DFS)智能体找出对应的工具使用方案。这种方式本质上是低效的,因为其核心思路是从复杂的智能体探索中提炼出有价值的轨迹,用来训练 LLM。
在 ACL 2026 上发表的论文《ToolGrad: Efficient Tool-use Dataset Generation with Textual ‘Gradients’》中,我们提出了另一种思路。ToolGrad 先生成一条真实可靠的工具使用链,再为其标注对应的用户提示词。直观地说,明确的工具使用方案比提示词包含更清晰无歧义的信息,因此从工具使用反推用户查询的标注要容易得多,只需一步 LLM 调用。结果显示,这种“答案优先”的方法能以更低的成本生成更复杂(长程)的工具使用数据。用我们生成的数据训练的 LLM 也优于用基线方法训练的模型,甚至在含有未见工具的分布外(OOD)数据集上,可与最先进的专有 LLM 相当。
用文本“梯度”迭代生成工具使用链
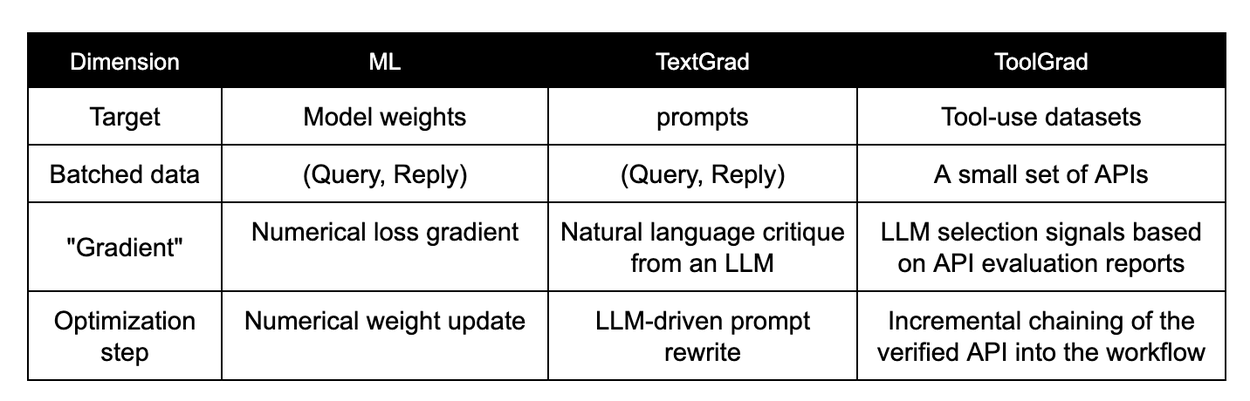
标准的机器学习(ML)系统通过在训练样本的小批量上计算数值损失梯度来改进,优化算法再用这些梯度更新模型权重。最近,TextGrad 把这一范式用于提示词工程:由 LLM 评审者给出丰富的纯文本描述性反馈,这种反馈被称为“文本梯度”。这些文本梯度随后引导对给定提示词的改写,得到能更好解决目标任务的新草稿。
ToolGrad 把文本梯度的概念从提示词优化迁移到了合成数据集生成。ToolGrad 不是优化一段静态的文本提示词,而是利用这些梯度,从大型工具库中迭代构建复杂且有效的 API 工作流。
ToolGrad 框架
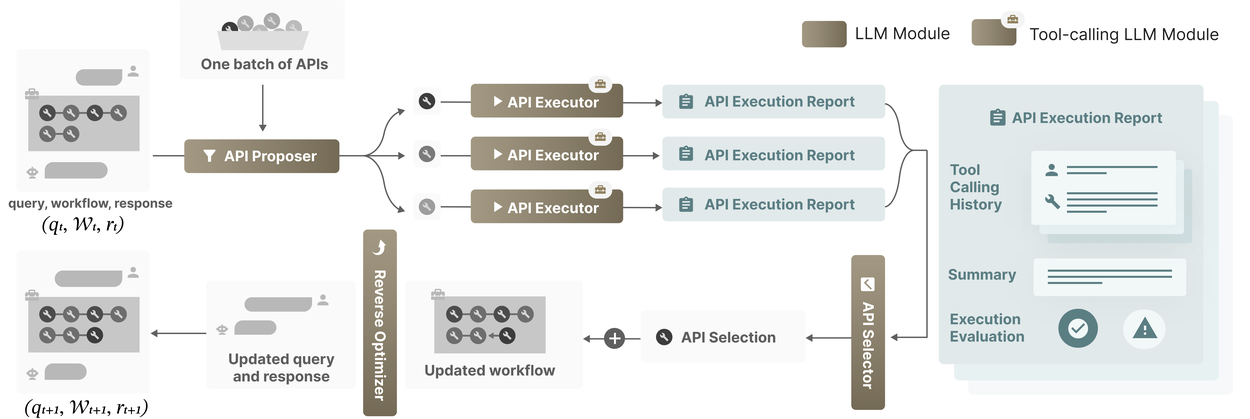
ToolGrad 有四个核心模块,依次执行提出、执行、选择和更新。
- API Proposer(API 提议器):每次迭代中,该模块把采样得到的一组 API 缩小为几个有希望的候选,用来扩展当前的工作流。
- API Executors(API 执行器):并行测试所选的 API,并生成详细的执行报告。
- API Selector(API 选择器):该模块审阅执行报告,选出表现最好的那个 API 调用,并将其追加到工作流中;这一选择相当于提供改进方向反馈的文本梯度。
- LLM Updater(LLM 更新器):最后,该模块修订合成的用户查询和 AI 回复,使其与新的 API 集合相匹配。
不断重复这一迭代过程,最终得到一个数据样本,包含用户查询、经过验证的 API 工作流和最终的 AI 回复。
实验
数据生成效率
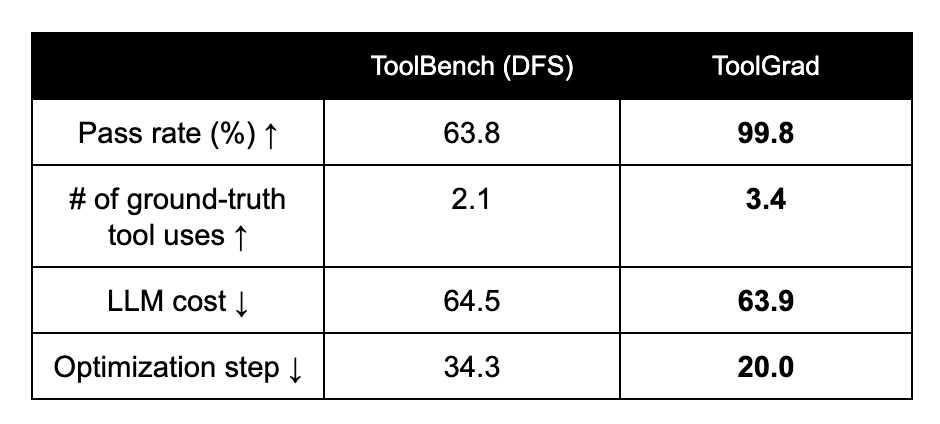
我们首先评估数据生成的成本和质量。我们以 ToolBench 作为 API 数据库(包含 1.6 万多个真实世界 API)来生成工具使用数据集。我们将 ToolBench 上最初采用深度优先搜索(DFS)的“查询优先”数据生成方法,与我们的“答案优先”方法 ToolGrad 进行比较。结果表明,ToolGrad 能以更低的生成成本,生成更复杂、通过率更高的工具使用数据。
Berkeley 函数调用排行榜
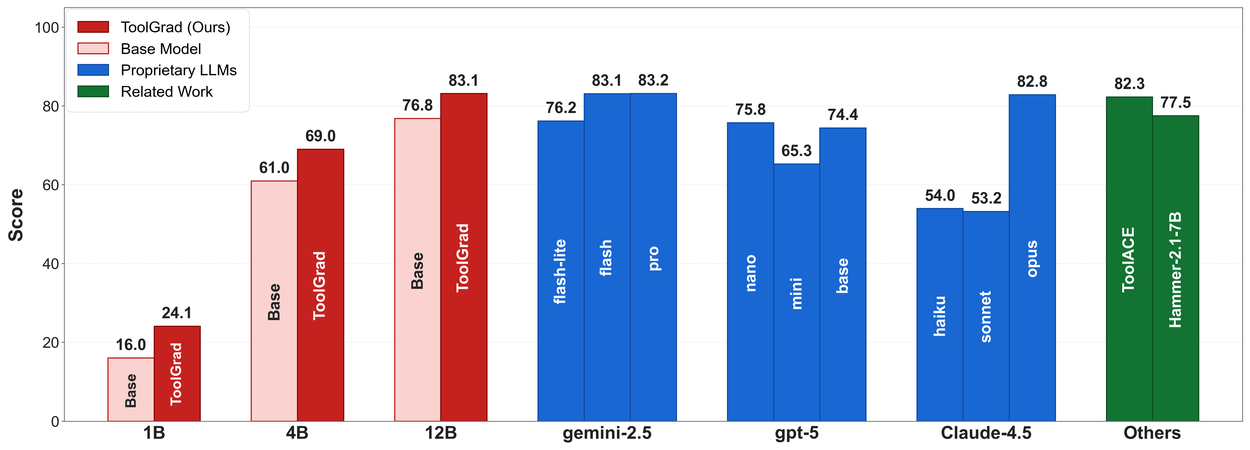
我们使用 ToolBench 的 API 数据库生成了小规模的工具使用数据集,称为 ToolGrad-500。随后我们用 ToolGrad-500 微调了 Gemma-3 模型(1B、4B 和 12B),并将微调后的模型命名为 ToolGrad-1B、ToolGrad-4B 和 ToolGrad-12B。我们在 Berkeley Function Calling Leaderboard(BFCL)上评估了这些模型的工具使用表现,这是一个工具集与 ToolBench 不同的工具使用基准测试。我们将微调后的模型与以下几类进行比较:(1)未经微调的基础模型;(2)最先进的专有模型(Gemini、GPT 和 Claude);(3)最先进的工具使用专用模型(ToolACE、Hammer-2.1-7B)。
我们的发现总结如下。
- 相对基线持续提升:在 ToolGrad-500 上对 Gemma-3 模型进行后训练,能在所有测试的参数规模上明显提升其工具使用表现。
- 超越专有 LLM:ToolGrad-12B 模型得分 83.1,表现出色,足以与发表时业界最先进的专有模型一较高下:gemini-2.5-pro(83.2)、claude-4.5 Opus(82.8)以及 gpt-5(74.4)。
- 自我进化:ToolGrad-500 数据集由 gemini-2.5-flash-lite 生成。有趣的是,我们发现,用 gemini-2.5-flash-lite 生成的数据微调的 Gemma-3-12B,可以超过它原本的“教师模型”。
- 超越其他开源模型:与其他开源的工具使用专用模型相比,ToolGrad-12B 明显领先,其中包括在更先进的 API 数据库上微调的 ToolACE。
结论与未来方向
ToolGrad 表明,通过“答案优先”的范式,可以更高效、更可靠地生成高质量的工具使用数据集。我们设计了一个智能体框架,借助文本梯度迭代地串联 API,由此解决了生产真实可靠数据长期面临的成本和可扩展性瓶颈。我们的设计在数据生成中取得了接近 100% 的通过率,让相对小巧的模型也能表现出色,并表明学生 LLM 甚至可以超越它们的教师。
展望未来,这项研究可以通过扩展框架,应对日益动态且庞大的 API 生态系统,进而应用到更广泛的现实场景。后续工作还将探索把这种自我进化能力扩展到支持持续的、实时的学习,以实现长期的个性化。随着智能体工作流日益融入企业和日常任务,像 ToolGrad 这样的框架,为训练既能力强大、部署成本又可负担的数字智能体奠定了重要基础。
致谢
这项研究主要由 Zhongyi Zhou 在 Google 担任访问研究员期间完成。我们衷心感谢主要贡献者 Kohei Uehara、Haoyu Zhang、Jingtao Zhou、Lin Gu、Zheng Xu、Tatsuya Harada 的支持,也感谢 Adarsh Kowdle 和 Shahram Izadi 的战略指导与悉心审阅。