摘要
我们提出一致性扩散语言模型(consistency diffusion language models,CDLM)。它将基于一致性的多 token 定稿与分块 KV 缓存相结合,加速扩散语言模型的推理,在数学和编程任务上实现最高 14.5 倍的延迟加速。
扩散语言模型(Diffusion Language Models,DLM)正在成为自回归(AR)语言模型之外一个很有前景的替代方案。DLM 不是一次生成一个 token,而是在多个采样步骤中迭代地精修一个部分被掩码的序列,将完全被掩码的序列逐步变成干净的文本。这一精修过程带来了一个很有吸引力的机会:它支持并行生成,让模型每次迭代定稿多个 token,吞吐量有望高于 AR 解码。同时,它还能利用双向上下文,解锁文本填充和精修等新能力。

但在实践中,标准 DLM 存在两大低效问题。[1]
- 完整双向注意力下 KV 缓存不兼容。标准 DLM 通常使用双向(非因果)注意力,每个去噪步骤都需要在完整上下文上重新计算注意力,导致推理开销很大,也无法使用标准的 KV 缓存。
- 为保证质量需要大量精修步数。高质量生成通常需要很多去噪/精修步骤,往往与生成长度相当。若简单地减少步数,质量往往会急剧下降。
CDLM 通过一套后训练方案同时解决这两个瓶颈:它让更少步数的推理变得可靠,同时支持精确的分块 KV 缓存。
背景知识:扩散语言模型中的推理
DLM 的生成是在 N 个离散采样步骤上进行的迭代精修,把 t=1 时完全被掩码的序列变换为 t=0 时的干净序列。每一步,模型根据当前带噪序列 xt 和提示 c,预测干净序列 x0 的分布:
$p_{\theta}(\mathbf{X}_0 \mid \mathbf{X}_t, c)$
一种常见的确定性实现是低置信度重掩码(low-confidence remasking):模型贪心地解除掩码(通常在块内进行),将置信度最高的被掩码位置定稿,其余位置保持掩码。这就得到了如下解码轨迹:
$\mathcal{T}_{\mathbf{x}} = \left(\mathbf{x}_{t_0}, \mathbf{x}_{t_1}, \ldots, \mathbf{x}_{t_N}\right), \quad t_k = 1 - \frac{k}{N}$
它记录了部分精修的序列如何逐步演化。这条轨迹是 CDLM 训练的核心对象。
CDLM 训练
1)轨迹收集
我们用 DLM 在特定领域的提示上运行推理,离线收集轨迹。对每个提示 x,我们记录 token 级的解码轨迹 T_x、一个紧凑的隐藏状态缓冲区 H_x(保存 token 定稿时刻的最后一层隐藏状态),以及真实文本 ŷ。具体来说,我们采用分块解码,生成长度 L_g = 256,块大小 B = 32,总步数 N = L_g(即在当前块内每步恰好定稿一个 token)。这种保守的设置能产生质量更高的蒸馏轨迹。
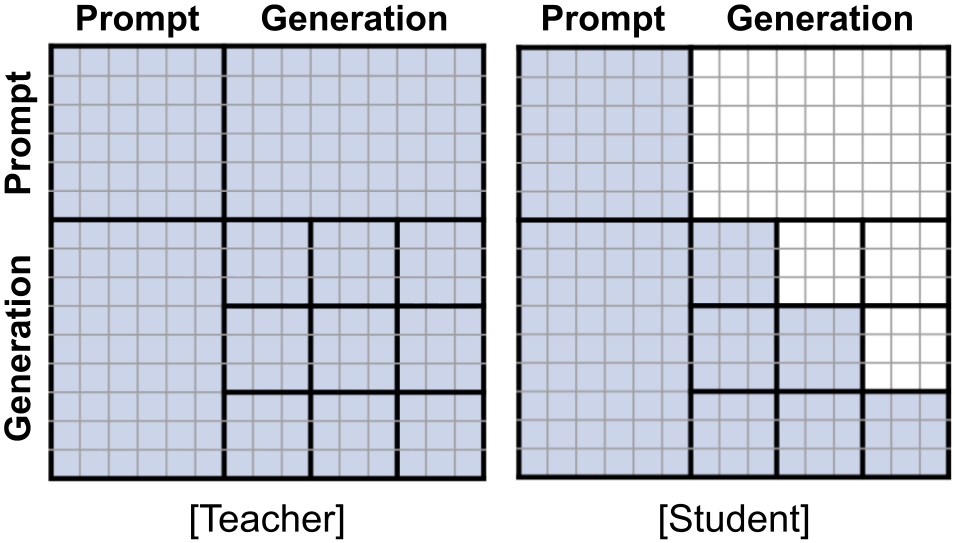
2)分块因果的学生模型与注意力掩码
在提取轨迹时,我们使用完整的双向注意力掩码。相比之下,训练 CDLM 时我们采用分块因果掩码,使其只关注提示、已完成的块和当前解码块。这一设计让模型从完整双向注意力切换为块扩散(block-diffusion)模型(类似 [2]),从而可以对已定稿的块使用精确的分块 KV 缓存。
3)训练目标
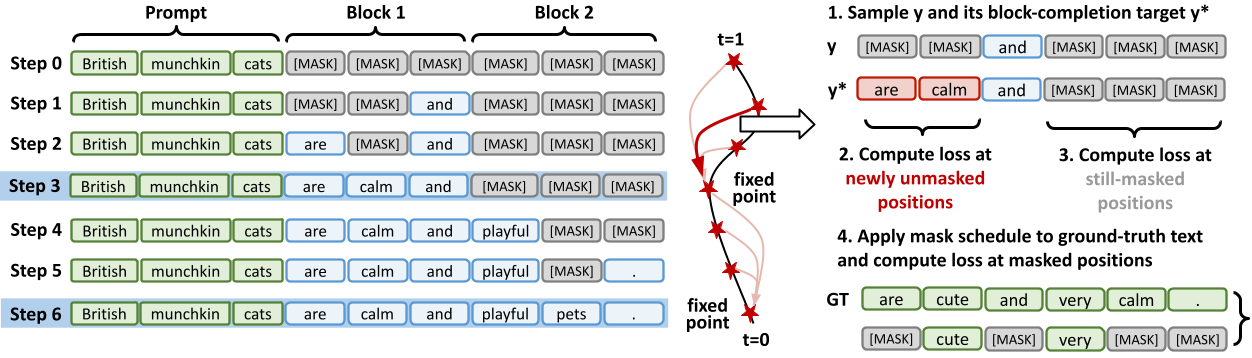
CDLM 联合最小化三个目标:
(i)蒸馏损失(新解除掩码的位置)
对于在中间状态 y 与其块完成状态 y* 之间新解除掩码的位置,我们让学生的预测分布与教师的重构分布对齐,后者由存储的隐藏状态得到。
直观理解:该目标是主要的锚点,教会学生在分块因果约束下于块内一次定稿多个 token。
(ii)一致性损失(仍被掩码的位置)
对于仍被掩码的位置,我们使用停止梯度(stop-gradient)的目标,让学生在状态 y 的预测与其自身在信息更充分的状态 y* 的预测对齐,以此强制块内的时间一致性。
直观理解:该目标鼓励解码轨迹上的多步转移保持稳定。
(iii)辅助的 DLM 掩码去噪损失
我们加入一个标准的掩码去噪目标,作用于随机掩码的真实文本。
直观理解:该目标保留了模型通用的掩码 token 预测能力,有助于保持推理行为,尤其是在数学任务上。
4)推理
推理时,CDLM 以分块自回归的方式解码,对提示和所有已定稿的块复用 KV 缓存。在每个块内,我们采用基于置信度阈值的并行定稿。[3] 一旦当前块中出现文本结束 token,我们还会提前停止。
我们有意避免引入额外超参数的其他启发式方法(例如依赖任务设置的块间并行),而是专注于一条稳健的默认解码流程,其基础是精确的 KV 缓存和可靠的步数削减。
主要结果:CDLM–Dream
我们的发现:
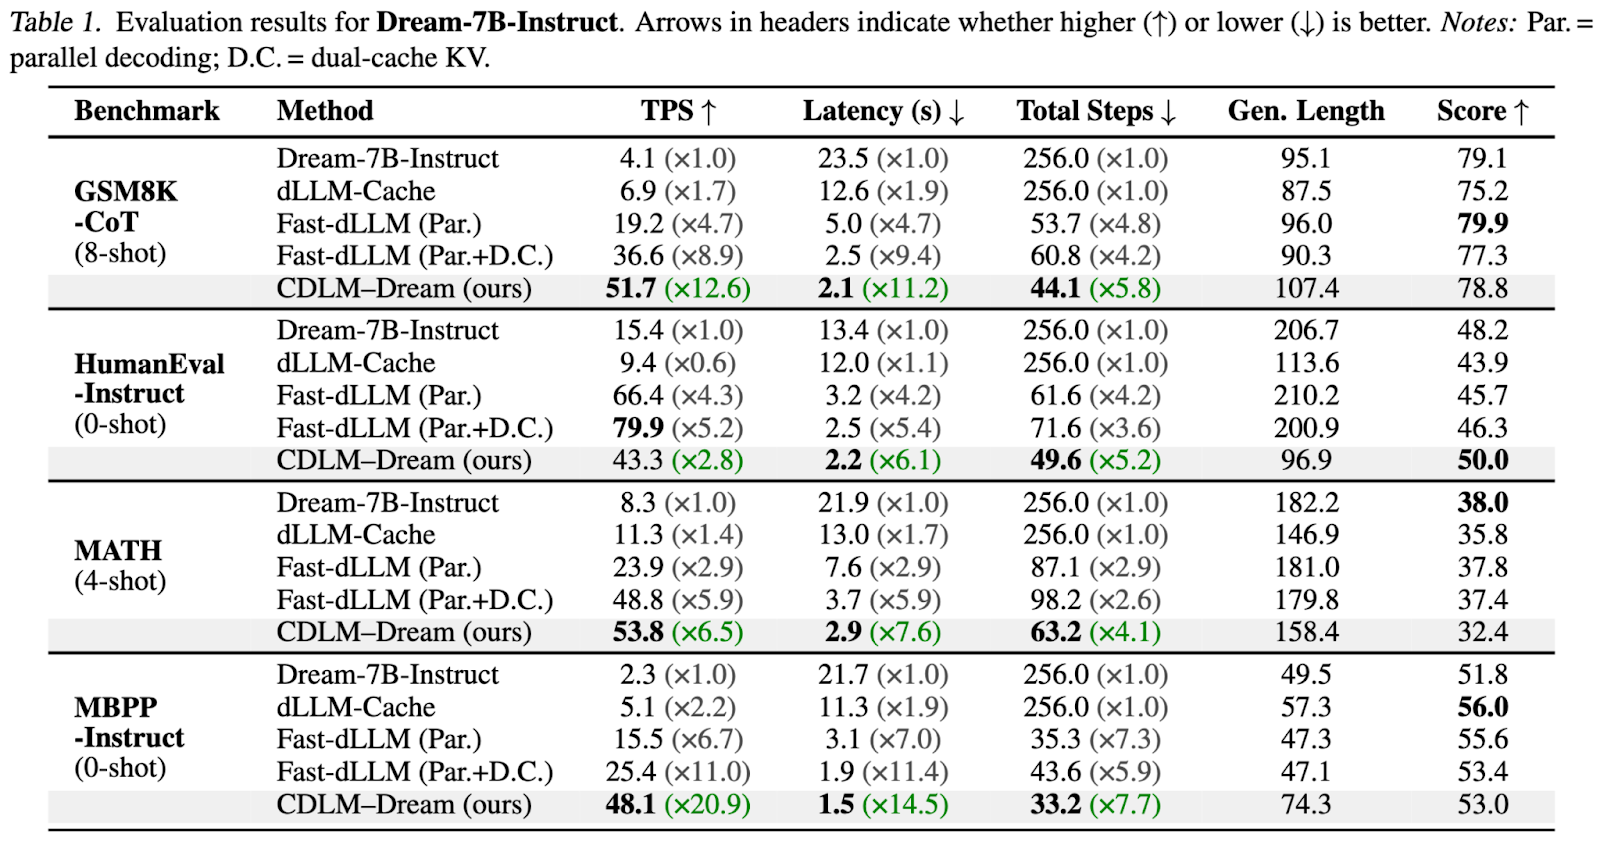
- CDLM–Dream 在各基准测试上实现了最大的步数削减,将精修步数削减约 4.1 至 7.7 倍,且大多数任务上准确率变化很小。
- 这些步数削减转化为大幅的延迟改善:在 GSM8K-CoT 上最高 11.2 倍,在 MBPP-Instruct 上最高 14.5 倍。
- CDLM 往往能取得最高的每秒 token 数吞吐量,但有一点值得注意:由于 CDLM 严格遵循分块因果,各任务的解码动态可能不同,它可能产生更短的输出,同时保持 pass@1 质量。
有效削减步数:为什么训练很重要
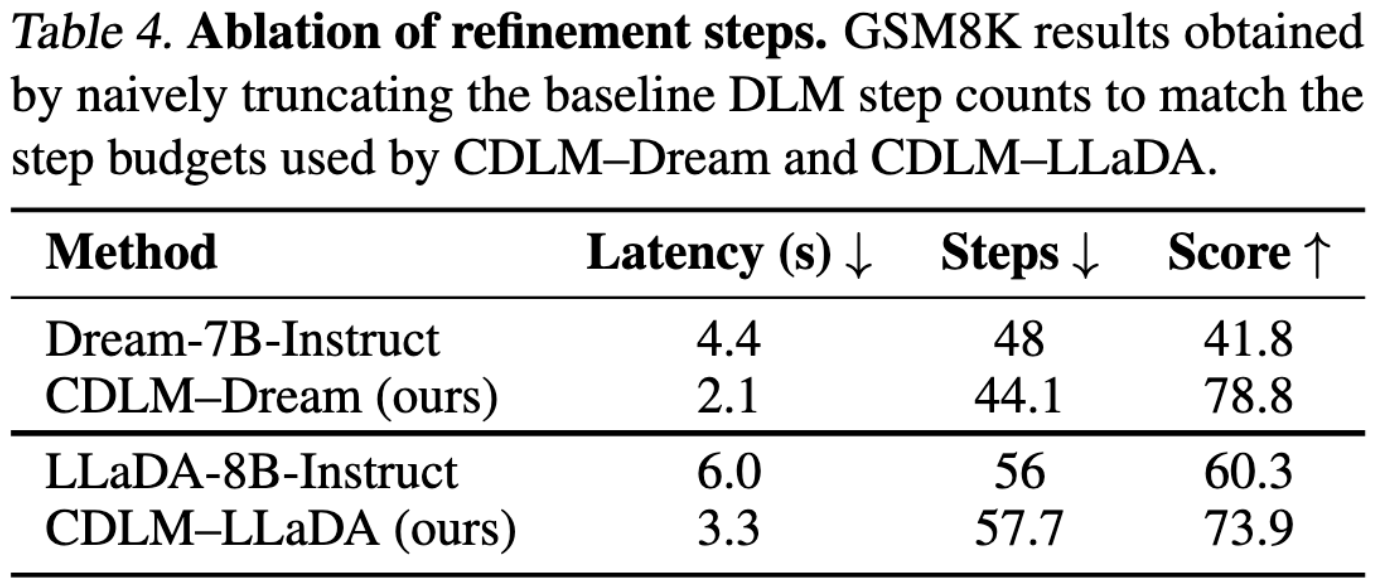
简单截断步数会导致准确率明显下降,而 CDLM 在相近的步数预算下保持了质量(并且由于缓存,延迟约为一半)。这凸显了核心观点:稳定的多 token 精修不是免费的,它需要强化轨迹一致行为的训练。
系统层面分析:为什么分块 DLM 处于最佳平衡点
为了理解硬件利用率,我们分析了随批大小增加的算术强度(arithmetic intensity,AI,即每搬运一字节数据对应的 FLOPs),比较对象包括:AR 解码、原始(完整注意力)DLM,以及 B∈{4,16,32} 的分块 DLM(CDLM)。
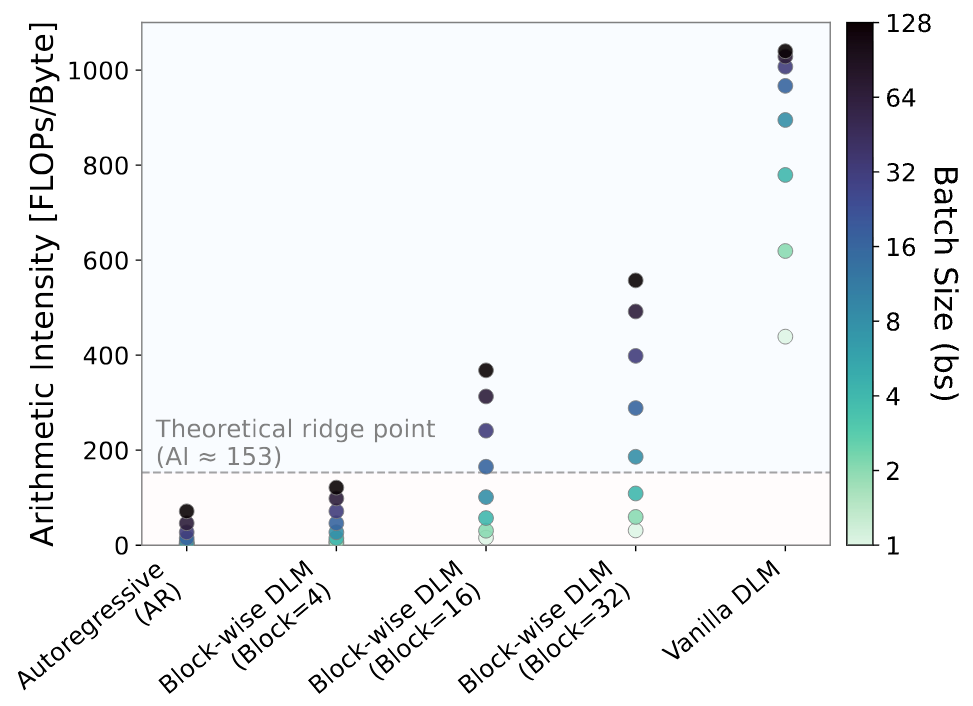
关键解读:
- AR 解码在小批量下强烈受限于内存带宽(bs=1 时 AI 接近 1),随着批大小增加,由于权重加载被摊销,AI 随之上升。
- 原始 DLM 即使在 bs=1 时也是计算受限的,因为完整双向注意力每步都要处理整个序列,导致算力饱和。
- 分块 DLM(CDLM)处于中间状态:由于块内并行(在相近的内存流量下处理 B 个 token),AI 高于 AR,但低于原始 DLM,对小批量场景来说往往是一个均衡的工作点。

总体而言,该分析解释了为什么类似 CDLM 的分块扩散能在小批量下带来很高的效率:它利用并行来摊销内存访问,同时仍处于可以从实际扩展中受益的区间。
讨论 & 结论
表达能力与效率
DLM 中的完整双向注意力要求在每个去噪步骤重新计算 O(L^2) 的注意力,使推理的计算开销极高。CDLM 支持精确的 KV 缓存,同时在每个块内保留双向上下文,从而保留了局部精修能力(例如在当前块内做填充)。
借助更强的 DLM 主干模型扩展
CDLM 是一套后训练方案,可应用于任何块扩散模型,随着更强的 DLM 出现,其收益有望进一步增长。一个有前景的方向是从更大、更强的 DLM 教师模型收集轨迹,再用 CDLM 训练中等规模的学生模型。
结论
我们提出了 CDLM,一种基于训练的加速方案,将一致性建模引入 DLM。通过强化块内时间一致性并微调分块因果的学生模型,CDLM 减少了精修步数,并支持精确的 KV 缓存。在数学和编程任务上,CDLM 实现了更快的推理、更少的步数、更低的延迟和更高的吞吐量,同时保持了有竞争力的准确率。
[1] 超越下一词元预测:扩散语言模型与自回归语言模型的性能特征分析
[2] 块扩散:在自回归与扩散语言模型之间插值
[3] Fast-dLLM:通过启用 KV 缓存与并行解码实现扩散 LLM 的免训练加速