Together 的内核团队最近拿到了 NVIDIA Vera Rubin NVL72 平台的使用权限。过去几天,我们深入研究了新的 ISA,并用微基准测试对这颗芯片做了各种探查。新特性很多,也很有意思!我们已经在 ThunderKittens 中补充了一些功能,可用于在 Vera Rubin 上编写 NVFP4 和 FP8 GEMM,也能帮助其他小猫们去探索星辰。
在深入介绍 Vera Rubin 带来了什么之前,我们先快速回顾一下 Blackwell GPU 上的 GEMM。
起点:NVIDIA HGX B200 上的 GEMM
NVIDIA Blackwell 架构的第五代张量核心从根本上改变了 GEMM 的编程模型。NVIDIA Hopper 架构的 wgmma 指令由一个 warpgroup 集体发射,而 Blackwell 的 tcgen05 指令由单个线程发射,因此只需一个小的生产者 warp 就能驱动张量核心。累加器也从寄存器移到了张量内存(Tensor Memory),操作数直接从共享内存读取,使得单个 MMA 可以跨越两个 SM 上的两个 CTA。
为了在 Blackwell 上达到有竞争力的性能,我们的 GEMM:
- 启动线程块集群(threadblock cluster),使每对 CTA 可以通过 TMA 多播共享操作数,把来自 HBM 的内存流量减半。
- 在集群内对 warp 做分工:加载器通过 TMA 把 A 和 B 搬入共享内存,单个 MMA warp 驱动张量核心,消费者 warpgroup 则把算好的累加器从张量内存送往 HBM。
- 以持久化方式运行:一个分块的输入正在流入时,上一个分块的输出仍在排出。
通过这些努力,我们得到了如下结果。
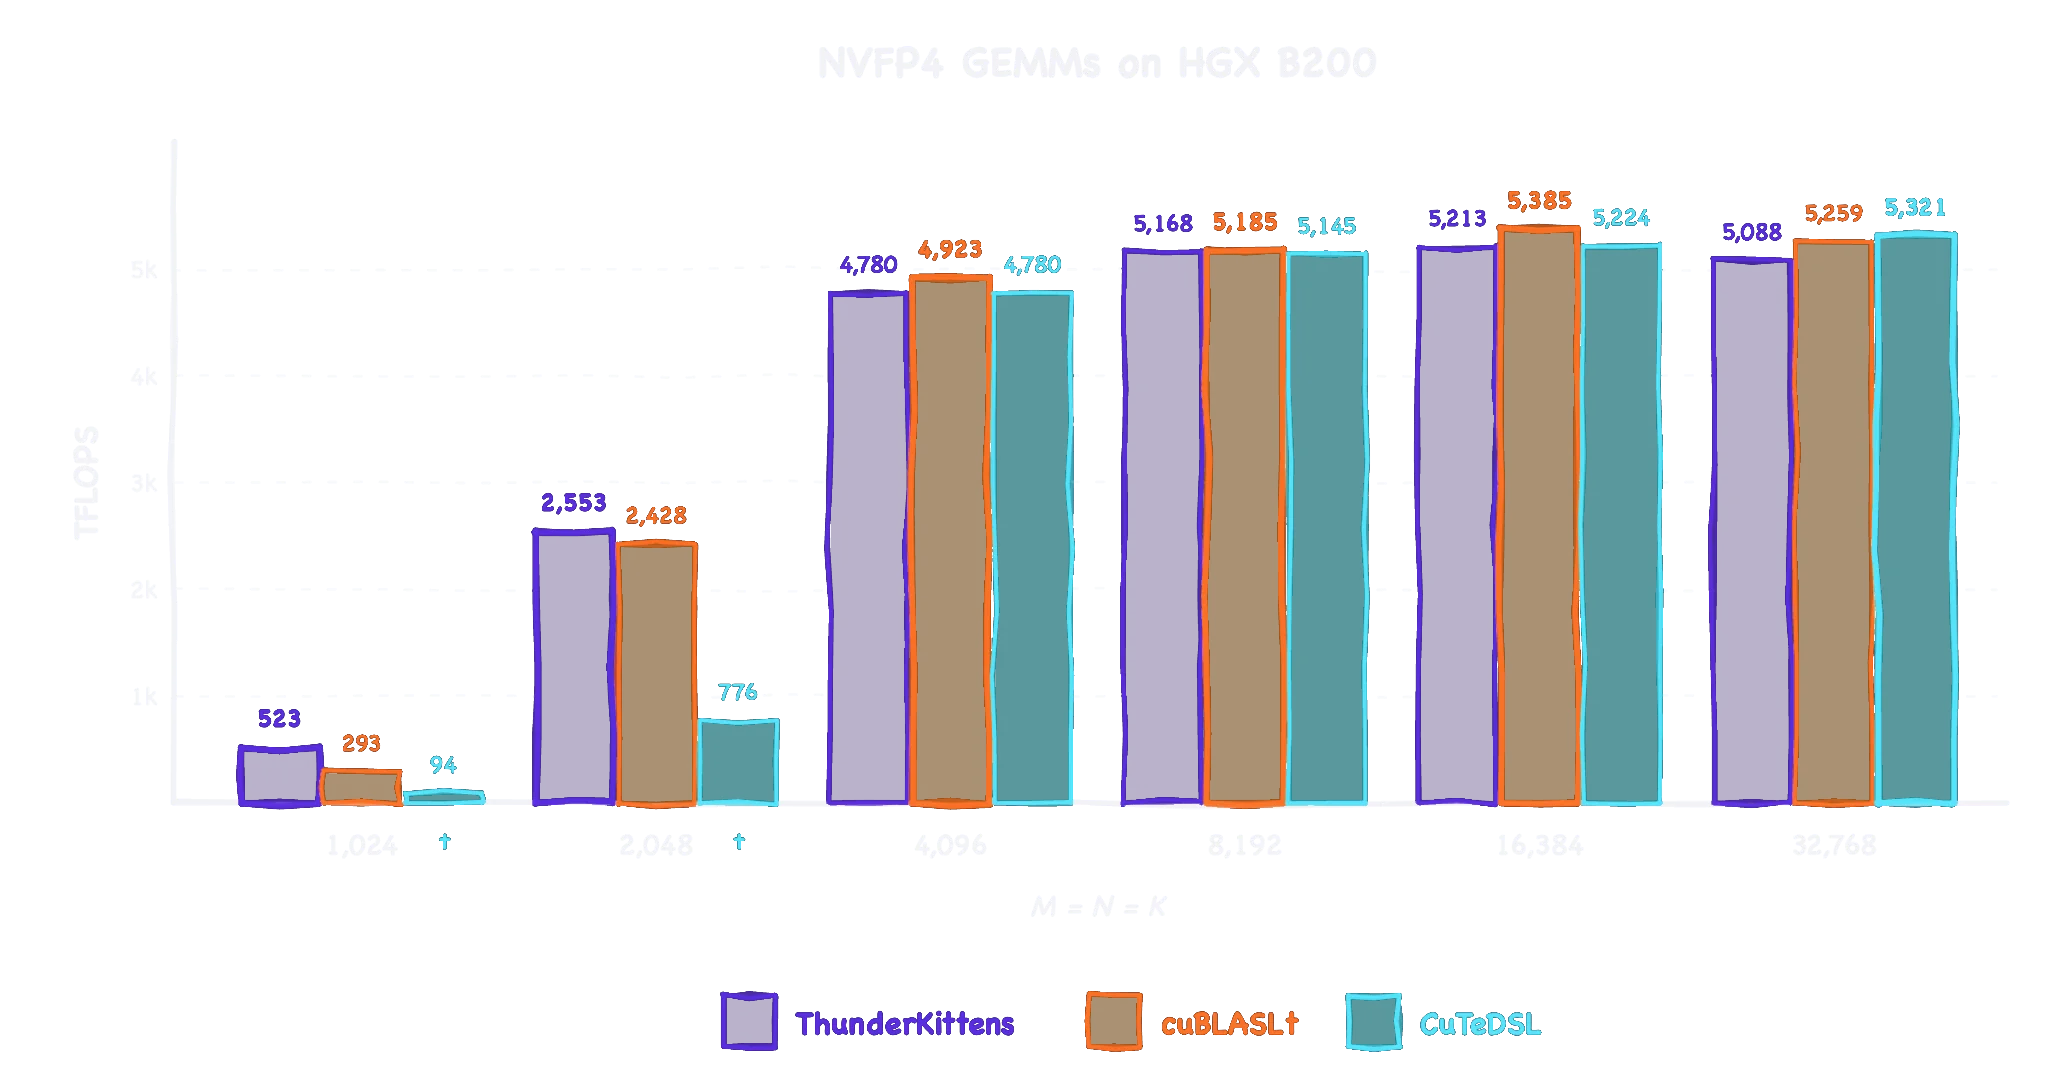
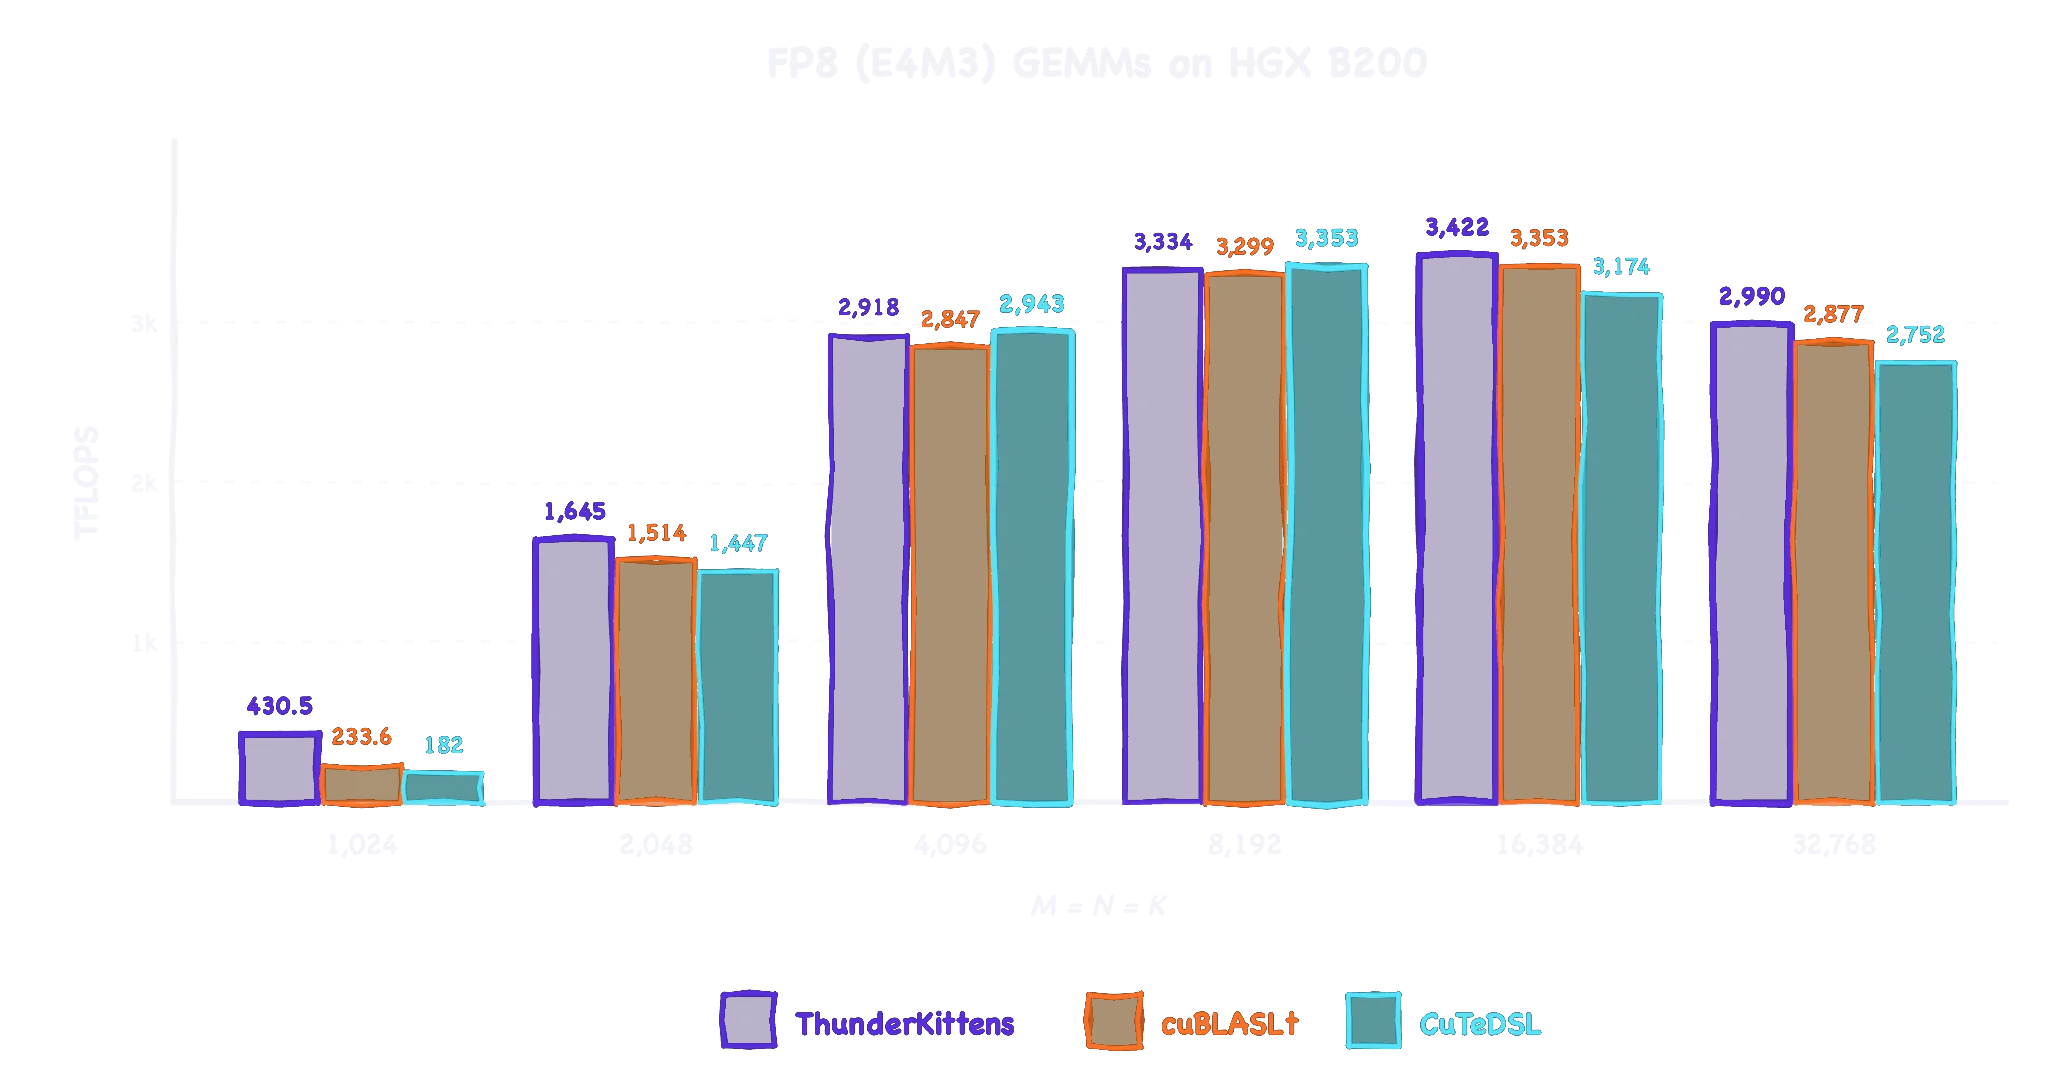
想进一步了解这些内核及其优化,请阅读我们之前的 Together 博客文章,或查看 ThunderKittens 2.0 的发布!
由于 Rubin 保留了 Blackwell 的编程模型,我们原有的 GEMM 仍然可以运行。不过,直接把它们放到 Vera Rubin 上跑,我们发现 NVFP4 和 FP8 内核只达到了屋顶线(roofline)的约 42.1% 和 44.4%,还有很大的优化空间!
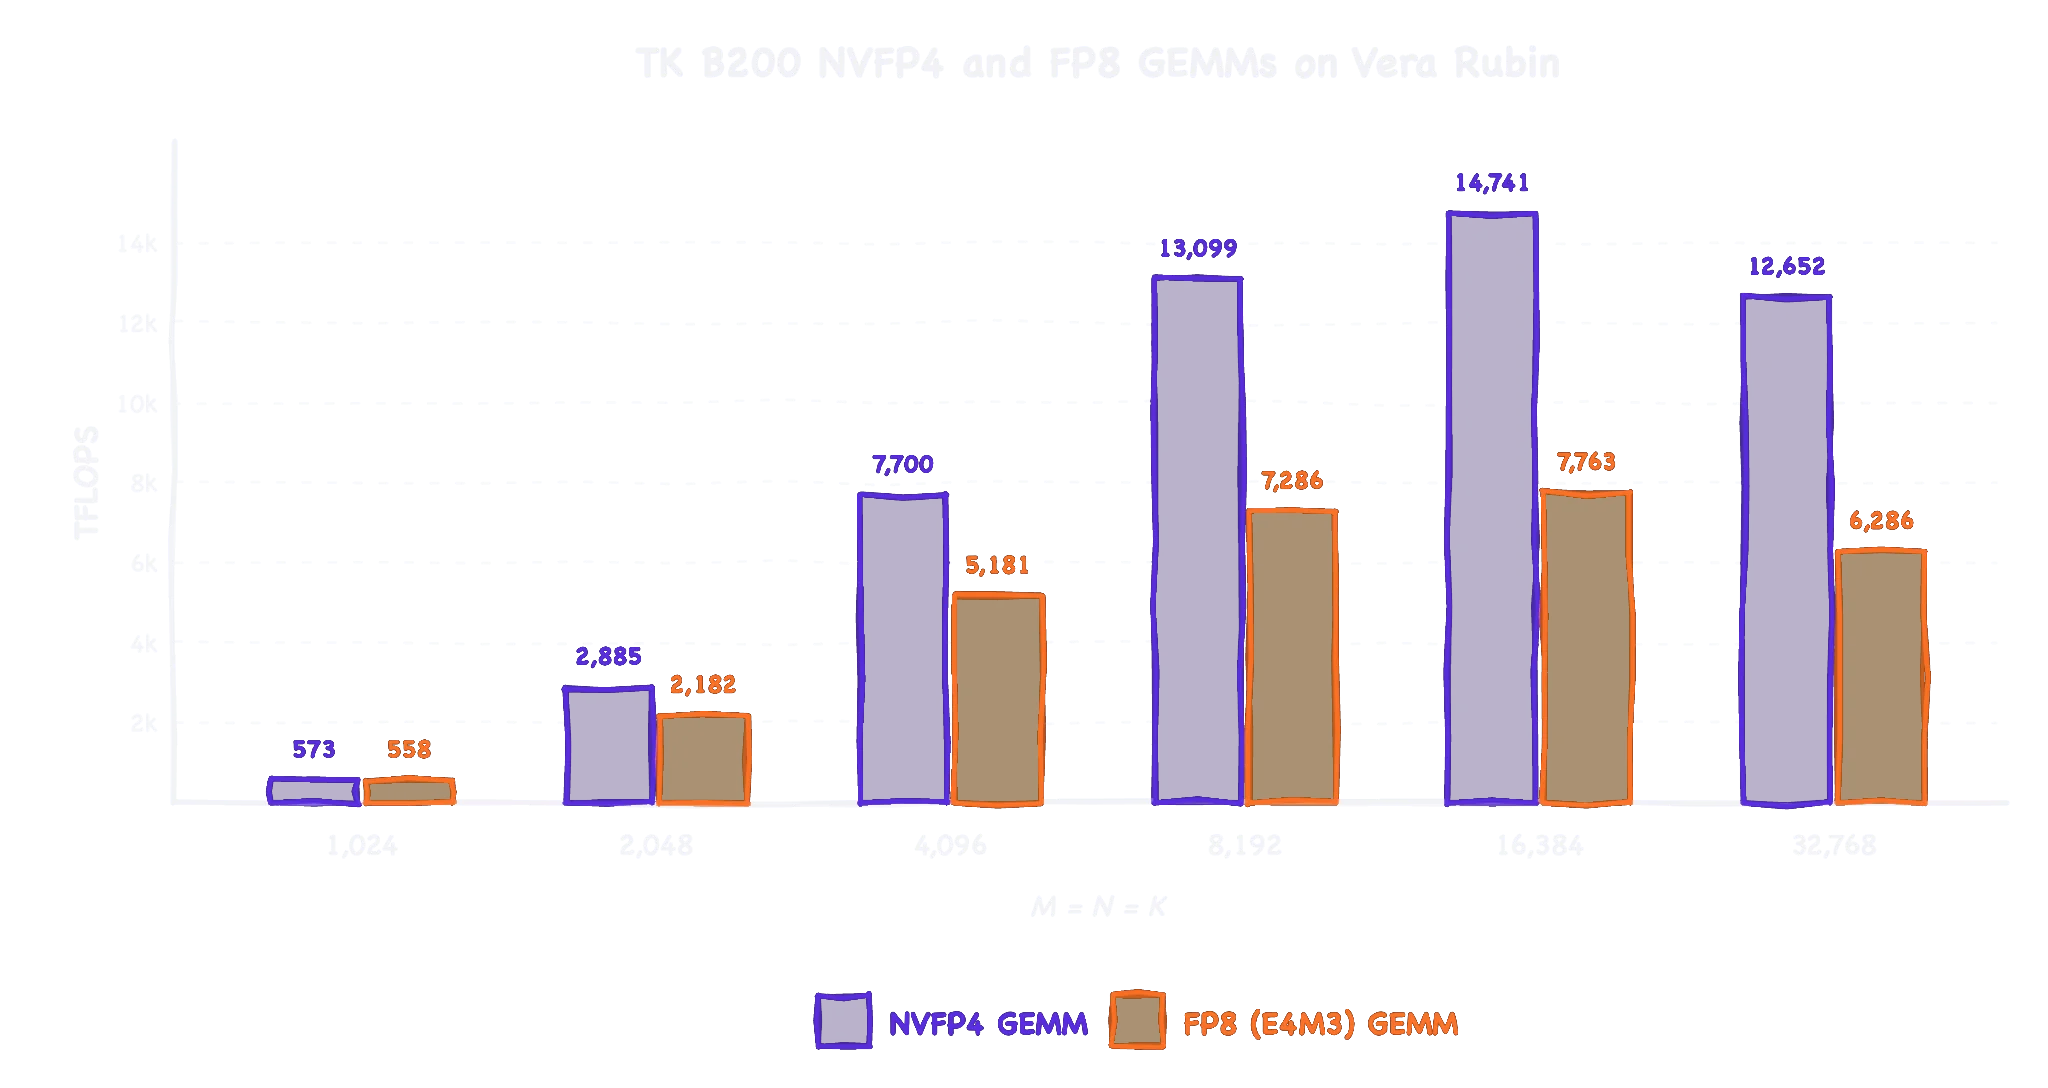
本文余下内容分为两部分。首先,我们介绍 Rubin 上对 GEMM 重要的新特性,以及如何在 ThunderKittens 中使用它们。然后,我们把这些特性逐步整合进现有的 Blackwell NVFP4 内核,使其性能超过 22 PFLOPS,与 cuBLAS 和 CuTE DSL 不相上下。
我们发现的核心问题是:Rubin 让张量核心消费操作数的速度提高了一倍,但我们旧的 Blackwell 内核喂数据的速度跟不上。要达到算力上限,我们需要用分块(tile)从已经在片上的数据中榨取更多复用。
NVIDIA Vera Rubin 平台有哪些新变化?
对比厂商规格,从 Blackwell 到 Vera Rubin 有如下改进。
| NVIDIA HGX B200 | NVIDIA Vera Rubin NVL72 | |
|---|---|---|
| NVFP4 张量核心 | 9 PFLOPS / GPU | 35 PFLOPS / GPU |
| FP8 张量核心 | 4.5 PFLOPS / GPU | 17.5 PFLOPS / GPU |
| FP16 / BF16 张量核心 | 2.25 PFLOPS / GPU | 4 PFLOPS / GPU |
| 内存带宽 | 8 TB/s / GPU | 22 TB/s / GPU |
| SM 数量 | 148 / GPU | 224 / GPU |
| 峰值功耗 | 1000W / GPU | 2300W / GPU |
就编写高性能 GEMM 而言,我们特别关注以下几项特性。
1. 张量核心的 K 翻倍
先回顾一下,tcgen05.mma 在 MxNxK 的分块上计算 C = A@B + C,每一步沿 K 方向消费固定字节数。在 Blackwell 上,这一步是 32 字节,而在 Vera Rubin 上可以增加到 64 字节。MMA 本身耗费的周期数不变,因此 K 翻倍让我们能在同样的指令窗口内塞进两倍的工作量。
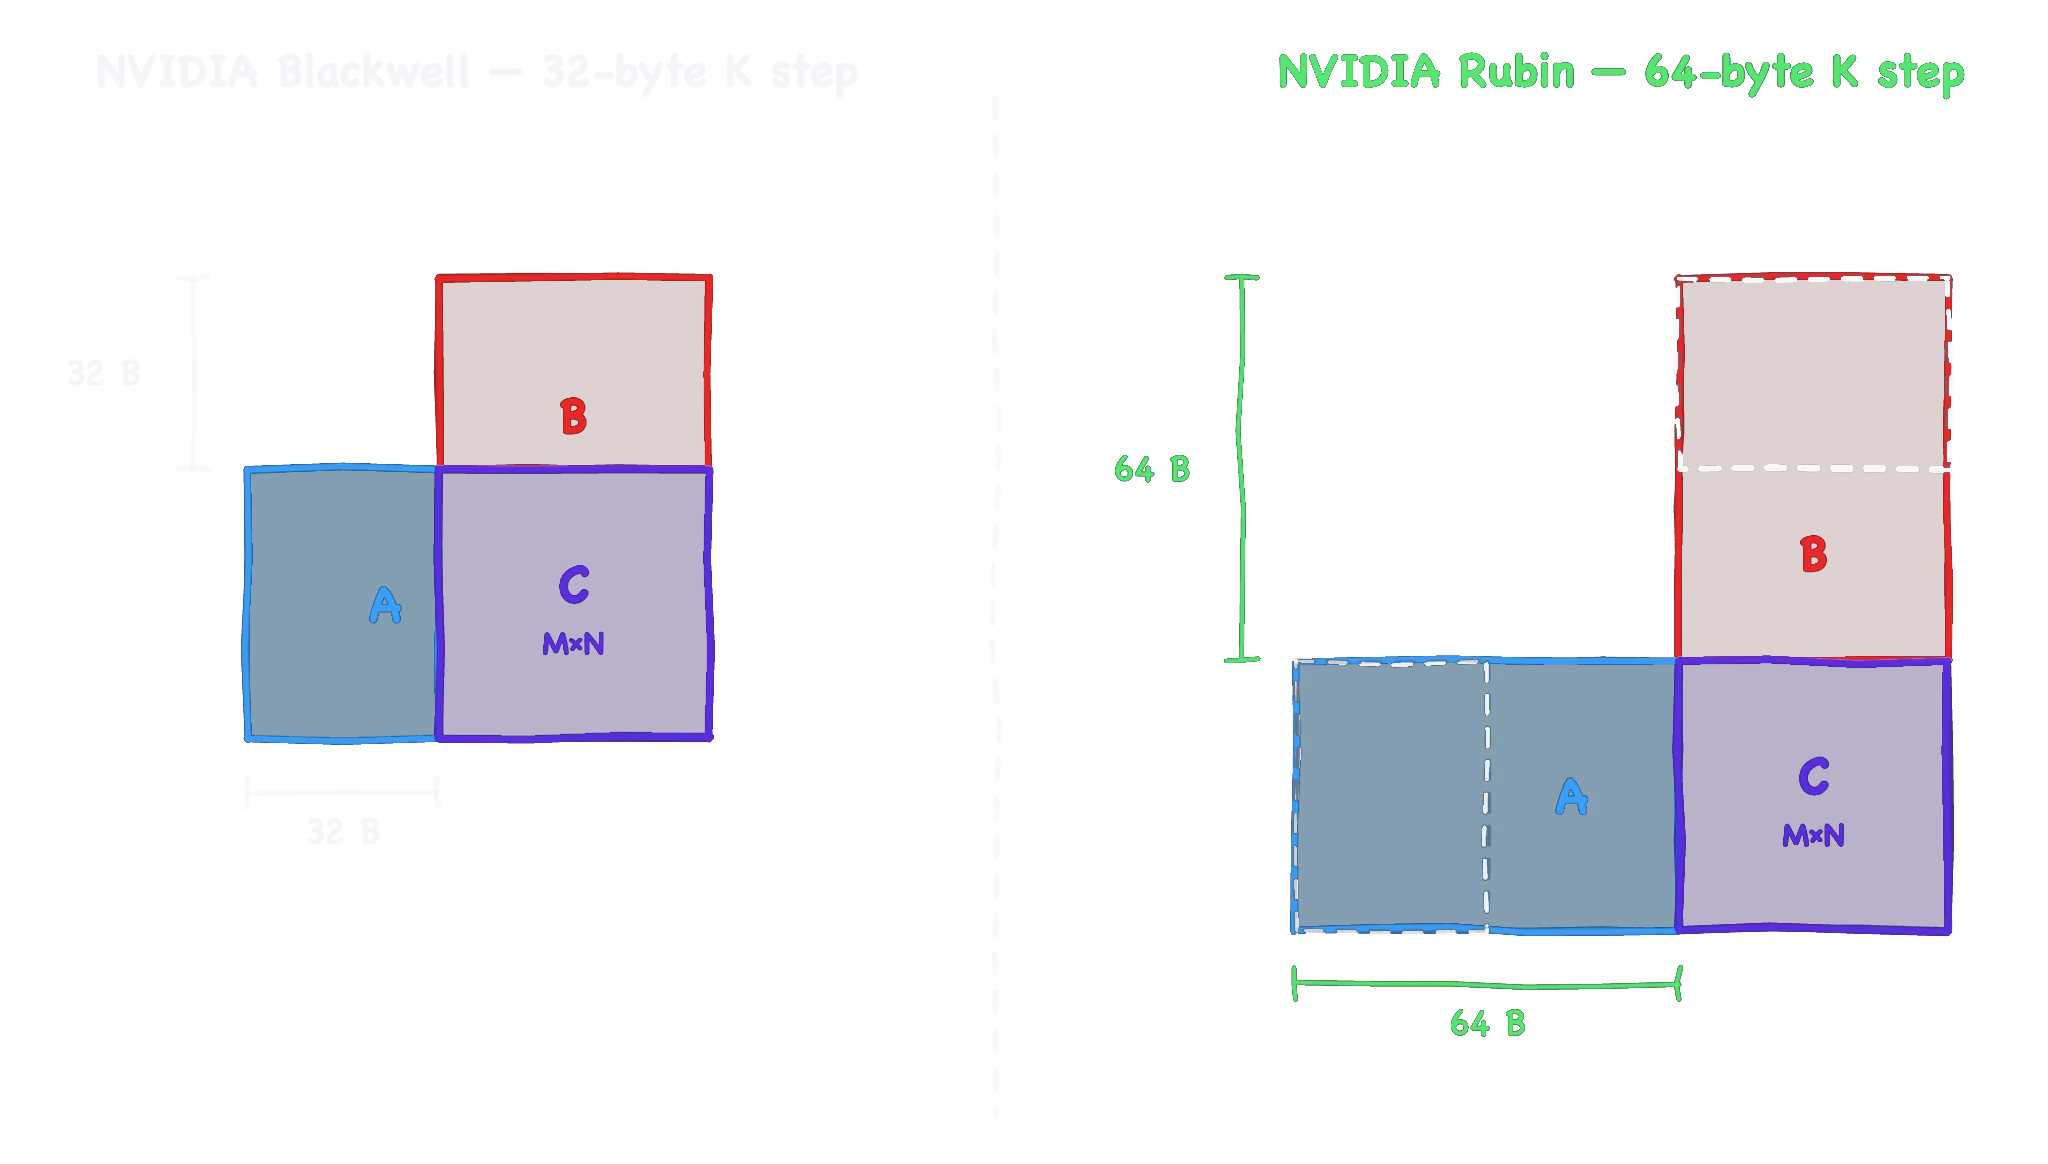
在 ThunderKittens 中,我们通过给现有 mma 操作新增一个模板参数来表达这一点。
mma_ABt    (...);   // Blackwell Default: 32-byte K step
mma_ABt<64>(...);   // Vera Rubin: 64-byte K step
2. 张量内存增长到 576 列
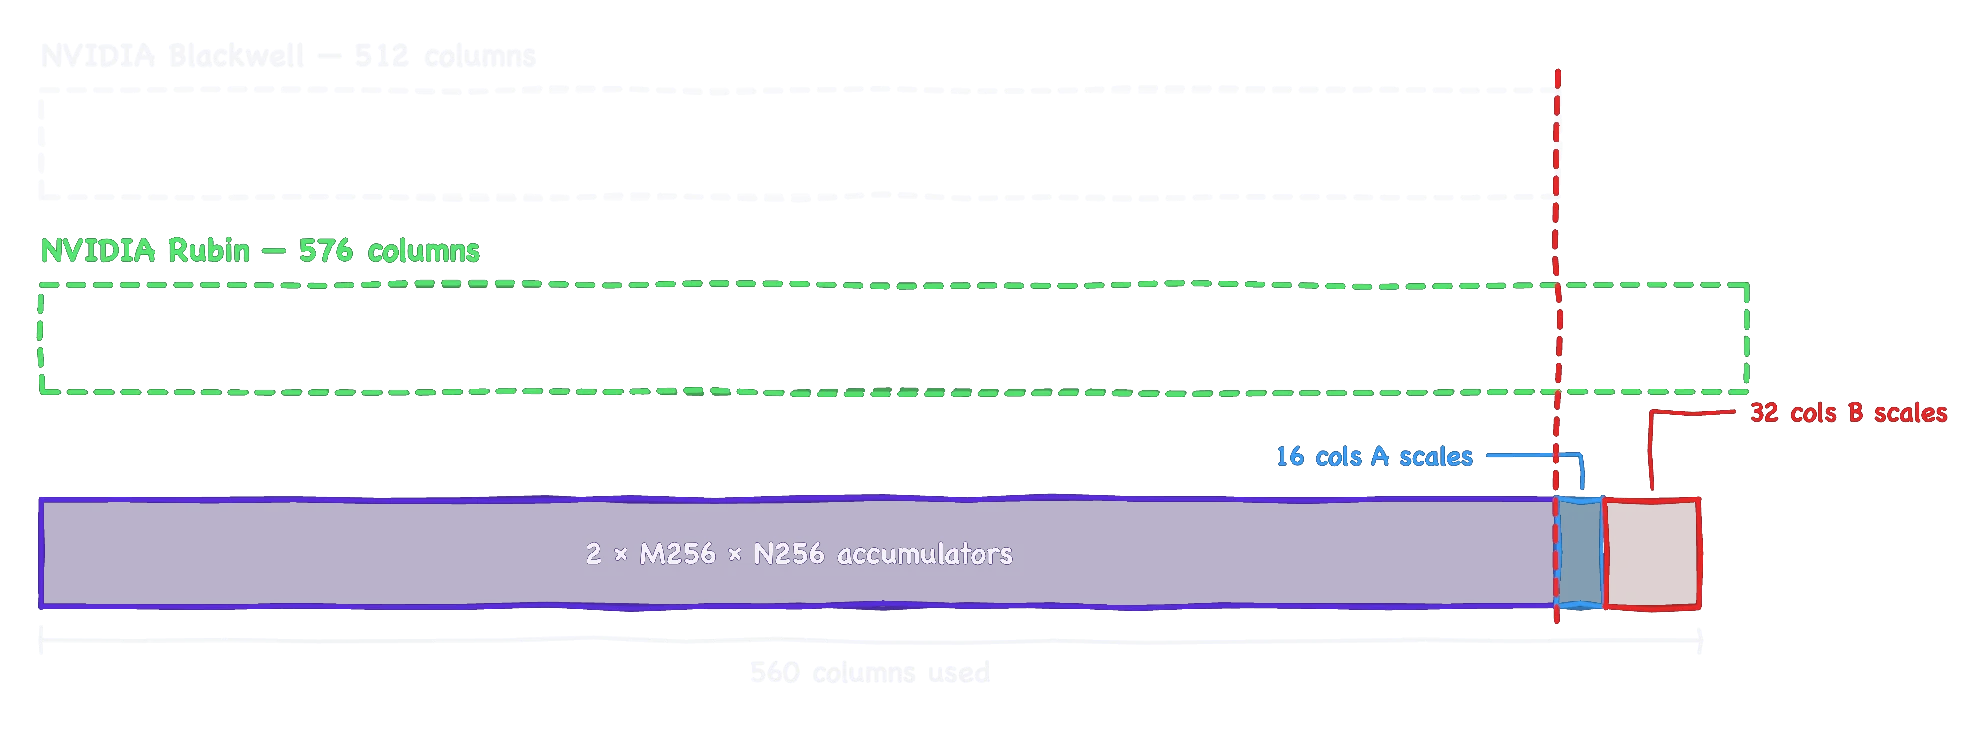
Blackwell 引入了张量内存的概念,这是一块 128 行(lane)x 512 列 x 32 位的空间,张量核心可以直接读写。在 Vera Rubin 上,这块空间增加到 576 列,多出 32 KiB 张量内存可供使用。
请注意,这些额外的列只能通过 .exclusive 限定符访问。这是 PTX 9.4 新增的特性,用于确保一个 SM 上只有一份有效的张量内存分配。非独占分配仍然上限为 512,且必须是 2 的幂。
在 ThunderKittens 中,用户可以通过张量内存分配器的一个模板参数来请求这一点,表明该分配是独占的。
template<int _nblocks_per_sm, int _ncta, bool _managed = true, bool _exclusive = false>
struct tensor_allocator { .... }
tensor_allocator<1, C::CLUSTER_SIZE, false> tm; // Blackwell default: 512 columns
tensor_allocator<1, C::CLUSTER_SIZE, false, true> tm; // Rubin: Up to 576 columns
3. 共享内存增加到 328 KiB
Hopper 和 Blackwell 提供 228 KiB 共享内存,而 Vera Rubin 引入了超大共享内存模式,可以动态增加到 328 KiB。这是主机端的设置,可以像下面这样调用。
CUfunction function = nullptr;
cudaGetFuncBySymbol(&function,reinterpret_cast<const void*>(kernel));
cuFuncSetAttribute(function, CU_FUNC_ATTRIBUTE_SHARED_MEMORY_MODE,
                   CU_SHARED_MEMORY_MODE_ALLOW_OVERSIZED_SHARED_MEMORY);
4. B 侧收集器
Blackwell 引入了收集器缓冲区(collector buffer)的概念,这是一个小型的 MMA 暂存缓冲区,可以锁存一个 A 分块,让下一条指令从这里取数,而不是从共享内存取。Vera Rubin 通过 .collector::b::* 把这一功能也扩展到了 B 分块。
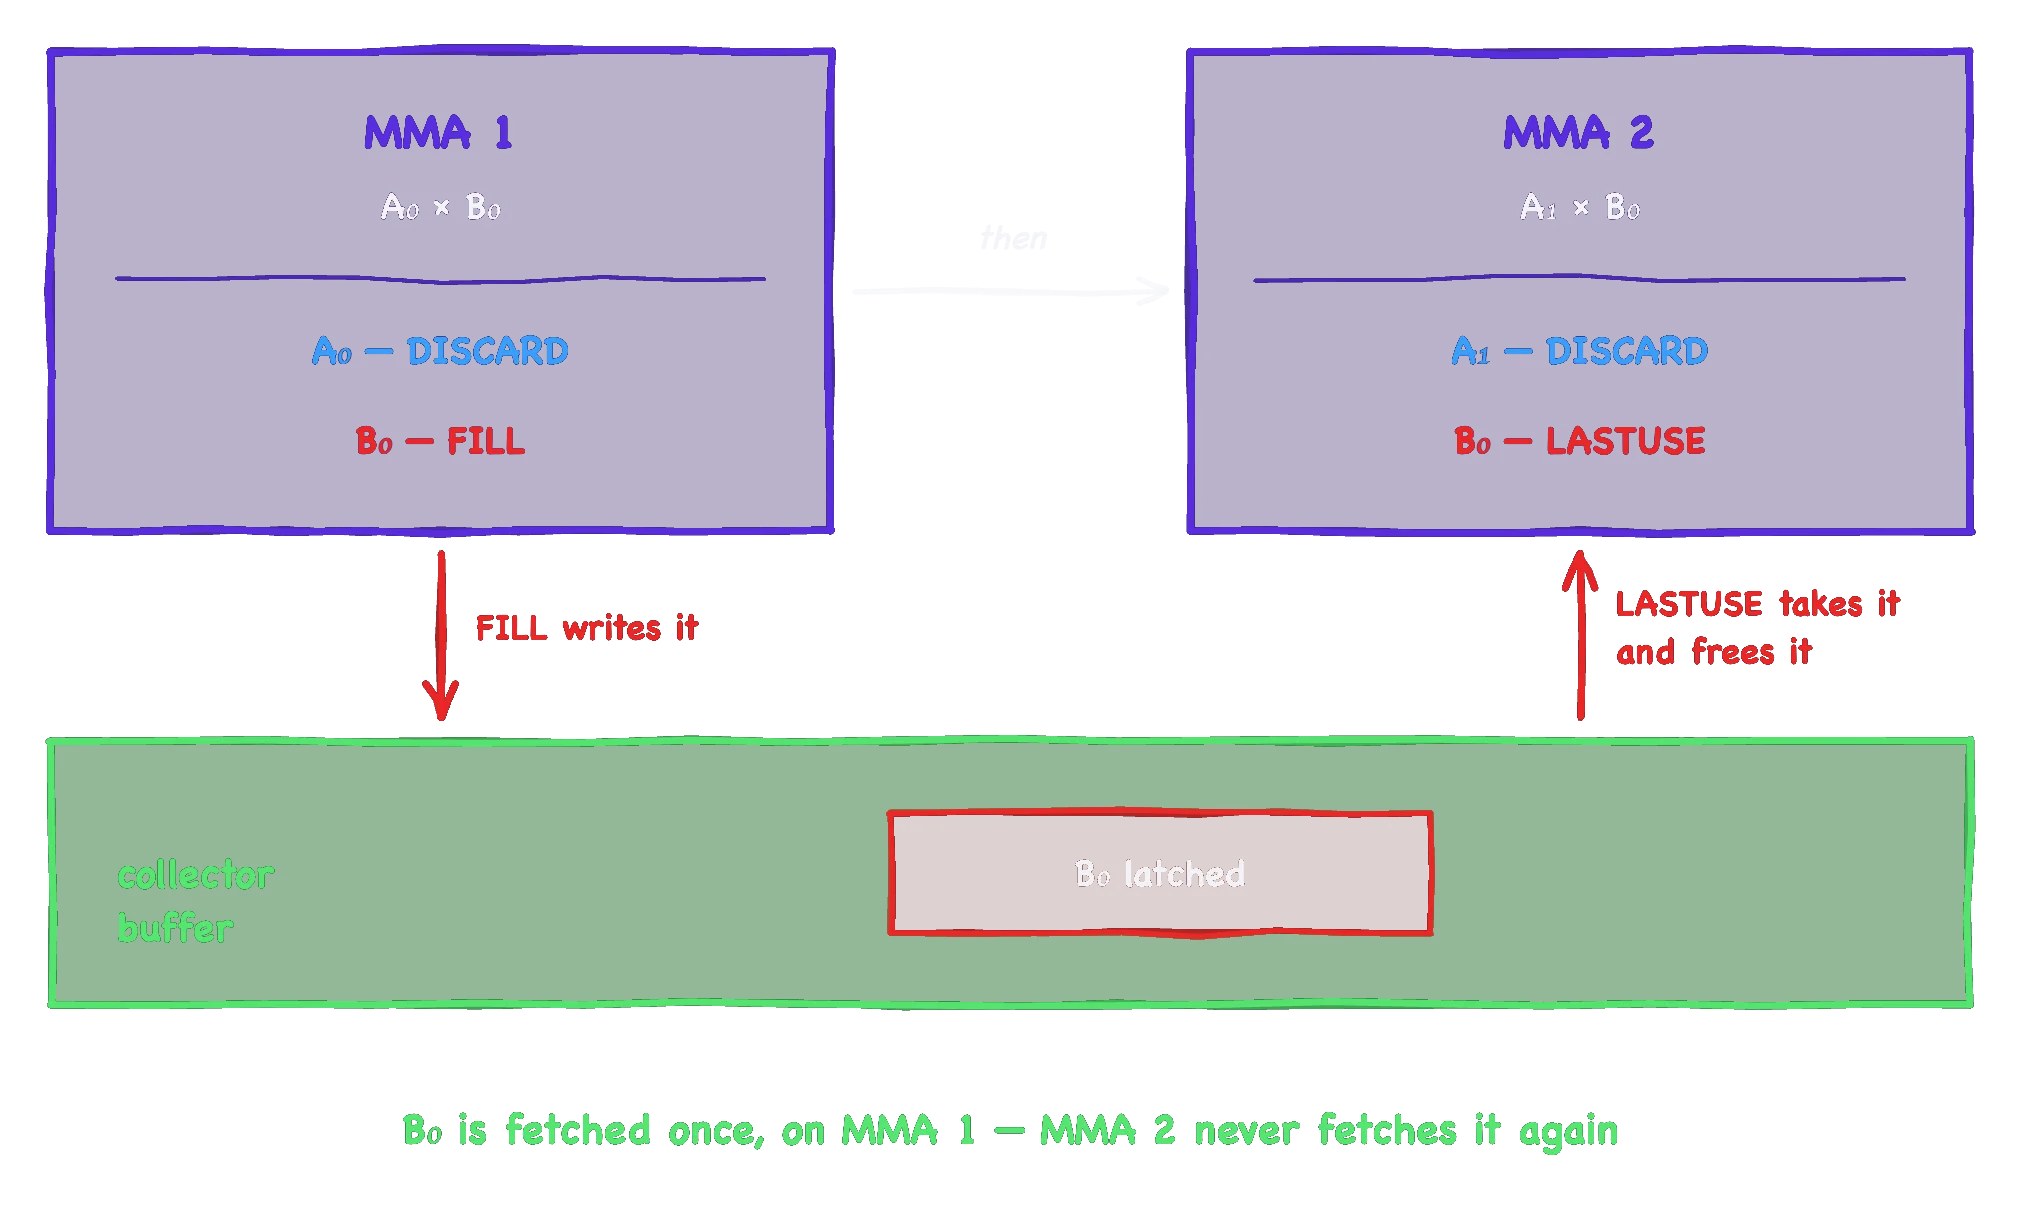
为了利用这一点,我们给每个 MMA 的操作数标注四种标签之一,用来描述它对收集器缓冲区的操作。
- “FILL” 从共享内存读取操作数并将其锁存
- “USE” 从缓冲区读取
- “LASTUSE” 从缓冲区读取并释放它
- “DISCARD” 为默认值,跳过锁存
这些标签是复用的许可限定符,而不是保证。也就是说,即使被允许复用,张量核心仍然可能重新加载矩阵。
既然任一操作数都可以驻留在收集器缓冲区中,我们就可以尝试新的模式。例如在 2x2 块上,两侧都收集,可以让 4 个 MMA 的操作数读取次数从 8 次降到只有 5 次。
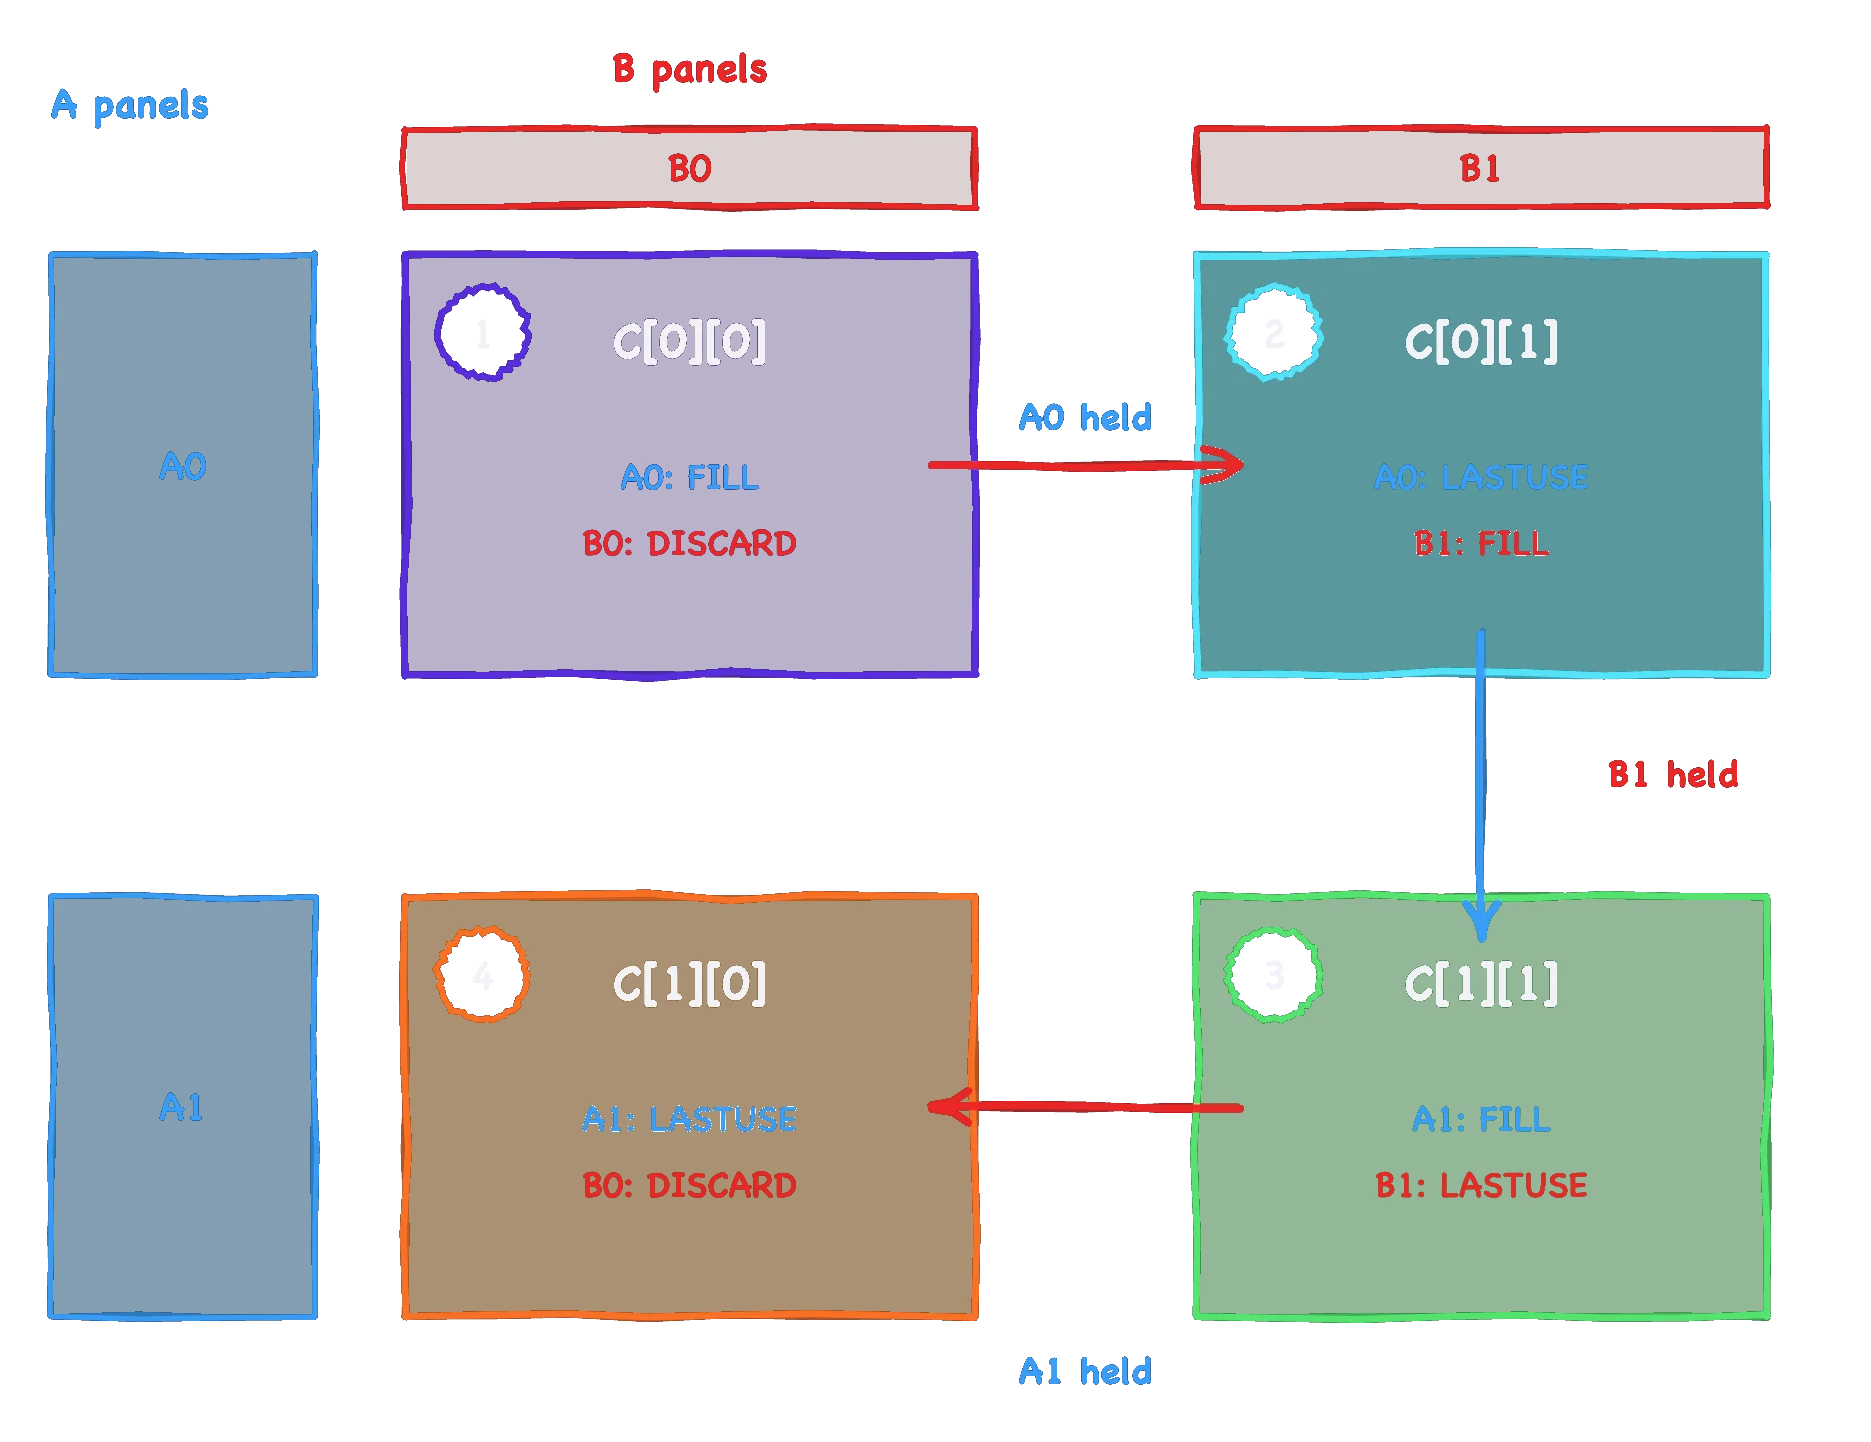
在 ThunderKittens 中,我们可以通过下面的方式暴露这一功能。
mma2_ABt_chunk<64, false, false, collector::FILL,collector::DISCARD>(C[0][0], a0, b0, ...);
mma2_ABt_chunk<64, false, false, collector::LASTUSE, collector::FILL   >(C[0][1], a0, b1, ...);
mma2_ABt_chunk<64, false, false, collector::FILL,    collector::LASTUSE>(C[1][1], a1, b1, ...);
mma2_ABt_chunk<64, false, false, collector::LASTUSE, collector::DISCARD>(C[1][0], a1, b0, ...);
5. A 的提前释放
tcgen05.commit 会在其处理的 MMA 完成后到达(arrive)一个 mbarrier,通知生产者某个阶段槽位可以复用了。PTX 9.4 引入了 tcgen05.commit.sync_restrict::shared::read::mma::a,这条新指令允许我们为 A 分块把这一信号提前。我们不必等 MMA 完成,而是在 MMA 刚把 A 操作数从共享内存读完时就触发屏障,从而通知 TMA 加载器开始存入下一阶段的数据。
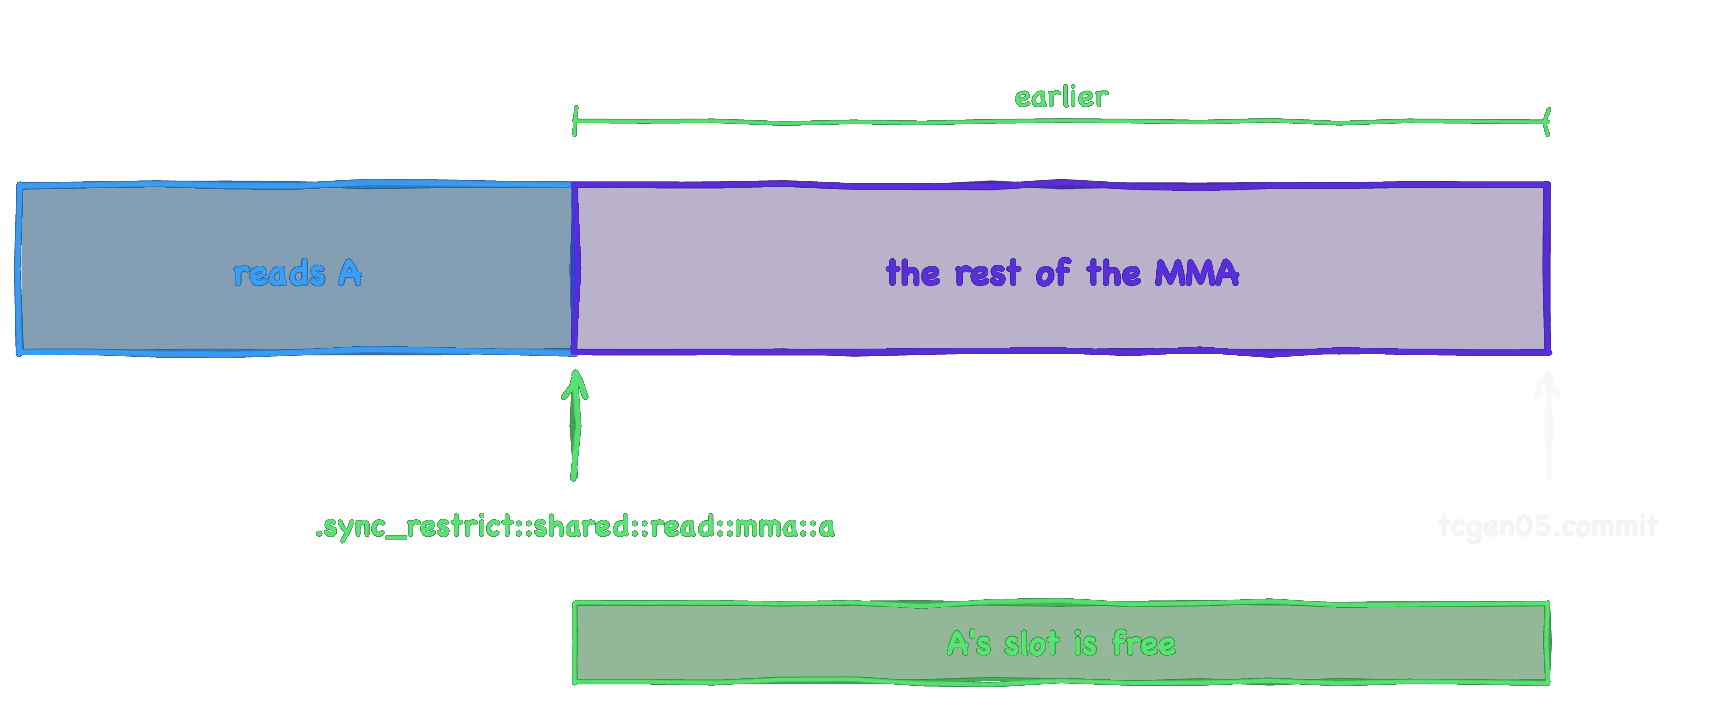
ThunderKittens 引入了一种新的提交(commit)类型,供用户表达这一点。
tensor_commit<2> (inputs_finished[stage], mask); // arrives when MMA retires
tensor_aread_commit<2>(A_finished[slot], mask); // arrives when MMA finishes reading A
构建 GEMM
现在我们有了新特性,也有了 Blackwell GEMM。接下来的部分将把这些特性逐步整合进现有的 Blackwell 内核,并解释迁移到 Vera Rubin 时为什么需要它们。
加宽指令:
最直观的瓶颈在于,我们仍在使用 Blackwell 的 32 字节 K 步长。在 Vera Rubin 上,这种编码的 ISA 上限约为 16.8 PFLOPs,而我们的 NVFP4 Blackwell GEMM 开箱即用就已达到 14.7 PFLOPs(上限的 88%)。要进一步提升,必须把 MMA 处理的 K 字节数翻倍。
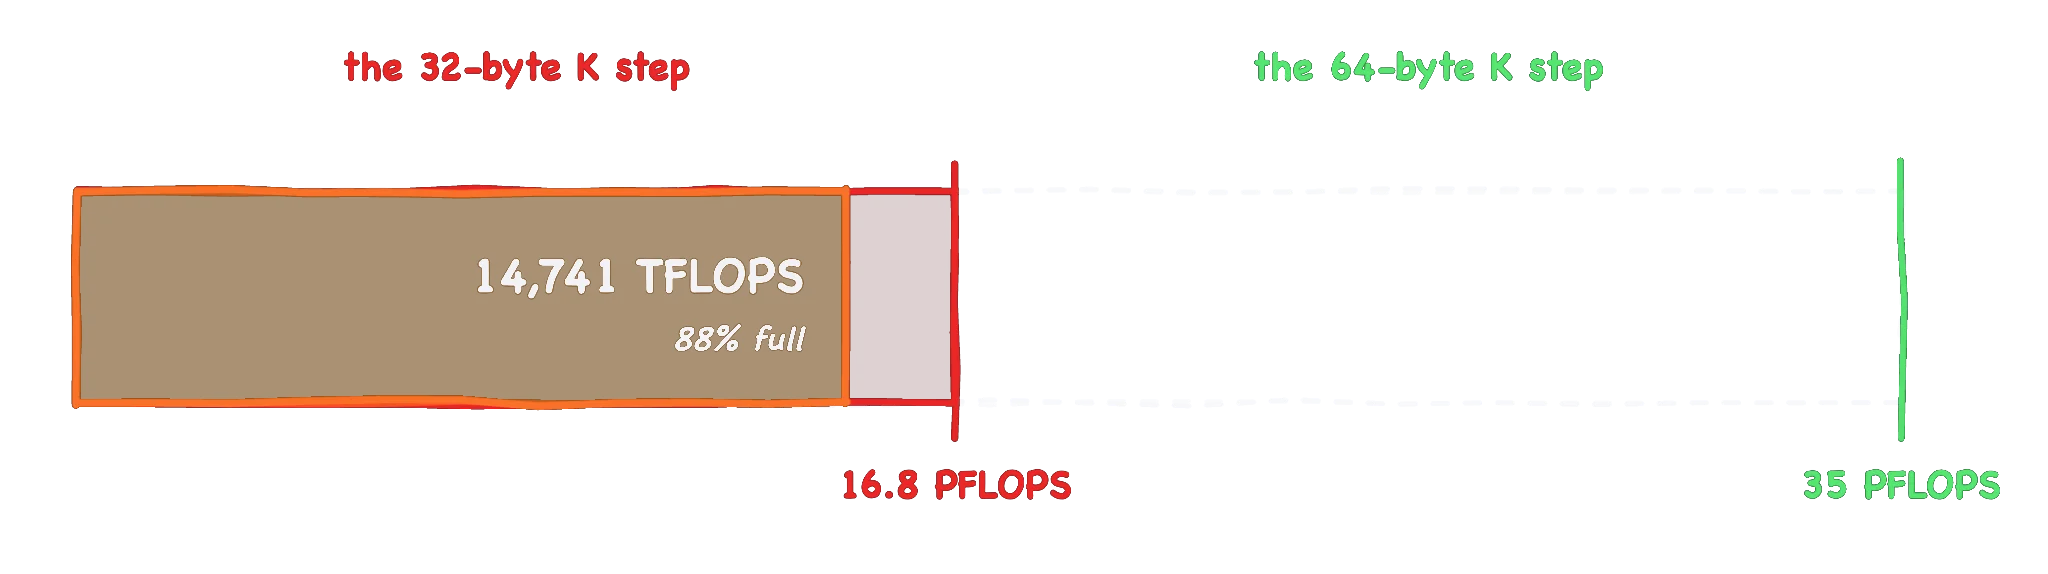
然而,我们只是为现有的 Blackwell 内核打开更宽的编码,就发现性能仅有小幅提升,而不是预期的 2 倍。更宽的 MMA 让张量核心消费操作数的速度翻倍,却无助于提高我们供给操作数的速度。要让 K 翻倍真正有用,我们需要从两方面入手,让核心保持忙碌:搬运更少的字节,以及加深流水线,让这些取数操作相互重叠。
读取更少的字节:
为了少取字节,我们在同一对 CTA 上沿 M 维度叠放第二个输出分块。由于两个累加器只在 M 上不同,它们可以共享同一块 B。我们最初的 Blackwell NVFP4 内核使用 1x1 分块格式,这意味着要覆盖 M512xN256 的输出,需要两个配对作业,各自独立传输一份 B。改用 2x1 格式后,我们只需取一次 B 就能覆盖同样的输出,从而减少了操作数流量。
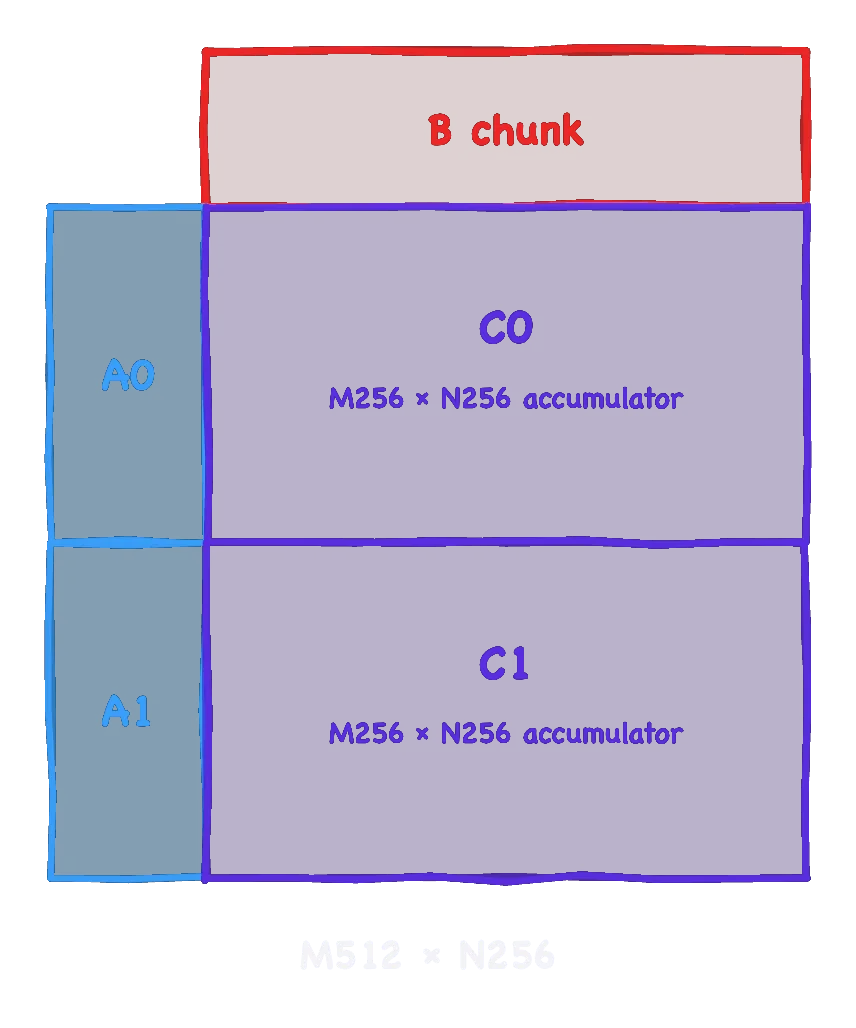
这种 2x1 分块格式在我们的 NVFP4 Blackwell 内核中不易实现,因为张量内存上限为 256 KiB。两个 M256xN256 的累加器就已占满 512 列,这意味着分块缩放(block-scaled)MMA 没有空间存放 A 和 B 的缩放因子。程序员虽然可以绕过这一限制,让后处理(epilogue)warp 只加载累加器的一部分列,再发出 MMA 空闲信号,使下一个 K 分块的 MMA 得以开始,但这会引入一小段无法隐藏的延迟。幸运的是,借助 Vera Rubin 多出的 64 列,我们无需再折腾这套把戏,就能存放缩放因子。
加深流水线:
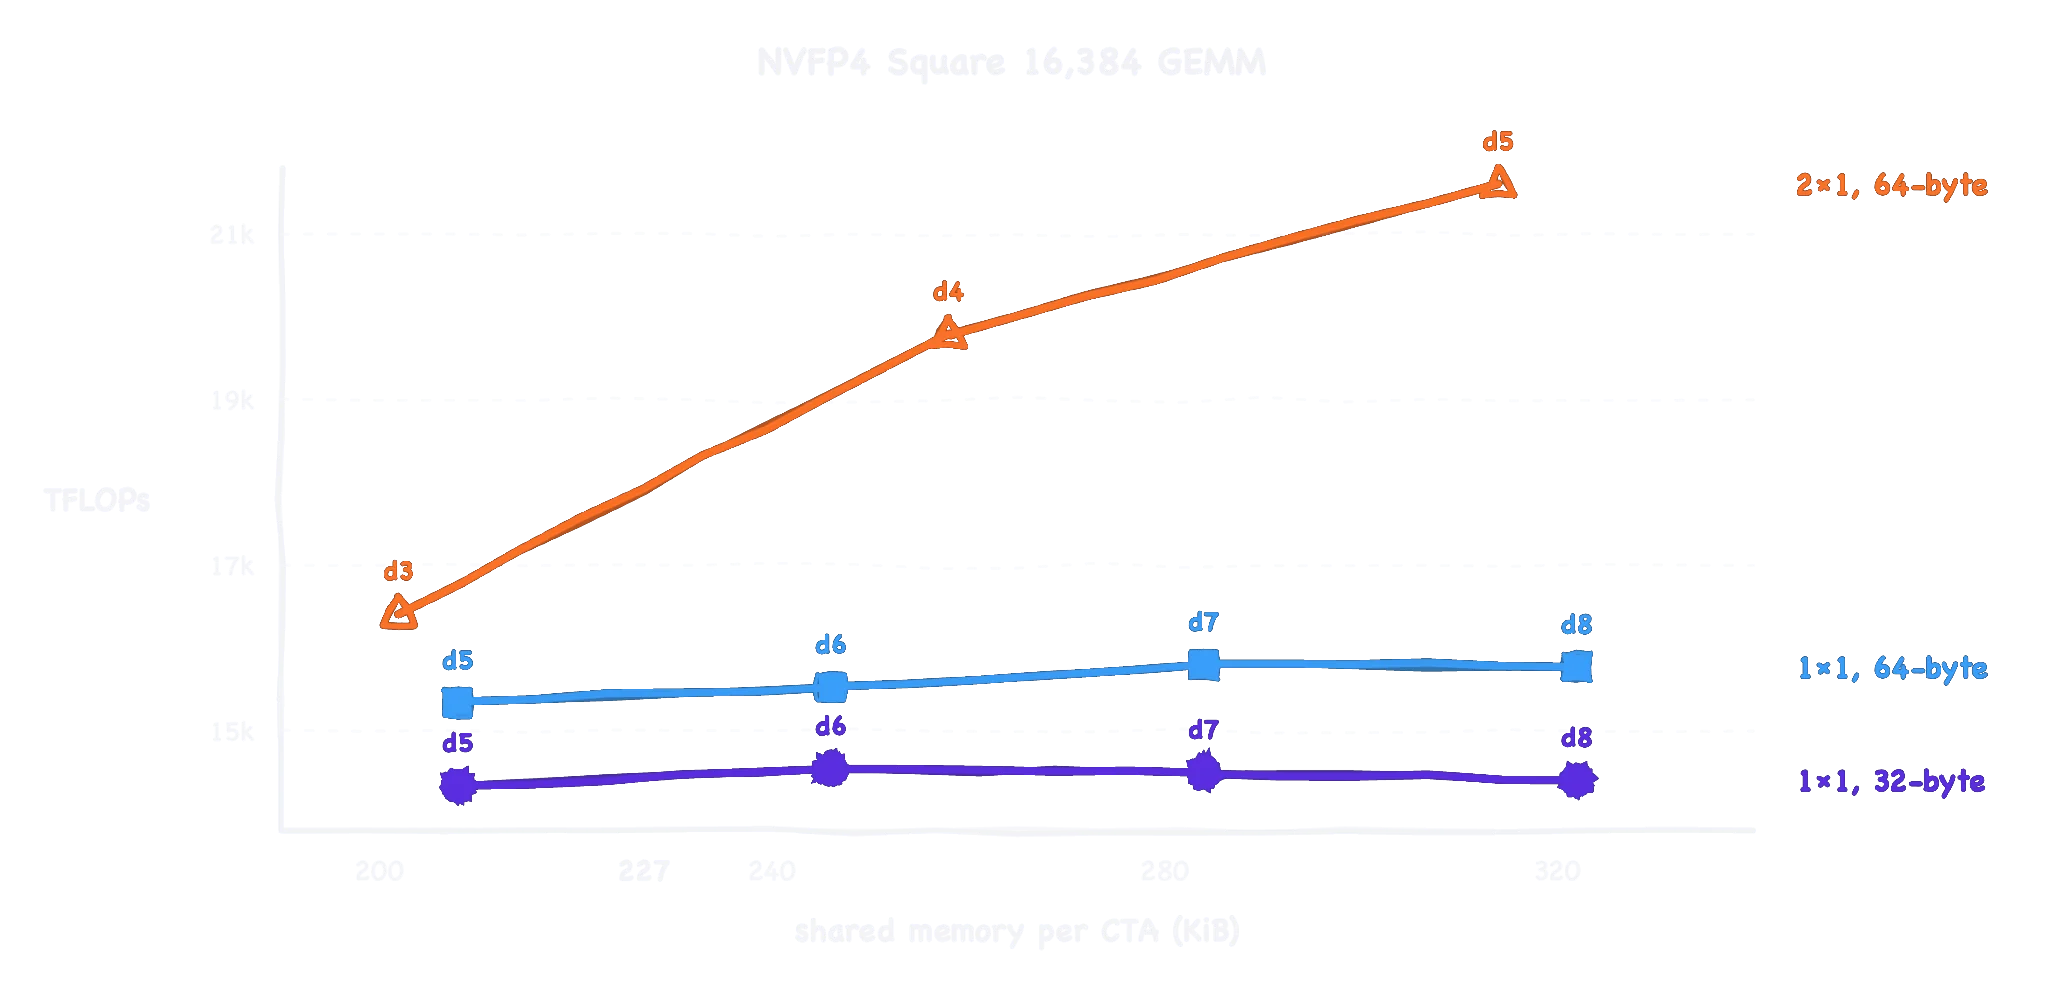
改变分块格式减少了操作数流量,但并不能缩短每次取数的耗时。下一个挑战是让张量核心持续不断地获得数据。Vera Rubin 更大的共享内存让我们可以构建更深的流水线,提前暂存更多分块,给数据传输留出更多完成时间。我们对 NVFP4 和 FP8 的 16k 方阵 GEMM 扫描了环形缓冲区深度,结果如下。
NVFP4 16k 方阵 GEMM:
| # Smem 分块阶段数 | 所需共享内存 | 实测 TFLOPS |
|---|---|---|
| 3 | 202 KiB | 17,054 |
| 4 | 258 KiB | 20,595 |
| 5 | 314 KiB | 22,239 |
FP8 (E4M3) 16k 方阵 GEMM:
| 配置 | 所需共享内存 | 实测 TFLOPS |
|---|---|---|
| 4 | 209 KiB | 10,895 |
| 5 | 257 KiB | 11,995 |
| 6 | 305 KiB | 11,288 |
虽然最大的收益出现在最后这一档,但我们注意到,这些收益依赖于前面的优化。下面是分别独立扫描 K 步长、共享内存流水线和分块策略的结果。
最后的调优:
为了把内核进一步推向极致,我们还调整了最后几个旋钮
- 内核配置调优:我们针对不同的工作负载进一步调优内核,以获得最佳性能。在 CTA 配对尺寸方面,我们发现 Blackwell 内核最初的 1x1 分块格式在较小的方阵工作负载上性能最好。对于较大的形状,我们采用 2x1 的 CTA 配对分块,并将集群大小调为 2、4 或 8 个 CTA。此外,对所有形状,我们都会重排分块光栅化顺序,以改善内存局部性和性能。
- B 侧收集器:由于采用 2x1 分块格式,我们可以使用 B 侧收集器。在一个 MMA 上指定 “FILL”,在下一个 MMA 上指定 “LASTUSE”,就能把 B 的读取从两次减少到只有一次。我们实测这带来了约 1-3% 的提升。
- 利用
sync_restrict::shared::read::mma::a:对于更大的 64k 和 128k 方阵 NVFP4 GEMM,我们观察到 A 的提前释放分别带来了 13.5% 和 22.1% 的加速。我们发现,这条指令在较大尺寸下很有用:此时 A 分块要与其他资源争夺驻留空间,导致其行在两次复用之间被逐出,迫使加载器等待它们。有了这条指令,我们就能获得 A 提前复用的收益。在较小尺寸下,A 分块始终不会离开 L2,也就是说读取本来就足够快,不需要提前释放 A。为了使用这条指令,我们修改了传统的环形顺序逻辑。在普通 GEMM 中,A 和 B 分块属于同一个环,并在单次提交下步调一致地运行。但要让 A 的提前释放生效,我们需要把两种分块解耦,使 A 的加载可以独立进行。A 的提前释放要求 A 的槽位在更早的信号上被释放,所以我们给 A 配备了独立的环,以及独立的到达/完成屏障对。 - L2 逐出提示:我们给 A 操作数标记 EVICT_LAST,以促使它们驻留在 L2 中,供后续复用它们的作业使用。这里的复用收益来自作业之间,而不是集群内部,带来了零点几个百分点的提升。
结果:
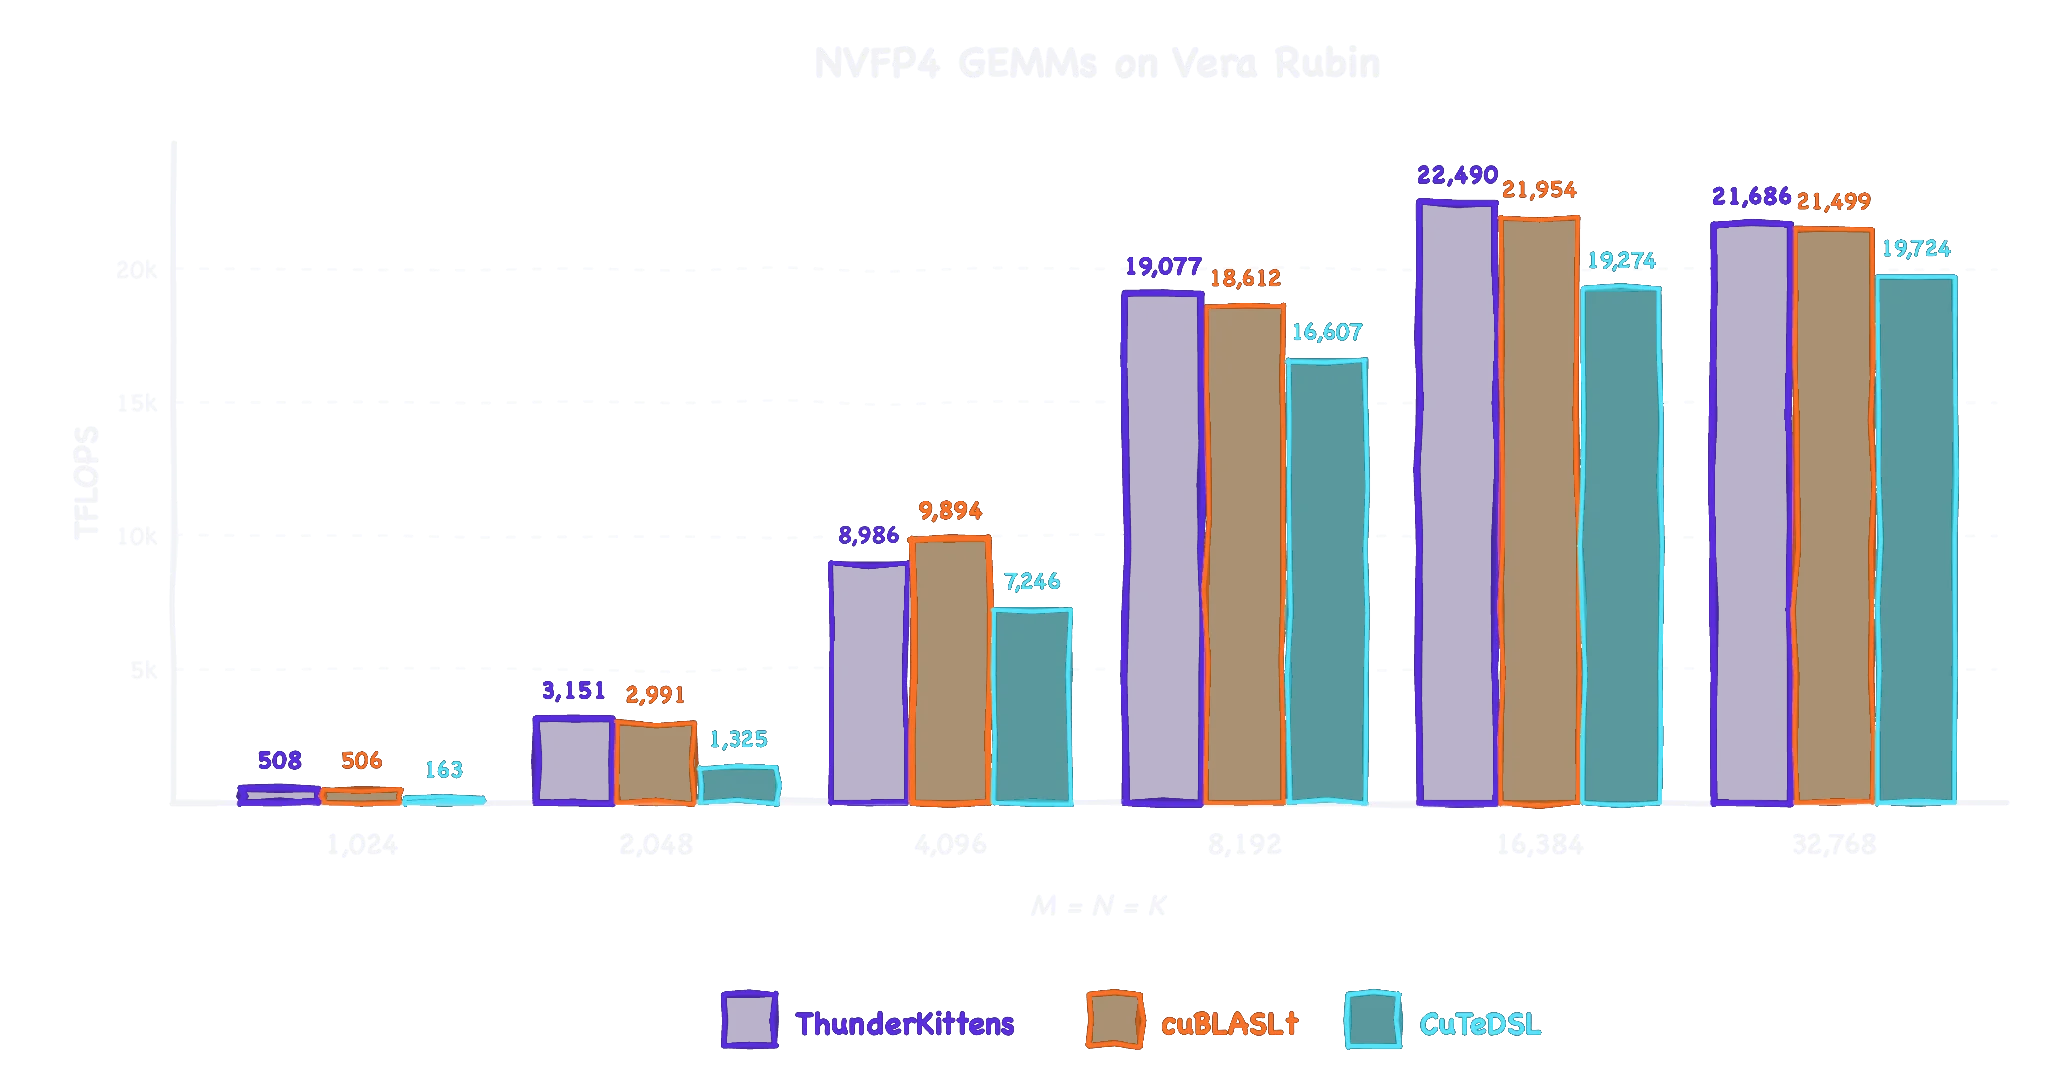
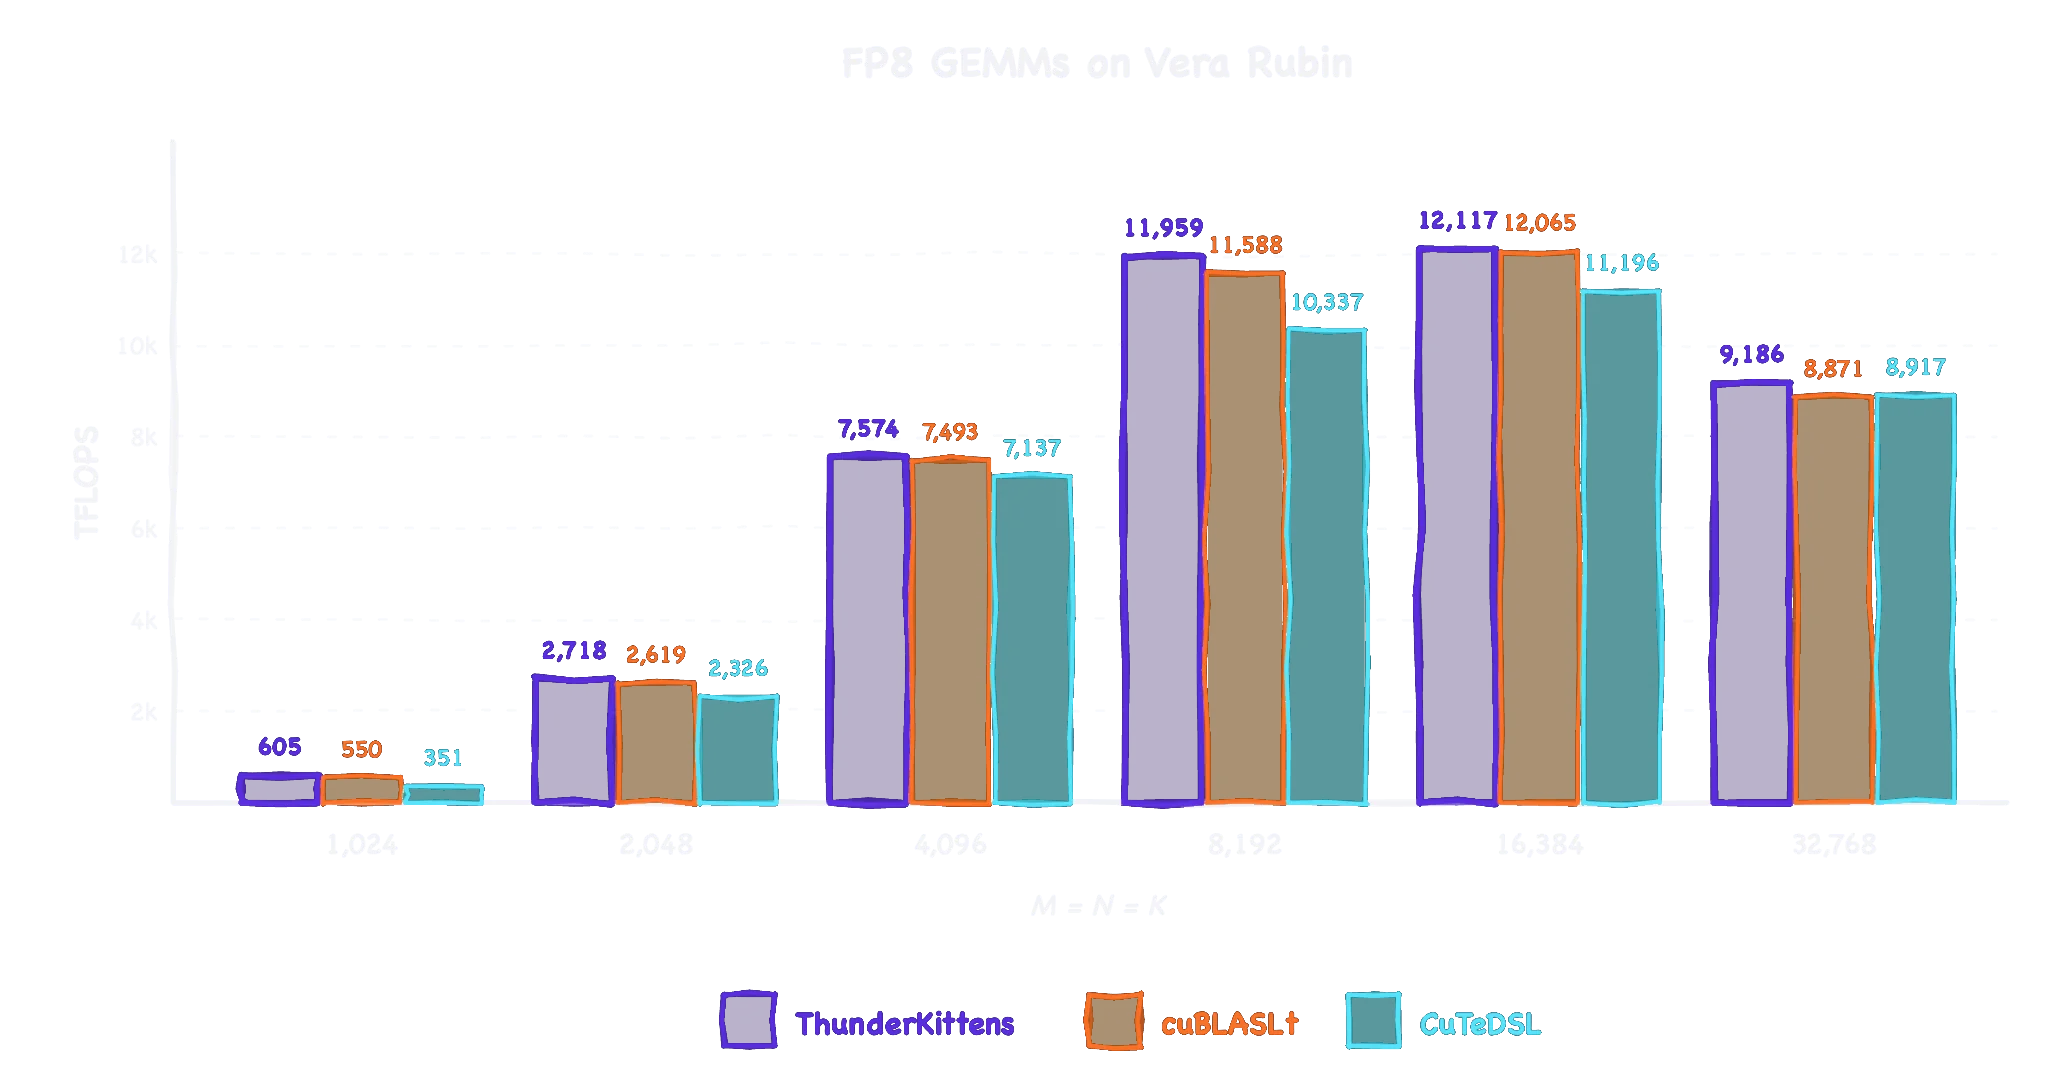
请注意,以上所有测量都是在合格样品(Qualification Sample,QS)GPU 上使用 NVIDIA CUDA 13.4 得出的。我们预计,随着 Vera Rubin 软件的陆续发布,所有基线的性能都将继续提升。
结语:
希望其中一些内容对你有帮助,我们也很期待大家很快上手尝试。从 LUT GEMM、硬件原生的 megakernel,到新的引擎优化,还有很多有趣的内容可以分享。敬请期待!
Together AI 的内核与性能团队正在招聘!如果你想进一步了解这些内核,或者想与我们一起开发下一批更新,请联系 Simran 或 Dan!
- Simran: simran@together.ai
- Dan: danfu@together.ai